Las demostraciones de asistentes conversacionales de voz llevan dos años impresionando en conferencias, pero apenas han logrado implantarse en centralitas telefónicas y centros de soporte reales. Las empresas se han topado sistemáticamente con dos barreras insalvables: costes de llamada incontrolables, donde las principales API en la nube pueden sumar con facilidad varios dólares por hora, y latencias excesivas, con silencios incómodos de más de un segundo en mitad de la conversación.
El 21 de octubre de 2026, Mistral presentó la familia de modelos de voz Voxtral 3, adaptando su esquema de facturación a la lógica habitual de las telecomunicaciones: la transcripción se cobra a 0,0035 dólares por minuto, mientras que la síntesis de voz se tarifa por caracteres. Con una lista de precios totalmente pública y transparente, los agentes de voz dejan de ser un experimento técnico para convertirse en una decisión de aprovisionamiento directo: ¿cuánto cuesta el minuto de llamada?
Demos impecables, facturas impredecibles
Hasta ahora, poner en marcha un agente de voz requería ensamblar múltiples servicios independientes: primero transcribir el audio a texto, alimentar con él a un modelo de lenguaje para generar la respuesta y, finalmente, enviar dicho texto a un motor de síntesis de voz. Cada componente manejaba su propia unidad métrica: la transcripción por minutos de audio, la inferencia por tokens y la síntesis por caracteres. Una única llamada de soporte atravesaba tres esquemas tarifarios distintos, haciendo prácticamente imposible que un departamento financiero fijara un techo de gasto creíble.
Voxtral 3 consolida estas etapas en un flujo unificado: Voxtral Small Transcribe 3 se encarga de la transcripción multilingüe con diarización de hablantes y sesgo contextual; Mini Transcribe 3 es una versión compacta de 4B parámetros concebida para despliegues de bajo coste; Realtime Transcribe 3 procesa audio en streaming con una latencia de extremo a extremo inferior a 500 milisegundos; y Mini TTS 3 ofrece síntesis expresiva a 13 dólares por millón de caracteres. Todo ello acompañado por un SDK para agentes de voz con soporte para diálogos multiturno y ejecución de herramientas externas.
A 0,0035 dólares por minuto, una hora completa de transcripción con el modelo Mini Transcribe 3 cuesta únicamente 0,21 dólares. En su presentación, Mistral comparó de forma directa estas cifras con las tarifas de OpenAI TTS-1, Deepgram, ElevenLabs Flash y Gemini Flash.
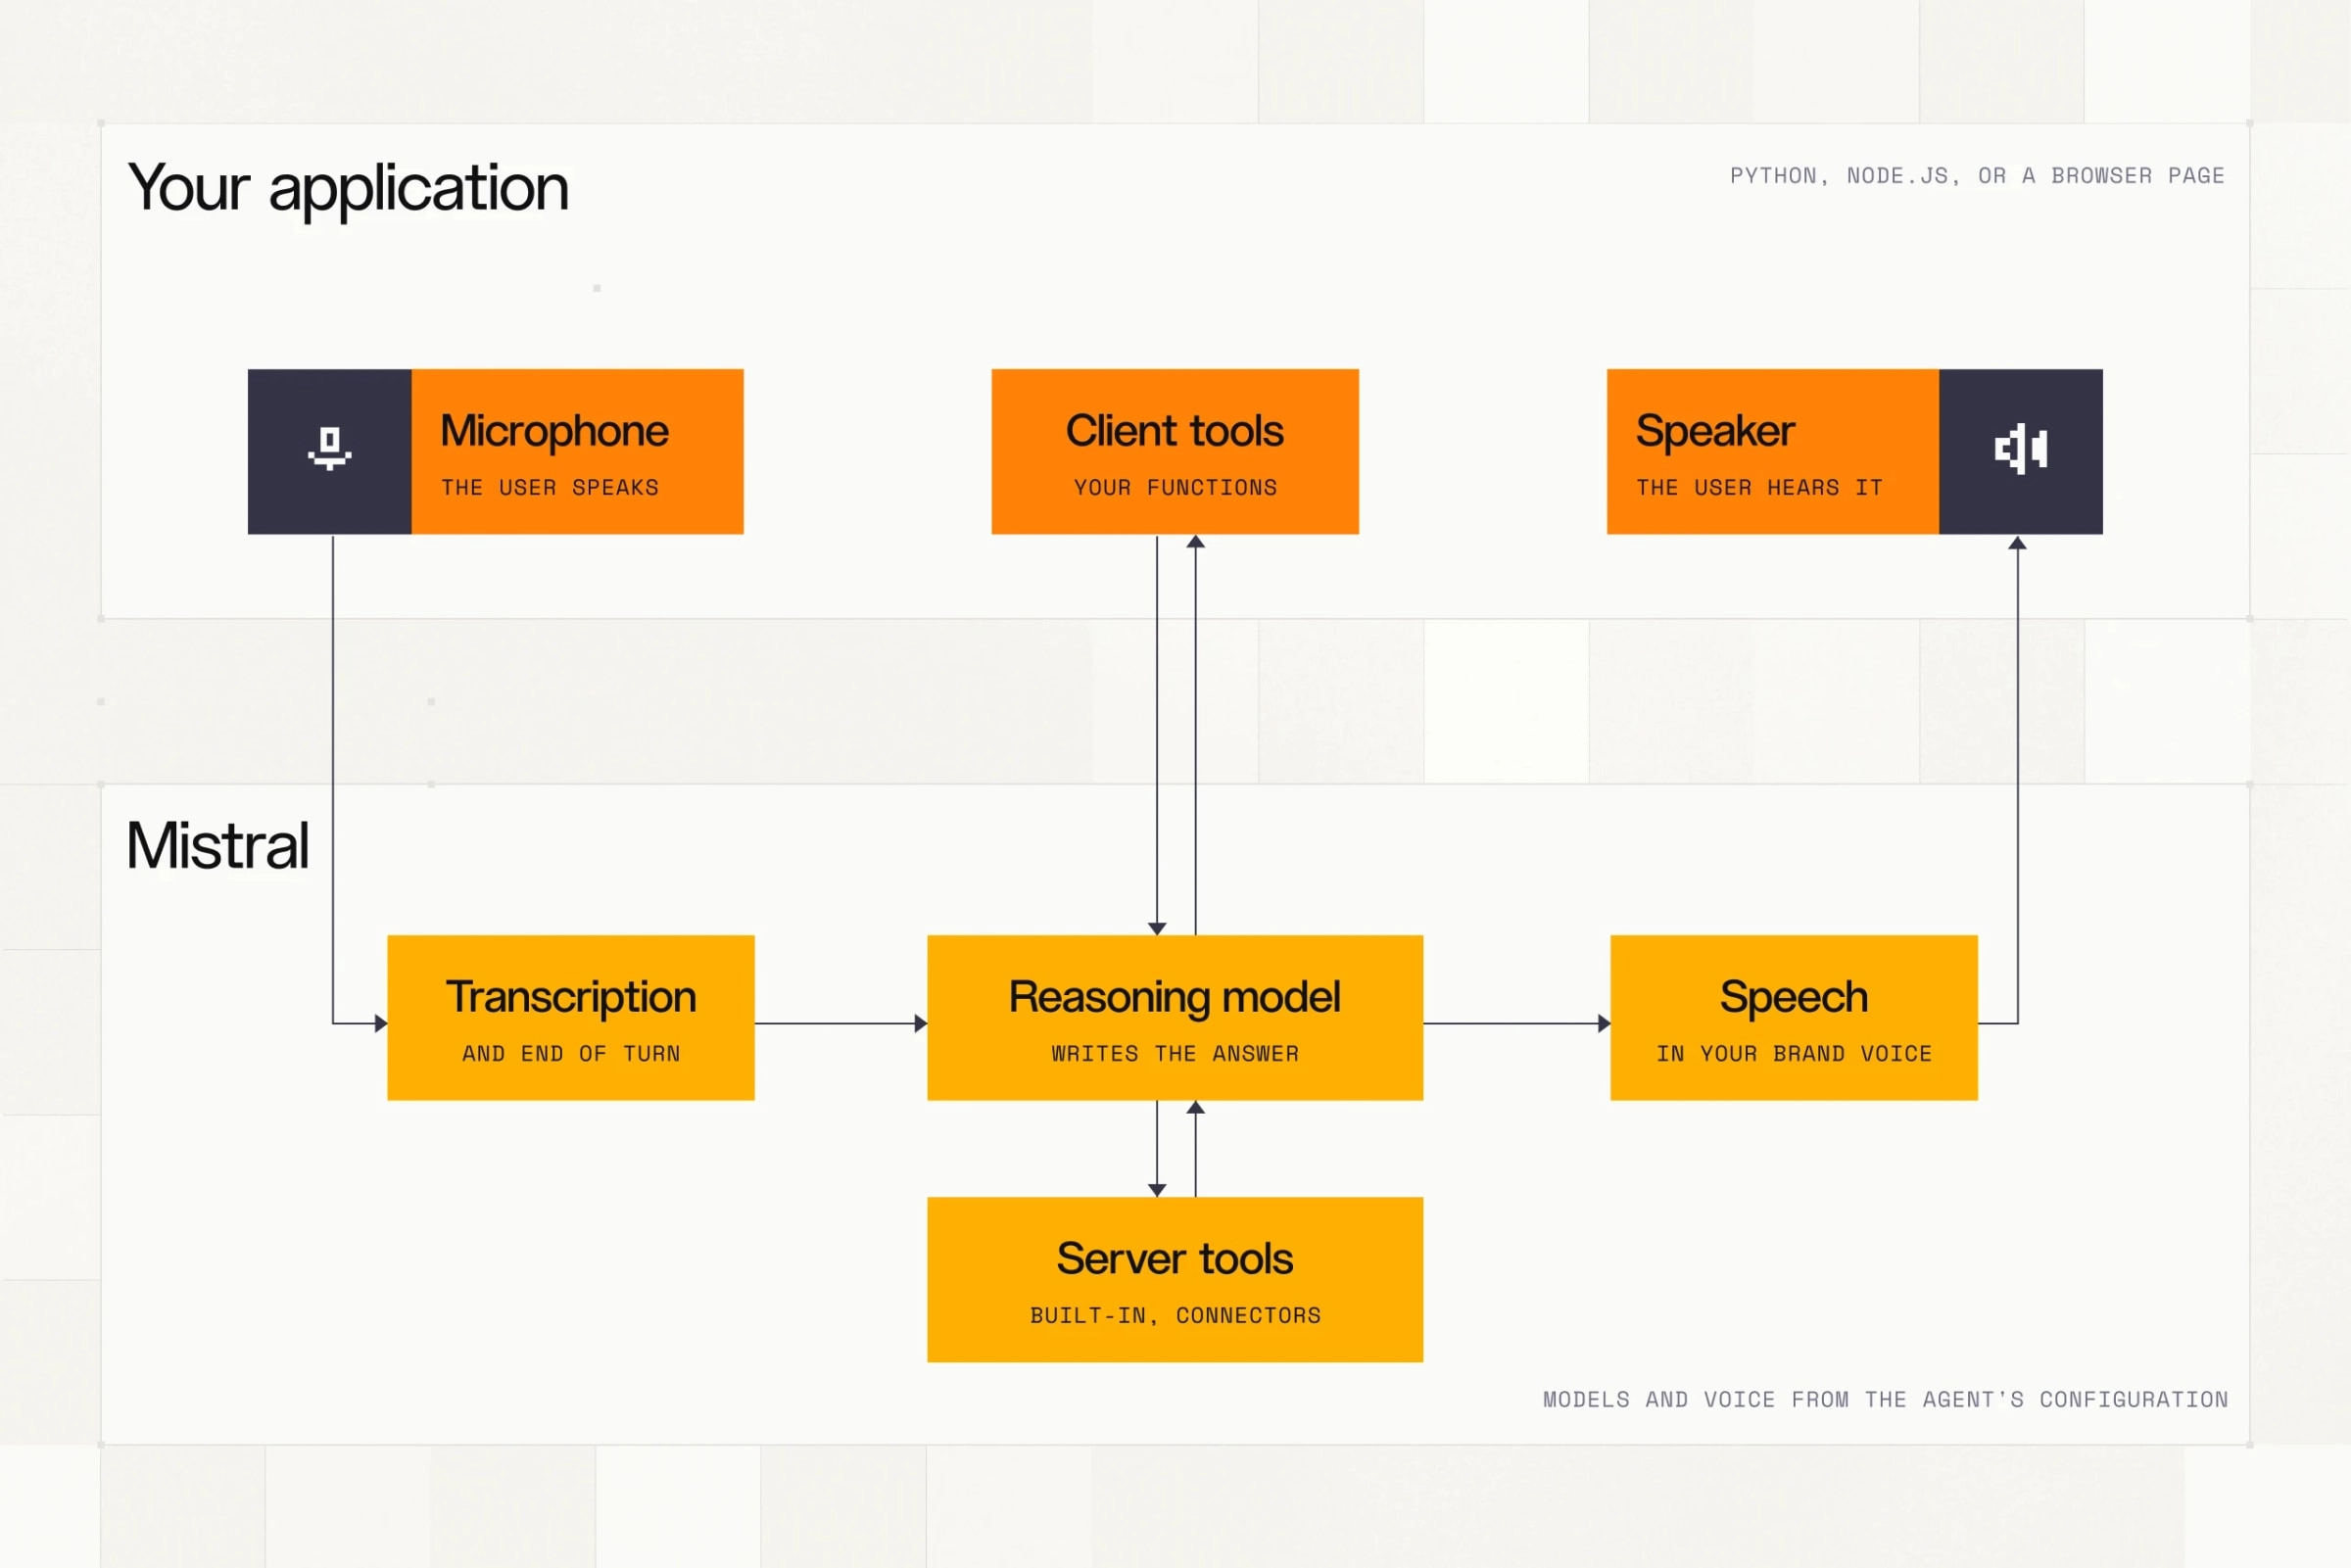 Figura: La arquitectura del agente de voz Voxtral 3 integra la entrada de audio del usuario, la inferencia del modelo, la ejecución de herramientas y la síntesis de voz en un bucle en tiempo real. Fuente: Anuncio oficial de Mistral AI.
Latencia e interrupciones indebidas: el obstáculo real
El margen admisible de latencia en una conversación entre persona y máquina es sumamente estrecho. En una charla presencial, las pausas naturales duran apenas unos cientos de milisegundos. Cuando la máquina tarda más de 800 milisegundos en responder, el usuario asume de inmediato que la comunicación se ha cortado. En los sistemas tradicionales en la nube, el retraso se acumulaba en cada tramo: subida del audio, cola del modelo hasta emitir el primer token y retransmisión del flujo de voz, superando con frecuencia el segundo completo.
Realtime Transcribe 3 reduce la transcripción en streaming a menos de 500 milisegundos, otorgando un margen vital para el posterior procesamiento de herramientas y la inferencia lingüística. Para los centros de atención telefónica, este margen es crucial: el sistema puede consultar bases de datos internas mientras el cliente aún está hablando y responder al instante en cuanto termina la frase.
Otro problema clásico es la interrupción a destiempo. Los primeros sistemas detectaban silencios basándose exclusivamente en umbrales de volumen sonoro; una respiración algo más fuerte o una pausa reflexiva provocaban que la máquina interrumpiera de golpe. Voxtral 3 combina análisis acústico con modelado semántico para predecir con exactitud el cierre de turno, evitando que los titubeos naturales mientras el interlocutor piensa sus palabras sean malinterpretados.
La tasa de error en 45 idiomas cae al 4 %
En cuanto a precisión de transcripción pura, Voxtral Small Transcribe 3 obtuvo una tasa de error de palabras (WER) del 4,0 % en el benchmark FLEURS a lo largo de 45 idiomas, mientras que la versión Mini de 4B alcanzó un 4,1 %. Como referencia, Whisper large-v3 registró un 16,0 % y un 14,9 % en la misma prueba, compitiendo frente a alternativas como Microsoft MAI-Transcribe-2, Gemini 3.5 Transcribe, Scribe v2 y GPT-Transcribe.
En los análisis comparativos multilingües de Artificial Analysis, Voxtral Small Transcribe 3 lideró los resultados en lenguas europeas como francés, español, italiano, portugués y neerlandés.
Sin embargo, lo que realmente preocupa a las empresas son los entornos ruidosos con múltiples interlocutores. En pruebas de diálogo con diarización de hablantes, Voxtral Small registró un cpWER (WER de permutación concatenada) del 18,4 %, frente al 38,4 % de Gemini 3.5 Transcribe, una diferencia que marca la línea entre un acta de reunión directamente aprovechable o una que exige horas de edición manual.
El vocabulario especializado representa otro escollo habitual. La función de sesgo de contexto (context biasing) permite precargar glosarios técnicos antes de transcribir, elevando la tasa de recuperación de términos clave del 81,4 % de partida a un 94,6 %. Nombres de medicamentos o códigos de catálogo interno ya no requieren corrección humana posterior.
 Figura: La implantación comercial de los modelos de voz se concentra en centralitas y centros de soporte con grandes volúmenes diarios de llamadas. Fuente: Anuncio oficial de Mistral AI.
La soberanía del dato define los grandes contratos
Superar los indicadores técnicos es únicamente el boleto de entrada. En procesos de licitación con bancos, aseguradoras y organismos gubernamentales, surge una barrera insoslayable: las grabaciones de voz en crudo contienen huellas vocales biométricas. Bajo el RGPD europeo y normativas internacionales de privacidad, la transferencia transfronteriza de estos datos está severamente restringida.
La mayoría de los proveedores estadounidenses solo ofrecen servicios en la nube gestionada, obligando a canalizar los flujos de voz por sus infraestructuras públicas. Mistral, en cambio, ofrece dos vías: conectarse a endpoints alojados íntegramente dentro de la Unión Europea o descargar los pesos de los modelos abiertos para desplegarlos en servidores locales (on-premise), dejando el control y la retención en manos del cliente. Para el sector público y financiero europeo, esta alternativa despeja un obstáculo legal de primer orden.
La competencia en IA de voz se ha desplazado definitivamente hacia los costes operativos y la soberanía jurídica sobre la información. Con una tasa de acierto plenamente madura para el uso diario, las soluciones que se están llevando los contratos son aquellas capaces de responder con claridad a dos cuestiones: cuánto cuesta el minuto de servicio y bajo qué bandera están operando los servidores.
Enlaces de referencia:
- Anuncio oficial de Mistral AI
- Debate técnico en Hacker News
- Informe comparativo de modelos de voz de Artificial Analysis
- Banco de pruebas BeSimple AI Voice Code Bench