Les démonstrations d’agents conversationnels vocaux impressionnent depuis deux ans, mais elles peinent toujours à s’intégrer dans les standards téléphoniques et les centres d’appels d’entreprise. Deux obstacles majeurs ont freiné leur adoption : des coûts d’appel imprévisibles, où les principales API cloud peuvent vite atteindre plusieurs dollars par heure de communication, et une latence excessive qui impose régulièrement des blancs de plus d’une seconde.
Le 21 octobre 2026, Mistral a officialisé sa gamme de modèles vocaux Voxtral 3, réalignant son modèle de facturation sur la grille tarifaire classique des télécommunications : la transcription est facturée 0,0035 dollar par minute, tandis que la synthèse vocale est comptabilisée au nombre de caractères. Grâce à cette grille tarifaire publique et transparente, l’agent vocal passe du statut de démonstrateur technologique à celui d’une décision d’approvisionnement concrète : combien coûte la minute de communication ?
Des démonstrations fluides, des factures impossibles à anticiper
Jusqu’à présent, la mise en place d’un dialogue vocal reposait sur un assemblage hétérogène : transcrire l’audio reçu en texte, transmettre ce texte à un grand modèle de langage pour formuler une réponse, puis renvoyer le résultat vers un moteur de synthèse vocale pour le lire à voix haute. Chaque maillon appliquait sa propre logique tarifaire – la transcription à la durée audio, l’inférence au token et la synthèse au nombre de caractères. Un simple appel au support client traversait ainsi trois structures de prix différentes, empêchant toute direction financière d’établir un plafond budgétaire fiable.
Voxtral 3 unifie ces composants au sein d’une seule chaîne de traitement : Voxtral Small Transcribe 3 prend en charge la transcription multilingue avec diarisation des interlocuteurs et biais contextuel ; Mini Transcribe 3 propose une déclinaison compacte à 4 milliards de paramètres taillée pour les déploiements économiques ; Realtime Transcribe 3 assure la transcription en streaming avec une latence de bout en bout inférieure à 500 millisecondes ; et Mini TTS 3 restitue une voix expressive pour 13 dollars par million de caractères. L’ensemble est complété par un SDK Voice Agent conçu pour gérer les échanges multi-tours et l’appel direct d’outils externes.
À 0,0035 dollar par minute, une heure complète de transcription avec le modèle 4B Mini Transcribe 3 ne revient qu’à 0,21 dollar. Dans sa communication officielle, Mistral a directement comparé cette offre aux tarifs d’OpenAI TTS-1, Deepgram, ElevenLabs Flash et Gemini Flash.
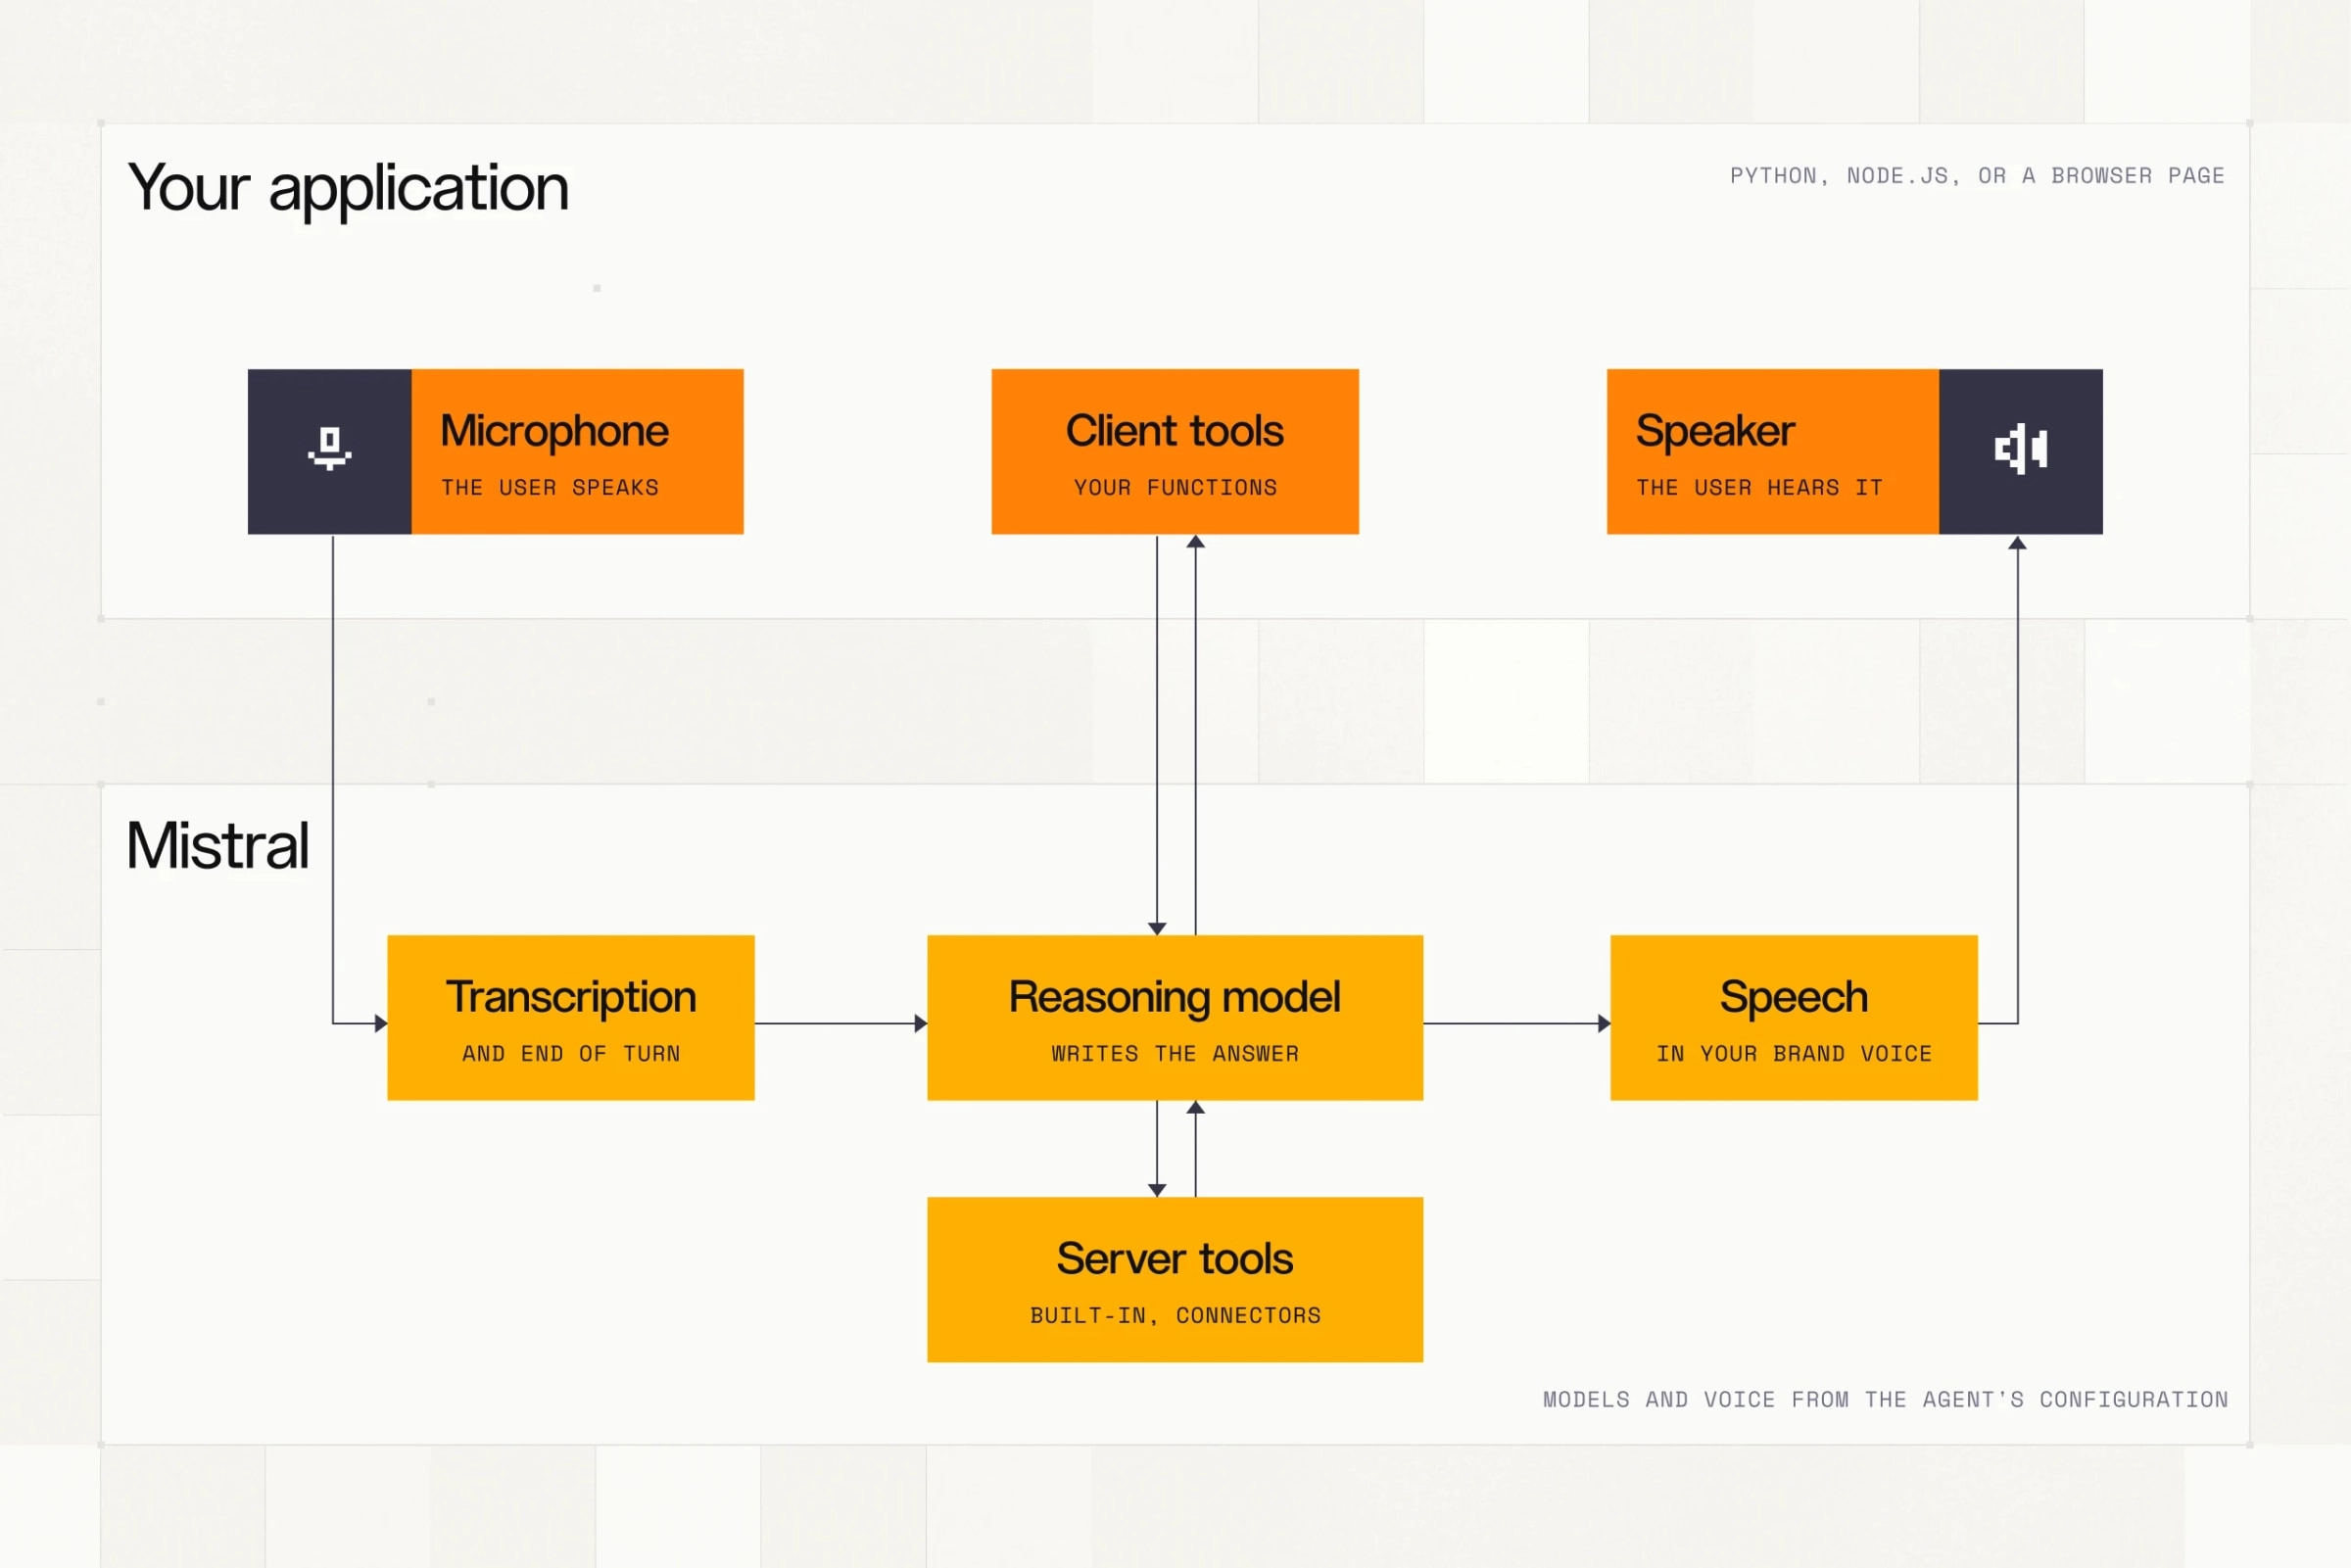 Figure : L’architecture de l’agent vocal Voxtral 3 réunit la saisie audio de l’utilisateur, l’inférence du modèle, l’exécution d’outils externes et la synthèse vocale au sein d’une boucle temps réel. Source : annonce officielle de Mistral AI.
Latence et interruptions intempestives : les véritables verrous
Le seuil de tolérance à la latence dans une conversation entre l’humain et la machine est particulièrement exigeant. Lors d’un échange direct, les pauses naturelles se comptent en quelques centaines de millisecondes. Dès lors qu’une machine hésite plus de 800 millisecondes, l’interlocuteur a le sentiment immédiat que la ligne est coupée. Dans les architectures cloud traditionnelles, les délais s’accumulent le long du parcours : téléversement de l’audio, attente en file pour produire le premier token, puis réémission du flux de synthèse, dépassant régulièrement la seconde pleine.
En comprimant la transcription en streaming sous la barre des 500 millisecondes, Realtime Transcribe 3 libère une marge temporelle indispensable pour l’appel d’outils et l’inférence linguistique. Pour les plateformes de service client, cette marge est déterminante : le système peut interroger les bases de données internes pendant que l’utilisateur s’exprime et lui répondre aussitôt sa phrase achevée.
Autre difficulté récurrente : les coupures de parole involontaires. Les premières générations de systèmes détectaient les silences uniquement à partir du niveau sonore. Une respiration plus marquée ou une brève hésitation au milieu d’une phrase suffisait pour que l’IA interrompe brutalement son interlocuteur. Voxtral 3 associe les caractéristiques acoustiques à l’analyse sémantique pour prédire précisément la fin d’un tour de parole, évitant ainsi d’interrompre l’utilisateur lorsqu’il cherche ses mots.
Un taux d’erreur ramené à 4 % sur 45 langues
Sur le plan de la précision pure de transcription, Voxtral Small Transcribe 3 a enregistré un taux d’erreur sur les mots (WER) de 4,0 % sur les 45 langues du banc d’essai FLEURS, la version Mini 4B obtenant pour sa part 4,1 %. À titre de comparaison, Whisper large-v3 s’établissait respectivement à 16,0 % et 14,9 % sur les mêmes données, aux côtés de Microsoft MAI-Transcribe-2, Gemini 3.5 Transcribe, Scribe v2 et GPT-Transcribe.
Dans les évaluations multilingues indépendantes menées par Artificial Analysis, Voxtral Small Transcribe 3 s’est hissé au premier rang sur plusieurs langues européennes, notamment le français, l’espagnol, l’italien, le portugais et le néerlandais.
Toutefois, les entreprises accordent une importance primordiale aux réunions comptant plusieurs intervenants simultanés. Dans les tests intégrant la diarisation des interlocuteurs, Voxtral Small affiche un cpWER (WER à permutations concaténées) de 18,4 %, contre 38,4 % pour Gemini 3.5 Transcribe – un écart qui conditionne directement l’exploitabilité d’un compte-rendu automatisé sans relecture manuelle fastidieuse.
La gestion du vocabulaire spécialisé constituait un autre point de friction. Grâce au biais contextuel (context biasing), les développeurs peuvent injecter des listes de terminologie métier avant la transcription, faisant passer le taux de rappel des termes clés de 81,4 % à 94,6 %. Les dénominations pharmaceutiques, le jargon technique ou les références d’articles n’ont plus à faire l’objet de corrections manuelles a posteriori.
 Figure : L’exploitation commerciale des modèles vocaux vise en priorité les centres de contacts et les réseaux téléphoniques d’entreprise à fort volume d’appels. Source : annonce officielle de Mistral AI.
La souveraineté des données tranche les appels d’offres
Afficher des performances techniques remarquables ne constitue qu’un prérequis d’admission. Lors des consultations d’entreprises dans le secteur bancaire, la santé ou le secteur public, un obstacle de conformité surgit immédiatement : les enregistrements audio bruts contiennent des empreintes vocales et sont qualifiés de données biométriques. Au regard du RGPD européen et des réglementations internationales sur la vie privée, le transfert transfrontalier de telles données fait l’objet de restrictions particulièrement sévères.
La plupart des acteurs nord-américains ne proposent que des services cloud gérés, contraignant les flux vocaux des clients à transiter par des infrastructures publiques basées outre-Atlantique. Mistral offre une double alternative : appeler des API hébergées exclusivement sur le territoire de l’Union européenne, ou télécharger les poids du modèle ouvert pour les déployer en local (on-premise) au sein de ses propres centres de calcul, laissant à l’entreprise la maîtrise totale de la conservation des données. Pour les acteurs financiers et institutionnels européens, cet atout lève une barrière juridique souvent rédhibitoire.
La compétition sur l’IA vocale s’est ainsi déplacée vers la maîtrise des coûts opérationnels et la souveraineté juridictionnelle. Dès lors que la fiabilité de transcription franchit le cap de l’usage courant, les solutions retenues sont celles qui répondent clairement à deux questions : combien coûte la minute de service, et sous quelle juridiction les serveurs sont-ils implantés ?
Liens de référence :
- Annonce officielle de Mistral AI
- Débats communautaires sur Hacker News
- Rapport d’évaluation des modèles vocaux par Artificial Analysis
- Banc d’essai BeSimple AI Voice Code Bench