음성 대화 인공지능의 시연은 지난 2년 동안 화려하게 이어졌지만, 실제 기업의 전화망과 고객센터 시스템에 전면 도입된 사례는 드물었다. 엔터프라이즈 도입을 가로막은 요인은 명확했다. 주요 클라우드 API를 사용할 때 시간당 수 달러에 달하는 예측 불가능한 통화 비용, 그리고 대화 도중 1초 이상 발생하는 어색한 지연 시간 때문이었다.
2026년 10월 21일, Mistral은 Voxtral 3 음성 모델 패밀리를 전격 발표하며 요금 체계를 통신 요금 청구 방식으로 재편했다. 음성 전사는 분당 0.0035달러, 음성 합성은 글자 수 기준으로 과금된다. 명확한 가격 정책이 공개되면서, 음성 에이전트는 “구현 가능한가”라는 기술적 검증 단계에서 “분당 얼마인가”라는 실질적인 조달 및 채산성 문제로 전환되었다.
매끄러운 시연과 예측 불가능한 청구서
지금까지 대화형 음성 시스템은 여러 독립 파이프라인을 엮어 조립하는 방식이 일반적이었다. 수신된 음성을 먼저 텍스트로 받아 적고, 대형 언어 모델에 전달해 응답을 생성한 뒤, 이를 다시 음성 합성 엔진에 전달해 낭독하도록 했다. 과금 기준 역시 제각각이었다. 전사는 오디오 재생 시간, 추론은 토큰 수, 합성은 글자 수로 계산되었다. 고객 지원 전화 한 통이 세 가지 청구 기준을 동시에 거쳐야 했기 때문에, 재무 부서에서 예산 상한선을 산정하기란 불가능에 가까웠다.
Voxtral 3는 이러한 복잡한 단계를 단일 파이프라인으로 통합했다. 화자 분리와 문맥 바이어싱을 지원하는 다국어 전사 모델 ‘Voxtral Small Transcribe 3’, 저비용 배포를 겨냥한 4B 매개변수 버전의 ‘Mini Transcribe 3’, 종단간 지연 시간을 500밀리초 미만으로 낮춘 스트리밍 전사 모델 ‘Realtime Transcribe 3’, 그리고 100만 자당 13달러로 감정 표현을 살려 출력하는 ‘Mini TTS 3’로 구성된다. 여기에 다중 턴 대화와 외부 도구 호출(Tool Calling)을 지원하는 음성 에이전트 개발 키트(SDK)가 함께 제공된다.
4B 크기의 Mini Transcribe 3는 분당 0.0035달러로, 한 시간 내내 전사를 실행해도 0.21달러(약 300원 미만)에 불과하다. Mistral은 공식 발표에서 OpenAI TTS-1, Deepgram, ElevenLabs Flash, Gemini Flash를 직접 비교 대상으로 제시하며 가격 경쟁력을 강조했다.
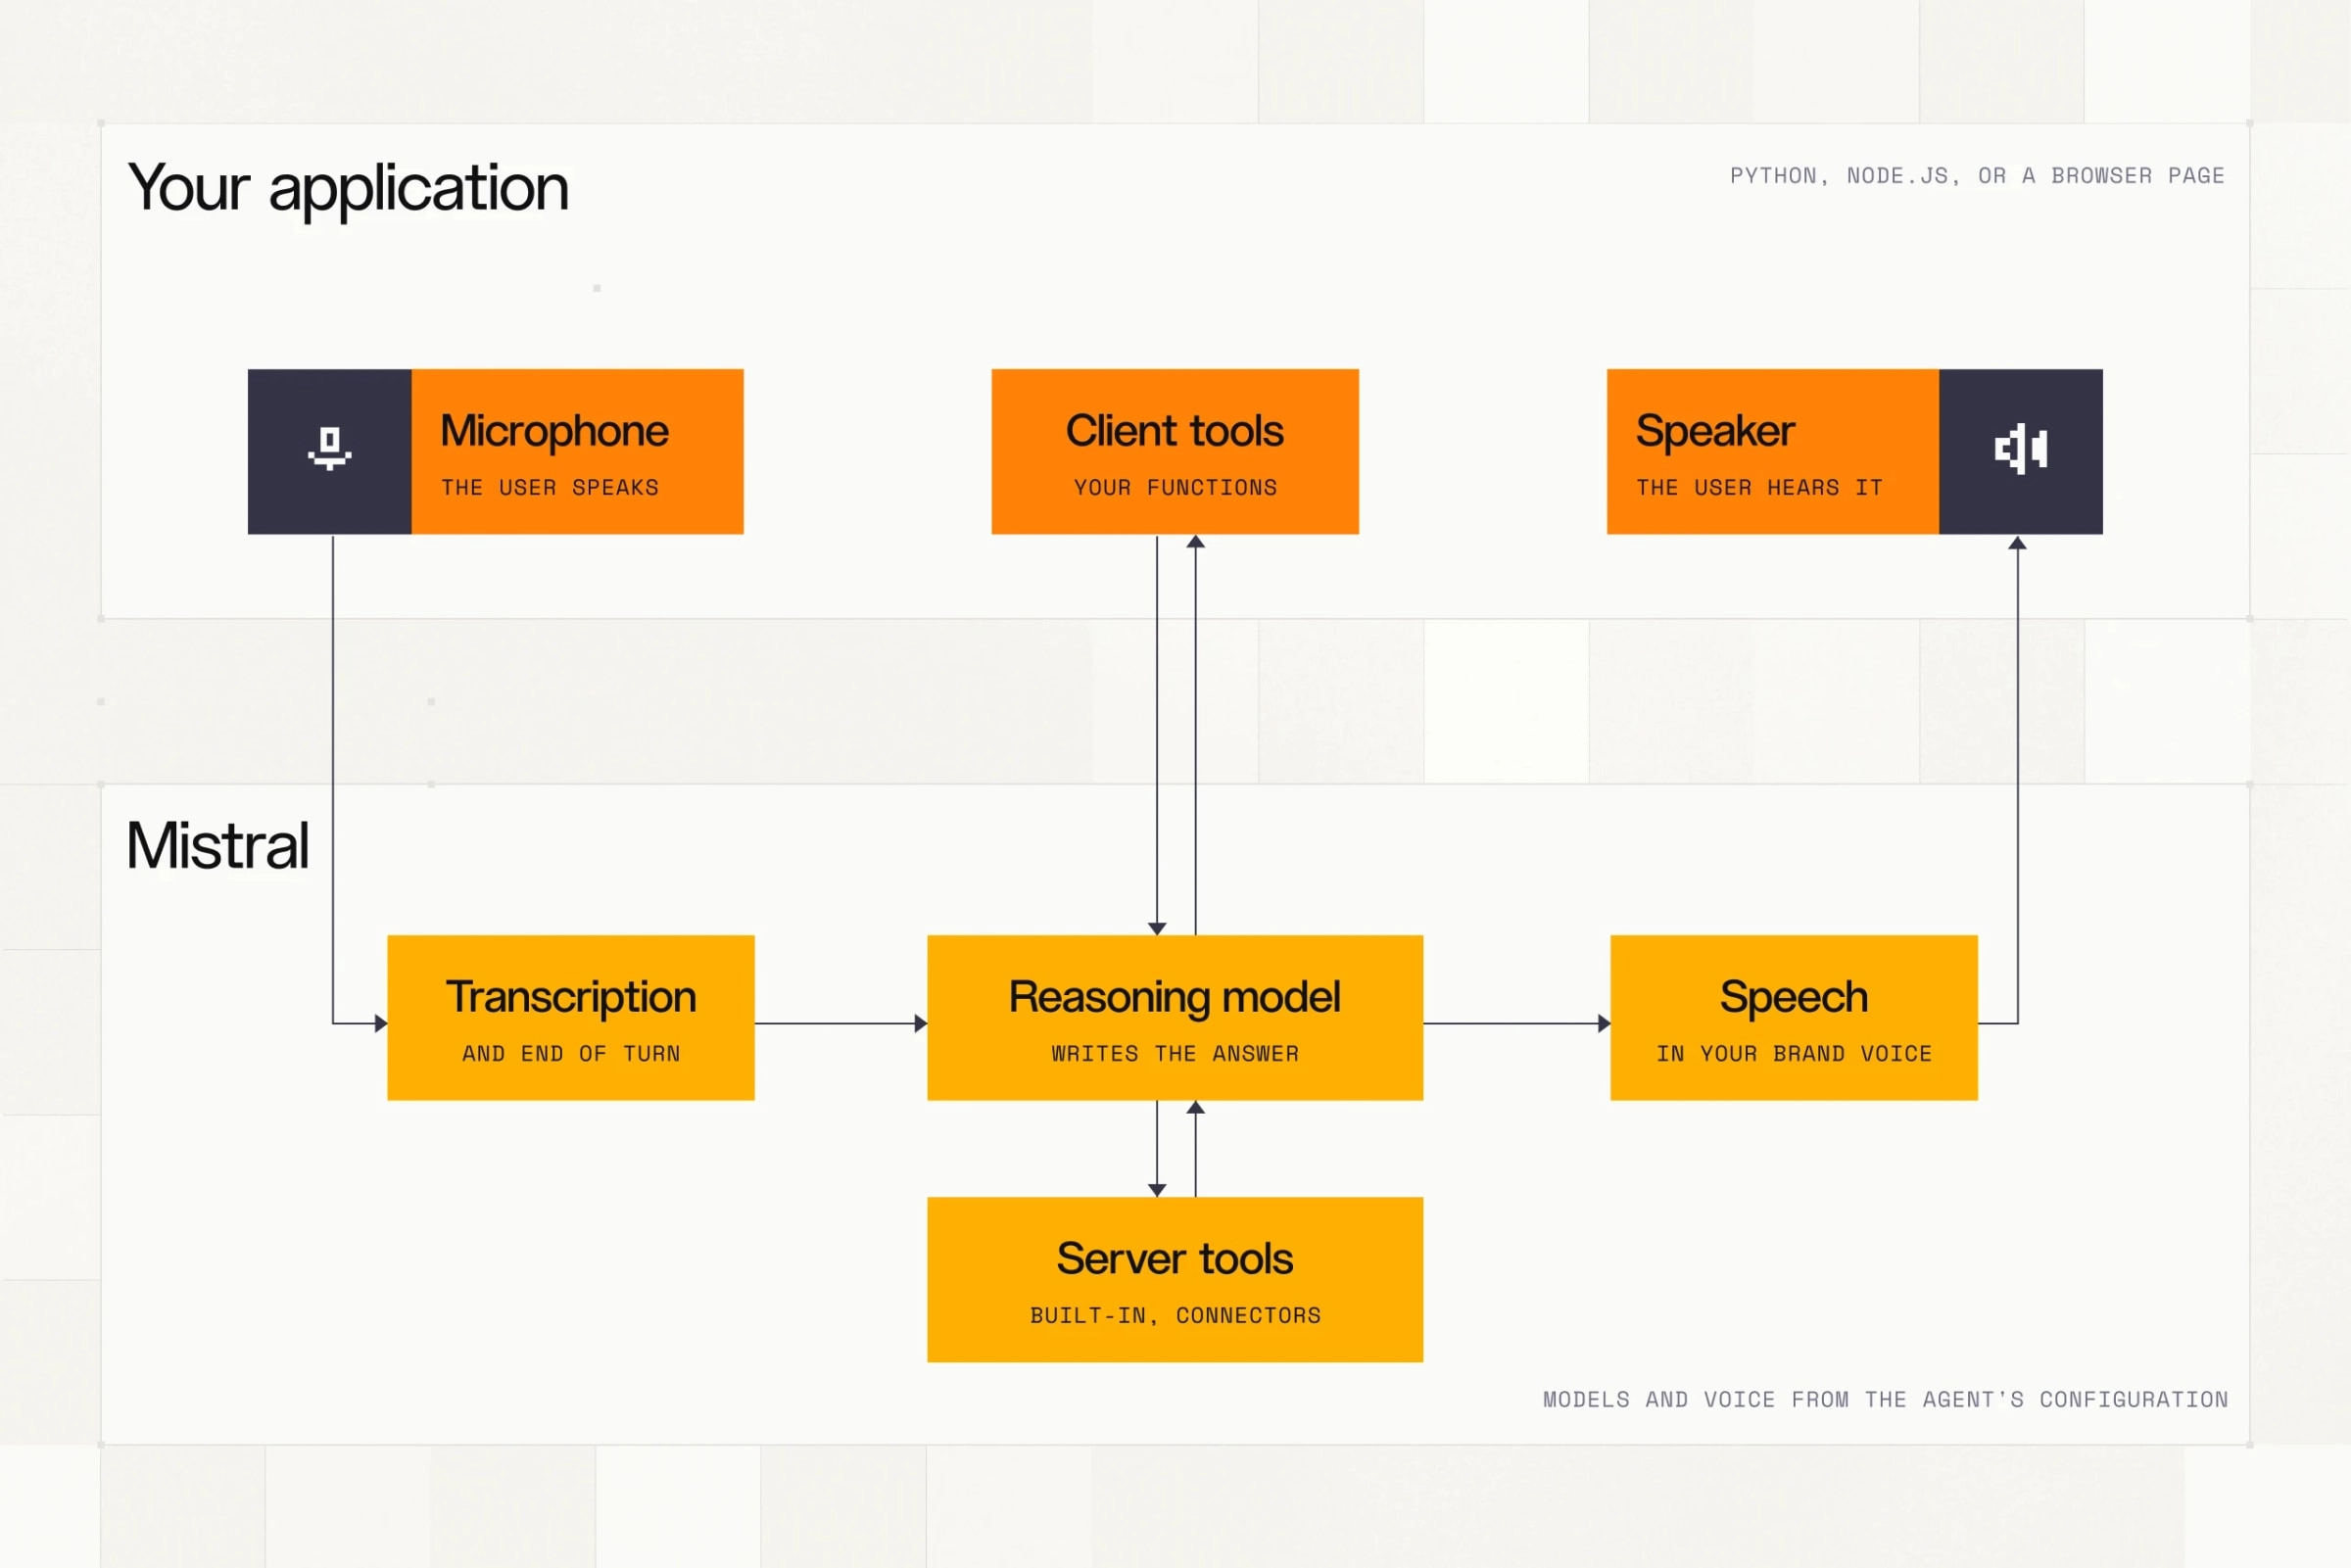 그림: 사용자 음성 입력, 모델 추론, 외부 도구 연동, 음성 합성을 실시간 루프로 엮어낸 Voxtral 3의 음성 에이전트 구조. 출처: Mistral AI 공식 발표
지연 시간과 말 끊김이 진정한 진입 장벽
인간과 기계의 음성 대화에서 지연 시간 허용치는 매우 엄격하다. 대면 대화에서 인간의 자연스러운 침묵 시간은 수백 밀리초 수준이다. 기계의 응답 정지가 800밀리초를 넘어가면 통화자는 회선이 끊어졌다고 느끼기 쉽다. 기존 클라우드 아키텍처는 음성 업로드, 첫 번째 토큰 생성을 위한 대기열, 합성 스트리밍 회신 등 여러 구간에서 지연이 누적되어 전체 응답 시간이 1초를 훌쩍 넘기 일쑤였다.
Realtime Transcribe 3는 스트리밍 전사 지연 시간을 500밀리초 미만으로 단축하여, 이어지는 도구 호출과 추론 과정에 충분한 여유를 확보했다. 이는 고객 상담 업무에서 결정적인 요소다. 고객이 말하는 도중에 백엔드 데이터를 미리 조회하고, 사용자의 발화가 끝나는 즉시 응답을 생성할 수 있기 때문이다.
또 다른 오랜 난제는 상대방의 말을 가로채는 문제였다. 기존 시스템은 음량 크기만으로 음성 활동 여부를 감지했기 때문에, 사용자의 거친 숨소리나 문장 중간의 짧은 쉼만으로도 기계가 끼어들어 말을 끊어버렸다. Voxtral 3는 음향 특징과 의미론적 문맥을 결합하여 발화 종료 시점을 판별하므로, 사용자가 단어를 고르며 잠시 뜸을 들이더라도 오작동하지 않는다.
45개 언어 대상 오류율 4%대로 단축
기본적인 전사 성능에서도 Voxtral Small Transcribe 3는 45개 언어를 아우르는 FLEURS 벤치마크에서 단어 오류율(WER) 4.0%를 기록했고, 4B 규모의 Mini 버전 역시 4.1%를 달성했다. 같은 평가에서 Whisper large-v3가 각각 16.0%와 14.9%를 기록한 것과 비교하면 큰 폭의 개선이다. 이 벤치마크에는 Microsoft MAI-Transcribe-2, Gemini 3.5 Transcribe, Scribe v2, GPT-Transcribe 등이 함께 참여했다.
Artificial Analysis의 다국어 평가 보고서에서도 Voxtral Small Transcribe 3는 프랑스어, 스페인어, 이탈리아어, 포르투갈어, 네덜란드어 등 유럽 주요 언어 전반에서 1위를 차지했다.
엔터프라이즈 현장에서 특히 중시하는 환경은 여러 사람이 동시에 대화하는 복합 환경이다. 화자 분리를 포함한 대화형 평가에서 Voxtral Small의 cpWER(결합 순열 단어 오류율)은 18.4%를 기록한 반면, Gemini 3.5 Transcribe는 38.4%에 머물렀다. 이러한 격차는 회의록 자동 작성 시스템을 실무에 바로 투입할 수 있는지 여부를 가르는 핵심 기준이 된다.
전문 용어 인식 또한 까다로운 영역이다. 문맥 바이어싱 기능을 활용하면 전사 실행 전에 맞춤형 용어 사전을 모델에 주입할 수 있어, 키워드 재현율이 기본 기준선인 81.4%에서 94.6%까지 향상된다. 의약품 명칭이나 특정 제품 부품 번호 등을 전사한 후 일일이 수작업으로 교정할 필요가 없어진다.
 그림: 음성 모델의 대규모 상용화는 막대한 통화량을 소화하는 고객 서비스와 엔터프라이즈 전화망에 집중되어 있다. 출처: Mistral AI 공식 발표
데이터 주권이 엔터프라이즈 계약을 결정한다
기술 지표는 시장 진입을 위한 최소 요건일 뿐이다. 금융, 의료, 공공 부문의 조달 과정에서는 또 다른 문턱을 넘어야 한다. 통화자의 고유 성문이 포함된 원본 음성은 민감한 생체 인식 정보에 해당하며, 유럽연합의 GDPR을 비롯한 글로벌 개인정보 보호 규정에 따라 국외 이전이 엄격히 통제되기 때문이다.
북미의 주요 클라우드 벤더 대다수는 완전 관리형 서비스만을 제공하므로, 고객의 오디오 스트림이 미국 공공 클라우드를 반드시 통과해야 한다. 반면 Mistral은 두 가지 경로를 제시한다. 유럽연합 역내에 위치한 데이터센터 API를 호출하거나, 오픈 모델 가중치를 다운로드하여 기업 자체 데이터센터에 온프레미스로 직접 구축하는 방식이다. 데이터 보관과 통제권을 고객사가 온전히 유지할 수 있다는 점은 유럽 금융권 및 공공기관과의 협상에서 중대한 법적 걸림돌을 제거해 준다.
음성 AI의 경쟁 구도는 단순한 인식 정확도 경쟁을 넘어 운영 엔지니어링 비용과 데이터 관할권 확보로 이동했다. 정확도가 실무 기준치를 넘어선 지금, 최종 계약을 따내는 솔루션은 두 가지 질문에 명확히 답할 수 있어야 한다. 바로 분당 비용이 얼마인가, 그리고 서버가 누구의 관할권 아래 놓여 있는가이다.
참고 링크:
- Mistral AI 공식 발표
- Hacker News 커뮤니티 기술 토론
- Artificial Analysis 음성 모델 평가 보고서
- BeSimple AI Voice Code Bench 평가 기준