Demos gesprochener KI-Dialoge begeistern seit zwei Jahren, doch in realen Telefonsystemen von Unternehmen sind sie bisher selten angekommen. Unternehmen scheitern vor allem an zwei Hürden: unvorhersehbare Betriebskosten, bei denen gängige Cloud-APIs schnell mehrere Dollar pro Stunde verschlingen, und lähmende Latenzzeiten, die immer wieder zu Sprechpausen von über einer Sekunde führen.
Am 21. Oktober 2026 stellte Mistral seine Modellfamilie Voxtral 3 vor und richtete das Abrechnungsmodell konsequent an den Gewohnheiten klassischer Telekommunikationstarife aus: Die Audiotranskription kostet exakt 0,0035 Dollar pro Minute, während die Sprachsynthese nach Zeichen abgerechnet wird. Mit dieser transparenten Preisstruktur verwandelt sich der Einsatz von Sprach-Agenten von einer technischen Machbarkeitsstudie in eine pragmatische Beschaffungsentscheidung: Was kostet die Betriebsminute?
Beeindruckende Demos, unkalkulierbare Rechnungen
Bislang basierten dialogorientierte Sprachsysteme meist auf zusammengefügten Einzellösungen: Das gesprochene Audio wurde zunächst transkribiert, an ein großes Sprachmodell übergeben, um eine Antwort zu erzeugen, und der generierte Text anschließend an eine Sprachsynthese-Engine weitergeleitet. Jeder Teilschritt hatte seine eigene Metrik – Transkription nach Audiominuten, Inferenz nach Token und Synthese nach Zeichenanzahl. Ein einziger Anruf beim Kundendienst durchlief drei getrennte Tarifstrukturen, was die Festlegung verlässlicher Budgetgrenzen für Finanzabteilungen fast unmöglich machte.
Voxtral 3 fasst diese Schritte in einer einheitlichen Pipeline zusammen: Voxtral Small Transcribe 3 übernimmt die mehrsprachige Transkription inklusive Sprechertrennung (Diarisierung) und Kontext-Biasing; Mini Transcribe 3 bietet als 4B-Parameter-Modell eine besonders ressourcenschonende Bereitstellung; Realtime Transcribe 3 ermöglicht Streaming-Transkriptionen mit einer Ende-zu-Ende-Latenz von unter 500 Millisekunden; und Mini TTS 3 generiert emotionale Sprachausgabe für 13 Dollar pro Million Zeichen. Ergänzend liefert Mistral ein Voice Agent SDK, das mehrstufige Dialoge und native Tool-Aufrufe direkt unterstützt.
Mit 0,0035 Dollar pro Minute schlägt eine volle Stunde Transkription mit dem 4B-Modell Mini Transcribe 3 mit lediglich 0,21 Dollar zu Buche. In der offiziellen Ankündigung verglich Mistral diese Konditionen direkt mit OpenAI TTS-1, Deepgram, ElevenLabs Flash und Gemini Flash.
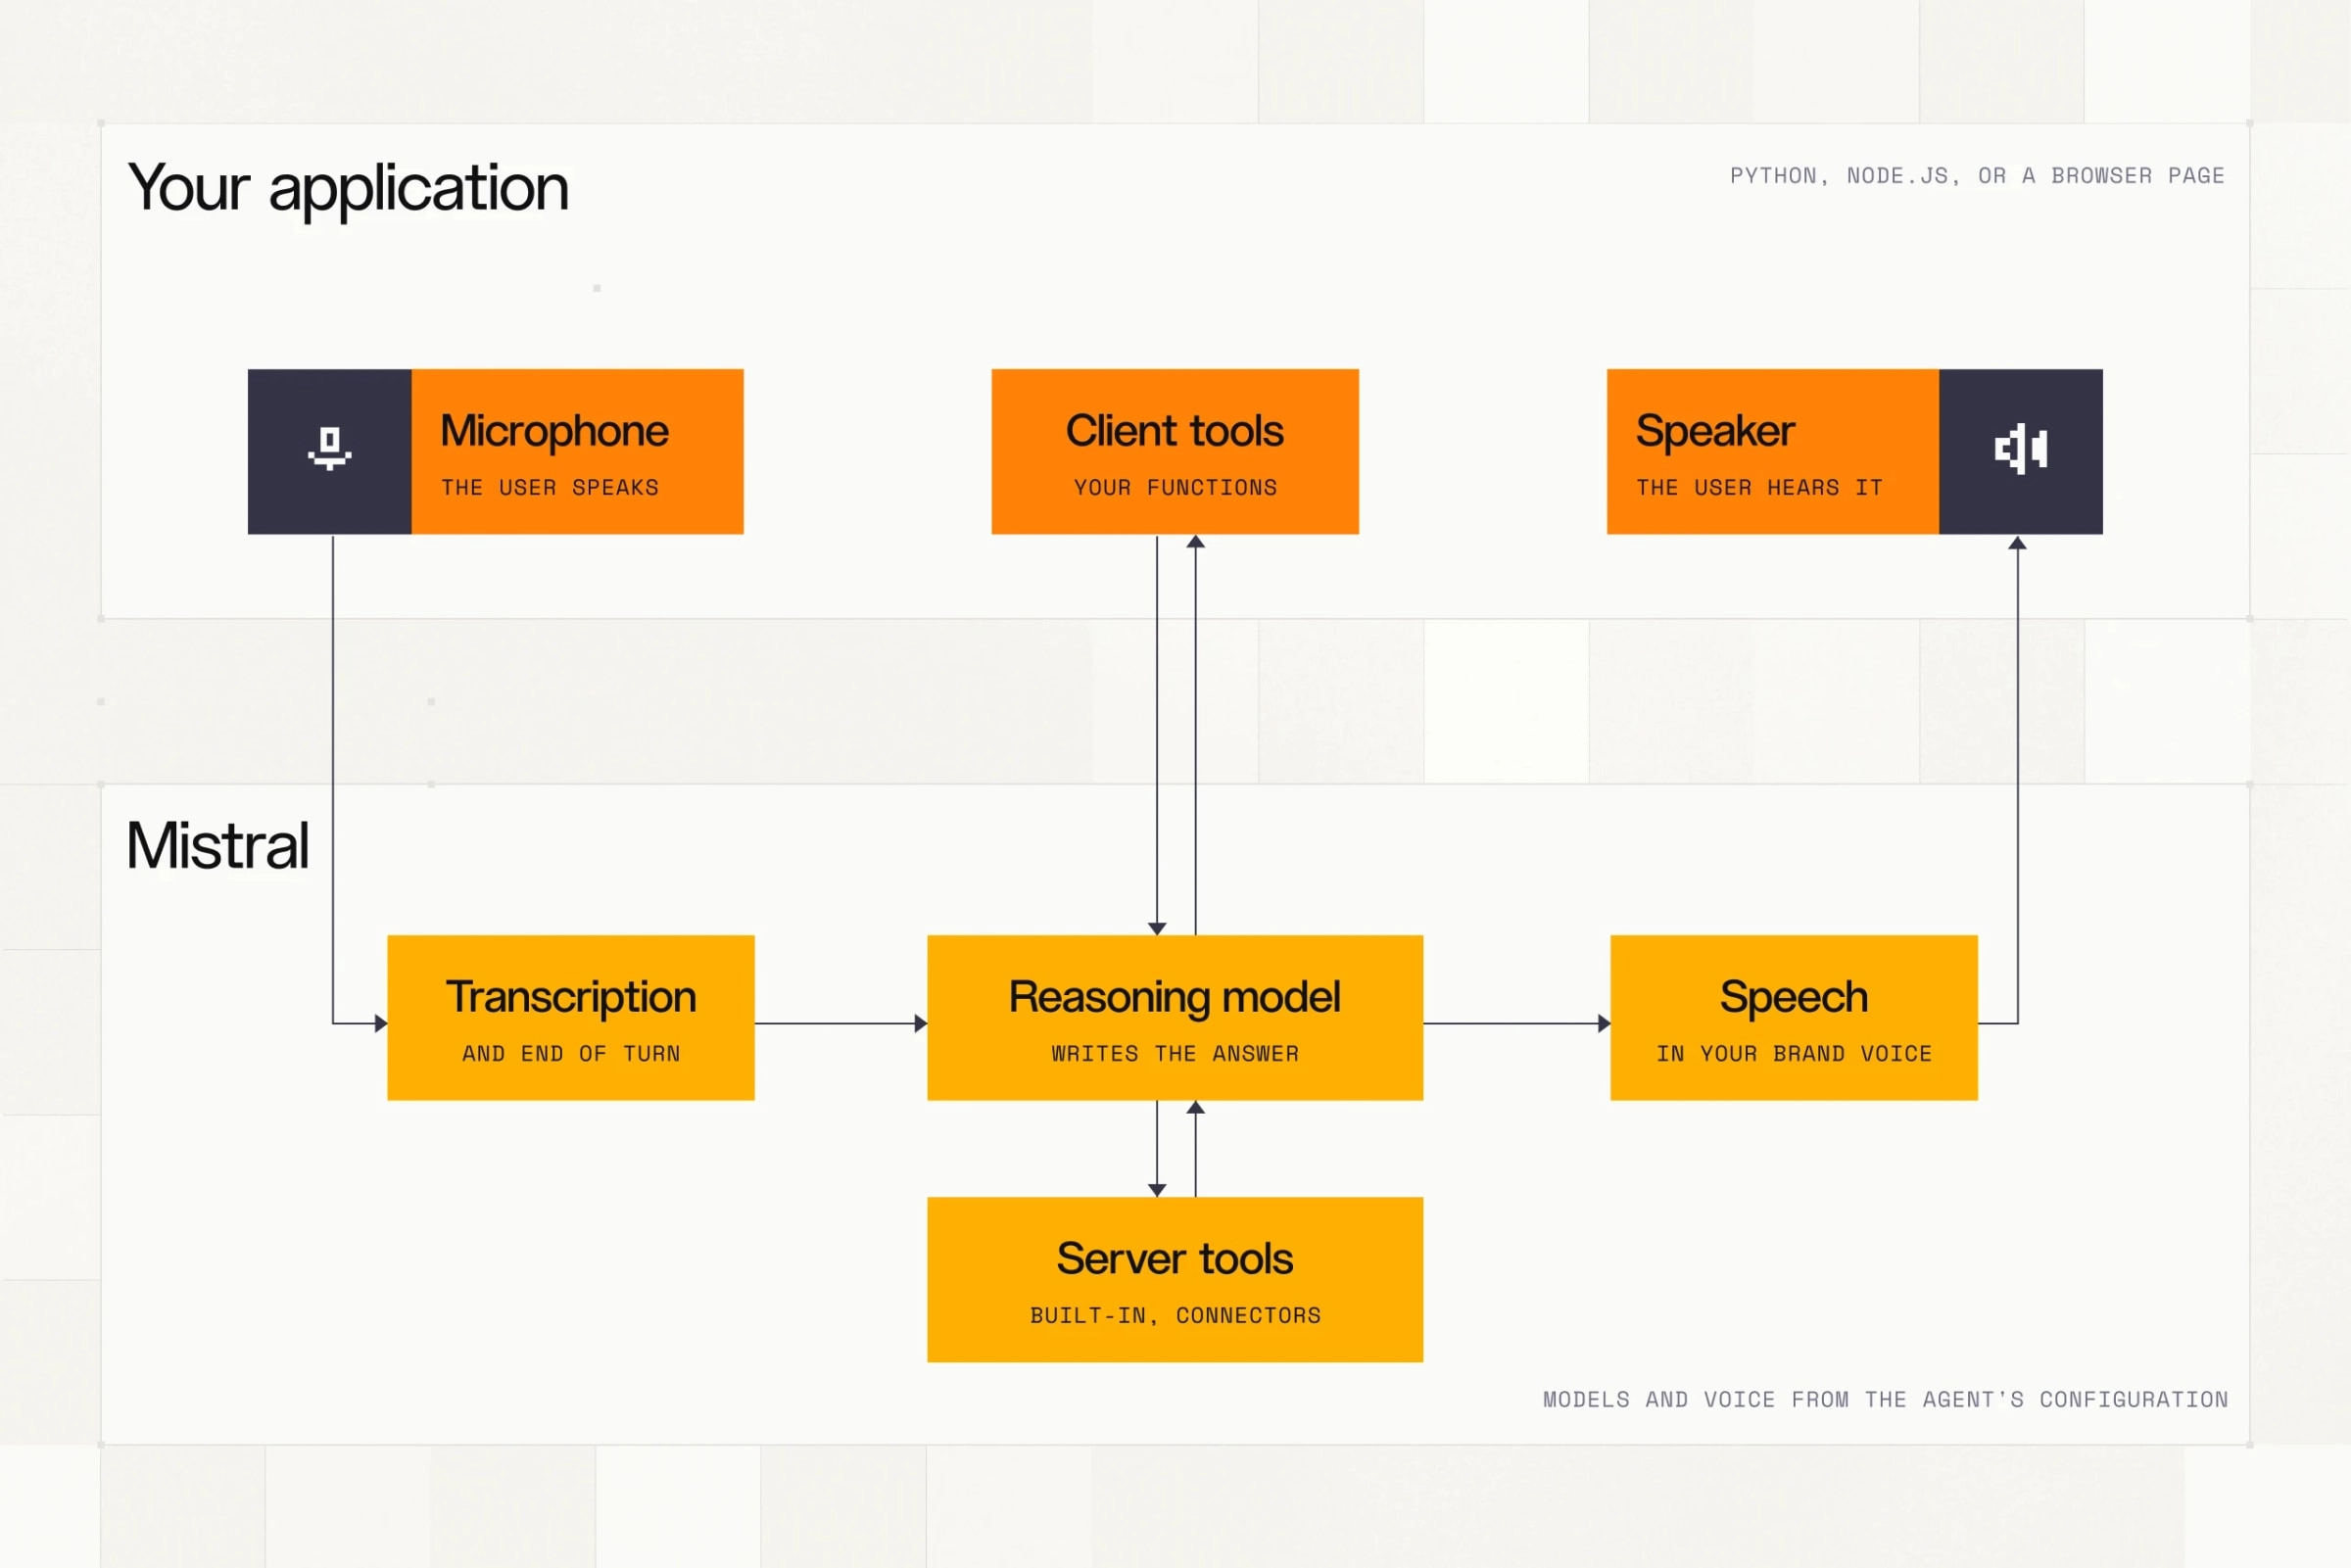 Abbildung: Die Architektur des Voxtral 3 Voice Agent verbindet Benutzeraudio, Modellinferenz, externe Tool-Aufrufe und Sprachsynthese zu einem echtzeitfähigen Dialogkreislauf. Quelle: Offizielle Ankündigung von Mistral AI.
Latenz und Gesprächsunterbrechungen als reale Barrieren
Die Toleranzgrenzen für Verzögerungen bei der Mensch-Maschine-Kommunikation sind eng gesteckt. Im persönlichen Gespräch zwischen Menschen dauern natürliche Pausen meist nur wenige hundert Millisekunden. Wenn ein System länger als 800 Millisekunden schweigt, vermutet der Anrufer instinktiv einen Verbindungsabbruch. In traditionellen Cloud-Setups summiert sich die Latenz über mehrere Stationen – Audio-Upload, Warteschlangen für das erste Token und das Zurücksenden des Audiosignals –, sodass Antwortzeiten oft eine Sekunde überschreiten.
Realtime Transcribe 3 drückt die Latenz beim Streaming unter 500 Millisekunden. Dadurch entsteht wertvoller zeitlicher Spielraum für nachgelagerte Inferenzschritte und Tool-Aufrufe. Im Kundendienst ist dieser Puffer entscheidend: Das System kann Backend-Systeme abfragen, während der Kunde noch spricht, und unmittelbar antworten, sobald der Sprecher geendet hat.
Ein weiteres Dauerthema ist das unbeabsichtigte Unterbrechen des Anrufers. Frühe Systeme nutzten simple Lautstärkeschwellen zur Spracherkennung. Ein tiefer Atemzug oder eine kurze Denkpause führten dazu, dass die KI ins Wort fiel. Voxtral 3 kombiniert akustische Merkmale mit semantischem Kontext, um das tatsächliche Ende eines Redebeitrags präzise vorherzusagen. Zögernde Dehnlaute beim Formulieren lösen keine Fehlentscheidung mehr aus.
Fehlerraten über 45 Sprachen auf 4 % gesenkt
Bei der reinen Transkriptionsleistung erreichte Voxtral Small Transcribe 3 im FLEURS-Benchmark über 45 Sprachen hinweg eine Wortfehlerrate (WER) von 4,0 %, während die 4B-Mini-Variante auf 4,1 % kam. Zum Vergleich: Whisper large-v3 verzeichnete im selben Test 16,0 % bzw. 14,9 %, gemessen im direkten Vergleich mit Microsoft MAI-Transcribe-2, Gemini 3.5 Transcribe, Scribe v2 und GPT-Transcribe.
Im unabhängigen Mehrsprachen-Vergleich von Artificial Analysis belegte Voxtral Small Transcribe 3 Spitzenplätze in europäischen Sprachen wie Französisch, Spanisch, Italienisch, Portugiesisch und Niederländisch.
In der Unternehmenspraxis zählt vor allem die Stabilität in lebhaften Meetings mit mehreren Beteiligten. Bei Tests mit Sprechertrennung erzielte Voxtral Small eine cpWER (Concatenated Permutation WER) von 18,4 %, während Gemini 3.5 Transcribe bei 38,4 % lag – ein Unterschied, der darüber entscheidet, ob Protokolle direkt nutzbar sind oder aufwendig nachbearbeitet werden müssen.
Fachbegriffe stellten bisher ein weiteres Hindernis dar. Dank Context Biasing können Entwickler spezifische Vokabellisten vorab einspeisen, wodurch die Trefferquote für Schlüsselbegriffe von 81,4 % auf 94,6 % steigt. Medizinische Präparate oder firmeninterne Teilenummern müssen dadurch nicht mehr mühsam manuell korrigiert werden.
 Abbildung: Der kommerzielle Fokus für Sprachmodelle liegt auf hochvolumigen Kundenzentren und unternehmensweiten Telefonnetzen. Quelle: Offizielle Ankündigung von Mistral AI.
Datensouveränität entscheidet über den Zuschlag
Hervorragende Benchmarks sind lediglich die Eintrittskarte. In Ausschreibungen von Banken, Versicherungen und Behörden folgt eine entscheidende Hürde: Unverarbeitete Audiodaten enthalten unverwechselbare Stimmabdrücke und gelten als biometrische Daten. Gemäß der europäischen DSGVO und vergleichbaren Datenschutzgesetzen unterliegt der grenzüberschreitende Transfer strengsten Auflagen.
Viele US-amerikanische Anbieter offerieren ausschließlich Managed-Cloud-Dienste, bei denen Kundenströme zwangsläufig über internationale Public-Cloud-Infrastrukturen geleitet werden. Mistral geht einen anderen Weg: Kunden können Schnittstellen nutzen, die garantiert innerhalb der Europäischen Union gehostet werden, oder die offenen Modellgewichte herunterladen, um sie komplett im eigenen Rechenzentrum on-premise zu betreiben. Die volle Kontrolle über Datenspeicherung und -verarbeitung beseitigt wesentliche juristische Vorbehalte europäischer Sicherheits- und Compliance-Beauftragter.
Der Wettbewerb um Sprach-KI dreht sich längst nicht mehr nur um Benchmark-Werte, sondern um operative Wirtschaftlichkeit und Datensouveränität. Wenn die Transkriptionsqualität für den Alltag ausreicht, gewinnen die Anbieter den Markt, die zwei grundlegende Fragen beantworten können: Wie viel kostet die Betriebsminute und in wessen Hoheitsgebiet stehen die Server?
Weiterführende Links:
- Mistral AI Offizielle Ankündigung
- Hacker News Community-Diskussion
- Artificial Analysis Sprachmodell-Vergleichsbericht
- BeSimple AI Voice Code Bench Benchmark