Prix de sortie divisé par 9, coût par tâche divisé par 20
Le 16 novembre 2026, Tencent Hunyuan a officialisé le lancement de Hy4 flash. Sur la grille tarifaire de son API, le prix de sortie s’établit à 0,281 dollar par million de tokens, contre 2,501 dollars pour le modèle précédent Hy4, soit une réduction d’un facteur 8,9. L’écart se creuse encore davantage pour les entrées mises en cache, atteignant un facteur 14 (0,003 dollar contre 0,042 dollar). Pourtant, le chiffre le plus impressionnant se trouve au cœur du banc d’essai interne WorkIndex de Tencent : pour accomplir exactement les mêmes tâches, le coût moyen par tâche de Hy4 flash ne représente qu’un vingtième de celui de Hy4.
 Figure : Visuel principal de la page de lancement de Hy4 flash. Source : Tencent Hunyuan
Les conférences annonçant des baisses de tarifs se sont multipliées ces deux dernières années dans le secteur des modèles de langage, mais diviser par vingt le coût réel d’une tâche accomplie constitue une première. Le token reste la plus petite unité de facturation, correspondant approximativement à un mot ou une partie de mot, mais une tâche concrète en milieu professionnel mobilise facilement des centaines de milliers de tokens. Si le tarif unitaire diminue mais que le modèle devient verbeux, la facture globale continue de grimper. Tencent a tout simplement choisi de remplacer l’étalon de mesure : au lieu de comparer le coût unitaire par token, l’évaluation repose sur la tâche menée à terme. Et dès que l’étalon change, la hiérarchie des modèles est entièrement bousculée.
Un tel niveau d’économie ne peut pas reposer sur de simples remises commerciales ; il exige de traquer les inefficacités couche par couche, depuis l’architecture du modèle jusqu’à la pile d’inférence. La stratégie d’économie de Hy4 flash s’articule autour de trois paliers : l’architecture, l’ingénierie d’inférence et le post-entraînement. Voici l’analyse détaillée de chacun de ces niveaux.
Tarification au token, facturation à la tâche
WorkIndex est une suite d’évaluation développée en interne par Tencent, composée de huit tâches pratiques directement assimilables à des prestations de travail concrètes : création de présentations, modification de diapositives, rédaction collaborative de présentations entre l’humain et l’IA, coécriture de documents Markdown, édition documentaire, correction de feuilles de calcul, traitement audio et vidéo, et compréhension visuelle. Selon les données officielles, les performances globales de Hy4 flash dépassent légèrement celles de Hy4 preview, tandis que son coût moyen par tâche chute à 1/13 de celui de Hy4 preview, 1/20 de celui de Hy4 et 1/8 de celui de DeepSeek-V4.1-Flash-1017 (évalué en palier Max aux heures de pointe).
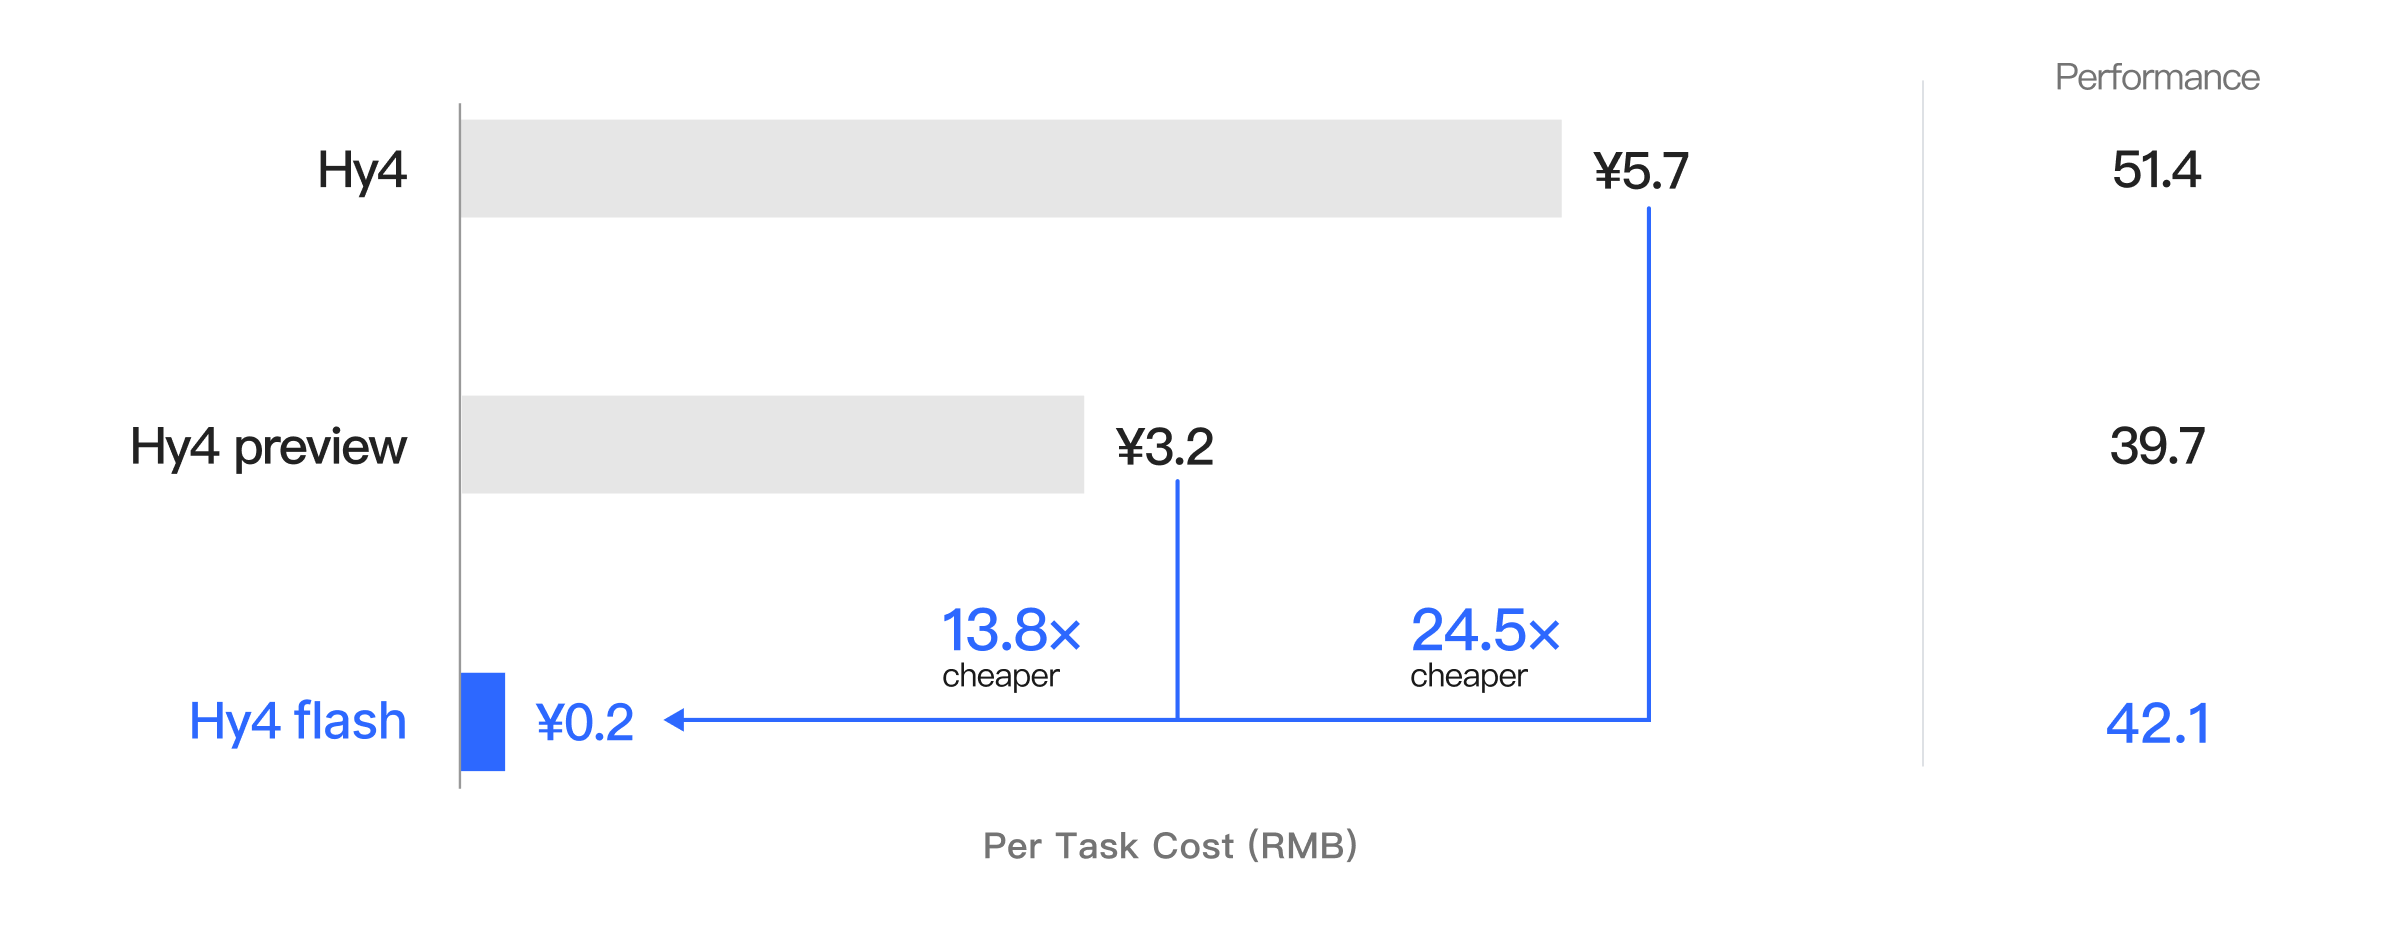 Figure : Figure 1 officielle : Distribution performance-coût sur les 8 jeux d’évaluation WorkIndex et sur 7 bancs d’essai publics d’agents. L’axe horizontal représente le coût et non le score. Source : Tencent Hunyuan
La clé de lecture de ce graphique est explicitée dans sa légende : les scores de performance demeurent quasiment stables, tandis que les coûts s’effondrent d’un facteur 8 à 20. En plaçant le coût sur l’axe principal, Tencent affiche une position claire : avant d’interroger les capacités d’un modèle, il faut d’abord évaluer ce qu’il coûte à l’usage. À mesure que les écarts de scores se resserrent sur les classements publics, la variable qui crée une véritable rupture se déplace inévitablement vers la colonne des dépenses.
Premier levier : le cache KV compressé à 1/24
Pour comprendre l’origine de cette baisse, il convient de rappeler le rôle du cache KV (Key-Value Cache). À chaque fois qu’un modèle de langage traite un texte étendu, il conserve un carnet de notes consignant les relations d’attention entre chaque token et le contexte qui le précède. Ce carnet n’est autre que le cache KV. Plus ce carnet est épais, plus il consomme de mémoire vidéo sur le GPU, plus le nombre de pages à parcourir à chaque étape de génération augmente, et plus les coûts d’infrastructure s’envolent. Dans les traitements à contexte long, la rétention de ce carnet en mémoire concentre l’essentiel des dépenses matérielles.
Hy4 flash associe trois innovations architecturales : l’attention hybride (qui module l’intensité des calculs selon les segments de texte pour économiser les ressources sur les passages simples), le LatentMoE (une architecture de mélange d’experts où la grande majorité des paramètres reste inactive et n’est sollicitée qu’à la demande) et le module Engram. D’après les chiffres officiels, le volume mémoire du cache KV est ramené à 1/24 de celui de Hy3 et à 1/6 de celui de Hy4. En réduisant ce carnet à une infime fraction de sa taille initiale, une fenêtre de contexte d’un million de tokens devient enfin économiquement viable. L’injection de documents volumineux ne sature plus la mémoire GPU, autorisant un effondrement des tarifs. Le tarif de 0,003 dollar par million de tokens d’entrée mis en cache découle directement de cette avancée : les contextes déjà traités n’ont plus besoin d’être recalculés et la place mémoire requise devient négligeable, entraînant une chute symétrique des coûts de stockage.
L’architecture MoE s’attaque quant à elle à l’efficacité du calcul : sur 224B paramètres au total (dont 64B dédiés au module Engram), seuls 12B sont activés pour chaque token. Imaginez une équipe de 224 collaborateurs où chaque mot entrant ne mobilise que 12 personnes, tandis que les autres restent au repos sans générer de charge. Mobiliser la puissance de calcul strictement à la demande sans consommer d’énergie sur les paramètres inactifs constitue la base d’ingénierie qui rend possibles ces prix planchers.
Exécution rapide, réponses concises
Si l’architecture allège l’empreinte mémoire, l’ingénierie d’inférence s’attaque au temps d’exécution machine. La pile d’inférence de Hy4 flash s’appuie sur trois briques clés : les mégakernels (qui fusionnent l’intégralité de la boucle de décodage dans un programme GPU unifié pour éliminer les temps de transfert de données entre modules), la quantification 4 bits (qui compresse les paramètres pour économiser la bande passante mémoire) et l’ordonnancement DFly. Les métriques officielles font état d’une vitesse de décodage supérieure à 150 tokens par seconde. La rentabilité d’un tarif bas repose sur la rapidité : plus un GPU génère de tokens à la seconde, plus la charge de machine amortie par token est faible, garantissant un modèle économique pérenne.
Le post-entraînement s’attaque directement au volume de tokens produits. Hy4 flash a d’abord bénéficié d’une autodistillation à partir de son grand modèle de référence Hy4 afin d’hériter de ses aptitudes générales, avant d’être affiné par apprentissage par renforcement pour formuler des réponses claires en minimisant les détours verbaux. Selon les relevés officiels, le nombre moyen de tokens de sortie de bout en bout a diminué de 50 %. Les tokens de sortie constituant le palier tarifaire le plus onéreux (0,281 dollar contre 0,070 dollar pour l’entrée standard), réduire le texte de moitié permet de couper immédiatement la facture en deux. Parmi les trois niveaux d’optimisation, il s’agit du levier le plus immédiat.
C’est uniquement par la multiplication de ces trois paliers que le ratio d’un vingtième est atteint : l’architecture réduit la mémoire à un niveau marginal, l’ingénierie d’inférence compresse le temps de calcul, et le post-entraînement divise par deux les tokens les plus coûteux. Aucune de ces mesures prise isolément n’aurait permis de gagner un ordre de grandeur sur les coûts. La véritable compétitivité tarifaire relève de l’ingénierie logicielle et matérielle, non de simples remises commerciales : la première est gravée dans l’architecture du modèle et sa pile d’exécution, la seconde ne survit pas aux campagnes marketing.
Chiffres officiels : comment les interpréter
Une mise en contexte des sources s’impose : l’ensemble des données chiffrées provient des communications institutionnelles de Tencent. WorkIndex est un banc d’essai propriétaire dont les épreuves et les modèles de comparaison ont été définis en interne, sans validation indépendante par des tiers à ce stade. Tout résultat issu d’une auto-évaluation comporte naturellement un biais favorable à son auteur et doit être interprété avec recul.
Cependant, plusieurs signaux convergents apportent une cohérence d’ensemble. Lors d’un test en double aveugle mené auprès de 85 utilisateurs internes de WorkBuddy, sur 259 tâches réparties en 27 catégories, le niveau de satisfaction suscité par Hy4 flash s’est révélé comparable à celui de Claude Haiku 5.5, avec le délai d’exécution de bout en bout le plus court et un coût par tâche sensiblement inférieur à tous les modèles concurrents. Les déploiements opérationnels confirment cette tendance : dans l’assistant de bureau WorkBuddy, la durée moyenne de traitement a baissé de 70 % pour un coût voisin de 1/15 de celui de Hy4 ; sur WeCom (la déclinaison d’entreprise de WeChat), l’assistant DaYuan a généré ses réponses 88 % plus vite tout en réduisant d’environ 60 % les tokens en mode réflexion ; sur QQ, le module Xiao Q a vu son taux de satisfaction progresser de 6,16, 2,84, 0,92 et 2,22 points de pourcentage sur la recommandation musicale, les canaux d’échange, Qzone et les analyses thématiques étendues ; enfin, Yuanbao a enregistré un bond de 13,6 % des performances de ses agents par rapport à Hy3.
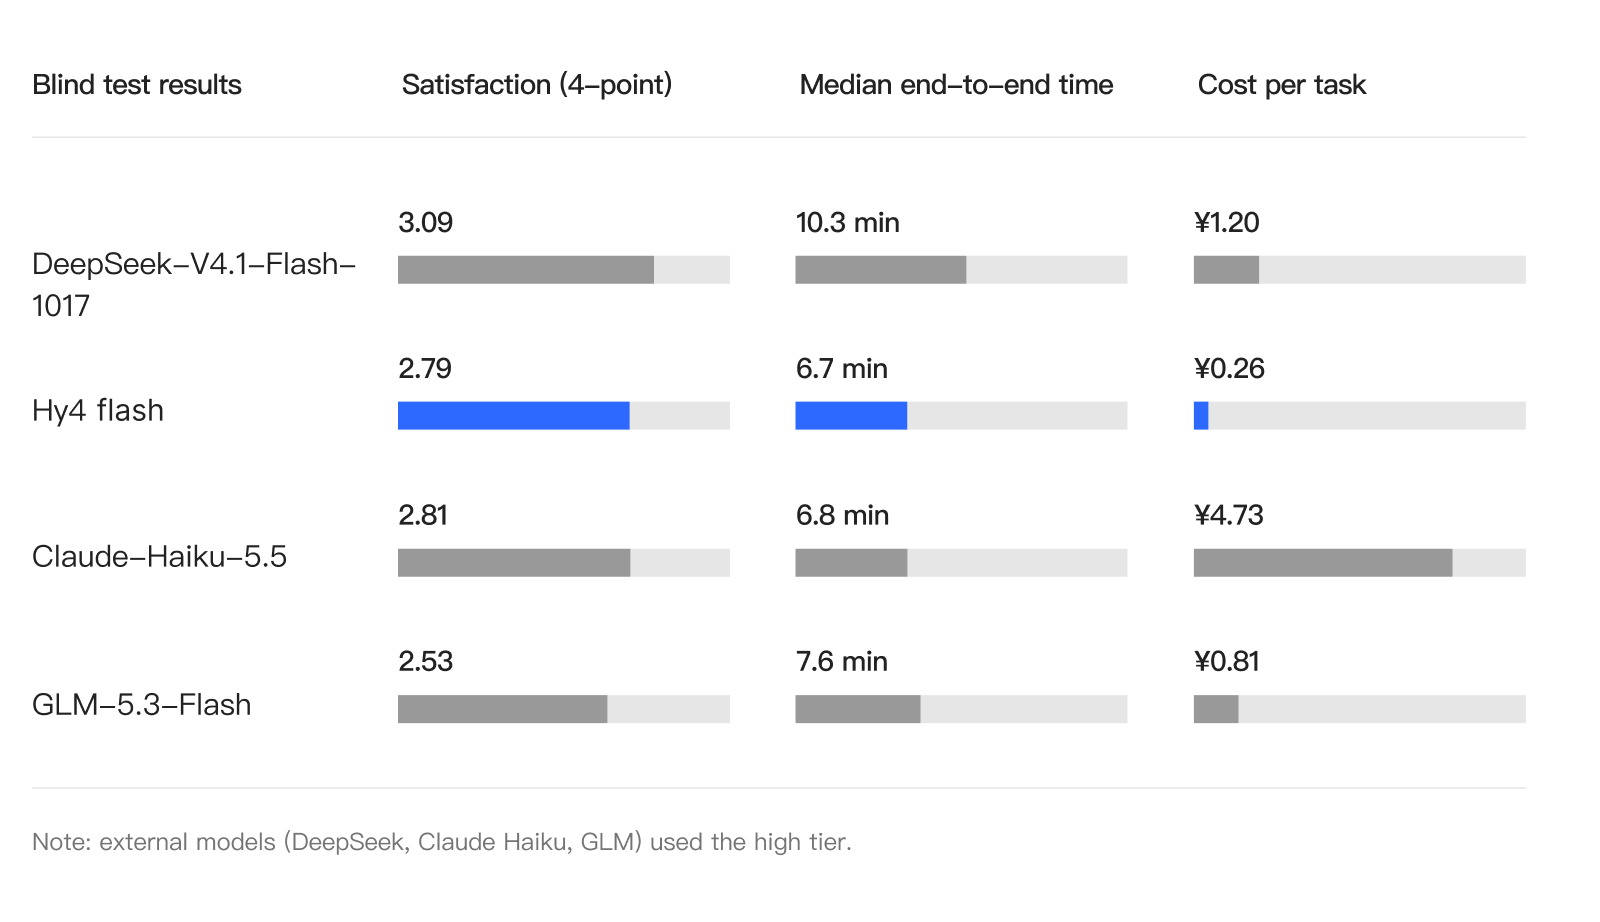 Figure : Résultats du test en double aveugle auprès de 85 utilisateurs de WorkBuddy sur 259 tâches et 27 catégories. Satisfaction rivalisant avec Haiku 5.5 et délai d’exécution le plus court. Source : Tencent Hunyuan
S’il est aisé d’adapter un banc d’essai interne à son avantage, il s’avère bien plus complexe d’orchestrer des gains simultanés sur plusieurs produits totalement cloisonnés. Le fait que les outils bureautiques, les agents conversationnels et les systèmes autonomes progressent de concert démontre que cette architecture d’optimisation fonctionne bel et bien en environnement de production. En attendant les vérifications de laboratoires tiers pour confirmer les valeurs précises, la dynamique technique est crédible.
Une nouvelle grille d’évaluation pour les modèles de pointe
Dans son communiqué, Tencent délimite clairement les cas d’usage : pour les tâches courantes de productivité — recherche approfondie, traitement documentaire, génération de diapositives, démonstrations rapides d’interfaces web et computer use (le contrôle direct de l’environnement graphique d’un ordinateur par le modèle) —, Hy4 flash est le choix recommandé. Pour l’ingénierie logicielle complexe à horizon long, Tencent préconise toujours l’usage du modèle Hy4 standard en raison de ses capacités de raisonnement supérieures. Les deux versions coexistent : la déclinaison flash l’emporte sur le plan financier, tandis que Hy4 conserve l’avantage sur le plafond d’intelligence pure.
Les canaux de distribution sont déjà accessibles : Tencent Cloud TokenHub, WorkBuddy, Yuanbao, WeCom, QQ, ima et Marvis, l’intégration sur OpenRouter étant attendue prochainement. L’accès à WorkBuddy reste gratuit jusqu’au 30 novembre, assorti d’une réduction de 50 % sur l’API TokenHub. Tencent prévoit en outre de publier les poids du modèle en open source. Une fois le code rendu public, la proportion d’équipes et d’entreprises qui adopteront cette recette (cache KV réduit à 1/24, mégakernels et division par deux des tokens de sortie) constituera le véritable test d’évaluation de cette approche.
Revenons à l’indicateur évoqué en introduction : à l’heure où les scores d’intelligence des modèles de pointe se resserrent, le coût par tâche devient l’un des rares leviers capables d’engendrer des écarts d’un ordre de grandeur. L’économie de Hy4 flash découle d’un travail d’optimisation minutieux mené de front sur l’architecture, le pipeline d’inférence et le post-entraînement, sans altérer les capacités généralistes du système. Cette rentabilité s’inscrit au cœur du modèle et de sa pile d’exécution, prête à être étudiée et reproduite. La compétition des modèles de pointe se joue désormais sur deux tableaux : les performances académiques d’un côté, le montant de la facture de l’autre. Dès lors que la course à l’intelligence ne suffit plus à créer une différence décisive, la bataille du coût d’exploitation ne fait que commencer.
Liens de référence :
- Page officielle de lancement de Tencent Hunyuan Hy4 flash