Precios de salida divididos por 9, coste por tarea dividido por 20
El 16 de noviembre de 2026, Tencent Hunyuan presentó Hy4 flash. En la lista oficial de precios de la API, la tarifa de salida se sitúa en 0,281 dólares por millón de tokens, frente a los 2,501 dólares del modelo previo Hy4, lo que representa una reducción de 8,9 veces. La diferencia de precio para las entradas en caché es todavía mayor, alcanzando las 14 veces: 0,003 dólares frente a 0,042 dólares. Sin embargo, la cifra más reveladora se encuentra en el índice de referencia interno WorkIndex: al realizar exactamente el mismo trabajo, el coste medio por tarea de Hy4 flash es una vigésima parte del de Hy4.
 Figura: Imagen principal del lanzamiento de Hy4 flash. Fuente: Tencent Hunyuan
En los últimos dos años se han visto innumerables eventos de reducción de precios en modelos de lenguaje, pero rebajar el coste real por tarea terminada a una vigésima parte no tiene precedentes. Un token es la unidad mínima de facturación en estos modelos, equivalente aproximadamente a una palabra o media palabra, y cualquier tarea real del entorno profesional consume con facilidad cientos de miles de tokens. Si el precio unitario baja pero el modelo se vuelve excesivamente locuaz, la factura final sigue aumentando. Tencent ha decidido cambiar la vara de medir: en lugar de evaluar el coste por token, mide el coste por tarea completada. Y cuando se cambia la regla de medir, la clasificación cambia con ella.
Alcanzar tal nivel de ahorro no se sostiene con meras promociones comerciales; exige recortar costes capa por capa en la arquitectura del modelo y en el entorno de inferencia. La estrategia de ahorro de Hy4 flash se divide en tres niveles: arquitectura, ingeniería de inferencia y postentrenamiento. A continuación se desglosa cada uno de ellos.
Precios por token, pagos por tarea
WorkIndex es un conjunto de pruebas de evaluación desarrollado internamente por Tencent, compuesto por ocho tareas prácticas directamente facturables: generación de presentaciones, edición de diapositivas, redacción colaborativa de diapositivas entre humanos e IA, coescritura de documentos en Markdown, edición documental, corrección de hojas de cálculo, procesamiento de audio y vídeo, y comprensión visual. Según los datos oficiales, el rendimiento general de Hy4 flash supera ligeramente al de Hy4 preview, mientras que su coste medio por tarea representa 1/13 del de Hy4 preview, 1/20 del de Hy4 y 1/8 del de DeepSeek-V4.1-Flash-1017 (calculado en nivel Max durante horas punta).
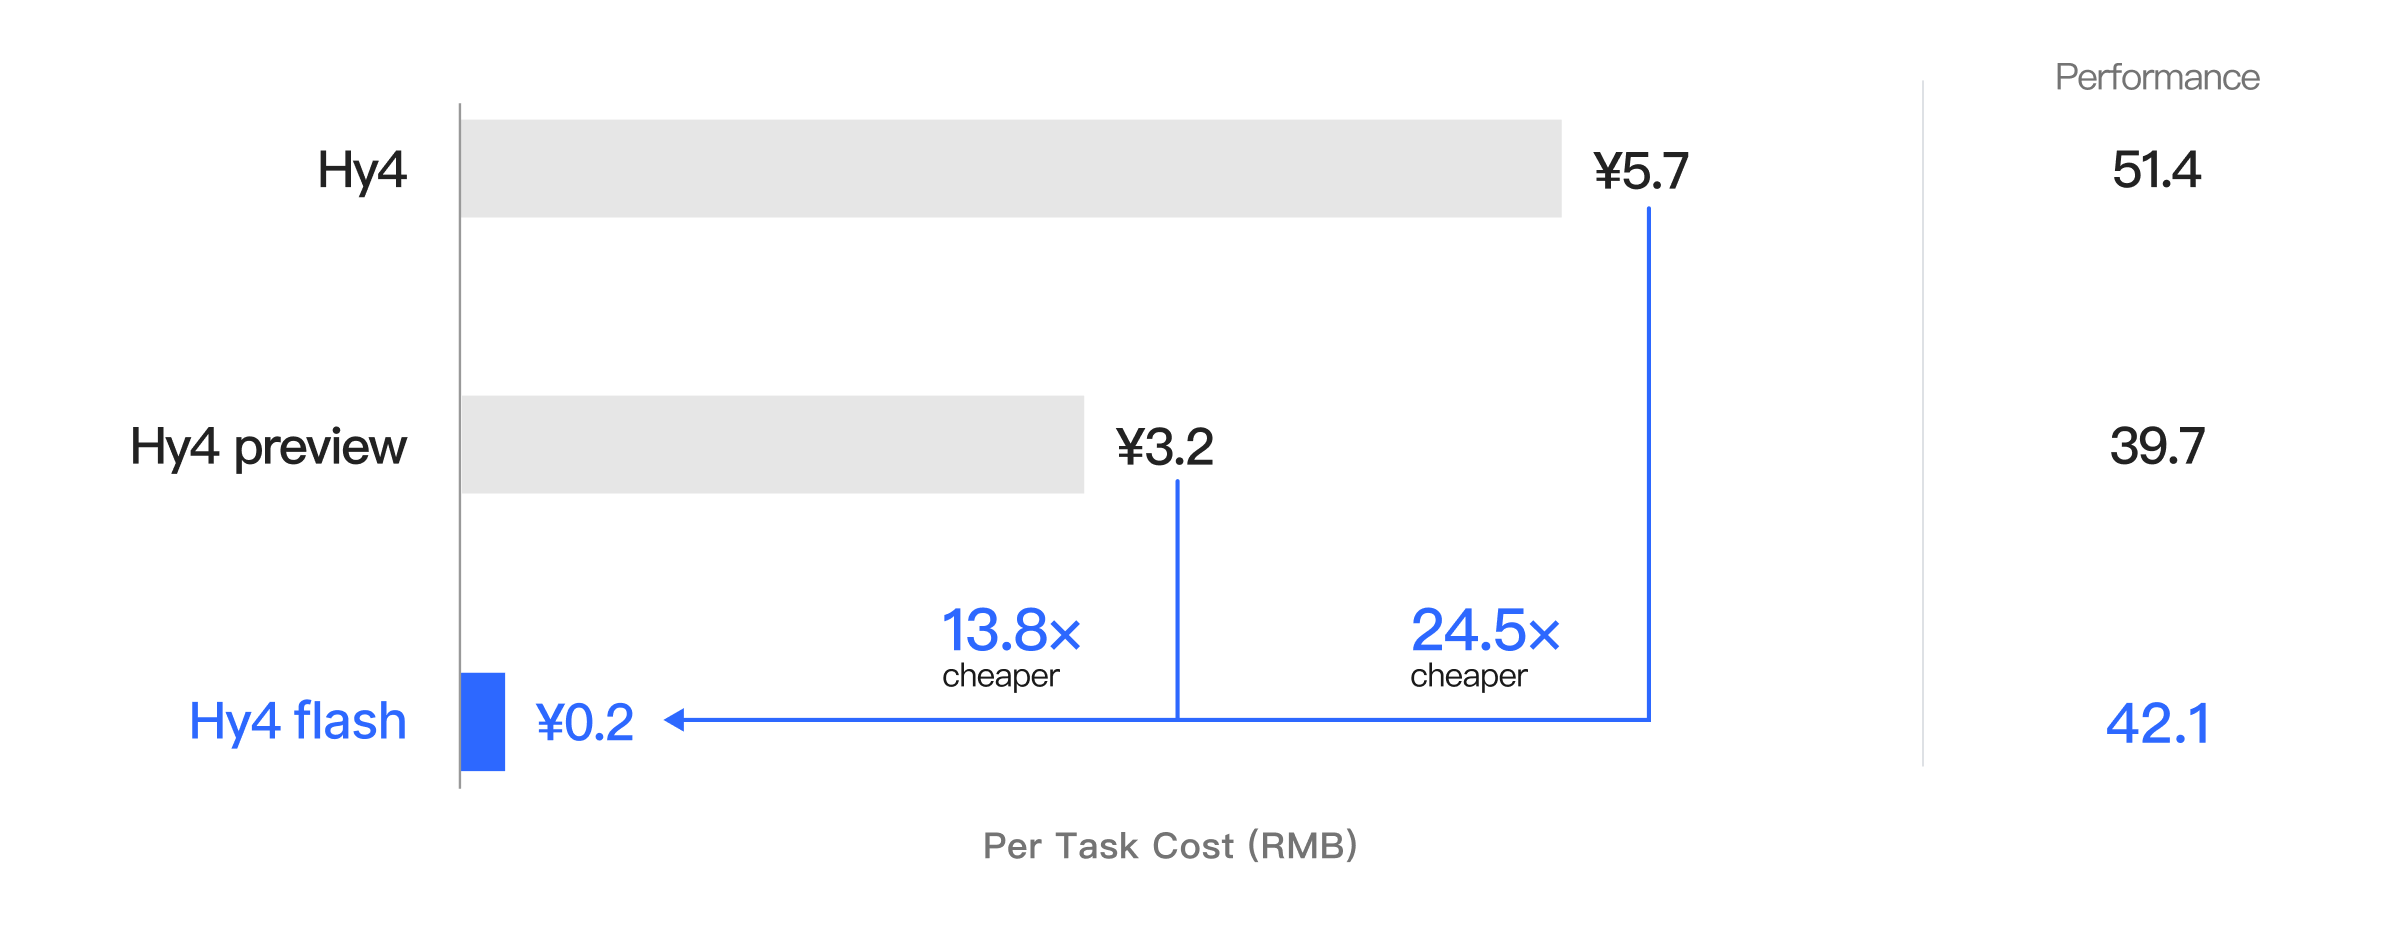 Figura: Figure 1 oficial: Distribución de rendimiento frente a coste en los 8 conjuntos de WorkIndex y en 7 puntos de referencia públicos de agentes. El eje horizontal refleja el coste y no la puntuación. Fuente: Tencent Hunyuan
La lectura de este gráfico queda clara en su descripción: las puntuaciones de capacidad técnica se mantienen casi idénticas, mientras que el coste se desploma a niveles entre 1/8 y 1/20. Al situar el coste como eje principal, Tencent formula una declaración explícita: antes de evaluar la inteligencia de un modelo, hay que preguntarse cuánto cuesta ejecutarlo. A medida que las puntuaciones en las tablas de clasificación se estrechan, la variable que marca la verdadera diferencia se desplaza directamente a la factura.
Primer recorte: la caché KV reducida a 1/24
Conviene explicar en primer lugar la función de la caché KV (Key-Value Cache). Cada vez que un modelo procesa un documento extenso, mantiene un cuaderno de notas donde registra la relación de cada palabra con todo el contexto precedente. Ese cuaderno es la caché KV. Cuanto más voluminoso es el cuaderno, mayor es la memoria de vídeo ocupada, más páginas deben examinarse en cada paso de generación y más cara resulta la ejecución. En tareas con contextos amplios, la mayor parte del gasto en infraestructura proviene del mantenimiento de este cuaderno en memoria.
Hy4 flash combina tres elementos arquitectónicos: atención híbrida (aplica distintos niveles de atención a diferentes fragmentos de texto para no malgastar computación en pasajes sencillos), LatentMoE (una arquitectura de mezcla de expertos donde la gran mayoría de los parámetros permanece en reposo y se activa solo según la demanda) y Engram. De acuerdo con los datos oficiales, la memoria requerida por la caché KV se reduce a 1/24 respecto a Hy3 y a 1/6 respecto a Hy4. Al adelgazar este cuaderno a una fracción mínima, una ventana de contexto de un millón de tokens pasa a ser económicamente viable. Al procesar documentos de millones de palabras, la memoria GPU ya no se satura, lo que permite abaratar radicalmente las tarifas. El precio de 0,003 dólares para entradas almacenadas en caché representa la otra cara de esta misma moneda: los contextos repetidos no necesitan recalcularse y el espacio de memoria requerido es minúsculo, reduciendo en paralelo los costes de almacenamiento.
Por su parte, el diseño MoE ahorra potencia de cálculo: de los 224B parámetros totales (incluidos 64B en el módulo Engram), solo se activan 12B por cada token. Es equivalente a contar con una plantilla de 224 empleados donde cada palabra que entra únicamente pone a trabajar a 12 de ellos, mientras el resto espera sin devengar costes. Desplegar computación bajo demanda estricta sin consumir energía en parámetros inactivos constituye la base técnica sobre la que se sostienen estos precios mínimos.
Mayor velocidad de ejecución, respuestas más concisas
Si la arquitectura reduce el almacenamiento en memoria, la ingeniería de inferencia reduce el tiempo de máquina. El entorno de ejecución de Hy4 flash se apoya en tres piezas clave: megakernels (integran todo el bucle de decodificación en un programa GPU altamente fusionado, eliminando las demoras de transferencia entre módulos), cuantización a 4 bits (comprime los parámetros del modelo a representaciones de 4 bits para ahorrar ancho de banda de memoria) y el sistema de planificación DFly. Las mediciones oficiales señalan una velocidad de decodificación superior a 150 tokens por segundo. Para que un servicio sea barato debe ser rápido: cuantos más tokens genere una misma GPU por segundo, menor tiempo de máquina absorberá cada token, evitando que las tarifas bajas generen pérdidas operativas.
El postentrenamiento aborda la cantidad total de tokens generados. Hy4 flash se sometió primero a una autodestilación a partir del modelo fundacional Hy4 para heredar sus capacidades generales, y después se entrenó con aprendizaje por refuerzo para expresar las respuestas con total claridad empleando la menor cantidad posible de palabras. Los datos oficiales reflejan una reducción del 50 % en el promedio de tokens de salida de extremo a extremo. Dado que la generación de salida es el tramo más caro de la tarifa (0,281 frente a 0,070 dólares por millón), reducir la longitud a la mitad recorta de inmediato la mitad del coste. Entre las tres capas, es la que produce el impacto financiero más directo.
Solo la multiplicación de estas tres capas permite alcanzar una reducción a 1/20: la arquitectura reduce la memoria a una fracción mínima, la inferencia amortiza el tiempo de computación por token y el postentrenamiento disminuye a la mitad los tokens más caros. Ninguna de estas medidas por separado habría logrado recortar un orden de magnitud en el precio. La verdadera economía se diseña en el código; los descuentos comerciales se limitan a imprimirse en catálogos. Lo primero queda grabado en la arquitectura del modelo y su entorno de ejecución; lo segundo desaparece cuando terminan las campañas promocionales.
Cifras oficiales: claves para su correcta lectura
Es indispensable contextualizar el origen de la información: todos los números citados provienen de comunicaciones oficiales de Tencent. WorkIndex es un punto de referencia interno, con pruebas y modelos de control seleccionados por la propia compañía, sin que existan por ahora réplicas de terceros. Toda autoevaluación oficial conlleva un sesgo favorable a quien la publica y debe ser analizada con prudencia.
No obstante, varios indicadores cruzados aportan solidez al resultado. En una prueba a doble ciego con 85 usuarios internos de WorkBuddy, a lo largo de 259 tareas en 27 categorías, la satisfacción de Hy4 flash se situó muy cerca de la de Claude Haiku 5.5, con el menor tiempo de respuesta y costes por tarea sustancialmente inferiores a todos los modelos de referencia. En los productos comerciales de la compañía también se registran mejoras: en el asistente de productividad WorkBuddy el tiempo medio por tarea bajó un 70 % con un coste aproximado de 1/15 respecto a Hy4; en WeCom (versión corporativa de WeChat), el asistente DaYuan aceleró su salida un 88 % y redujo los tokens en modo de razonamiento un 60 %; en QQ, el asistente Xiao Q mejoró sus índices de satisfacción en 6,16, 2,84, 0,92 y 2,22 puntos porcentuales en recomendación musical, canales comunitarios, Qzone y análisis astrológicos extensos; y Yuanbao incrementó el rendimiento de sus agentes un 13,6 % frente a Hy3.
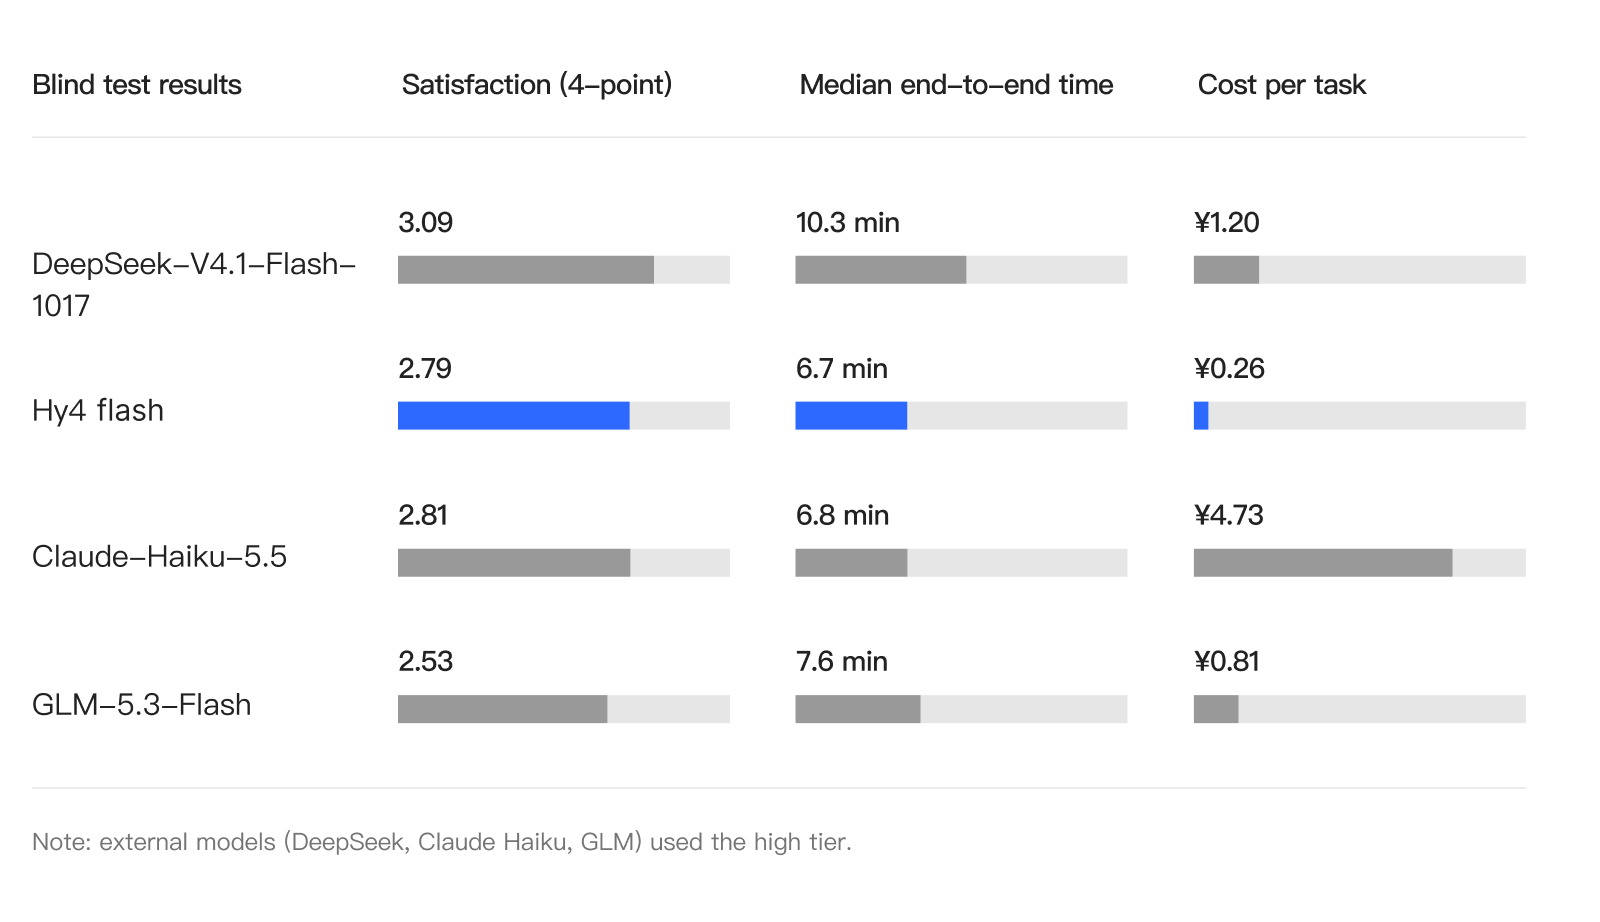 Figura: Resultados de la prueba a doble ciego con 85 usuarios de WorkBuddy, 259 tareas y 27 categorías. Satisfacción similar a Haiku 5.5 con el menor tiempo de finalización. Fuente: Tencent Hunyuan
Un índice interno puede configurarse a medida, pero es muy difícil simular mejoras coordinadas en múltiples líneas de negocio independientes. Que las herramientas de oficina, los asistentes sociales y los agentes autónomos avancen en la misma dirección demuestra que esta arquitectura de ahorro opera con solidez en entornos reales. A falta de validaciones externas que confirmen las cifras exactas, la tendencia de fondo resulta coherente.
La frontera competitiva renueva su marcador
En su comunicado, Tencent delimita con nitidez los casos de uso: para tareas cotidianas de productividad (búsqueda profunda, procesamiento de textos, creación de diapositivas, prototipos rápidos de interfaz y control directo de entornos de escritorio por el modelo), recomienda Hy4 flash. En cambio, para proyectos de ingeniería de software a largo plazo, sigue recomendando el modelo principal Hy4 debido a su mayor capacidad de razonamiento complejo. Ambos modelos conviven: la versión flash lidera en rentabilidad y Hy4 lidera en capacidad máxima, sin que uno anule al otro.
Los canales de acceso ya están operativos: Tencent Cloud TokenHub, WorkBuddy, Yuanbao, WeCom, QQ, ima y Marvis, con una próxima integración en OpenRouter. Hasta el 30 de noviembre, el uso de WorkBuddy es gratuito y se aplica un 50 % de descuento en la API de TokenHub. Asimismo, está prevista la publicación de los pesos del modelo bajo licencia de código abierto. Cuando se liberen, el número de desarrolladores y empresas que adopten esta fórmula (caché KV reducida a 1/24, megakernels y salida reducida a la mitad) será la auténtica prueba de fuego de su valor técnico.
Volviendo a la cifra inicial: a medida que los modelos de vanguardia equiparan su nivel de inteligencia, el coste por tarea se consolida como una de las pocas variables capaces de abrir diferencias de órdenes de magnitud. El bajo coste de Hy4 flash se ha conseguido optimizando minuciosamente la arquitectura, la inferencia y el postentrenamiento sin mermar las capacidades generales. Esta eficiencia forma parte de la arquitectura y el software de ejecución, lista para ser estudiada y adoptada. El marcador de la competición en inteligencia artificial cuenta ahora con dos columnas: una para las puntuaciones y otra para la factura. Cuando la competencia en inteligencia ya no permita despegarse del rival, la carrera por la máxima economía de uso apenas habrá comenzado.
Enlaces de referencia:
- Página oficial de lanzamiento de Tencent Hunyuan Hy4 flash