El 16 de noviembre de 2026, el equipo de Qwen de Alibaba presentó Qwen4-Max, el modelo insignia cerrado de su cuarta generación: un MoE (Mixture of Experts) disperso de 2,4 billones de parámetros totales con 71B activados por token, visión nativa y contexto de 1M. El centro de gravedad del relato oficial se ha movido: lo que sostiene la presentación ya no son las puntuaciones de benchmark, sino un conjunto de cifras de coste en Work360, donde el coste medio por tarea cae de 4,43 a 1,67 dólares, un 62% menos.
Un agente que cuesta 4,43 dólares por tarea solo puede vivir en vídeos de demostración; a 1,67 dólares puede entrar en los flujos de producción diarios. Eso es exactamente lo que hace este lanzamiento: desplazar el foco de la competición entre modelos insignia de «qué tan bien responde» a «qué tan completo es lo que entrega».
El coste por tarea cae de 4,43 a 1,67 dólares, un 62% menos
Work360 es el marco de evaluación de tareas de oficina desarrollado por Alibaba, con 26 dominios de primer nivel, 182 subdominios de segundo nivel y 721 áreas especializadas de tercer nivel. Qwen4-Max logra ahí 52,69 puntos, frente a los 47,74 de su predecesor Qwen3.8-Max: cinco puntos más de capacidad y un 62% menos de coste. Los cinco puntos son un avance modesto en capacidad; el 62% es otra cosa: el consumo de tokens ha bajado.
En los dos niveles de razonamiento Xhigh y High, el uso de tokens en Work360 cae aproximadamente un 24% y un 35%, y en Terminal-Bench 4.0 cerca de un 48% y un 49%. La mayor parte de la factura de un agente de largo alcance son tokens de razonamiento; el precio unitario de la API pesa poco. El precio en China baja de 12/36 yuanes a 10/30 yuanes por millón de tokens, apenas un 16,7%; el precio de caché acertada baja a 0,5 yuanes/M, un 66,7% menos; en la versión internacional, QwenCloud factura la caché acertada a 0,075 dólares/M, una veinteava parte del precio de entrada. Una sesión de agente encadena decenas de llamadas a herramientas, y la tasa de acierto de caché es la variable decisiva en la factura de una sesión larga.
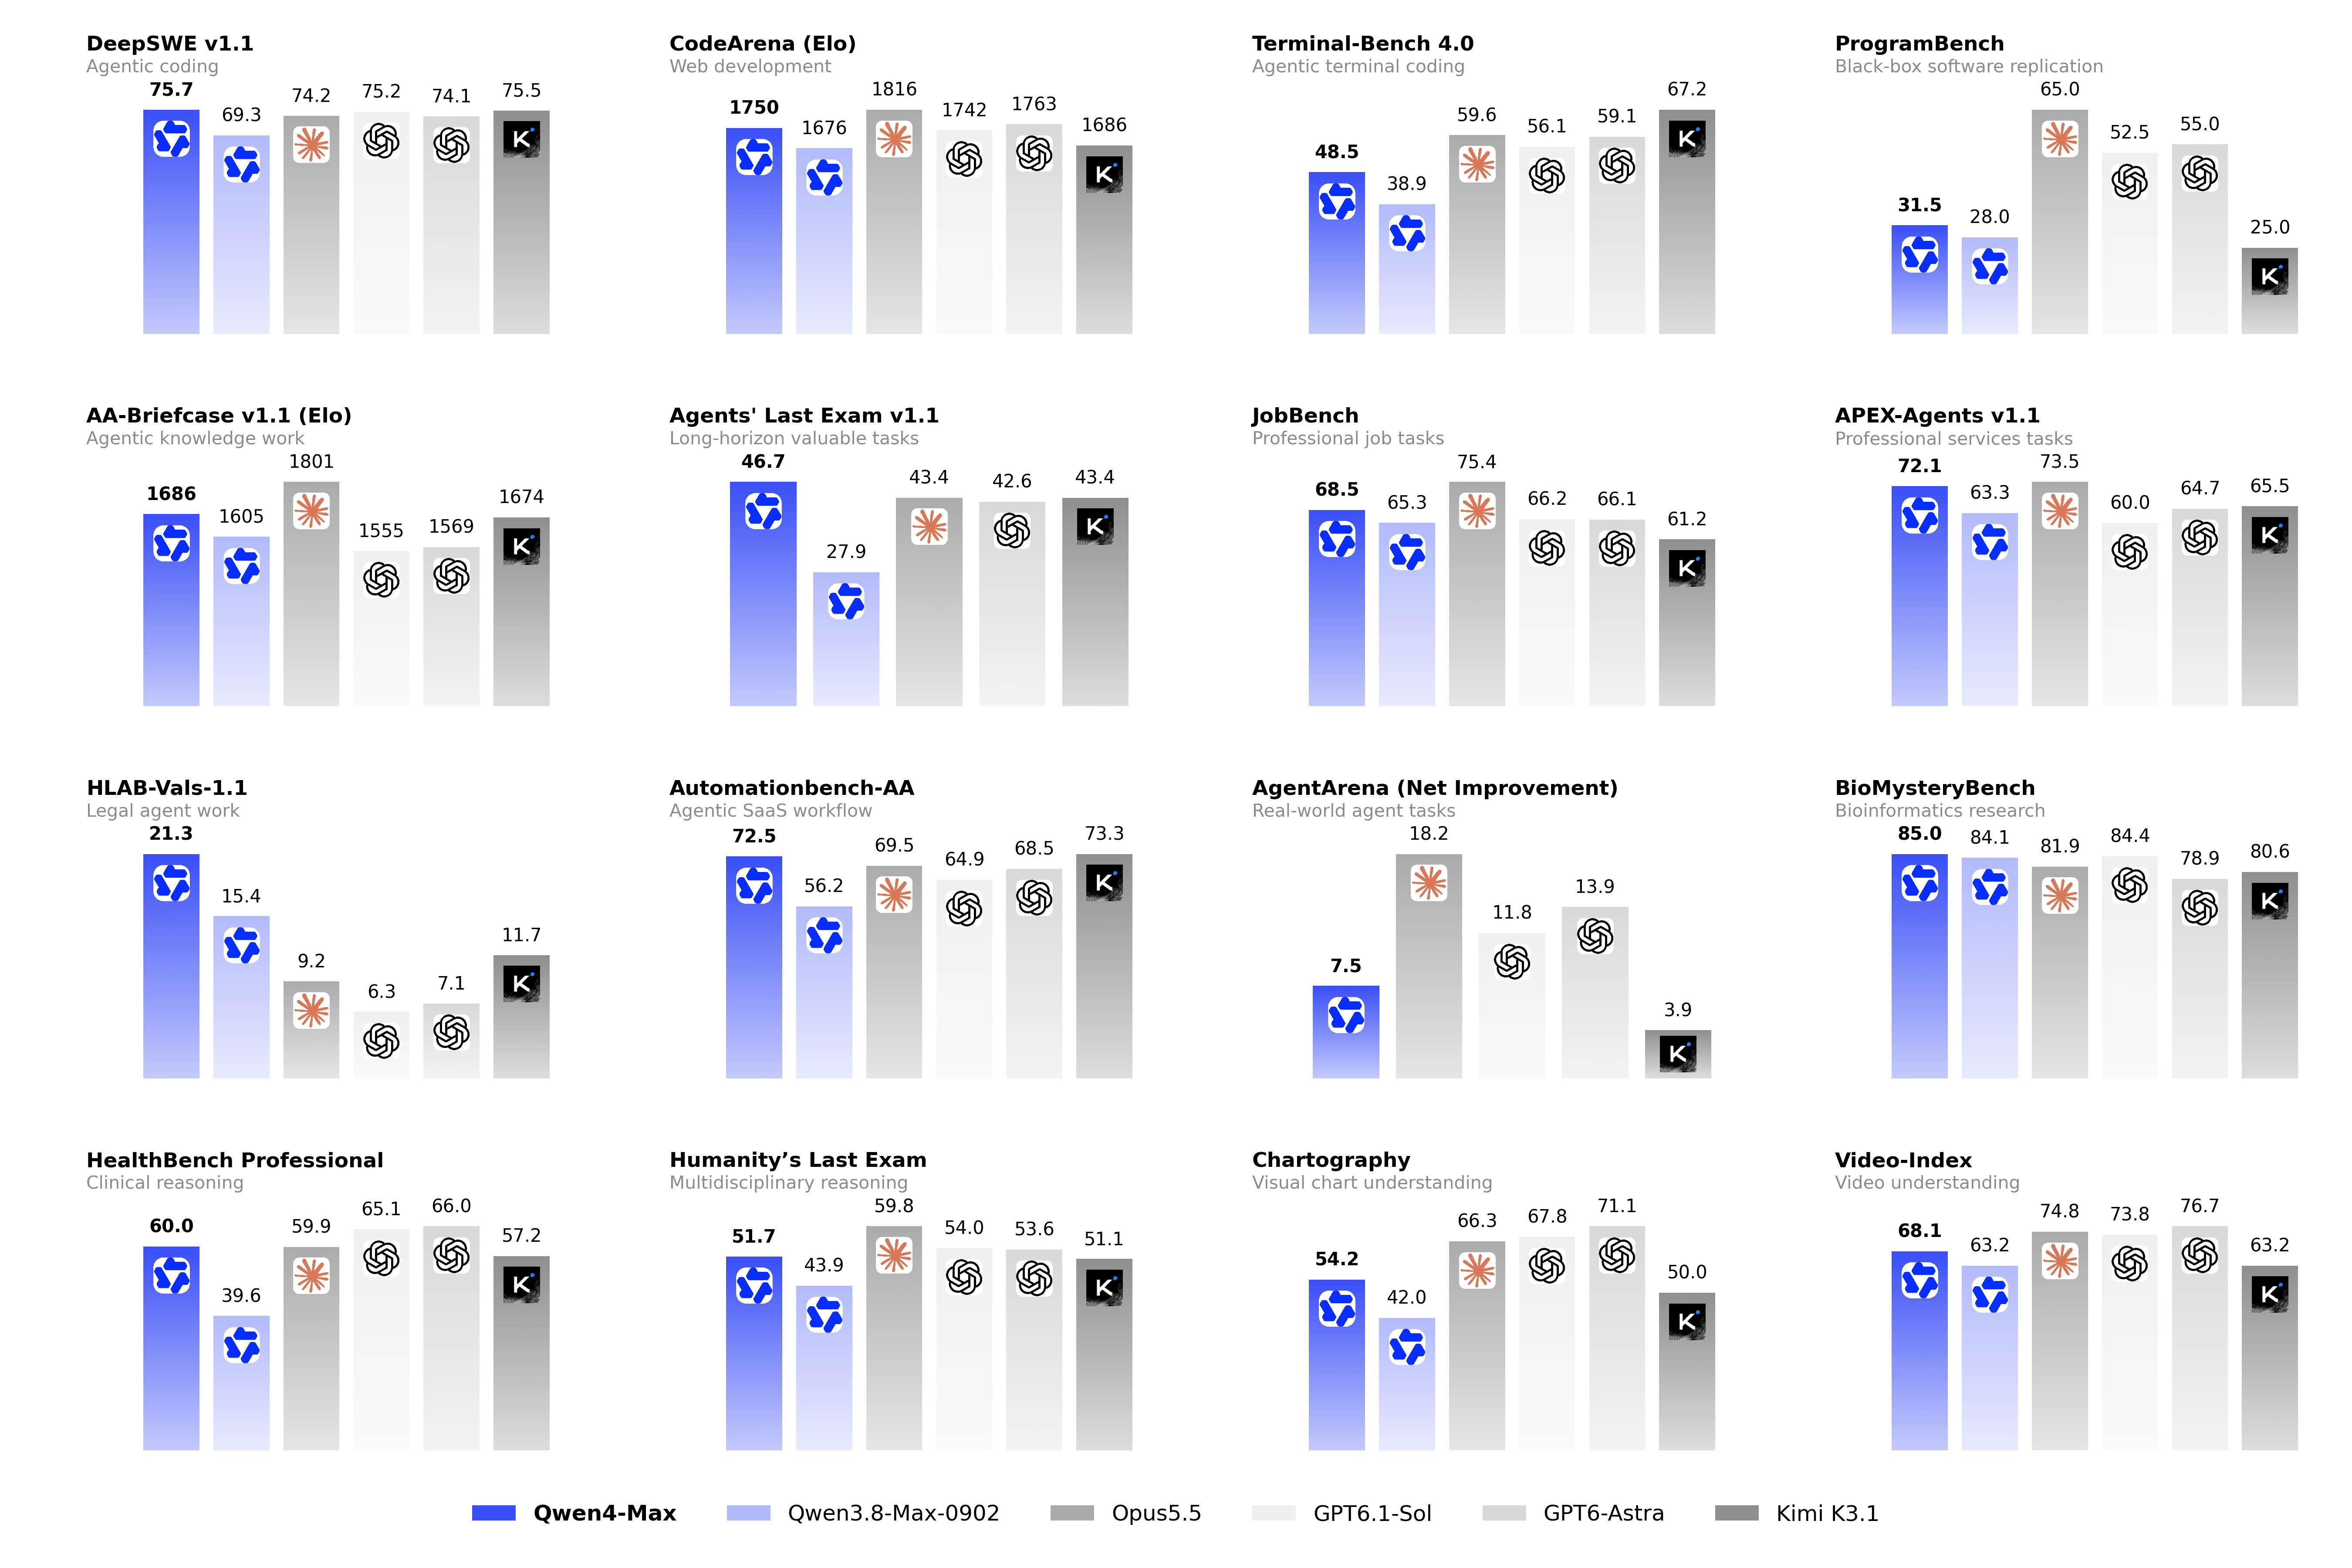
Figura: comparativa oficial de rendimiento global, con Qwen4-Max frente a su predecesor Qwen3.8-Max en tres escenarios: código, oficina y tareas de largo alcance. Nótese que el término de comparación es la generación anterior de la propia casa; las evaluaciones independientes de terceros aún no han seguido. Fuente: blog oficial de Qwen
2,4 billones de parámetros y 71B activados: la arquitectura apunta a la factura
2,4 billones de parámetros totales, 71B activados por token y, además, 328B de parámetros de N-gram Embedding, un tipo de parámetros que amplía la capacidad del modelo casi sin aumentar el cómputo. Los tres cambios de arquitectura tienen cada uno su función: GDN (Gated DeltaNet) junto con Qwen Sparse Attention (QSA) se encargan del coste del contexto largo; Gated Residual, de la estabilidad del entrenamiento; y N-gram Embedding, de la representación de patrones locales de tokens.
QSA comprime primero el historial en un estado de tamaño fijo mediante tres capas de Gated DeltaNet en cada capa, y luego un indexer ligero selecciona el contexto relevante a granularidad de micro-block, reduciendo a la vez el coste de atención y el de indexado en secuencias largas. Gated Residual usa compuertas dinámicas de lectura/escritura para controlar el flujo de información entre capas en cuatro ramas residuales paralelas, y el beneficio se materializa en la estabilidad del entrenamiento. La evidencia es directa: el preentrenamiento a escala de 2,4 billones muestra una pérdida descendiendo suavemente de principio a fin, sin picos (spikes). Lograr un entrenamiento sin spikes a esta escala no es nada habitual en el rango de los billones de parámetros.
Las cuentas a nivel Base cuadran: en la evaluación propia de cuatro dominios (Knowledge / Code / QA / STEM, 10 × BPB, cuanto más bajo mejor), el BPB de Qwen4-Max-Base es entre un 5% y un 13% inferior al de la generación anterior, con un 25% menos de parámetros activados. Aumentar la dispersión no costó capacidad. GLM-5.3 y Kimi-K3.1-Pro, incluidos en la comparación, son checkpoints post-entrenados, y la propia página oficial advierte de que la comparabilidad queda afectada: esas cifras hay que tomarlas como afirmaciones unilaterales del fabricante.
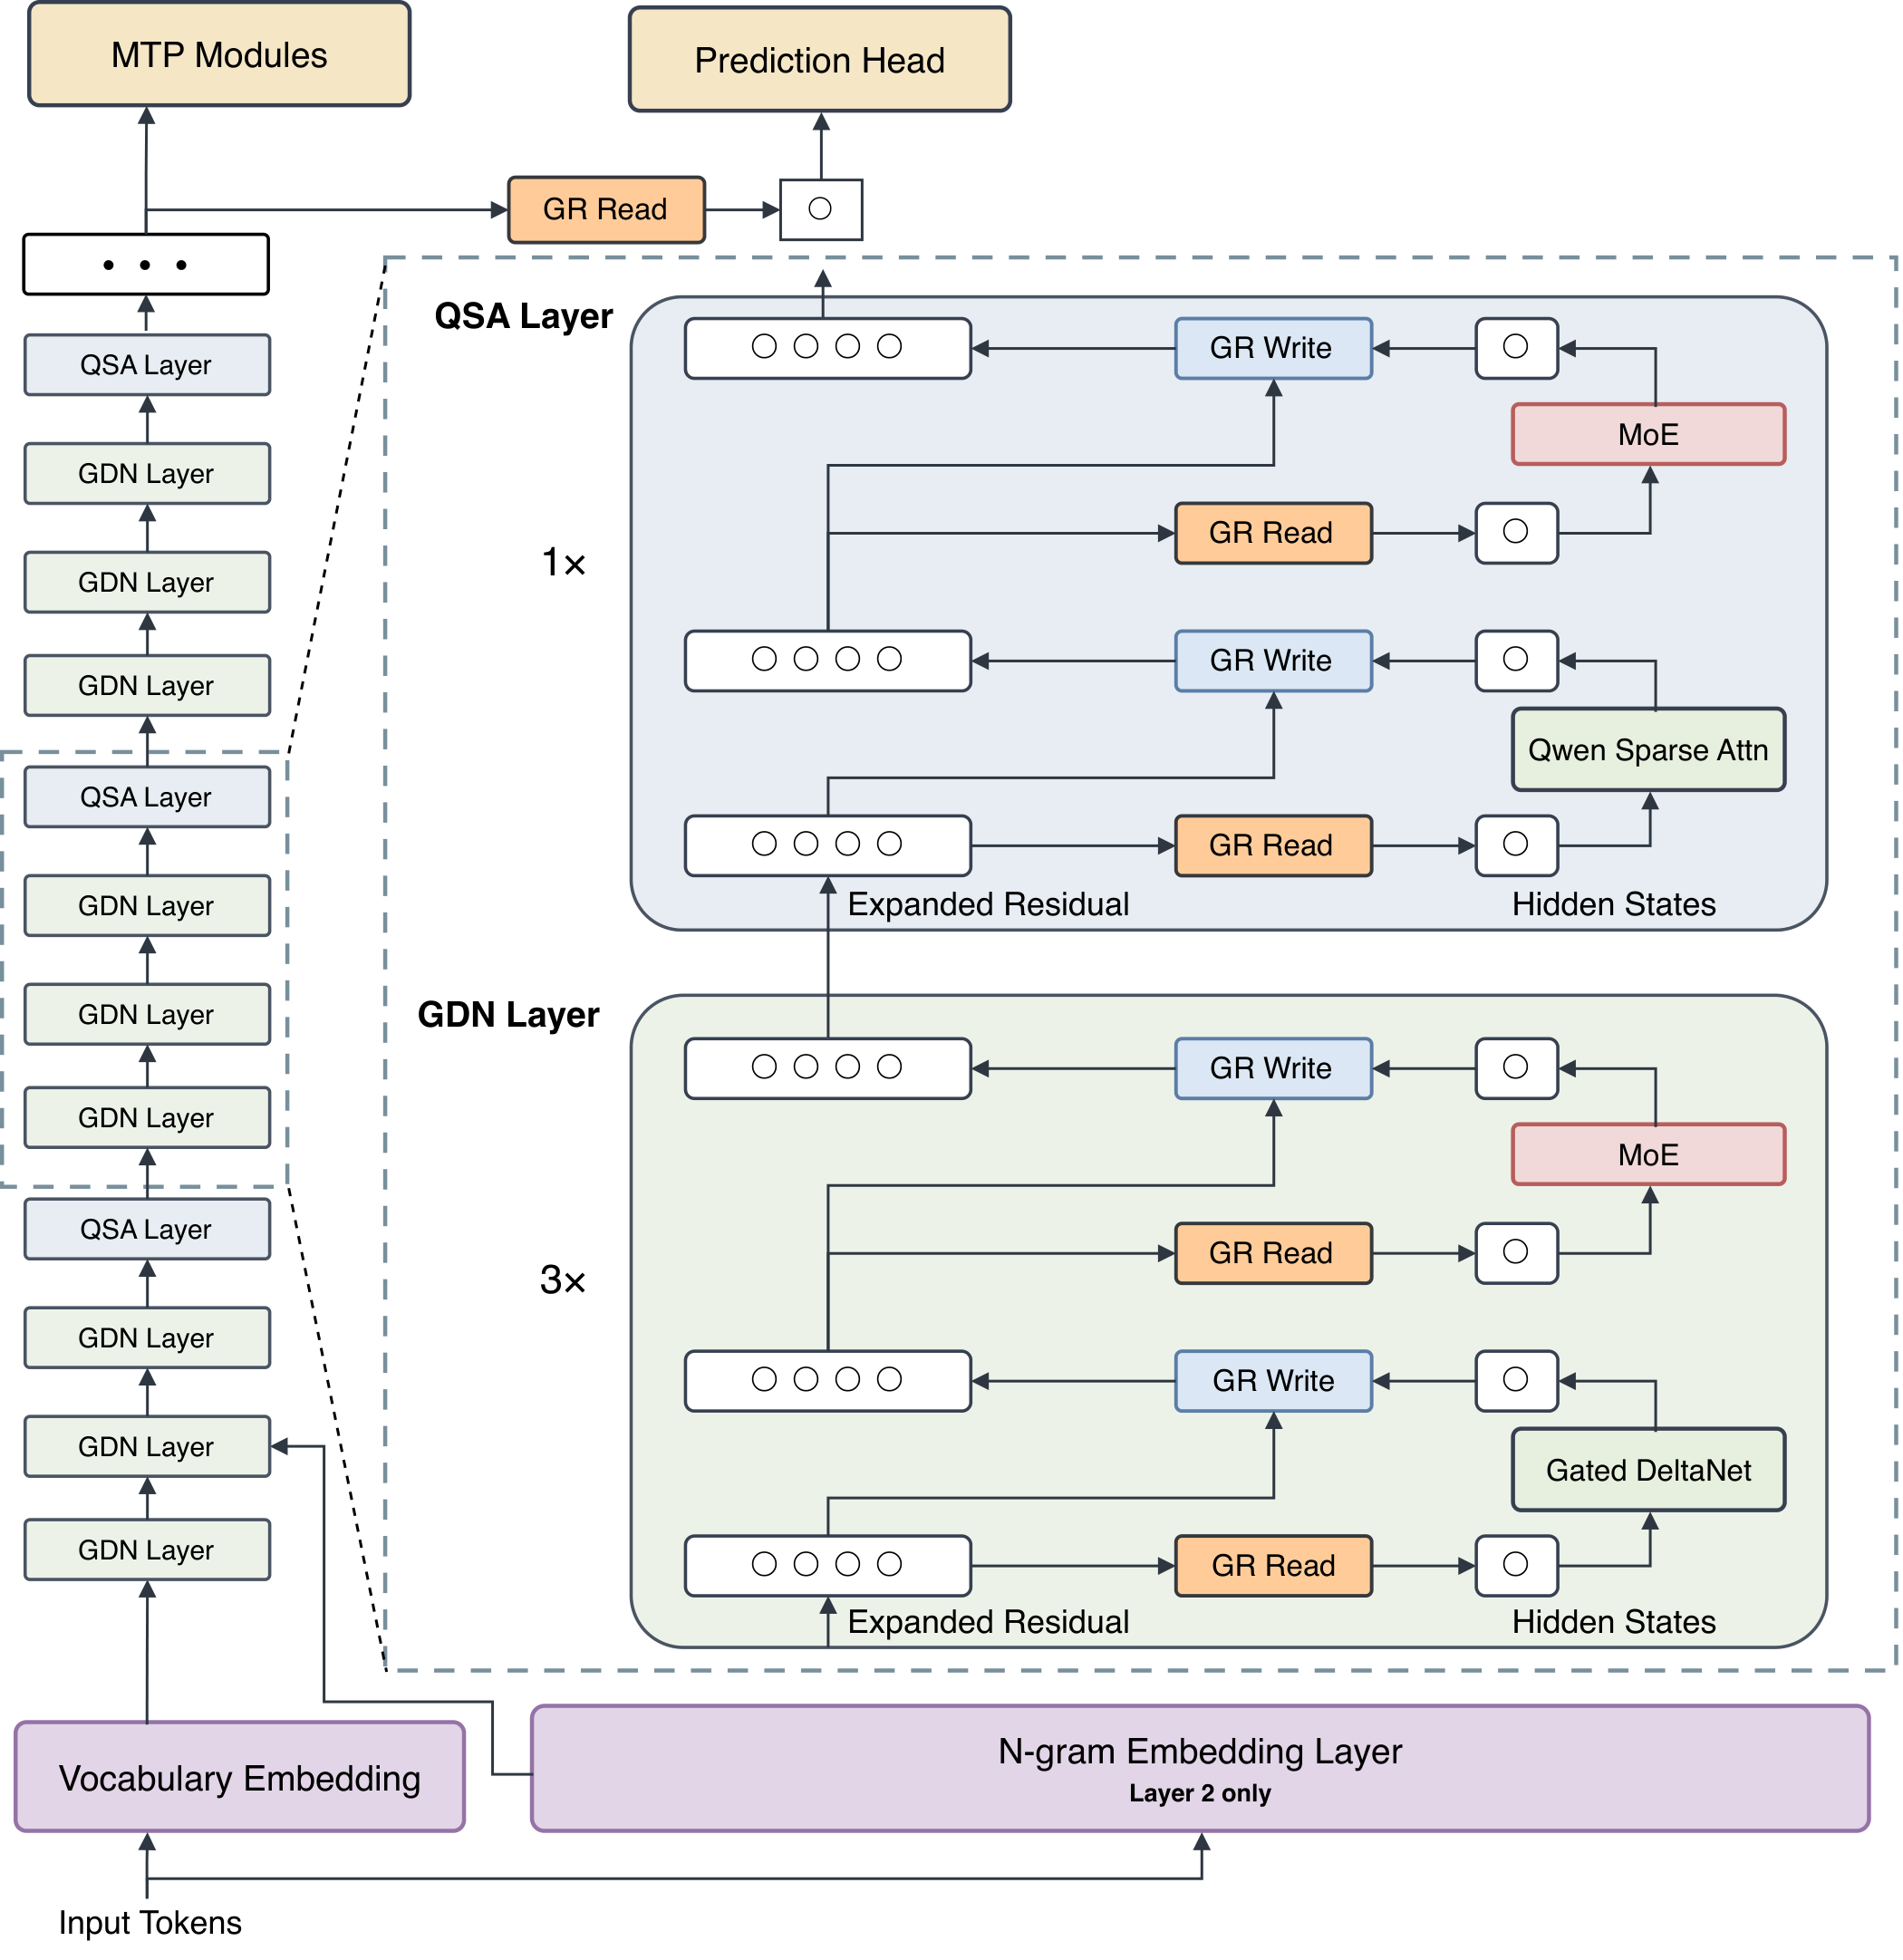
Figura: arquitectura de Qwen4-Max. Fíjate en las tres capas de Gated DeltaNet previas a cada capa de QSA: el historial se comprime en un estado de tamaño fijo, y ahí está la base estructural que permite contener el coste de atención en sesiones largas. Fuente: blog oficial de Qwen
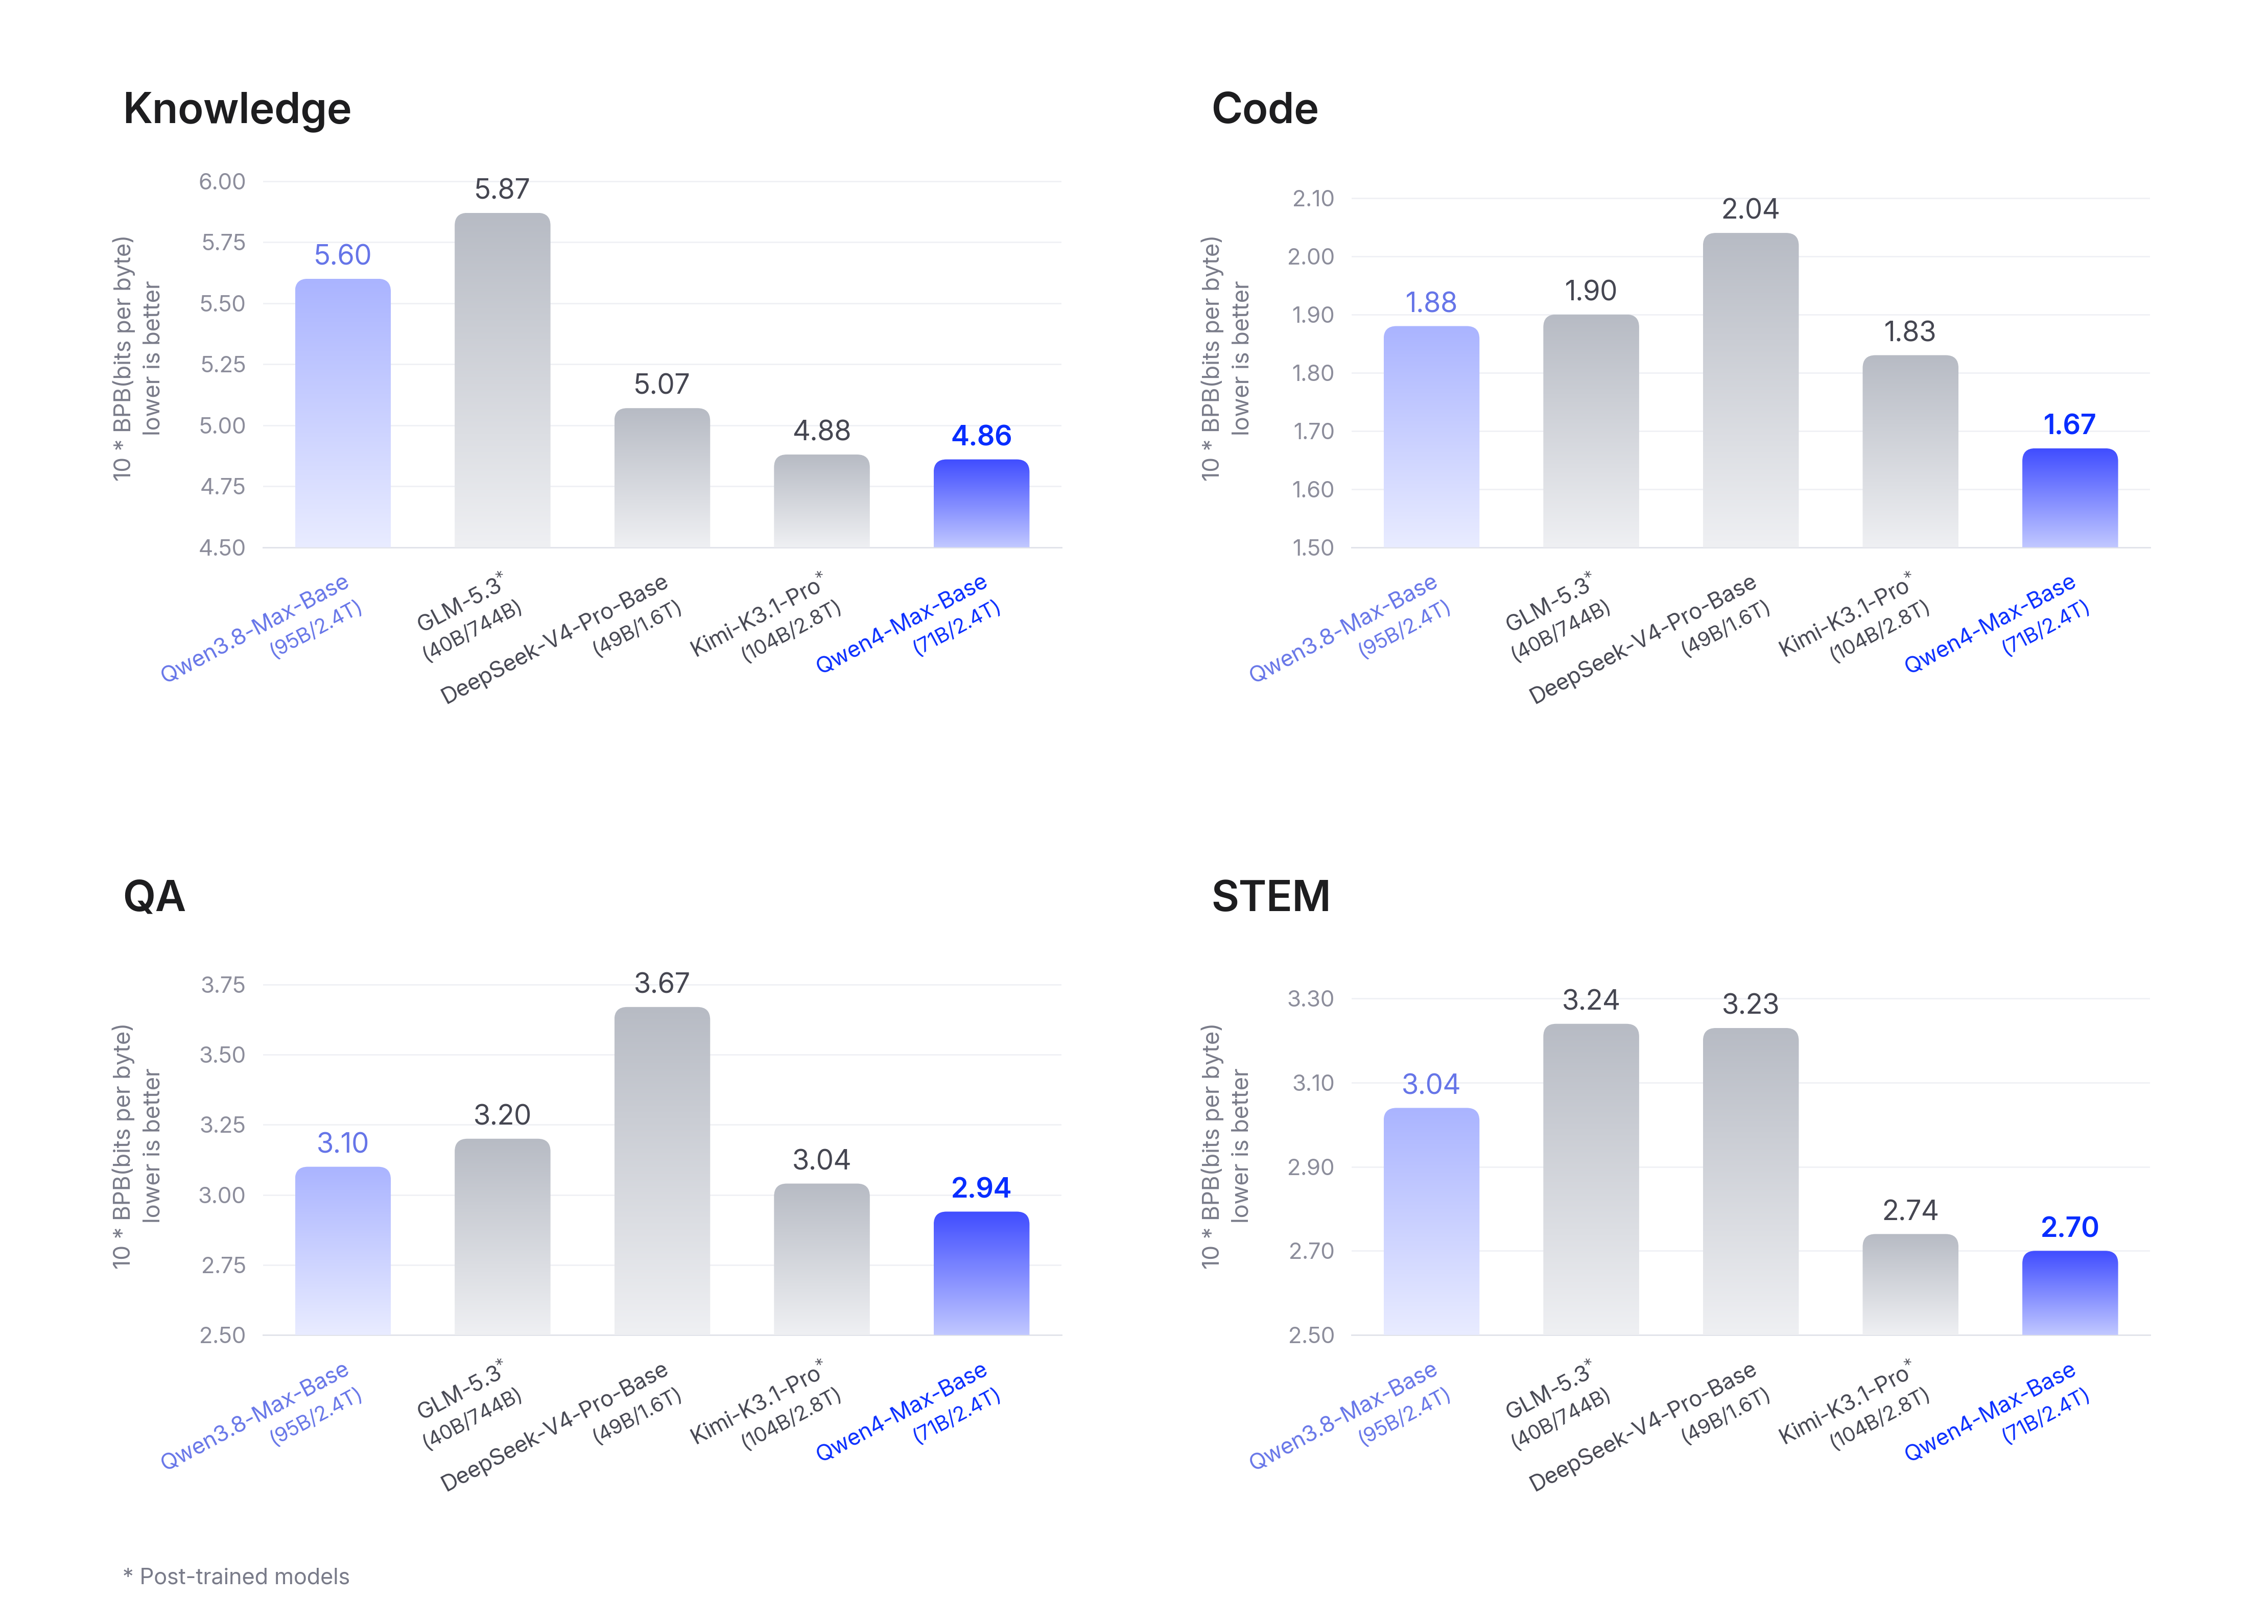
Figura: la evaluación del preentrenamiento usa 10 × BPB (cuanto más bajo mejor); Qwen4-Max-Base es el más bajo de los cinco checkpoints en los cuatro dominios, con un 25% menos de parámetros activados que la generación anterior. Fuente: blog oficial de Qwen
El contexto llega a 1M de tokens (límite estándar de entrada: 991K), y el de salida a 393.216 tokens incluyendo la cadena de razonamiento, con cinco niveles de razonamiento entre none y xhigh. Con un límite de salida cercano a los 400.000 tokens, una sola ejecución de agente cabe en su totalidad: todo el razonamiento más todo el entregable. Los cinco niveles son el mando para controlar costes: la misma capacidad, con la factura ajustada según el escenario.
48 horas sin intervención humana: un proyecto de laboratorio completo
Conectado a la plataforma de laboratorio húmedo-seco Mira de Deep Principle, el modelo completó en 48 horas sin intervención humana una línea completa de descubrimiento de materiales. El espacio de candidatos: 2,7 millones de moléculas. Primero filtrado estructural, predicción de propiedades, cálculos de primeros principios, análisis retrosintético y planificación experimental; después, dirección de un laboratorio húmedo automatizado para la preparación de reactivos, la síntesis, la purificación por separación y los ensayos. Tras cuatro ciclos de «diseño → síntesis → ensayo → aprendizaje activo», el resultado fue una nueva molécula refrigerante validada experimentalmente, orientada a la refrigeración de centros de datos para la próxima generación de chips de alto consumo.
Este tipo de tareas tiene ciclos de retroalimentación de días y señales de recompensa escasas; antes no podían delegarse a un sistema automatizado. Lo que lo bloqueaba eran dos condiciones: los modelos no sostenían la consistencia a largo plazo, y cada intento fallido salía demasiado caro. La segunda condición es justo el problema que resuelven los 1,67 dólares.
Las cifras del caso de orquestación en la nube provienen del negocio real de Alibaba Cloud: el coste de orquestación de llamadas a modelos para el etiquetado de datos bajó de media un 10,42%; la capacidad ociosa de máquinas en la asignación de GPUs online mejoró un 4,62%; y la velocidad de resolución del reescalado de CPU offline superó en 14,61 veces el objetivo óptimo. Un 10,42% y un 4,62% no parecen gran cosa, pero salen del libro contable de un negocio real: el modelo optimiza el mismo sistema con el que fue entrenado, y el dinero ahorrado vuelve directamente a las cuentas de Alibaba. La aceleración de 14,61 veces en la resolución cumple lo esperado: escribir restricciones y ajustar solvers es terreno cómodo para un LLM.
El descubrimiento de fármacos es aún más denso en ensayo y error: en la plataforma PharmMaster de DP Technology, se llevó a cabo una investigación de extremo a extremo sobre el inflamasoma NLRP3, asociado al alzhéimer, con 454 llamadas a herramientas, 3.239 evaluaciones de métricas computacionales y 24 moléculas candidatas. La energía libre de enlace relativa (RBFE) estimada de la molécula seleccionada fue unas 3,6 veces la de la molécula de referencia, y se consideró merecedora de validación en laboratorio húmedo. Con 454 puntos de decisión de ensayo y error bajo la antigua estructura de costes, el presupuesto de esta línea de investigación no habría pasado ni la fase de aprobación del proyecto.
El material del lanzamiento incluye una lista de entregables sectoriales: en las líneas de producción reales de SANF y Pacific Union, las horas de trabajo humano por pieza para la programación cayeron de casi 8 horas a 24 minutos, cerca de un 95% menos; 198 documentos legales con nombres caóticos se clasificaron en 14 carpetas, generando un informe de 86 páginas que cubre 12 áreas de revisión, con cada conclusión trazable a un documento concreto; y en medicina intensiva, un caso con 1.433 imágenes originales y decenas de miles de palabras de historial clínico se procesó de principio a fin —de la extracción al soporte de decisiones— en una sola conversación. El denominador común: criterios de aceptación claros. Un informe, un programa que funciona, código de producción: cuando el entregable es verificable, el agente tiene derecho a entrar en los flujos de producción.
El primer puesto de las listas es dato oficial; la lista de precios, no
Según las posiciones registradas por DataLearner, Qwen4-Max encabeza listas como Agents’ Last Exam v1.1 (46,70, 1.º de 26), BioMysteryBench (85, 1.º de 26), AutomationBench-AA (72,50, 1.º de 4) y Code Arena WebDev (1750, 1.º de 4), pero la fuente de esos datos son casi en su totalidad gráficos del blog oficial; las listas independientes de terceros como Artificial Analysis o LMArena aún no lo han incluido. Work360 es un marco autodesarrollado por Alibaba y todos los vídeos de casos provienen del fabricante. Benchmarks propios más posiciones de gráficos oficiales: esa cadena de evidencia hay que mirarla con reservas.
Los precios no requieren reservas. En la versión china: 10 yuanes de entrada y 30 yuanes de salida por millón de tokens; en la internacional: 1,5 dólares de entrada y 4,5 de salida, con caché acertada a 0,075 dólares. La tarifa está publicada en la plataforma: es un hecho contractual, sin margen para disputas de metodología de evaluación.
También hay que reconocer los límites frente a la competencia: en ingeniería de terminal compleja y reproducción de cajas negras, Kimi K3.1 y Opus 5.5 mantienen una ventaja notable en puntuación. Qwen4-Max obtiene 48,48 en Terminal-Bench 4.0 (13.º de 58) y el puesto 15 de 120 en Vibe Code Bench v1.1. Su ventaja de relación calidad-precio se concentra en escenarios de alto reuso de caché, trabajo ofimático multimodal con contexto largo y agentes legales y de bioinformática; los huesos duros de la terminal aún no los ha roído.
La discusión más caliente de la comunidad ese día fue la prueba de dibujo del «pelícano en bicicleta»: Simon Willison la ejecutó en los cuatro niveles none/low/high/xhigh, y hubo comentarios que cuestionaban que este tipo de pruebas ya formaran parte del conjunto de entrenamiento. El día del lanzamiento de un modelo nuevo, las señales independientes disponibles son prácticamente cero: es la dificultad generalizada de todo sistema de evaluación, y Qwen4-Max es solo la muestra más reciente.
Insignia cerrada; el código abierto esperará a los tamaños pequeños
Qwen4-Max no libera pesos: solo ofrece API y servicios de plataforma cerrados, con interfaces compatibles con los formatos de OpenAI y Anthropic. La empresa indica que los modelos pequeños de la serie Qwen4 se entrenarán con la misma tecnología y se irán liberando progresivamente, pero no ha comprometido la apertura del insignia Max; quien necesite despliegue privado, por ahora debe seguir con los pesos abiertos de Qwen3.8-Max. Insignia cerrada para ingresos comerciales, tamaños pequeños abiertos para cultivar el ecosistema: esta combinación Alibaba ya la domina.
La codificación segura es un punto que pasa desapercibido con facilidad: en Last Secure Code Bench, la proporción de código que pasa a la vez las pruebas funcionales y de seguridad a nivel de función subió del 22,0% al 31,8%; la proporción de generaciones seguras simultáneas a nivel de función, archivo y repositorio pasó del 8% al 14,7%, casi el doble. Los valores absolutos siguen siendo bajos: menos del 15% de generaciones seguras en las tres granularidades a la vez. Cuando un agente escribe código sensible a la seguridad, la revisión humana no se puede ahorrar ni una línea. Pero la pendiente del 8% al 14,7% apunta en la dirección correcta, y además el fabricante retiró los datos de ciberseguridad ofensiva del conjunto de entrenamiento, conservando solo las tareas defensivas.
Mirado en perspectiva, el interruptor que este lanzamiento ha pulsado es la curva de costes: 1,67 dólares cae dentro del rango de precio que una empresa está dispuesta a pagar por ensayar una tarea; 4,43 dólares, no. Se puede dudar de que las puntuaciones de las listas provengan de gráficos oficiales, se puede sospechar que los vídeos de casos estén actuados, pero las cifras de la lista de precios no admiten discusión. Qwen4-Max aún no ha vencido a Kimi K3.1 ni a Opus 5.5 en ingeniería de terminal; lo que ha conseguido es que los agentes de largo alcance puedan, por primera vez, planificarse dentro de un presupuesto de producción e integrarse en los flujos diarios. En el próximo lanzamiento insignia, la escala de parámetros probablemente pase a la segunda línea del anuncio: la curva de costes ya ha tomado ese puesto.
Enlaces de referencia:
- Blog oficial de Qwen: anuncio de lanzamiento de Qwen4-Max
- Página de registro del modelo en las listas de DataLearner
- Simon Willison: registro de la prueba de dibujo en los cuatro niveles de razonamiento