Le 16 novembre 2026, l’équipe Qwen d’Alibaba a dévoilé Qwen4-Max, quatrième génération de son modèle phare propriétaire : un MoE (Mixture of Experts) clairsemé de 2 400 milliards de paramètres au total, avec 71B activés par token, vision native et 1M de contexte. Le centre de gravité du discours officiel s’est déplacé : place aux scores de benchmark, un jeu de chiffres de coûts sur Work360 — le coût moyen par tâche passe de 4,43 à 1,67 dollar, soit une baisse de 62 %.
Un agent à 4,43 dollars la tâche reste cantonné aux vidéos de démonstration ; à 1,67 dollar, il peut enfin être inscrit dans les flux de production quotidiens. C’est exactement l’objet de cette sortie : déplacer la compétition des modèles phares de « la qualité des réponses » vers « la complétude des livrables ».
Le coût par tâche ramené de 4,43 à 1,67 dollar, soit −62 %
Work360 est le cadre d’évaluation de tâches bureautiques développé en interne par Alibaba : 26 domaines de premier niveau, 182 sous-domaines, 721 domaines de spécialité au troisième niveau. Qwen4-Max y obtient 52,69 points contre 47,74 pour son prédécesseur Qwen3.8-Max — un gain de 5 points, et 62 % de coûts en moins. Les 5 points gagnés sont un petit pas en capacité ; la baisse de 62 % est une autre histoire : la consommation de tokens a reculé.
Les deux niveaux de raisonnement Xhigh et High réduisent leur consommation de tokens d’environ 24 % et 35 % sur Work360, et d’environ 48 % et 49 % sur Terminal-Bench 4.0. Pour un agent de longue haleine, la facture se joue surtout sur les tokens de réflexion ; le prix unitaire de l’API n’est qu’une ligne secondaire. En Chine, la tarification passe de 12/36 à 10/30 yuans par million de tokens, soit −16,7 % seulement ; le prix en cache descend à 0,5 yuan/M, soit environ −66,7 % ; côté international, le cache hit de QwenCloud s’établit à 0,075 dollar/M, soit environ un vingtième du prix d’entrée. Les sessions d’agent enchaînent des dizaines de tours d’appels d’outils : le taux de hit du cache est la variable qui décide de la facture des longues sessions.
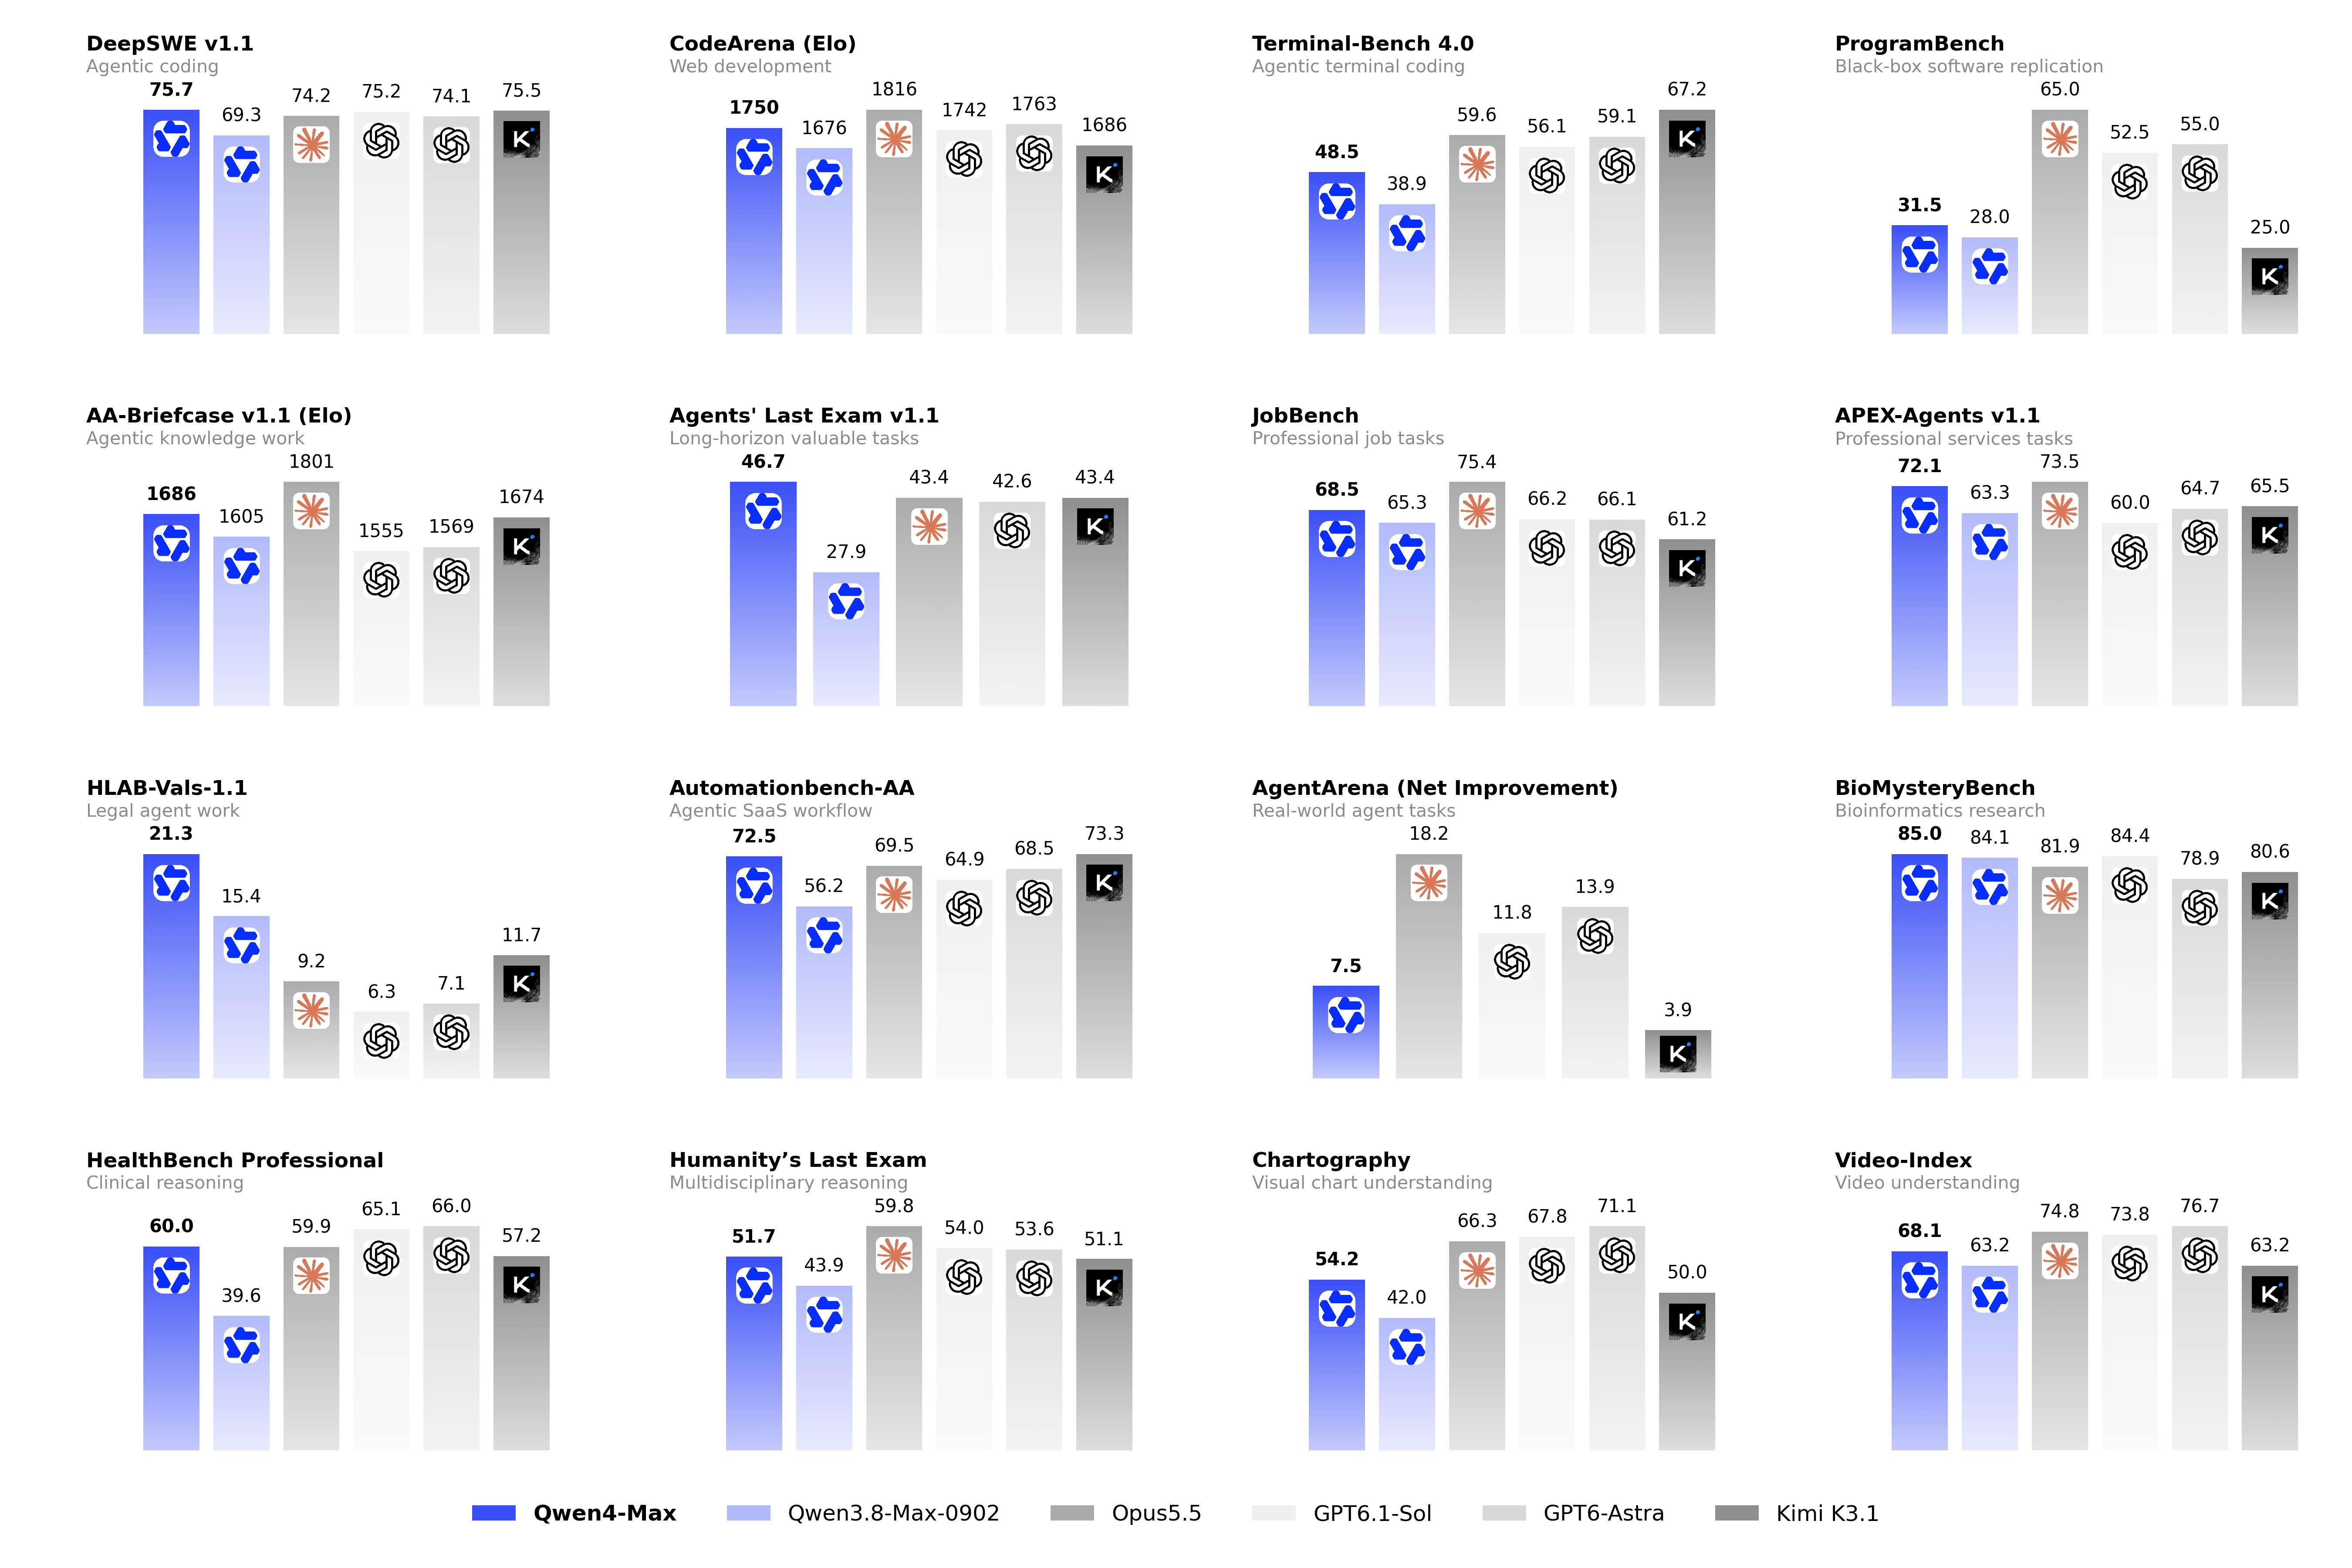
Figure : comparaison officielle des performances globales de Qwen4-Max face à la génération précédente Qwen3.8-Max sur trois scénarios — code, bureautique, tâches longues. Attention : la comparaison porte sur la génération précédente de la même maison, les évaluations indépendantes tierces ne sont pas encore disponibles. Source : blog officiel Qwen
2 400 milliards de paramètres, 71B activés : une architecture qui vise la facture
2 400 milliards de paramètres au total, 71B activés par token, plus 328B de paramètres N-gram Embedding — des paramètres qui étendent la capacité du modèle sans presque augmenter le calcul. Trois modifications architecturales aux rôles distincts : GDN (Gated DeltaNet) couplé à Qwen Sparse Attention (QSA) prend en charge le coût du long contexte, Gated Residual assure la stabilité de l’entraînement, N-gram Embedding gère la représentation des motifs locaux de tokens.
QSA procède ainsi : à chaque couche, trois couches de Gated DeltaNet compriment d’abord l’historique dans un état de taille fixe, puis un indexeur léger sélectionne le contexte pertinent à l’échelle des micro-blocks — coût d’attention et coût d’indexation des longues séquences sont comprimés simultanément. Gated Residual utilise des portes de lecture/écriture dynamiques pour contrôler le flux d’information inter-couches de quatre branches résiduelles parallèles ; le bénéfice se loge dans la stabilité de l’entraînement. La preuve est directe : sur un pré-entraînement à l’échelle de 2 400 milliards, la loss descend en douceur du début à la fin, sans aucun spike — un exploit qui reste rare sur des entraînements du trilliard.
Au niveau des bases, les comptes se tiennent : sur l’évaluation interne quatre domaines (Knowledge / Code / QA / STEM, 10 × BPB, plus bas est mieux), le BPB de Qwen4-Max-Base est inférieur de 5 à 13 % à celui de la génération précédente, avec 25 % de paramètres activés en moins — la densité accrue ne s’est pas payée en capacités. Dans le tableau comparatif, GLM-5.3 et Kimi-K3.1-Pro sont des checkpoints post-trainés, ce que l’éditeur signale lui-même comme limitant la comparabilité ; ces quelques chiffres sont donc à prendre comme des déclarations unilatérales.
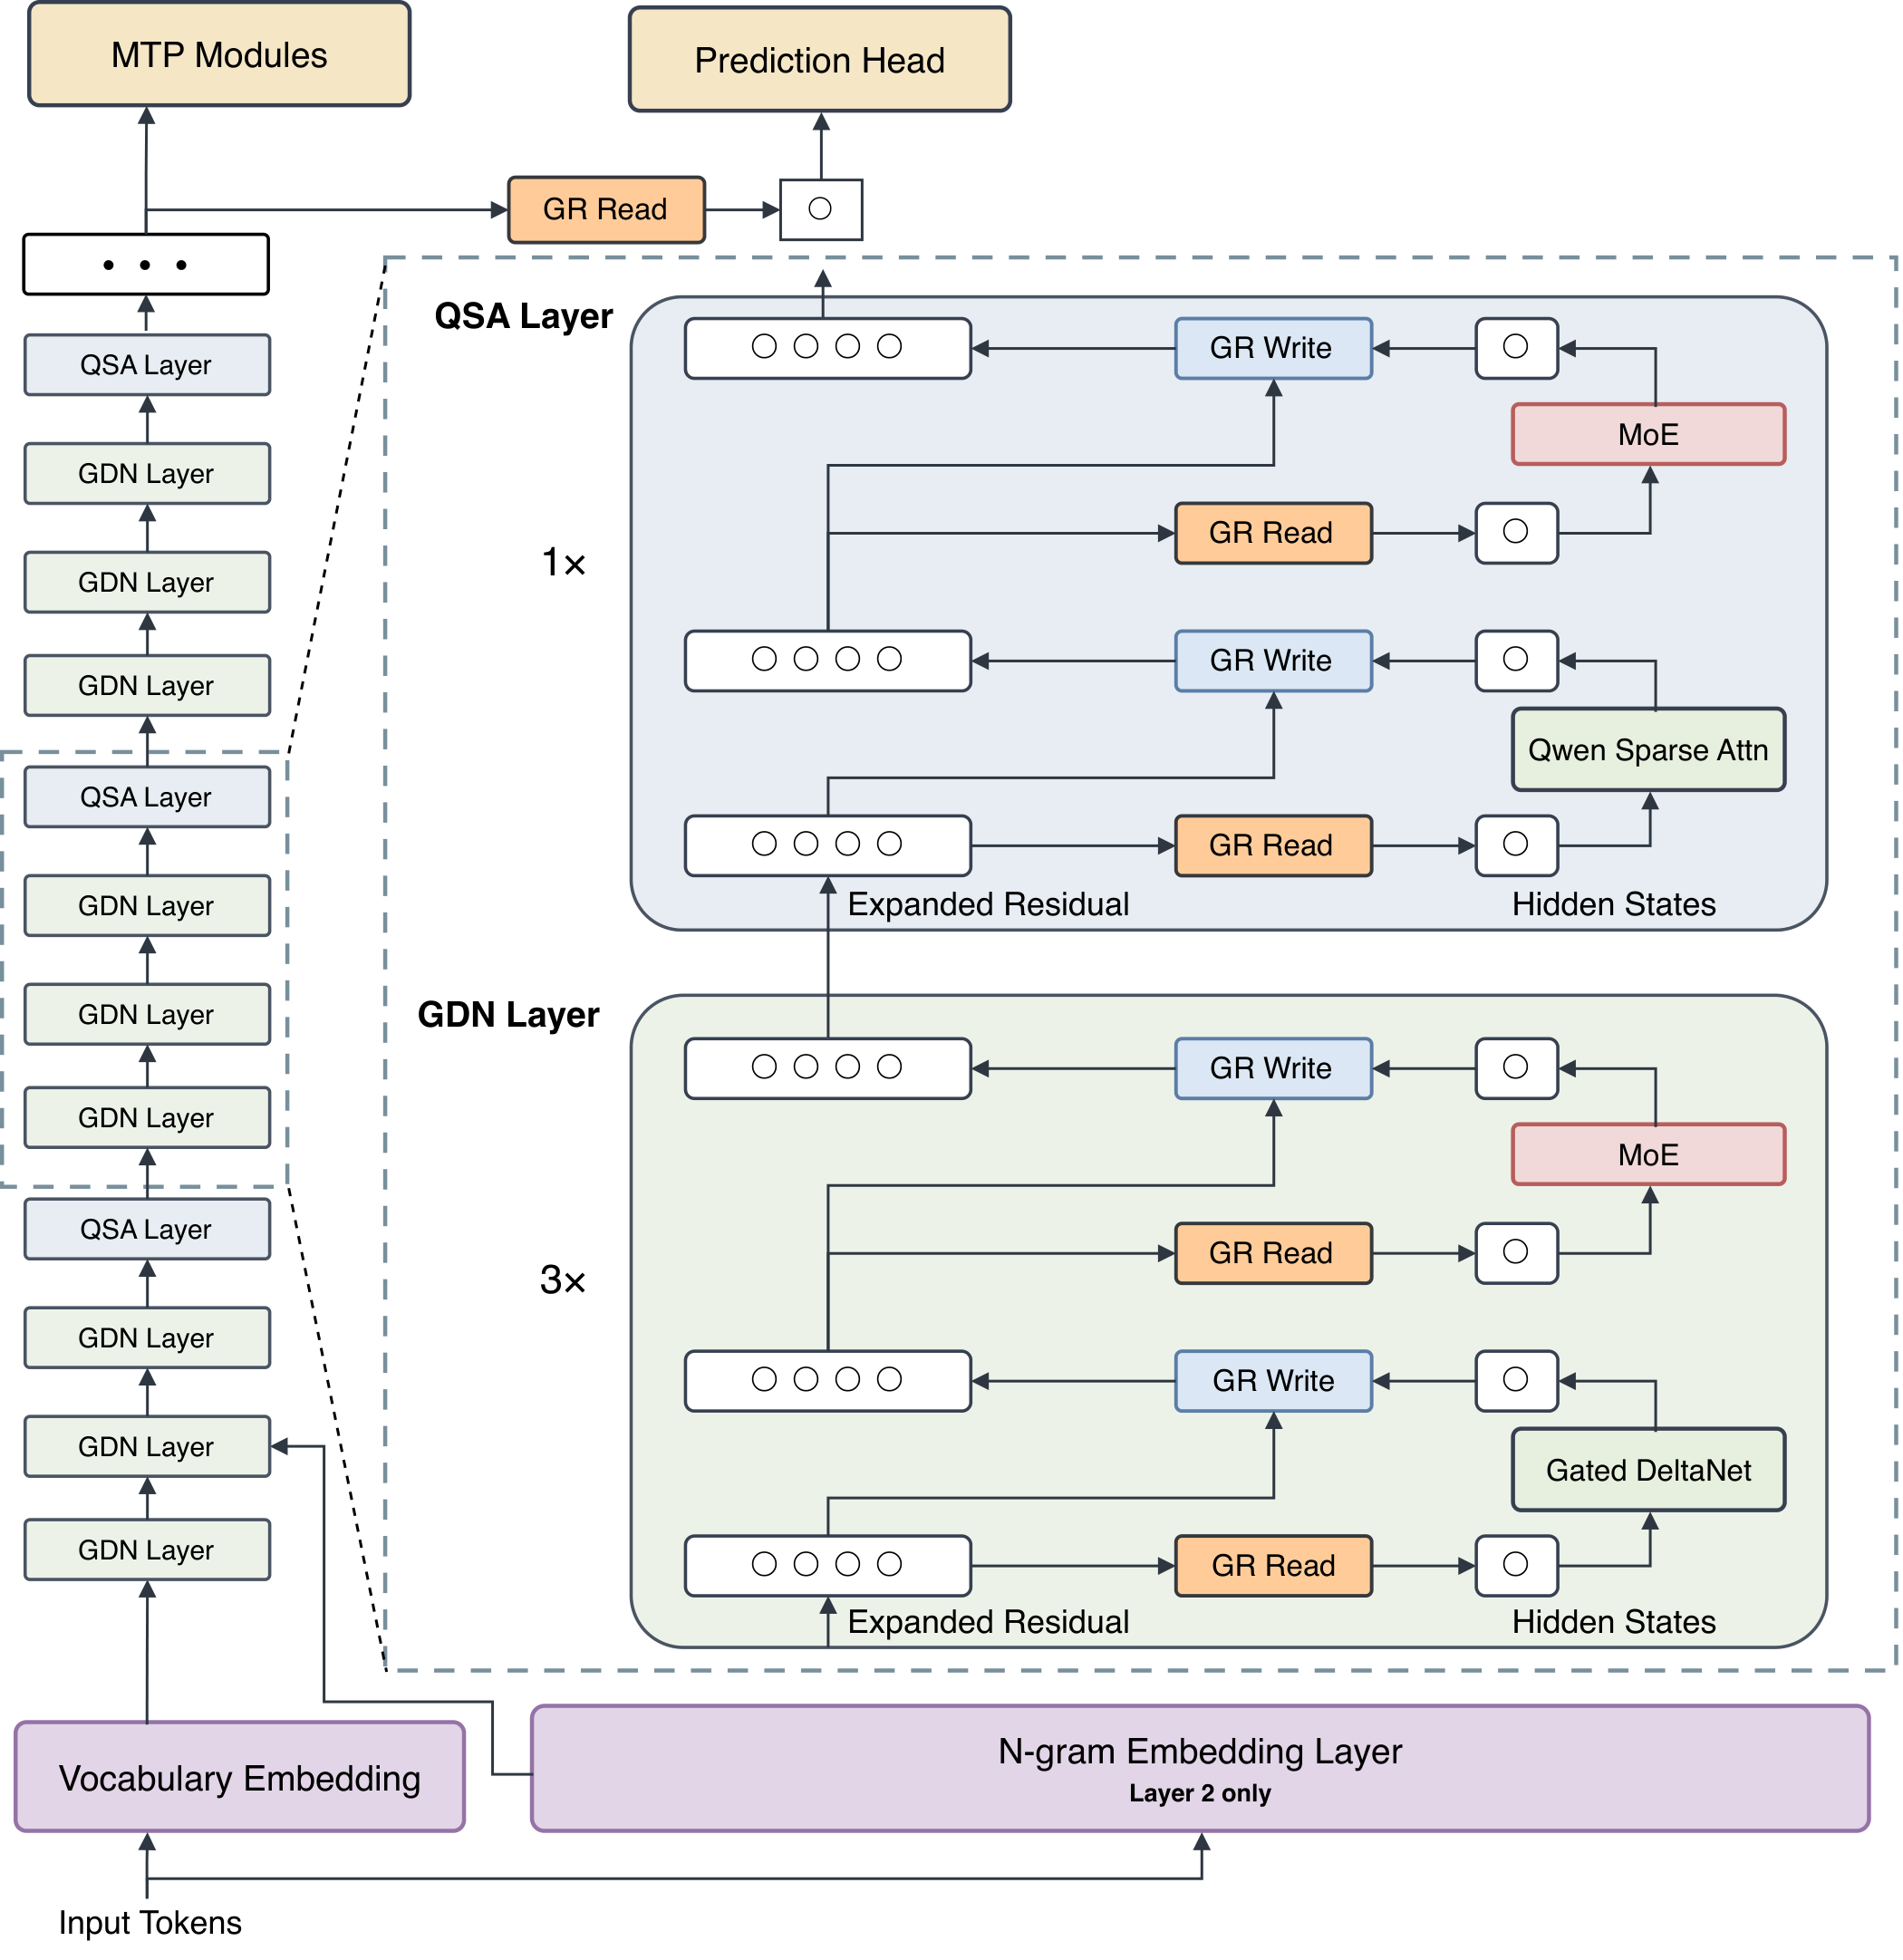
Figure : architecture de Qwen4-Max. Regardez les trois couches de Gated DeltaNet qui précèdent le QSA de chaque couche : l’historique y est comprimé dans un état de taille fixe — c’est le socle structurel qui permet de faire baisser le coût d’attention des longues sessions. Source : blog officiel Qwen
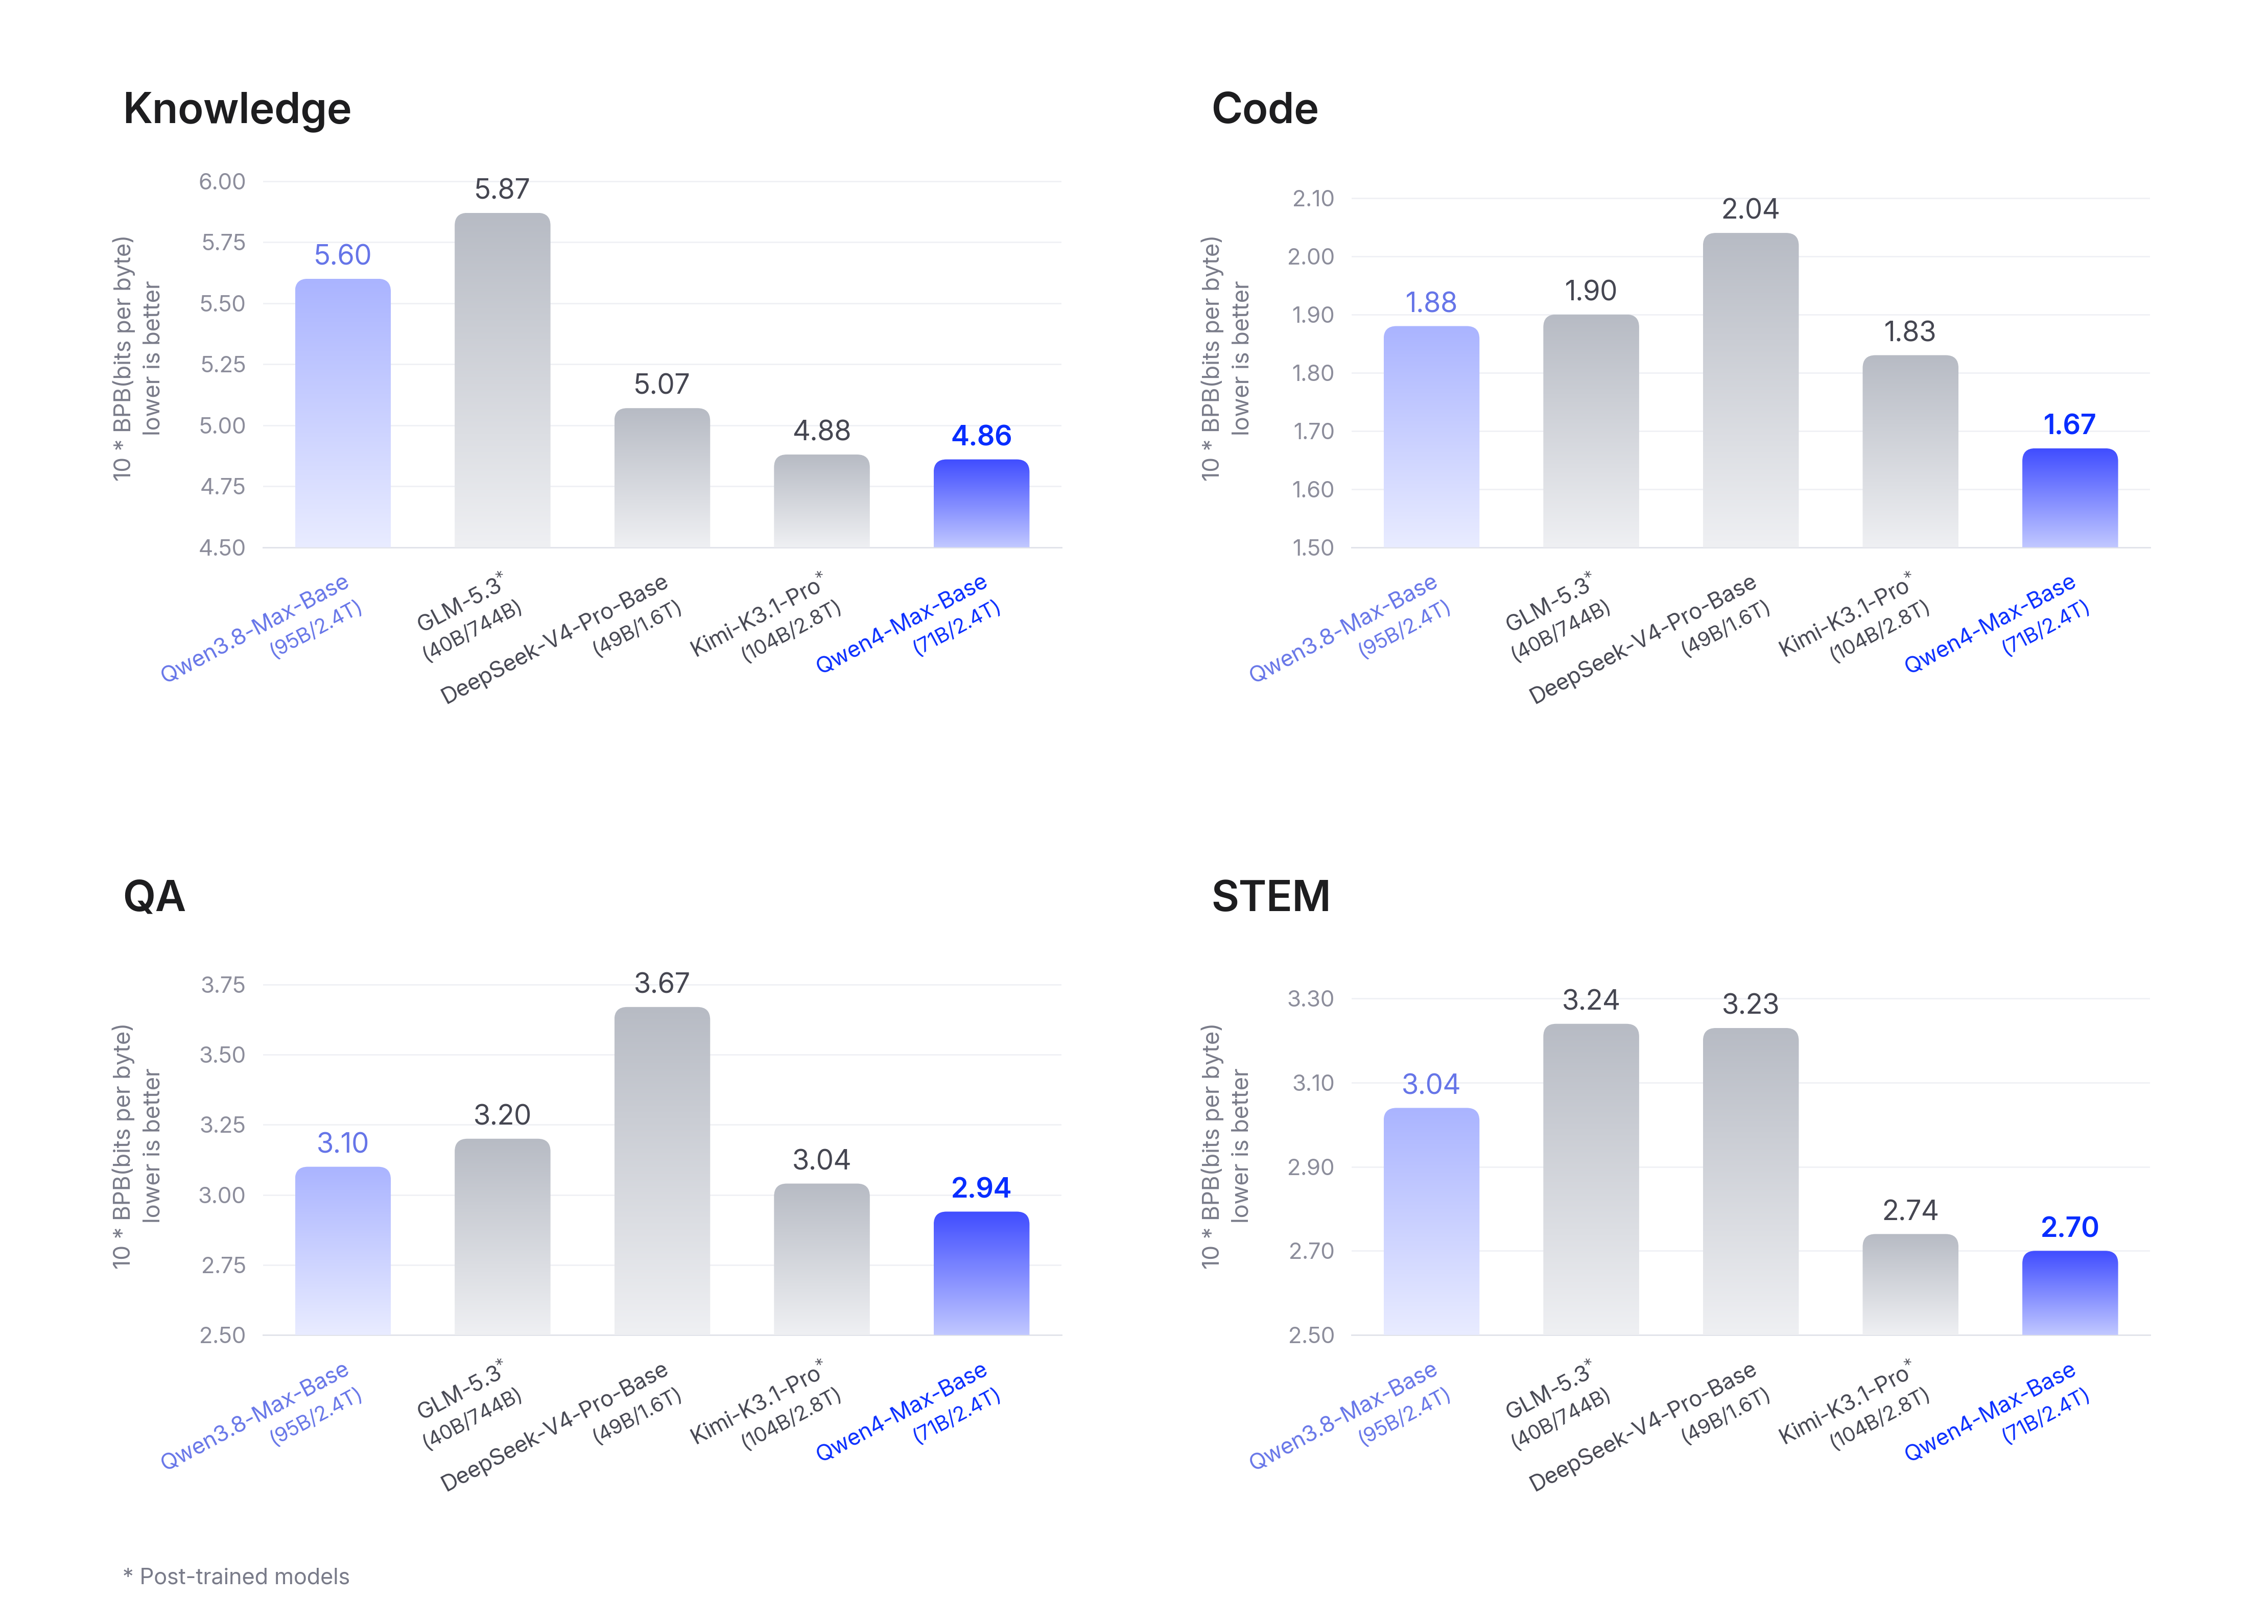
Figure : l’évaluation du pré-entraînement utilise le 10 × BPB (plus bas est mieux) ; Qwen4-Max-Base affiche la valeur la plus basse des cinq groupes de checkpoints sur les quatre domaines, avec 25 % de paramètres activés en moins que la génération précédente. Source : blog officiel Qwen
Le contexte atteint 1M de tokens (limite d’entrée standard 991K), la limite de sortie s’établit à 393 216 tokens chaîne de raisonnement incluse, avec cinq niveaux de raisonnement allant de none à xhigh. Une limite de sortie proche de 400 000 tokens suffit à un run d’agent pour boucler l’intégralité de sa réflexion et de ses livrables ; les cinq niveaux sont le bouton de contrôle des coûts — même capacité, facture ajustée au scénario.
48 heures sans intervention humaine pour boucler un projet de laboratoire
Une fois connecté à la plateforme de laboratoire hybride Mira de Deep Principle, le modèle a mené sans aucune intervention humaine, pendant 48 heures d’affilée, une ligne complète de découverte de matériaux. L’espace de candidats : 2,7 millions de molécules — filtrage structurel, prédiction de propriétés, calculs de premiers principes, analyse rétrosynthétique et planification expérimentale, puis pilotage d’un laboratoire humide automatisé pour la préparation des réactifs, la synthèse, la purification et les tests. Après quatre cycles « concevoir → synthétiser → tester → apprentissage actif », le dispositif a produit une nouvelle molécule de fluide caloporteur validée expérimentalement, visant le refroidissement des centres de données de la prochaine génération de puces très gourmandes.
Ce type de tâche, au cycle de feedback de plusieurs jours et aux signaux de récompense rares, ne pouvait jusqu’ici pas être confié à un système automatisé. Deux prérequis bloquaient : le modèle ne tenait pas la cohérence sur la longueur, et chaque essai-erreur coûtait trop cher. Le second prérequis, c’est précisément ce que résout le 1,67 dollar.
Les chiffres du cas d’orchestration cloud proviennent de l’activité réelle d’Alibaba Cloud : le coût d’orchestration des appels de modèles pour l’annotation de données baisse en moyenne de 10,42 %, le temps de capacité idle des machines récupéré par l’allocation GPU en ligne augmente de 4,62 %, et la replanification CPU hors ligne atteint l’objectif optimal 14,61 fois plus vite. 10,42 % et 4,62 % paraissent modestes, mais ils sortent de vrais registres comptables : le modèle optimise le système qui l’entraîne lui-même, et les économies remontent directement dans les états financiers d’Alibaba. L’accélération de 14,61 fois du solveur, elle, était attendue — écrire des contraintes et régler des solveurs est le terrain naturel des LLM.
La découverte de médicaments est plus dense en essais-erreurs : sur la plateforme PharmMaster de DP Technology, le modèle a conduit une recherche de bout en bout sur l’inflammasome NLRP3, lié à la maladie d’Alzheimer — 454 appels d’outils, 3 239 évaluations de métriques calculées, 24 molécules candidates ; l’énergie libre de liaison relative (RBFE) de la molécule retenue est estimée à environ 3,6 fois celle de la molécule de référence, jugée digne d’une validation en laboratoire humide. Avec 454 points de décision d’essais-erreurs, cette ligne de recherche n’aurait tout simplement pas passé l’étape du budget sous l’ancienne structure de coûts.
Le dossier de lancement empile aussi une série de livrables sectoriels : chez SANF et Pacific Union, sur des lignes de production réelles, les heures de travail humain pour programmer une pièce passent de près de 8 heures à 24 minutes, soit environ −95 % ; 198 dossiers juridiques au nommage chaotique sont rangés en 14 dossiers, débouchant sur un rapport de 86 pages couvrant 12 domaines d’audit, chaque conclusion remontant à un document précis ; en réanimation, un dossier de patient comptant 1 433 images brutes et des dizaines de milliers de caractères de notes de suivi est traité en une seule conversation, de l’extraction jusqu’à l’aide à la décision. Le point commun : des critères d’acceptation clairs — rapports, programmes qui tournent, code de production. Tant que les livrables sont vérifiables, l’agent mérite une place dans le flux de production.
Premières places des classements : données officielles. Grille tarifaire : pas de doute possible
D’après les classements référencés par DataLearner, Qwen4-Max pointe en tête d’Agents’ Last Exam v1.1 (46,70, 1er/26), BioMysteryBench (85, 1er/26), AutomationBench-AA (72,50, 1er/4) et Code Arena WebDev (1750, 1er/4) — des données issues pour l’essentiel des graphiques publiés par le blog officiel ; les classements indépendants d’Artificial Analysis, LMArena et autres ne l’ont pas encore référencé. Work360 est un cadre développé en interne par Alibaba, et toutes les vidéos de cas sortent du fabricant. Benchmarks maison plus places acquises sur graphiques officiels : cette chaîne de preuves mérite une décote.
Les prix, eux, ne se décotent pas. Côté chinois, 10 yuans l’entrée et 30 yuans la sortie par million de tokens ; côté international, 1,5 dollar l’entrée et 4,5 dollar la sortie, cache hit à 0,075 dollar. La grille est affichée sur la plateforme : c’est un fait contractuel, sans espace pour la controverse méthodologique.
Les frontières de la compétition aussi : sur l’ingénierie terminal complexe et la reproduction de boîtes noires, Kimi K3.1 et Opus 5.5 conservent un net avantage au score. Qwen4-Max obtient 48,48 points sur Terminal-Bench 4.0 (13e/58) et 15e/120 sur Vibe Code Bench v1.1. Son avantage prix-performance se concentre sur les scénarios à fort réemploi de cache, la bureautique multimodale à long contexte, les agents juridiques et bioinformatiques ; les os durs du terminal ne sont pas encore craqués.
La discussion communautaire la plus animée du jour tournait autour du test de dessin « un pélican sur un vélo » : Simon Willison l’a passé dans les quatre modes none/low/high/xhigh, et des commentaires ont souligné que ce genre de test figure sans doute depuis longtemps dans les données d’entraînement. Au jour de sortie d’un nouveau modèle, les signaux indépendants disponibles sont pratiquement nuls — c’est la faiblesse généralisée de tout l’édifice d’évaluation, et Qwen4-Max n’en est que le dernier échantillon.
Un phare propriétaire, l’open source attendra les petites tailles
Qwen4-Max ne publie pas ses poids : API propriétaire et services de plateforme seulement, avec des interfaces compatibles aux formats OpenAI et Anthropic. L’éditeur annonce que les petites tailles de la gamme Qwen4 seront entraînées avec la même pile technique et ouvertes progressivement, sans toutefois s’engager sur l’open sourcing du phare Max ; qui exige un déploiement privé devra continuer, pour cette génération, sur les poids ouverts de Qwen3.8-Max. Phare propriétaire pour les revenus commerciaux, petites tailles ouvertes pour cultiver l’écosystème : cette combinaison, Alibaba la maîtrise déjà parfaitement.
Un point souvent négligé : le code sécurisé. Sur Last Secure Code Bench, la proportion de généractions passant simultanément les tests fonctionnels et de sécurité au niveau « fonction » passe de 22,0 % à 31,8 % ; la proportion de générations sécurisées aux trois granularités — fonction, fichier, dépôt — passe de 8 % à 14,7 %, soit quasi un doublement. Les valeurs absolues restent faibles : moins de 15 % de générations sécurisées aux trois granularités, donc pas une ligne de revue humaine à économiser quand l’agent écrit du code sensible à la sécurité. Mais la pente de 8 % à 14,7 % pointe dans le bon sens, et l’éditeur a de surcroît retiré les données de cybersécurité offensive de son entraînement pour ne conserver que les tâches défensives.
En regardant le tout en arrière, l’interrupteur que cette sortie a actionné, c’est la courbe des coûts : 1,67 dollar tombe dans la zone de prix où une entreprise accepte de payer pour tenter une tâche ; 4,43 dollar, non. Les scores des classements peuvent être suspectés de venir des graphiques officiels, les vidéos de cas d’être mises en scène — les chiffres de la grille tarifaire, eux, ne se discutent pas. Qwen4-Max n’a pas encore battu Kimi K3.1 ni Opus 5.5 sur l’ingénierie terminal ; ce qu’il a gagné, c’est de permettre aux agents de longue haleine d’entrer pour la première fois dans les plannings de production et les flux quotidiens. À la prochaine génération de modèles phares, la taille des paramètres occupera sans doute la deuxième ligne — la courbe des coûts a déjà pris cette place.
Références :
- Blog officiel Qwen : annonce de lancement de Qwen4-Max
- DataLearner : fiche et classements du modèle
- Simon Willison : tests de dessin sur les quatre modes de raisonnement