Sur le benchmark MATH-500, le modèle compact Qwen3.5-0.8B ne parvenait initialement qu’à un taux de réussite modeste de 7,9 %. Lors de 93 % des problèmes soumis, le modèle se figeait en cours de résolution, percutant de plein fouet le plafond contextuel de 32 768 tokens. Enfermé dans une boucle de répétition textuelle infinie, il épuisait l’intégralité de son quota sans jamais livrer de réponse finale.
L’approche d’ingénierie classique consisterait à rassembler de nouveaux jeux de données et à relancer de longs et coûteux cycles d’entraînement par rétropropagation. Trois chercheurs ont choisi une voie radicalement différente : ils ont couplé le modèle de pointe Astra à un environnement Python standard, lui conférant la capacité d’inspecter et d’écraser directement les paramètres profonds du réseau de neurones.
93 % de résolutions piégées en boucle infinie : un petit modèle figé avant la ligne d’arrivée
Affichant moins d’un milliard de paramètres, Qwen3.5-0.8B manifestait de sévères blocages logiques dès l’activation de son mode de réflexion approfondie. La documentation officielle du modèle avait déjà émis une mise en garde, signalant la propension de ce modèle sous le milliard de paramètres à s’enfermer dans des impasses lors de raisonnements à long terme. Dans son espace de travail intermédiaire, le modèle répétait inlassablement la même démonstration jusqu’à saturer la fenêtre de contexte d’un bavardage redondant.
Le modèle maîtrisait parfaitement les règles de dérivation algébrique, mais son circuit de résolution se trouvait verrouillé par un signal anormal d’auto-excitation. La puissance de calcul s’évaporait dans des itérations vaines, évinçant purement et simplement le raisonnement mathématique.
Les données d’évaluation confirmaient l’ampleur du dysfonctionnement : sur le jeu GSM8K, le score du modèle d’origine plafonnait à 13,8 %, tandis que son score au test de suivi d’instructions (IFEval) stagnait à 21,0 %. Le réseau neuronal évoquait un bolide au moteur impeccable mais dont le frein à main serait désespérément bloqué, exigeant une intervention chirurgicale ciblée.
Sans rétropropagation de gradient : l’IA pratique la neurochirurgie par le code
Dans la vision traditionnelle, les milliards de nombres en virgule flottante constituant les poids d’un réseau forment une boîte noire impénétrable. Pour corriger le comportement d’un réseau, les ingénieurs devaient s’en remettre à la rétropropagation et à la descente de gradient. Ce processus probabiliste modifie l’ensemble du modèle, risquant à tout instant de dégrader les connaissances générales acquises par oubli catastrophique.
L’équipe de recherche a introduit un nouveau paradigme baptisé “Programmation dans l’espace des poids” (Weight-Space Programming). Astra s’est affranchi de clusters GPU onéreux et de longs cycles d’entraînement, mobilisant un simple interpréteur Python pour lire directement les tenseurs. Les chercheurs ont octroyé à Astra un budget de 50 passes avant (Forward Passes) pour observer l’état d’activation des couches intermédiaires.
Astra est parvenu à isoler avec exactitude le circuit responsable du blocage. Au sein des modules de perceptrons multicouches (MLP) des 15e et 19e couches, une direction vectorielle anormale inscrivait continuellement un schéma de répétition dans les activations. Astra a conçu un script retranchant ce vecteur spécifique des 64 colonnes de sortie de ces deux couches, tranchant net le canal de propagation de la boucle.
L’opération chirurgicale n’a modifié que 131 072 paramètres en virgule flottante, soit à peine 0,016 % des 800 millions de paramètres du modèle. Une fois la modification appliquée, la proportion d’exécutions heurtant la limite de tokens a chuté à 33,1 %, tandis que la précision sur MATH-500 a bondi à 48,1 %. Parallèlement, le score GSM8K a grimpé à 67,1 %, et la capacité de suivi des instructions a presque triplé. Cette résection précise au niveau des paramètres a instantanément libéré un potentiel de raisonnement étouffé par une anomalie technique.
Les expériences de contrôle brisent le mythe : réparer un circuit ne crée pas de savoir ex nihilo
Une telle envolée de performance suscite naturellement une interrogation : le grand modèle a-t-il enseigné les mathématiques supérieures au petit modèle en inventant des connaissances à partir de rien ? Pour répondre à cette question, l’équipe a mené une expérience de contrôle rigoureuse sur le modèle Gemma 3 270M de Google. Contrairement à Qwen, Gemma 3 270M ne présente presque jamais de boucles infinies et n’atteint le plafond de tokens que dans 8,5 % des cas.
Lorsqu’Astra a tenté d’appliquer la même stratégie d’édition des poids à Gemma, le gain de performance a fait défaut. Le score de base de Gemma sur MATH-500 était de 6,8 % ; après plusieurs analyses d’activation et micro-ajustements, le résultat n’a oscillé que faiblement entre 7,0 % et 7,7 %. Les auteurs précisent dans leur rapport que cette faible variation relève du bruit de mesure statistique, sans amélioration confirmée.
L’inspection menée par Astra a révélé que les échecs de Gemma provenaient d’erreurs fondamentales en calcul arithmétique et en algèbre de base. Ces lacunes conceptuelles étaient uniformément réparties dans l’ensemble du réseau, sans aucun circuit défaillant isolé qu’il eût été possible d’amputer. L’excision de poids anormaux lève une inhibition fonctionnelle, mais elle ne saurait fabriquer des connaissances préalables jamais assimilées. Un scalpel peut réséquer une tumeur, mais il ne peut suppléer à la croissance osseuse.
Du décryptage de jeux à la refonte de réseaux : un nouvel accès au cœur des paramètres
Intervenir directement sur les poids ne sert pas seulement à déboguer des modèles de langage ; cela permet également de décrypter les stratégies latentes en apprentissage par renforcement (Reinforcement Learning). Lors d’un test, les chercheurs ont soumis à Astra un réseau multicouche sans étiquette comprenant 17 253 poids. En s’appuyant uniquement sur la distribution numérique des matrices de poids, Astra a déduit que ce réseau pilotait le jeu rétro Breakout d’Atari.
Le cheminement déductif d’Astra apparaît distinctement dans ses journaux d’exécution : il a relevé que les zones de forte activation de la première couche se concentraient sur la ligne inférieure de la grille d’entrée, identifiant la raquette du joueur, tandis que les poids associés à de fortes récompenses s’alignaient en haut de la grille, correspondant aux briques à détruire. Le modèle a démontré une capacité réelle à interpréter la géométrie abstraite d’un espace de paramètres à haute dimension.
 Figure : Ce réseau de seulement 17 253 poids jouait à Breakout : après suppression des étiquettes de tâche, Astra l’a reconnu uniquement à partir des valeurs de ses poids. Source : Blog officiel d’Astra
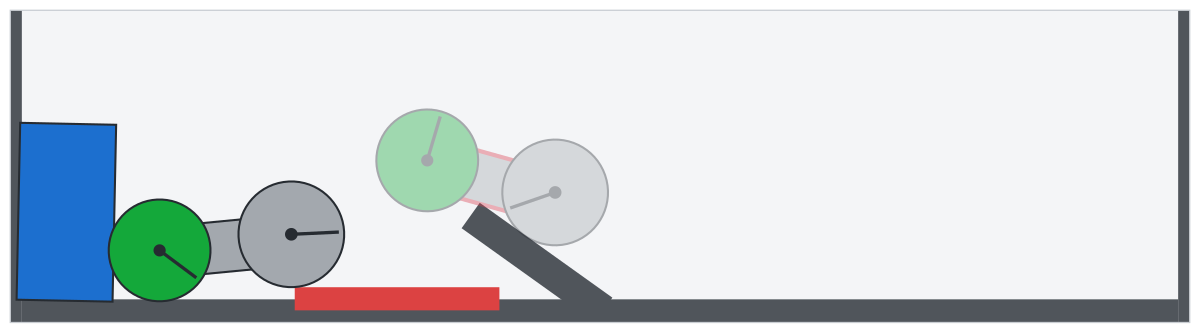 Figure : Comparatif sur le parcours du véhicule : la voiture aux poids modifiés par Astra apprend à reculer pour prendre de l’élan et sauter l’obstacle. Source : Blog officiel d’Astra
Dans une autre expérience de contrôle d’un véhicule gravissant une pente, une voiture entraînée par optimisation de politique proximale (PPO) classique restait piégée dans un optimum local, bloquée sur un talus. Astra a examiné les paramètres du contrôleur et restructuré manuellement les connexions de la couche de sortie. Le véhicule ainsi corrigé a appris à faire marche arrière pour prendre de l’élan, utilisant l’inertie pour franchir la côte et sauter l’obstacle. Les paramètres d’un réseau neuronal acquièrent ainsi une lisibilité et une maintenabilité comparables à celles d’un code logiciel standard.
Controverses dans la communauté : lever les verrous ou bâtir un nouveau moteur ?
La publication de ces travaux a suscité un débat passionné au sein de la communauté open source et du machine learning. Les interrogations sur les forums techniques ont principalement porté sur la rigueur des termes employés. Le développeur l9o a souligné qu’affirmer avoir “appris les mathématiques au modèle” constituait un abus de langage : Qwen possédait déjà ses aptitudes déductives, mais la boucle infinie le privait de l’occasion de rendre sa réponse. D’autres ingénieurs ont rappelé que l’ablation de concepts (Abliteration) visant à supprimer des vecteurs de direction indésirables existait déjà, la véritable percée résidant dans l’automatisation du diagnostic et de l’intervention chirurgicale grâce au raisonnement d’un LLM.
Les partisans d’une approche industrielle mettent en avant le potentiel pratique de la méthode. Pour des modèles locaux de 20B à 70B paramètres, un réentraînement exige des ressources de calcul prohibitives et expose au risque d’oubli catastrophique. Si des modèles frontières peuvent inspecter de manière autonome des groupes de poids et en extraire chirurgicalement les micro-anomalies, la communauté open source disposera d’une filière de maintenance allégée et ultra-ciblée.
La déconstruction directe de l’espace des paramètres ouvre un nouveau chapitre dans l’optimisation des réseaux neuronaux. Astra a apporté la preuve d’un dépannage pragmatique au niveau des circuits. Lorsque des algorithmes deviennent capables d’examiner et de rectifier par le code les connexions de leurs homologues, la frontière entre lever une entrave et octroyer une compétence nouvelle devient plus limpide que jamais.
Liens de référence :
- Blog technique officiel d’Astra
- Discussion sur Hacker News