MATH-500ベンチマークにおいて、パラメータ数10億未満の軽量モデル「Qwen3.5-0.8B」の初期スコアはわずか7.9%にとどまっていた。解答プロセスの93%が途中で進行不能に陥り、コンテキスト上限である32,768トークンに正面から衝突していた。モデルは無意味なテキストの自己反復ループに捕らわれ、トークン枠を使い切るまで最終回答を出力できなかった。
従来の機械学習エンジニアリングであれば、新たな訓練データを集めて長時間のバックプロパゲーション(逆伝播)を再実行するところだ。しかし3人の研究チームはまったく異なるアプローチを選択した。最先端の大規模言語モデル「Astra」にPython実行環境を与え、ターゲットモデル深層のニューラルネットワーク重みを直接読み書きさせたのである。
93%が無限ループで脱落、ゴール直前で立ち往生する小型モデル
10億パラメータに満たないQwen3.5-0.8Bは、ディープシンキング(推論)モードを起動すると深刻な論理の停滞を示した。公式ドキュメントでもすでに警告されていた通り、この極小モデルは長期推論において思考のデッドロックに陥りやすい。推論用スクラッチパッドの中で同一の論証パターンを何度もループさせ、コンテキストウィンドウが冗長なテキストで埋め尽くされていく。
モデル自身は代数推論のルールを理解しているにもかかわらず、解答回路が異常な自己励起シグナルによってロックされていた。計算リソースが無益なループで浪費され、本来進むべき数学的導出が思考領域から締め出されていたのだ。
評価データによると、ベースモデルのGSM8Kスコアも13.8%と低迷し、指示追従ベンチマーク(IFEval)も21.0%にとどまっていた。このニューラルネットワークは、エンジンは正常に回っているのにサイドブレーキが固着したレーシングカーのような状態であり、ピンポイントの外科手術を必要としていた。
勾配降下法をバイパス:AIがコードで執刀する神経外科手術
従来の常識では、数十億個の浮動小数点数で構成される重みパラメータは分解不可能なブラックボックスと見なされてきた。ネットワークの振る舞いを修正するには、バックプロパゲーションと勾配降下法に頼るしかなかった。だがそれは確率的な重み調整であり、モデルが本来持っていた汎用的な知識を破壊する(破滅的忘却を招く)リスクを常に孕んでいる。
研究チームが提唱したのは「重み空間プログラミング」(Weight-Space Programming)という新たな枠組みだ。Astraは大規模なGPUクラスタによる再学習を一切必要とせず、標準的なPythonインタープリタを介してテンソル値を直接読み取る。チームはAstraに50回分のフォワードパス(順伝播)バジェットを与え、中間活性化層の計算状態をプロファイリングさせた。
Astraは破綻を引き起こしている具体的な回路を特定することに成功した。第15層および第19層のMLP(多層パーセプトロン)モジュール内に、ループ特性を持続的に書き込み続ける異常なベクトル方向が存在していた。AstraはPythonスクリプトを生成し、これら2層の64列の出力から該当ベクトルを正確に引き算することで、デッドロックの伝播経路を物理的に切断した。
手術による変更対象はわずか131,072個の浮動小数点パラメータであり、モデル全体の8億パラメータのうち比率はわずか0.016%にすぎない。修正後、長さ上限に衝突する割合は33.1%へと激減し、MATH-500の正答率は48.1%へと急伸した。同時にGSM8Kの正答率も67.1%へ跳ね上がり、指示追従性能は3倍近く向上した。パラメータレベルの精密な切除によって、バグに覆い隠されていた本来の推論能力が一気に解放されたのだ。
対照実験が暴く真実:回路の切除は知識の無中生有ではない
この飛躍的な向上を目にすると、「フロンティアモデルが重みを書き換えることで、小型モデルに高度な数学の知識をゼロから教え込んだのではないか」という直感的な期待を抱くかもしれない。研究チームはGoogleの「Gemma 3 270M」モデルを用いて厳密な対照実験を実施した。Qwenとは異なり、Gemma 3 270Mはもともと推論ループをほとんど起こさず、トークン上限に到達する確率は8.5%にすぎない。
Astraが同様の手法でGemmaの最適化を試みたところ、スコア向上効果はまったく現れなかった。GemmaのMATH-500初期スコアは6.8%であり、複数回のフォワードパス分析と微小な重み調整を行っても、スコアは7.0%から7.7%の間でわずかに揺らぐにとどまった。論文でも、この程度の変動はテストノイズの範囲内であり、有意な改善効果は確認されなかったと結論づけられている。
Astraがパラメータを精査したところ、Gemmaのエラーは四則演算や初等代数の変形ミスといった基礎知識の不足に起因していた。こうした知識の欠落はネットワーク全体にまんべんなく分散しており、局所的に切除できる単一の故障回路は存在しなかった。異常な重みの切除は機能の阻害を解除できるが、最初から学習されていない事前知識を無から捏造することはできない。 外科用メスは腫瘍を切除できても、骨格を成長させる代わりにはならないのである。
ゲームの読解からポリシーの再配線まで:重み空間が開く新たな工学の扉
重みへの直接介入は、言語モデルのバグ修正にとどまらず、強化学習(Reinforcement Learning)の隠れた方策を読み解く手段としても機能する。ある実験において、研究チームはタスクのラベルをすべて伏せた17,253パラメータの小規模ネットワークをAstraに提示した。Astraは重み行列の数値分布だけを手がかりに、このネットワークがアタリの「ブロックくずし」(Breakout)をプレイしていることを見事に看破した。
Astraの推論過程は実行ログに明瞭に記録されている。第1層の重みにおいて高反応を示す領域が入力グリッドの最下行に集中していることから「プレイヤーが操作するパドル」と判断し、高報酬に結びつく重みがグリッド最上段に配置されていることから「壊すべきブロック」の配置であると論理的に同定した。高次元のパラメータ空間の幾何構造を抽象的に読み解く能力が実証された形だ。
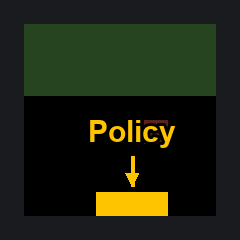 図:わずか17,253パラメータのこのネットワークはブロックくずしをプレイしていた。ラベルを消去された状態で、Astraは重みの数値分布のみからそれを特定した。出典:Astra公式ブログ
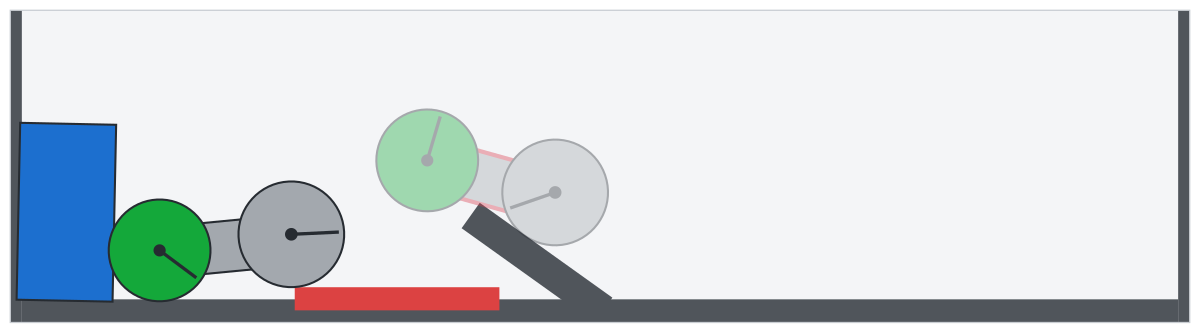 図:車両障害物ステージの比較:Astraによって重みを修正された車は、一度バックして勢いをつけ、坂を駆け上がって障害物を跳び越える動作を獲得した。出典:Astra公式ブログ
さらに、急坂を越える車両制御の強化学習タスクにおいて、従来のPPO(近位方策最適化)で学習された車両は局所最適解に陥り、急な坂の手前で立ち往生を繰り返していた。Astraはコントローラのパラメータ行列を調査し、出力層の結合関係を手作業で再構築した。修正を受けた車両は「一度バックして助走距離を取り、慣性を利用して一気に急坂を駆け上がりジャンプして障害物を飛び越える」という巧みな動作を身につけた。ニューラルネットワークのパラメータが、まるで従来のソフトウェアコードのような可読性と保守性を獲得しつつある。
コミュニティの議論:障害物の除去か、それとも新たなエンジンの創出か
実験結果が公開されると、オープンソースやAIエンジニアのコミュニティで活発な議論が巻き起こった。技術フォーラムにおける懐疑的な見解は、主に概念の定義に向けられた。開発者のl9o氏は、ループを解除したことを「モデルに数学を教え込んだ」と表現するのは不正確だと指摘する。Qwenにはもともと推論能力が備わっており、無限ループのせいで答えを提出する機会を奪われていただけにすぎないというわけだ。また別のエンジニアは、特定の特徴ベクトルを除去するアブリトレーション(Abliteration)技術は以前から存在しており、今回の真のブレイクスルーはLLMの自律推論によってその診断と修正プロセスを自動化した点にあると論じた。
一方で工学的な実用性を支持する開発者らは、このアプローチが持つ産業的価値を高く評価している。20Bから70B規模のローカルモデルにおいて、再ファインチューニングには莫大な計算資源が必要であり、破滅的忘却を引き起こしやすい。もしフロンティアモデルが重みクラスタを自律的にパトロールし、局所的な欠陥をピンポイントで外科的に除去できるようになれば、オープンソースコミュニティは極めて軽量なモデル保守パイプラインを手にすることになる。
パラメータ空間の直接解読は、ニューラルネットワークの最適化にまったく新しい地平を切り拓いた。Astraが示したのは、実用的な回路レベルのトラブルシューティング手法だ。アルゴリズムがコードによって同類の神経結合を自律点検し修正できるようになるとき、「障害の除去」と「能力の付与」の境界線もまた、より明確に見極められるようになるだろう。
参考リンク:
- Astra公式技術ブログ
- Hacker Newsコミュニティの議論