En la evaluación de referencia MATH-500, el modelo ligero Qwen3.5-0.8B obtuvo inicialmente una precisión de apenas el 7,9%. En el 93% de los problemas evaluados, el modelo se bloqueaba a mitad del razonamiento, chocando directamente contra el límite de longitud de 32.768 tokens. Atrapado en un bucle interminable de repetición de texto, consumía todo el presupuesto de contexto sin llegar a entregar una respuesta final.
El enfoque tradicional de la ingeniería de aprendizaje automático optaría por recopilar nuevos conjuntos de datos e iniciar un largo y costoso ciclo de reentrenamiento por retropropagación. Tres investigadores tomaron un camino radicalmente distinto: conectaron un intérprete estándar de Python al modelo de vanguardia Astra y le permitieron inspeccionar y sobreescribir directamente los parámetros subyacentes de la red neuronal.
El 93% de las ejecuciones atrapadas en bucles: un modelo pequeño bloqueado ante la meta
Con menos de mil millones de parámetros, Qwen3.5-0.8B mostró severos bloqueos lógicos al activar el modo de razonamiento profundo. La documentación oficial del modelo ya había advertido con anterioridad de que este modelo sub-milmillonario tendía a caer en callejones sin salida en tareas de razonamiento de largo alcance. En su borrador interno, el modelo reiteraba una y otra vez la misma formulación deductiva hasta llenar por completo la ventana de contexto con texto redundante.
El modelo comprendía las reglas de derivación algebraica, pero el circuito de resolución de problemas quedaba bloqueado por una señal anómala de autoexcitación. La capacidad de cómputo se disipaba en ciclos infructuosos, desplazando la deducción matemática real fuera del campo de visión.
Los datos de evaluación confirmaron la magnitud de la anomalía: en GSM8K la precisión se quedaba en un modesto 13,8%, mientras que en la prueba de seguimiento de instrucciones (IFEval) se estancaba en el 21,0%. La red neuronal recordaba a un vehículo de carreras con el motor en perfecto estado pero con el freno de mano trabado, urgido de una intervención quirúrgica precisa.
Sin retropropagación de gradientes: la IA ejecuta neurocirugía mediante código
En la concepción habitual, los miles de millones de números en coma flotante que forman los pesos se consideran una caja negra impenetrable. Para corregir el comportamiento de una red, los ingenieros recurren tradicionalmente a la retropropagación y al descenso de gradiente. Este proceso probabilístico modifica parámetros en todo el modelo, arriesgándose a destruir conocimientos generales consolidados mediante olvido catastrófico.
El equipo de investigación propuso un paradigma denominado “Programación en el Espacio de Pesos” (Weight-Space Programming). En lugar de costosos clústeres de GPU para entrenamientos prolongados, Astra recurrió a un intérprete común de Python para leer y manipular tensores de forma directa. Los autores concedieron a Astra un presupuesto de 50 pasadas hacia adelante (Forward Passes) para examinar los estados de activación de las capas intermedias.
Astra localizó con exactitud el circuito causante del colapso. En los módulos perceptrón multicapa (MLP) de las capas 15 y 19 existía una dirección vectorial anómala que inscribía de forma continua un patrón de bucle repetitivo. Astra generó un script en Python que restó con precisión ese vector de 64 columnas de salida en ambas capas, cortando limpiamente la ruta de retroalimentación del bucle.
La intervención quirúrgica solo modificó 131.072 parámetros en coma flotante, apenas el 0,016% del total de 800 millones de parámetros del modelo. Tras la corrección, la proporción de respuestas que chocaban contra el límite de tokens se redujo al 33,1%, y la precisión en MATH-500 se disparó hasta el 48,1%. Al mismo tiempo, el resultado en GSM8K ascendió al 67,1% y la capacidad de seguimiento de instrucciones casi se triplicó. La ablación a nivel de parámetros liberó el potencial de deducción que permanecía sofocado por el fallo.
Los experimentos de control disipan el mito: corregir circuitos no genera conocimiento de la nada
Este notable salto plantea de inmediato una interrogante: ¿enseñó el gran modelo matemáticas avanzadas al modelo pequeño creando conocimiento desde la nada? Para contrastarlo, el equipo realizó un experimento de control riguroso con Gemma 3 270M de Google. A diferencia de Qwen, Gemma 3 270M rara vez experimenta bucles lógicos y solo alcanza el límite de longitud en el 8,5% de los casos.
Cuando Astra intentó aplicar la misma metodología de edición en Gemma, la estrategia de mejora no surtió efecto. La puntuación inicial de Gemma en MATH-500 era del 6,8%, y tras múltiples análisis de activación y microajustes, se mantuvo oscilando débilmente entre el 7,0% y el 7,7%. Los investigadores señalaron en el informe que esta leve variación constituía simple ruido estadístico, sin mejora cuantificable confirmada.
Al inspeccionar los parámetros, Astra constató que los fallos de Gemma se debían a deficiencias fundamentales en operaciones aritméticas básicas y transformaciones algebraicas. Estas carencias de conocimiento estaban distribuidas de manera homogénea por toda la red, sin que existiera un circuito anómalo individual que extirpar. La resección de pesos anómalos puede liberar la inhibición de funciones, pero no puede inventar conocimientos previos que el modelo jamás aprendió. El bisturí extirpa tumores, pero no puede sustituir el desarrollo óseo.
De descifrar videojuegos a reestructurar redes: un nuevo horizonte en el espacio de parámetros
La intervención directa en los pesos no solo sirve para corregir modelos de lenguaje; también permite descifrar las políticas ocultas del aprendizaje por refuerzo (Reinforcement Learning). En un ensayo, los investigadores suministraron a Astra una red multicapa sencilla con 17.253 pesos, habiendo ocultado cualquier etiqueta sobre la tarea. A partir únicamente de la distribución numérica de las matrices de pesos, Astra dedujo que la red ejecutaba el clásico videojuego Breakout de Atari.
La cadena de razonamiento de Astra quedó registrada con nitidez en sus registros de ejecución: identificó que las regiones de mayor activación en la primera capa se concentraban en la última fila de la cuadrícula de entrada, deduciendo que correspondían a la paleta del jugador, mientras que los pesos vinculados a altas recompensas se situaban en la fila superior, coincidiendo con la puntuación de los bloques. El modelo demostró capacidad para interpretar la geometría abstracta de espacios de parámetros de alta dimensión.
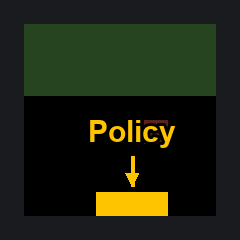 Figura: Esta red con apenas 17.253 pesos ejecutaba Breakout. Sin etiquetas de tarea, Astra la identificó únicamente a partir de los valores de sus pesos. Fuente: Blog oficial de Astra
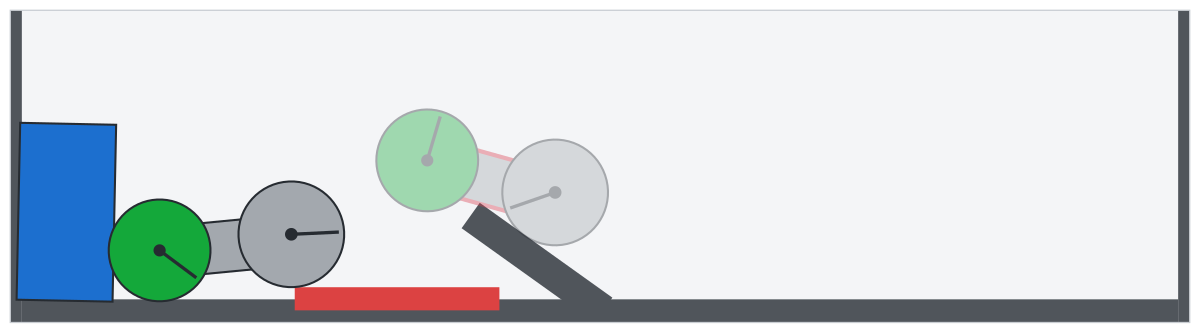 Figura: Comparativa en la prueba del vehículo con obstáculos: el coche con pesos modificados por Astra aprende a dar marcha atrás, ganar inercia y saltar la barrera. Fuente: Blog oficial de Astra
En otro experimento de control sobre un vehículo que debía ascender una colina empinada, un agente entrenado con Proximal Policy Optimization (PPO) convencional había quedado atrapado en un óptimo local, estancándose indefinidamente ante la pendiente. Astra examinó los parámetros del controlador y reconfiguró de forma manual las conexiones de la capa de salida. El vehículo modificado aprendió a retroceder para ganar impulso, embistiendo la cuesta con inercia para saltar el obstáculo. De este modo, los parámetros de las redes neuronales comienzan a ofrecer una legibilidad y capacidad de mantenimiento comparables a las del código fuente tradicional.
Controversia en la comunidad: ¿eliminar obstáculos o construir motores nuevos?
La divulgación del trabajo provocó un vivo debate en la comunidad de código abierto y aprendizaje automático. Las dudas en foros técnicos apuntaron principalmente a la definición conceptual. El desarrollador l9o señaló que afirmar que se había “enseñado matemáticas al modelo” resultaba inexacto, pues Qwen ya disponía de la capacidad lógica pero el bucle infinito le impedía entregar los resultados. Otros ingenieros recordaron que la técnica de ablación de conceptos (Abliteration) para suprimir sesgos ya existía con anterioridad, residiendo el verdadero mérito en haber automatizado el diagnóstico y la cirugía mediante el razonamiento de un modelo de lenguaje.
Los partidarios de su aplicación práctica destacan su enorme potencial industrial. En modelos locales de entre 20B y 70B parámetros, el reentrenamiento exige infraestructuras de cómputo inasumibles y arriesga el olvido catastrófico. Si los grandes modelos pueden auditar de forma autónoma cúmulos de pesos y extirpar microdefectos con precisión quirúrgica, la comunidad de código abierto dispondrá de una vía de mantenimiento sumamente ligera y eficiente.
La deconstrucción directa del espacio de parámetros traza una ruta innovadora para la optimización de redes neuronales. Astra ha mostrado un método pragmático de resolución de fallos a nivel de circuitos. Cuando los algoritmos son capaces de inspeccionar y reparar las conexiones de sus semejantes mediante código, la frontera entre eliminar impedimentos y crear capacidades se vuelve mucho más nítida.
Enlaces de referencia:
- Blog técnico oficial de Astra
- Debate en la comunidad de Hacker News