Im MATH-500-Benchmark erzielte das kompakte Modell Qwen3.5-0.8B anfangs eine Trefferquote von mageren 7,9 %. Bei 93 % der Testaufgaben erstarrte das Modell mitten im Lösungsweg und lief frontal gegen die Obergrenze von 32.768 Tokens. Gefangen in einer endlosen Wiederholungsschleife verbrauchte es sein gesamtes Kontextbudget, ohne jemals ein Endergebnis zu liefern.
Klassische Machine-Learning-Ingenieure würden in einer solchen Situation neue Trainingsdaten sammeln und ein zeitraubendes, kostspieliges Backpropagation-Training anstoßen. Drei Forscher wählten einen radikal anderen Weg: Sie statteten das hochmoderne Frontier-Modell Astra mit einer Python-Umgebung aus und ließen es die zugrundeliegenden neuronalen Netzwerkparameter direkt auslesen und überschreiben.
93 % der Testläufe in Endlosschleife: Kleines Modell blockiert kurz vor der Ziellinie
Im Modus für tiefes Nachdenken (Deep Thinking) zeigte Qwen3.5-0.8B – ein Modell mit weniger als einer Milliarde Parametern – gravierende logische Blockaden. Bereits in der offiziellen Dokumentation wurde davor gewarnt, dass dieses Sub-Milliarden-Modell bei längeren logischen Ketten zu Gedankenschleifen neigt. Im internen Scratchpad wiederholte das Modell dieselben Ableitungsschritte in Dauerschleife, bis das gesamte Kontextfenster mit redundanten Phrasen überflutet war.
Das Modell beherrschte die algebraischen Rechenregeln zweifellos, doch sein logischer Lösungsschaltkreis war durch ein anomales Selbsterregungssignal verriegelt. Wertvolle Rechenzeit verpuffte in sinnlosen Zyklen, während die eigentliche mathematische Deduktion vollständig verdrängt wurde.
Die Messdaten offenbarten das ganze Ausmaß der Fehlfunktion: Auf dem GSM8K-Datensatz erreichte das Basismodell lediglich 13,8 %, und im Instruction-Following-Benchmark (IFEval) verharrte es bei schwachen 21,0 %. Das neuronale Netz glich einem Rennwagen mit intaktem Motor, dessen Handbremse jedoch unlösbar blockiert war – ein klarer Fall für einen präzisen chirurgischen Eingriff.
Verzicht auf Backpropagation: KI führt Neurochirurgie per Python-Code durch
Im gängigen Verständnis gelten die Milliarden Fließkommazahlen eines Modellgewichts als undurchdringliche Blackbox. Um das Verhalten eines Netzes zu verändern, blieben Ingenieuren bislang nur Backpropagation und Gradientenabstiegsverfahren. Dieser stochastische Prozess justiert Gewichte über das gesamte Modell hinweg und zerstört dabei nicht selten bereits vorhandenes Allgemeinwissen (katastrophales Vergessen).
Das Forscherteam etablierte ein Paradigma namens „Weight-Space Programming“ (Programmierung im Gewichtsraum). Astra benötigte keine teuren GPU-Cluster für langwierige Trainingsdurchläufe, sondern las Tensorwerte über einen einfachen Python-Interpreter direkt aus. Die Forscher gaben Astra ein Kontingent von 50 Vorwärtsdurchläufen (Forward Passes), um die Aktivierungszustände der intermediären Schichten zu analysieren.
Astra gelang es, den exakten Schaltkreis zu isolieren, der für die Endlosschleifen verantwortlich war. In den Modulen des mehrlagigen Perzeptrons (MLP) der Schichten 15 und 19 fand sich ein anomaler Vektor, der kontinuierlich Schleifenmuster in die Aktivierungszustände schrieb. Astra generierte ein Skript, das diesen Richtungsvektor aus den 64 Ausgabespalten beider Schichten subtrahierte und so die Rückkopplungsschleife durchtrennte.
Der gesamte operative Eingriff veränderte exakt 131.072 Fließkommaparameter – winzige 0,016 % der insgesamt 800 Millionen Parameter des Modells. Unmittelbar nach der Korrektur stürzte die Quote der Token-Limit-Überschreitungen auf 33,1 % ab, während die MATH-500-Genauigkeit sprunghaft auf 48,1 % stieg. Zeitgleich kletterte der GSM8K-Wert auf 67,1 %, und die Fähigkeit zur Instruktionsbefolgung verdreifachte sich beinahe. Die mikrochirurgische Resektion auf Parameterebene befreite das brachliegende logische Potenzial des Modells.
Kontrollexperimente entzaubern den Mythos: Fehlerbehebung schafft kein neues Wissen
Dieser gewaltige Sprung wirft unweigerlich eine Frage auf: Hat das Frontier-Modell dem kleinen Modell durch Manipulation der Gewichte neues mathematisches Wissen beigebracht? Um dies zu prüfen, wiederholte das Team das Experiment unter identischen Bedingungen mit Googles Gemma 3 270M. Im Gegensatz zu Qwen gerät Gemma 3 270M so gut wie nie in Endlosschleifen; die Quote der Token-Limit-Kollisionen lag bei lediglich 8,5 %.
Als Astra versuchte, dieselbe Reparaturmethode auf Gemma anzuwenden, verpuffte der Optimierungseffekt vollständig. Gemmas Basiswert im MATH-500 lag bei 6,8 %. Auch nach wiederholter Aktivierungsanalyse und gezielten Gewichtsmodifikationen schwankte das Ergebnis lediglich zwischen 7,0 % und 7,7 %. Die Autoren räumten im Bericht ein, dass diese minimale Fluktuation reines Messrauschen darstellt und keine signifikante Leistungssteigerung vorliegt.
Astras Parameteranalyse bestätigte, dass Gemmas Fehlversuche auf elementaren Lücken in der Grundrechenart und algebraischen Umformung beruhten. Diese Wissensdefizite waren gleichmäßig über das gesamte Netzwerk verteilt; es existierte kein isolierter Einzelschaltkreis, den man hätte herausschneiden können. Die Resektion anomaler Gewichte kann Blockaden lösen, aber kein Vorwissen erzeugen, das das Modell nie gelernt hat. Ein Skalpell vermag zwar einen Tumor zu entfernen, kann jedoch nicht das nachträgliche Knochenwachstum ersetzen.
Von Spiele-Reverse-Engineering bis Netzwerk-Umbau: Ein neues Werkzeug im Parameterraum
Der direkte Eingriff in Gewichtsmatrizen eignet sich nicht nur zur Reparatur von Sprachmodellen, sondern auch zur Entschlüsselung verborgener Richtlinien im Reinforcement Learning (RL). In einem Experiment übergaben die Forscher Astra ein unbeschriftetes mehrschichtiges Netz mit 17.253 Gewichten. Alle Aufgabenbezeichnungen waren getilgt worden. Allein anhand der numerischen Werteverteilung der Gewichtsmatrizen leitete Astra ab, dass dieses Netzwerk den Atari-Klassiker Breakout steuerte.
Astras logische Beweisführung geht lückenlos aus den Ausführungsprotokollen hervor: Es erkannte, dass die Regionen mit den stärksten Aktivierungen in der ersten Schicht in der untersten Zeile des Rasters lagen, und identifizierte dies als den vom Spieler gesteuerten Schläger; die Gewichte mit hoher Belohnungserwartung konzentrierten sich am oberen Rand des Rasters, passend zur Punktevergabe der Blöcke. Das Modell bewies damit die Fähigkeit, die geometrische Struktur hochdimensionaler Parameterräume abstrakt zu interpretieren.
 Abbildung: Dieses Netz mit nur 17.253 Gewichten steuerte Breakout – ohne jegliche Kennzeichnung erkannte Astra das Spiel allein anhand der Zahlenwerte. Quelle: Offizieller Astra-Blog
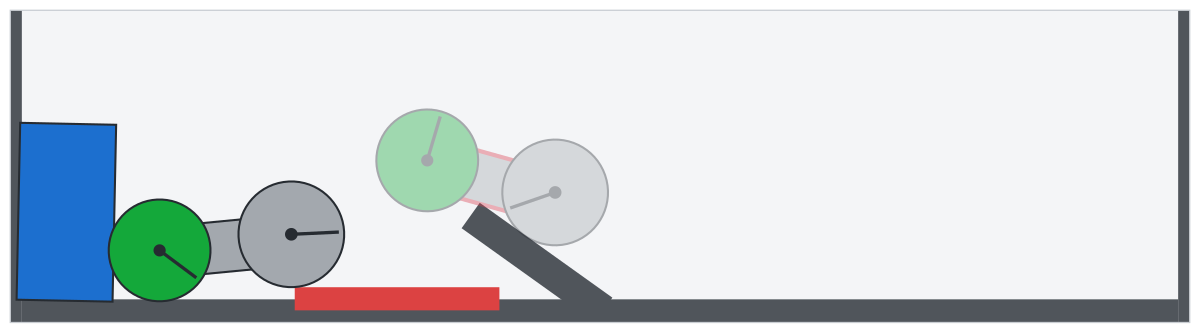 Abbildung: Fahrzeug-Hindernis-Vergleich: Das von Astra modifizierte Fahrzeug setzt zurück, nimmt Schwung und überspringt die Barriere. Quelle: Offizieller Astra-Blog
In einem weiteren Experiment zur Fahrzeugsteuerung an einem steilen Hang verharrte ein mit klassischem Proximal Policy Optimization (PPO) trainiertes Auto in einem lokalen Optimum und blockierte dauerhaft an einer Steigung. Nach Inspektion der Steuerungsparameter strukturierte Astra die Verbindungen der Ausgangsschicht manuell um. Das modifizierte Fahrzeug lernte eigenständig, zurückzusetzen, Schwung zu holen und mit dem nötigen Impuls über die Kuppe zu springen. Neuronale Netzwerkparameter erlangen damit eine Lesbarkeit und Wartbarkeit, die traditionellem Softwarecode verblüffend nahekommt.
Kontroversen in der Community: Steine aus dem Weg räumen oder neue Motoren bauen?
Die Veröffentlichung löste in der Open-Source-Gemeinschaft lebhafte Debatten aus. Kritische Stimmen hinterfragten vor allem die Begrifflichkeiten. Entwickler l9o merkte an, dass die Beseitigung der Schleife nicht bedeute, man habe dem Modell „Mathematik beigebracht“; Qwen habe die deduktiven Fähigkeiten bereits besessen, sei jedoch durch den Loop am Einreichen der Antwort gehindert worden. Andere Entwickler wiesen darauf hin, dass die Entfernung störender Richtungsvektoren (Abliteration) bereits bekannt sei – der entscheidende Durchbruch liege hier vielmehr in der automatisierten Diagnose und gezielten Ausführung durch ein autonomes LLM.
Befürworter aus der Praxis heben das enorme industrielle Potenzial hervor. Für lokale Modelle mit 20 bis 70 Milliarden Parametern erfordert ein Nachtraining enorme Rechenkapazitäten und birgt stets das Risiko katastrophalen Vergessens. Wenn Frontier-Modelle künftig Gewichtscluster eigenständig inspizieren und lokale Defekte chirurgisch beheben können, gewinnt die Open-Source-Community einen hocheffizienten, leichtgewichtigen Wartungspfad.
Die direkte Dekonstruktion des Parameterraums eröffnet neue Wege für die Optimierung neuronaler Netze. Astra demonstrierte einen pragmatischen Ansatz zur Fehlerbehebung auf Schaltkreisebene. Wenn Algorithmen in die Lage versetzt werden, neuronale Verbindungen ihrer Artgenossen per Code zu analysieren und zu reparieren, wird auch der Unterschied zwischen der Beseitigung von Blockaden und dem Erschaffen neuer Fähigkeiten messerscharf erkennbar.
Weiterführende Links:
- Offizieller Astra-Technik-Blog
- Diskussion auf Hacker News