2026 年 11 月 16 日,阿里通义千问团队发布第四代旗舰闭源模型 Qwen4-Max:2.4 万亿总参数稀疏 MoE(Mixture of Experts),每 token 激活 71B,原生视觉,1M 上下文。官方叙事的重心挪了位置,撑场面的从 benchmark 分数换成了 Work360 上的一组费用数字,单任务平均成本 4.43 美元降到 1.67 美元,降 62%。
一次任务 4.43 美元的 agent 只能待在演示视频里;降到 1.67 美元,它才可能被排进日常生产流程。Qwen4-Max 这次发布做的就是这件事:把旗舰竞争的焦点从「回答得多好」挪到「交付得多完整」。
单任务成本从 4.43 美元压到 1.67 美元,降 62%
Work360 是阿里自研的办公任务评测框架,覆盖 26 个一级域、182 个二级子域、721 个三级细分领域。Qwen4-Max 在上面拿到 52.69 分,上一代 Qwen3.8-Max 是 47.74,涨了 5 分,费用降了 62%。涨 5 分是能力的小步前进,降 62% 是另一件事:token 用量下来了。
Xhigh 与 High 两档思考档位在 Work360 上的 token 用量分别降约 24% 和 35%,在 Terminal-Bench 4.0 上降约 48% 和 49%。长程 agent 的账单大头是思考 token,API 单价只占小头。国内 API 定价从 12/36 元降到 10/30 元每百万 token,只降 16.7%;缓存命中价降到 0.5 元/M,降约 66.7%;国际站 QwenCloud 缓存命中 0.075 美元/M,约为输入价的二十分之一。agent 会话动辄几十轮工具调用,缓存命中率才是长会话账单的决定变量。
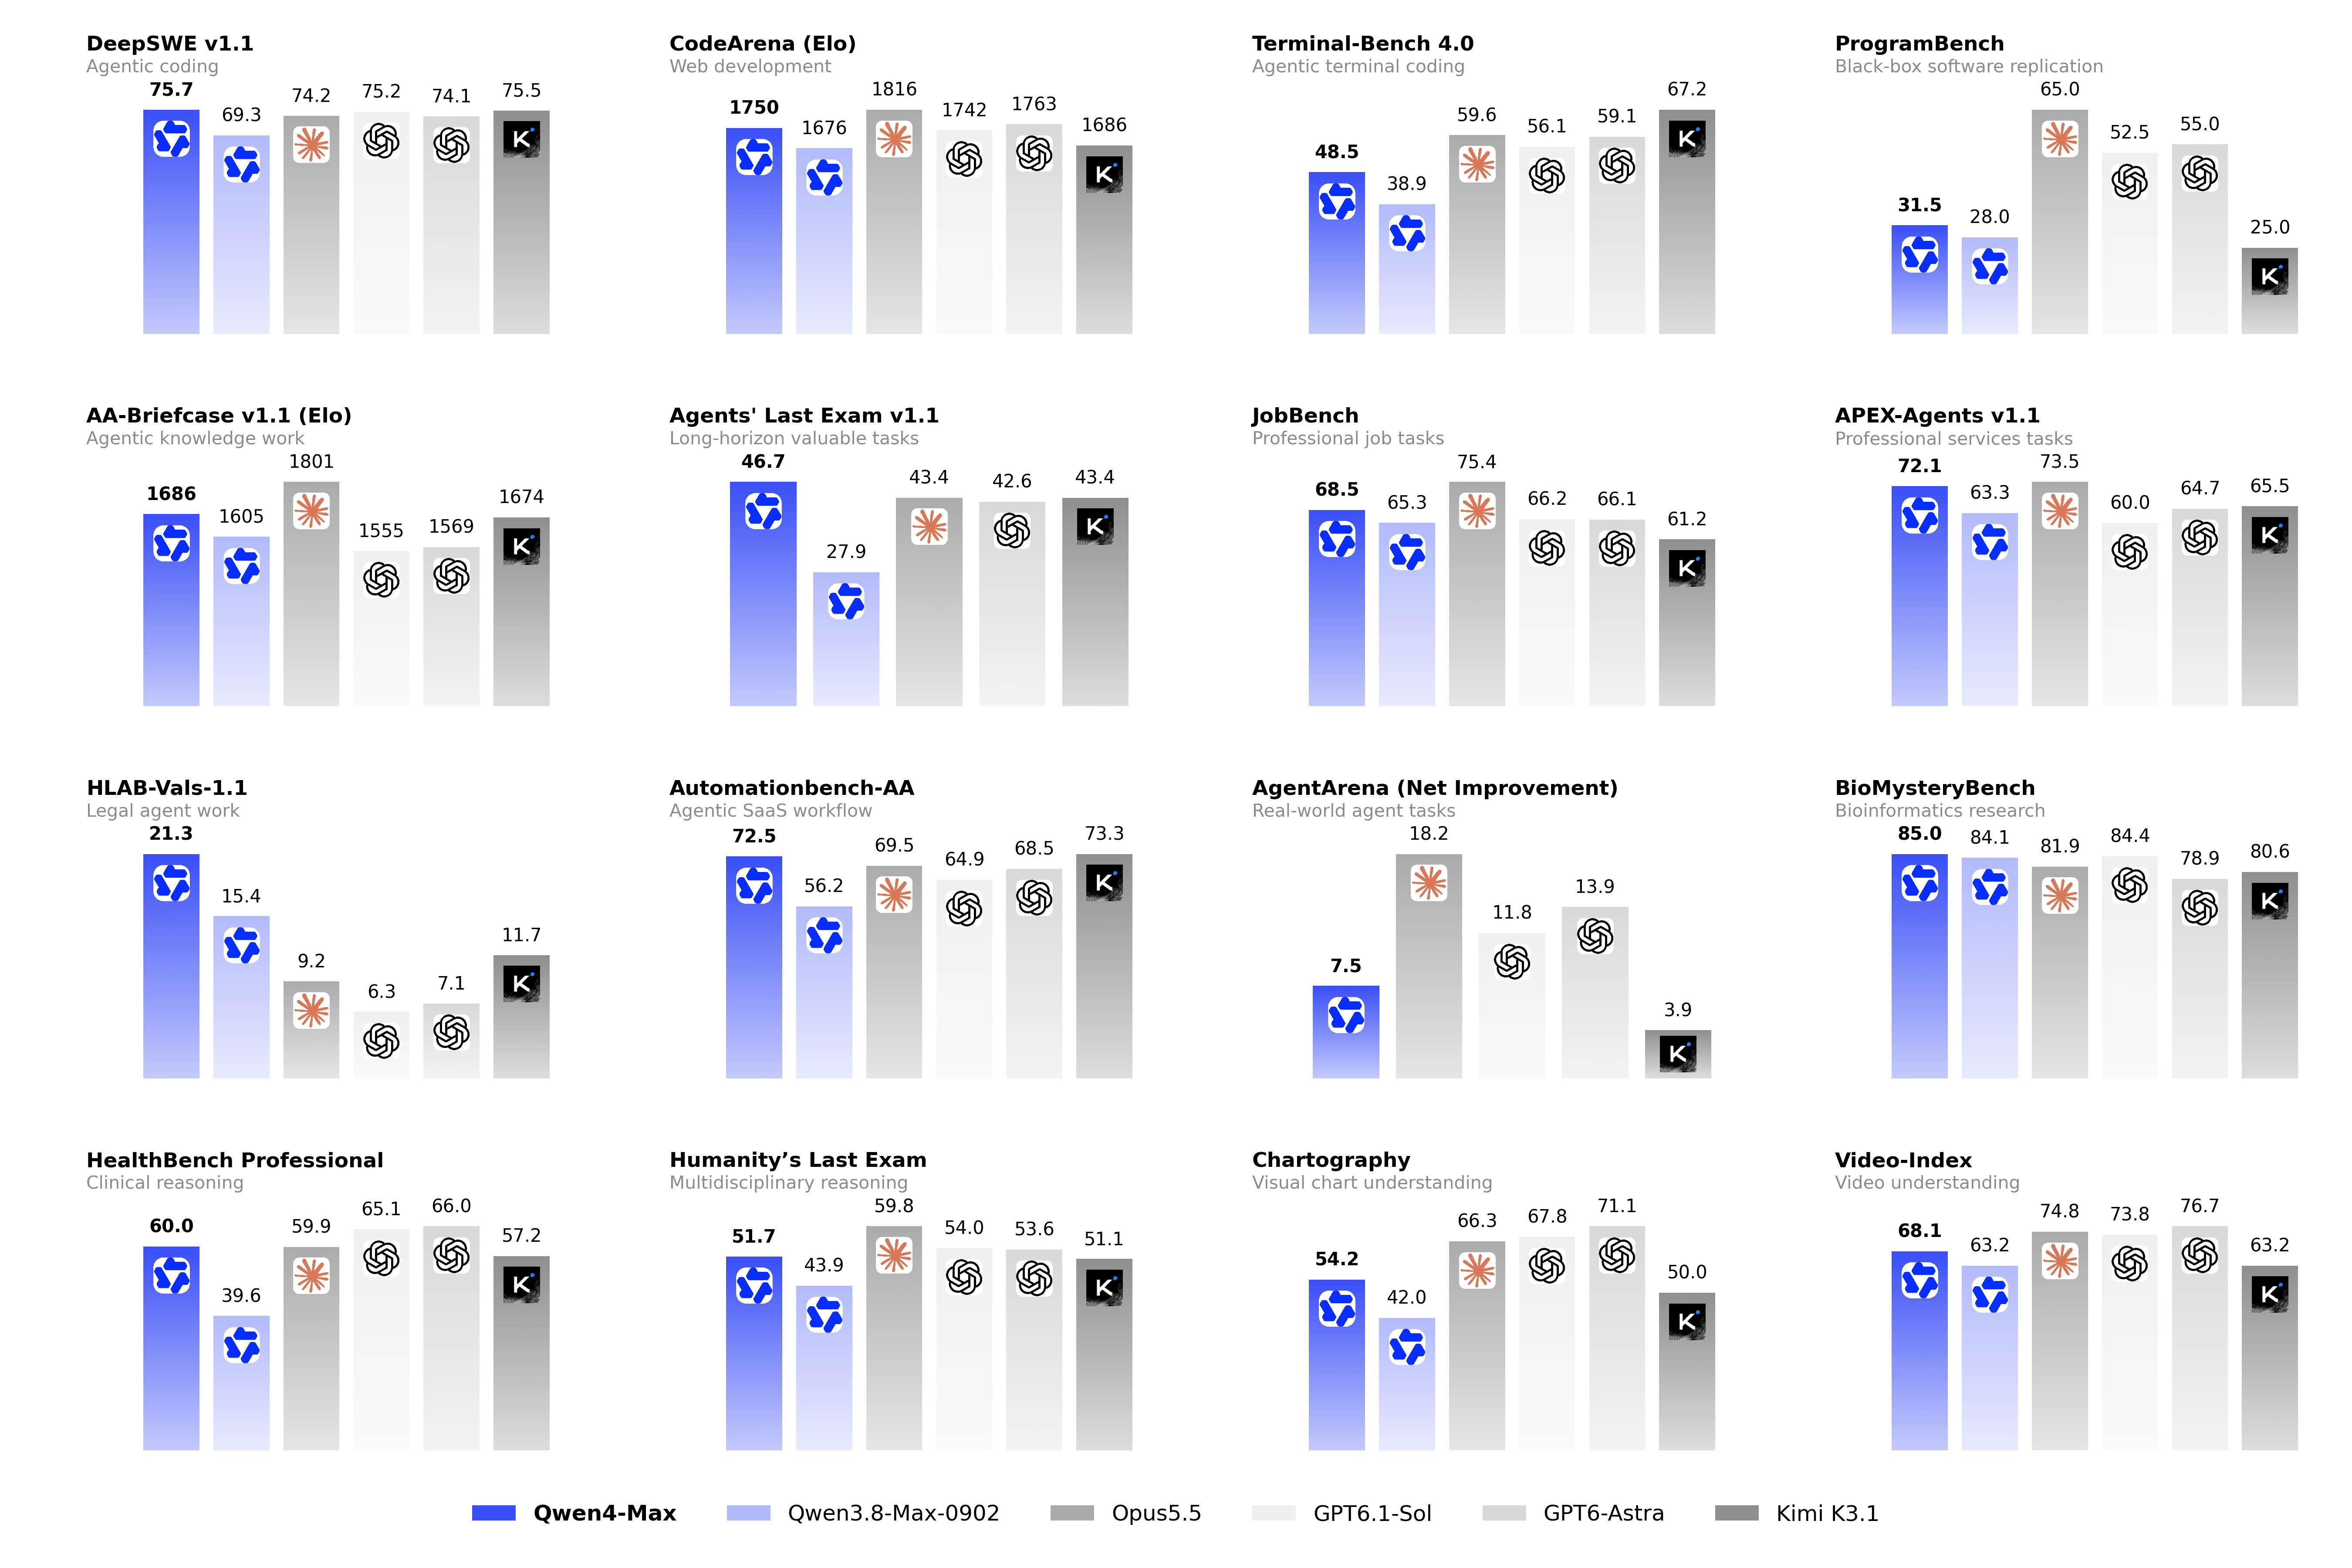
图:官方综合性能对比,Qwen4-Max 对比上一代 Qwen3.8-Max 的编码、办公、长程任务三类场景,注意对比对象是自家上一代,第三方独立评测尚未跟进。来源:Qwen 官方博客
2.4 万亿参数加 71B 激活,架构改动冲着账单去
总参数 2.4 万亿,每 token 激活 71B,另有 328B N-gram Embedding 参数,这类参数让模型容量扩大而计算量几乎不增。三项架构改动各有分工:GDN(Gated DeltaNet)加 Qwen Sparse Attention(QSA)管长上下文成本,Gated Residual 管训练稳定,N-gram Embedding 管局部 token 模式表示。
QSA 的做法是每层先用三层 Gated DeltaNet 把历史压成固定大小的状态,再用轻量 indexer 在 micro-block 粒度上挑相关上下文,长序列的 attention 成本和索引成本同时被压低。Gated Residual 用动态读写门控制四条并行残差分支的跨层信息流,收益落在训练稳定性上。证据很直接:2.4 万亿规模的预训练全程 loss 平滑下降、没有飞跳(spike),这个体量做到全程无 spike,在万亿级训练里并不多见。
Base 层面的账对得上:自研四域评测(Knowledge / Code / QA / STEM,10 × BPB,越低越好)里,Qwen4-Max-Base 的 BPB 比上一代低约 5–13%,激活参数还少 25%,稀疏度提高没有拿能力做交换。对比项里的 GLM-5.3 和 Kimi-K3.1-Pro 属于 post-trained checkpoint,官方自己注明可比性受影响,这几组数字先按官方单方面说法看。
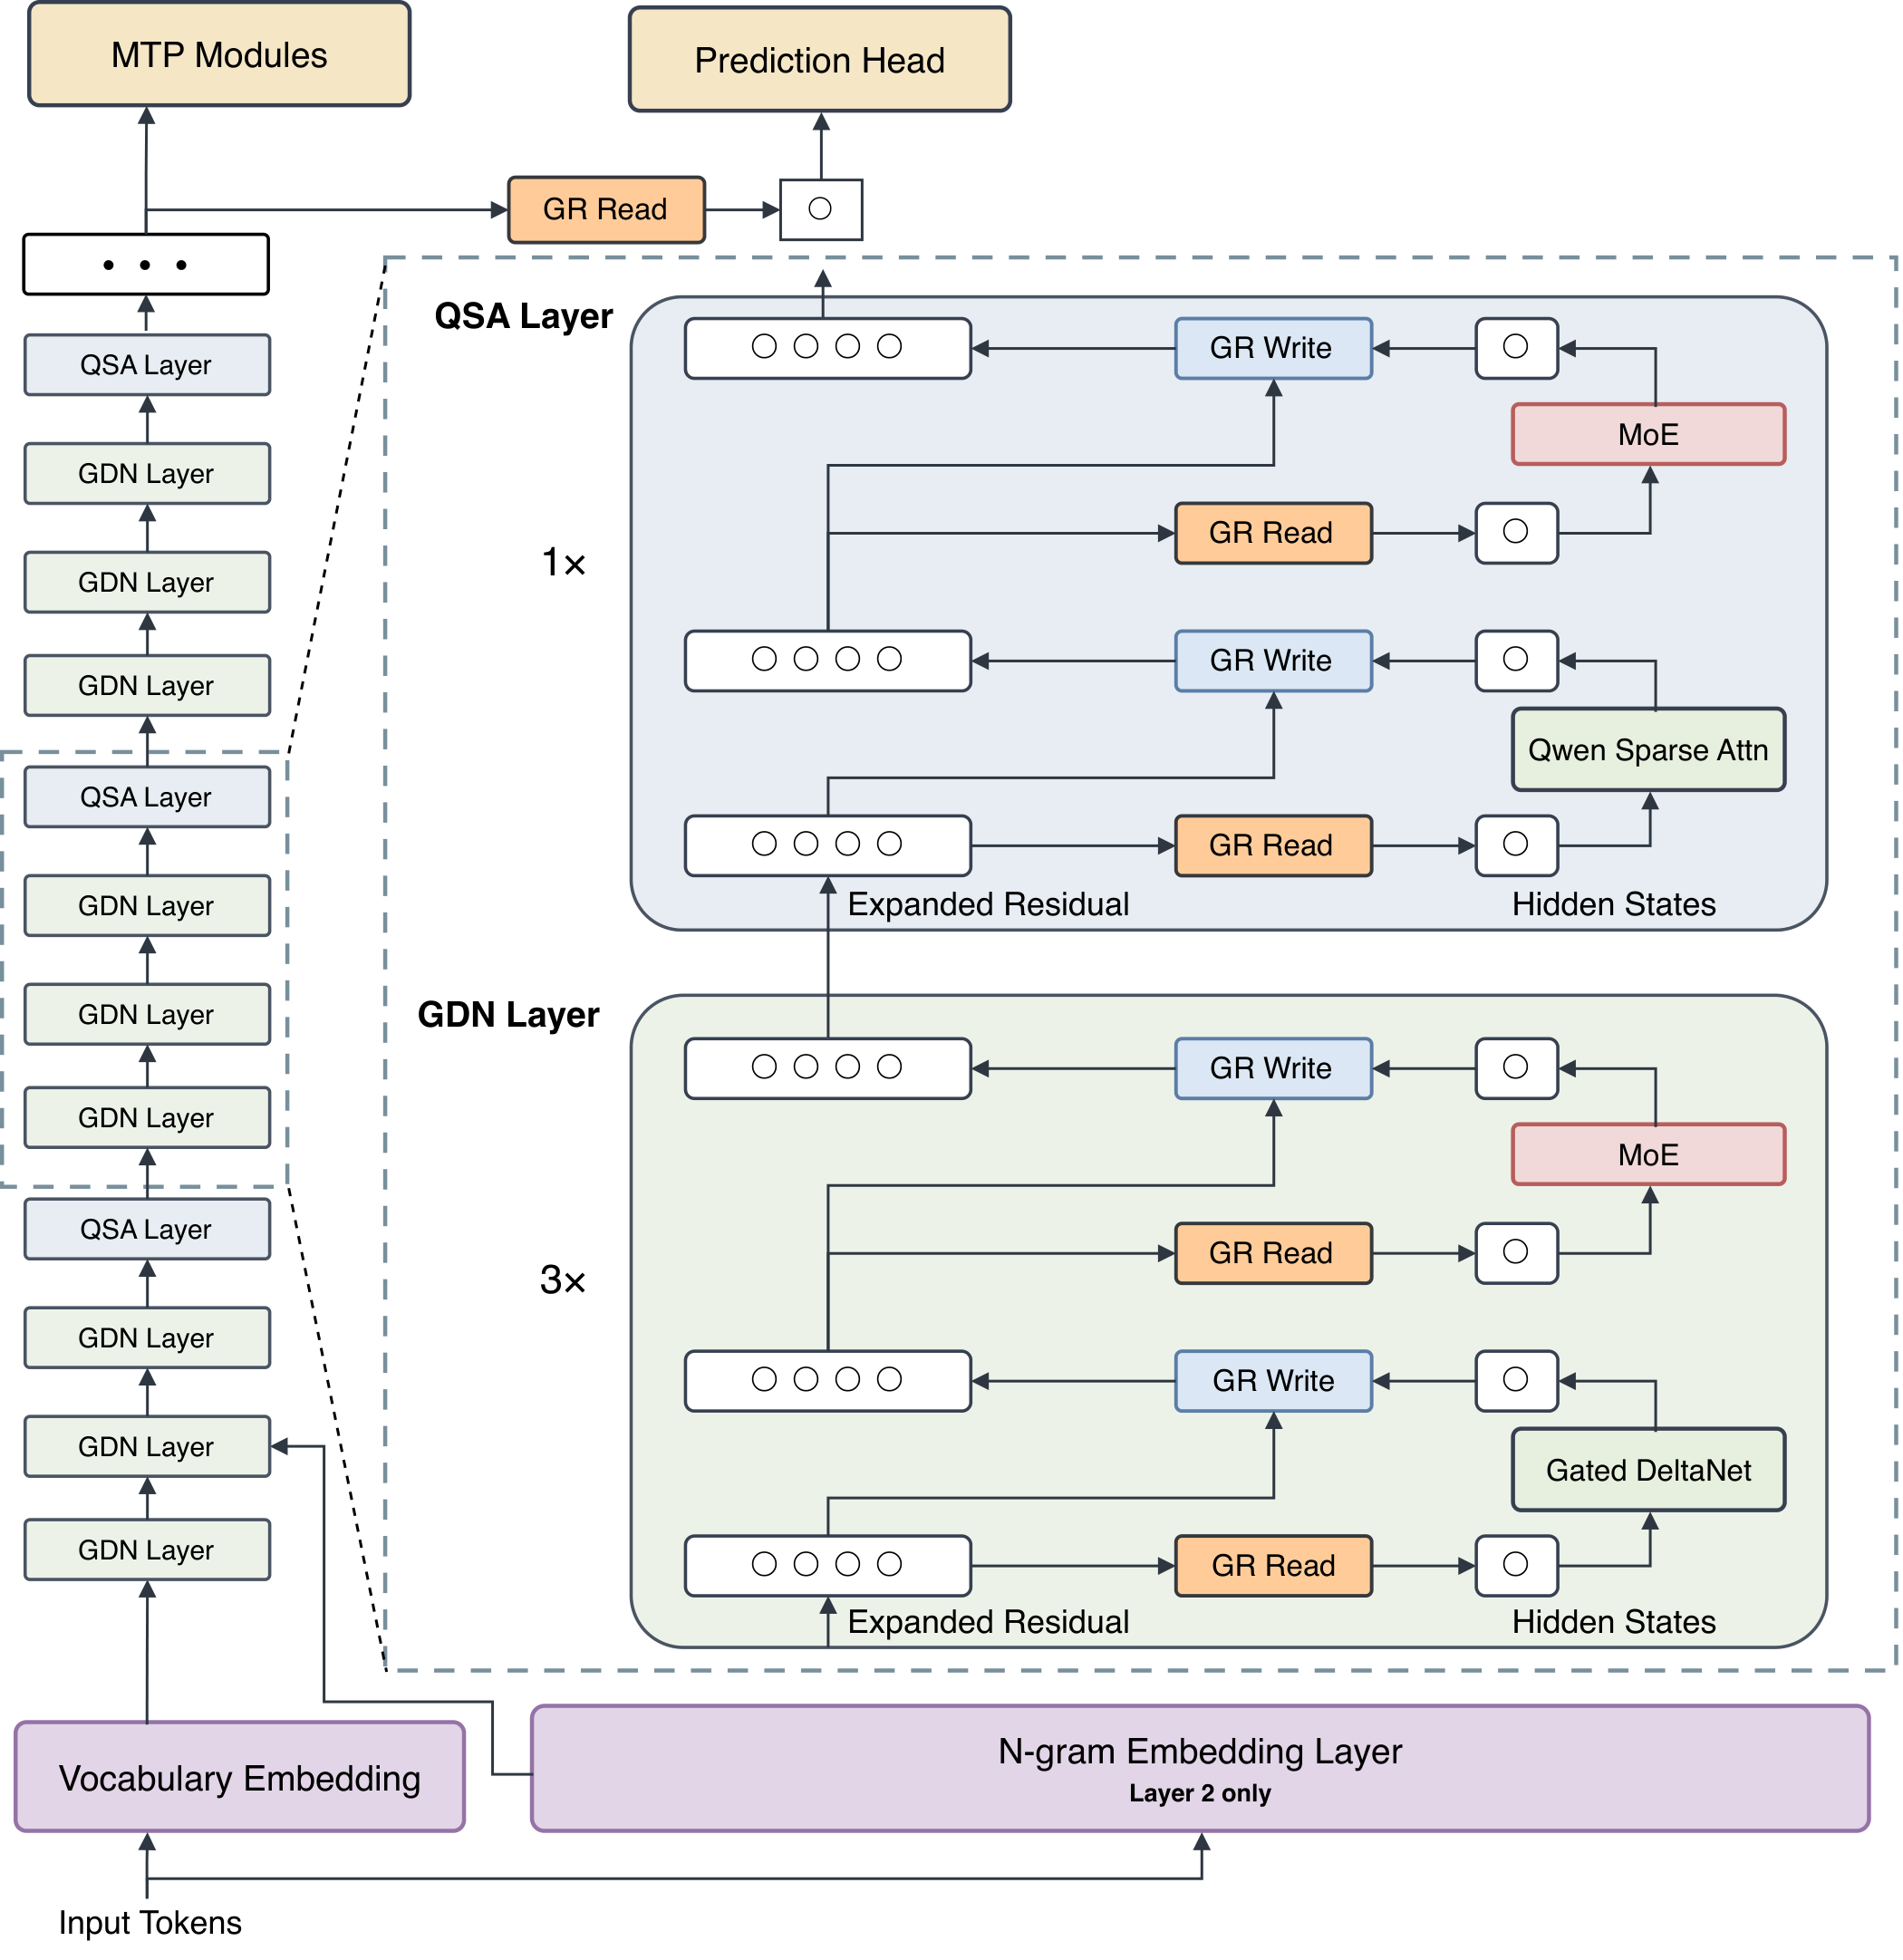
图:Qwen4-Max 架构。看每层 QSA 之前的三层 Gated DeltaNet,历史被压成固定大小状态,这是长会话注意力成本能压下来的结构基础。来源:Qwen 官方博客
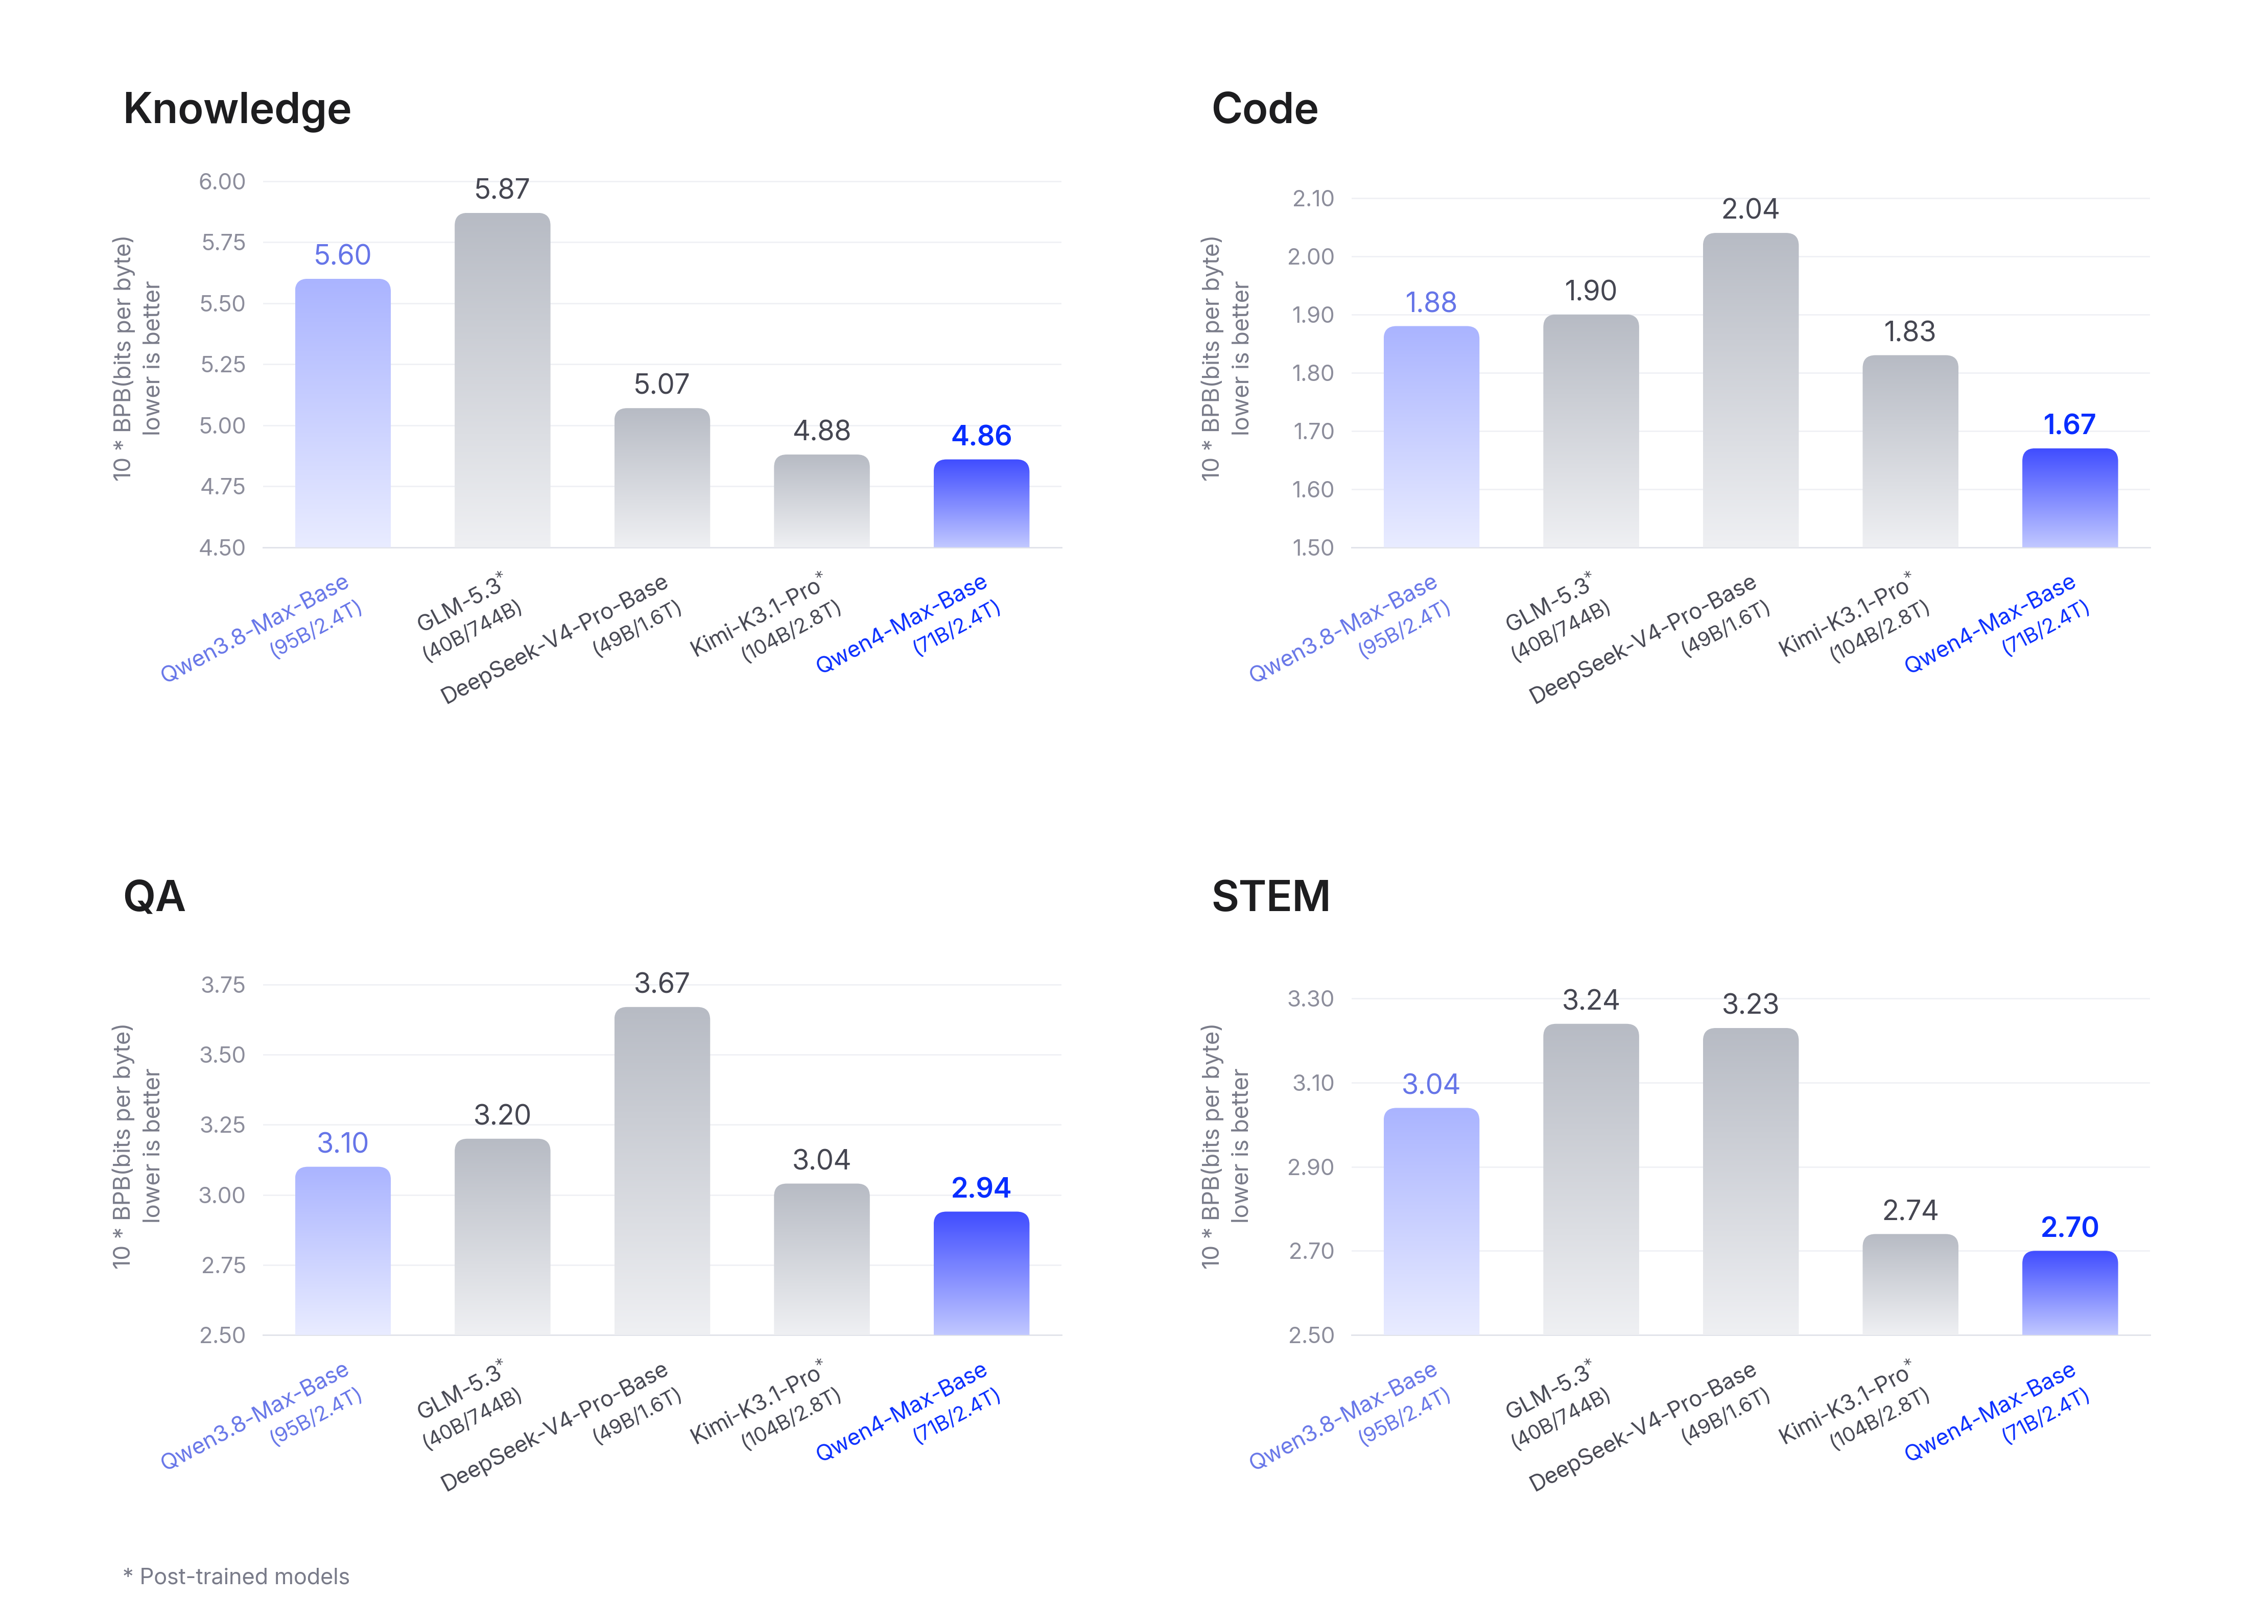
图:预训练评测采用 10 × BPB(越低越好),Qwen4-Max-Base 在四域均为五组 checkpoint 中最低,且激活参数比上一代少 25%。来源:Qwen 官方博客
上下文 1M tokens(标准输入上限 991K),输出上限 393,216 tokens 含思维链,思考档位 none 到 xhigh 五档。输出上限逼近 40 万 token,够一次 agent run 完成整段思考加整套产出;五档档位是留给成本控制的旋钮,同一能力,账单按场景调。
48 小时无人干预,跑完一个实验室课题
接入 Deep Principle 的 Mira 干湿实验室平台后,模型连续 48 小时无人干预跑完一条材料发现线。候选空间 270 万个分子:先结构筛选、性质预测、第一性原理计算、逆合成分析与实验规划,再指挥自动化湿实验室完成试剂配制、合成、分离纯化与测试,四轮「设计→合成→测试→主动学习」循环后拿到一个经实验验证的新冷却液分子,目标场景是下一代高功耗芯片的数据中心散热。
这类任务的反馈周期以天计、奖励信号稀疏,过去没法交给自动化系统,卡住的是两个前提:模型撑不住长程一致性,单次试错又太贵。后一个前提正是 1.67 美元在解的题。
云调度案例的数字来自阿里云真实业务:数据标注的模型调用调度成本平均降 10.42%,在线 GPU 分配的整机空闲容量时长提升 4.62%,离线 CPU 重调度达到最优目标的求解速度提升超过 14.61 倍。10.42% 和 4.62% 看着不大,但它们出自真业务账本,模型在优化训练它自己的那套系统,省下的钱直接回到阿里的报表。14.61 倍的求解加速符合预期,写约束、调求解器本来就是 LLM 的舒适区。
药物发现的试错密度更高:在 DP Technology 的 PharmMaster 平台上针对阿尔茨海默病相关的 NLRP3 炎症小体做端到端研究,454 次工具调用、3,239 次计算指标评估、24 个候选分子,优选分子的相对结合自由能(RBFE)估算约为参考分子的 3.6 倍,被认为值得进入湿实验验证。454 个决策点的试错放在旧成本结构下,这条研究线的预算在立项阶段就批不下来。
发布材料里还有一串行业交付:SANF 与 Pacific Union 真实产线上,单件工件编程的人工工时从近 8 小时降到 24 分钟,降幅约 95%;198 份命名混乱的法律底稿被归入 14 个文件夹,产出 86 页、覆盖 12 个审查领域的报告,每条结论可回溯到具体底稿;重症医学一份病例含 1,433 张原始影像与上万字病程记录,单次对话完成从抽取到决策支持的全流程。共同点是验收标准清楚,报告、能跑的程序、产线代码,交付物可检验,agent 才有资格进生产流程。
榜单第一是官方数据,价格表不是
DataLearner 收录的位次里,Qwen4-Max 在 Agents’ Last Exam v1.1(46.70,第 1/26)、BioMysteryBench(85,第 1/26)、AutomationBench-AA(72.50,第 1/4)、Code Arena WebDev(1750,第 1/4)等榜单排第一,数据来源基本是官方博客发布的图表,Artificial Analysis、LMArena 等第三方独立榜单尚未收录。Work360 是阿里自研框架,案例视频全部出自厂商。自家基准加官方图表位次,这套证据链要打折看。
价格不用打折。国内站输入 10 元、输出 30 元每百万 token,国际站输入 1.5 美元、输出 4.5 美元,缓存命中 0.075 美元,价目表写在平台上,是合同事实,没有评测方法学的争议空间。
竞争边界也要认:复杂终端工程与黑盒复现场景,Kimi K3.1 与 Opus 5.5 仍保持显著得分优势,Qwen4-Max 在 Terminal-Bench 4.0 拿 48.48 分排第 13/58,Vibe Code Bench v1.1 排第 15/120。它的性价比优势集中在高缓存复用、长上下文多模态办公、法律与生信 agent 这些场景,终端的硬骨头还没啃下来。
社区当天最热的讨论在跑「鹈鹕骑自行车」绘图测试,Simon Willison 按 none/low/high/xhigh 四档各跑了一遍,有评论质疑这类测试早已进了训练集。新模型发布当天,手里能用的独立信号几乎为零,这是评测体系的普遍困境,Qwen4-Max 只是最新一个样本。
旗舰闭源,开源要等小尺寸
Qwen4-Max 不开放权重,只提供闭源 API 与平台服务,接口兼容 OpenAI 与 Anthropic 两种格式。官方表示 Qwen4 系列小尺寸模型将用同一套技术训练、陆续开源,但没有承诺开源 Max 旗舰;需要私有化部署的,这一代还得继续用 Qwen3.8-Max 的已开源权重。闭源旗舰保商业收入,开源小尺寸养生态,这套组合阿里已经用熟了。
安全编码是容易被忽略的一条:Last Secure Code Bench 上,功能与安全同时通过的功能级比例从 22.0% 升到 31.8%;函数、文件、仓库三个粒度同时安全生成的比例从 8% 升到 14.7%,接近翻倍。绝对值仍然不高,三粒度同时安全生成不到 15%,agent 写安全敏感代码时人审环节一行都省不掉。但 8% 到 14.7% 的斜率方向是对的,官方还把进攻性网络安全数据移出了训练集,只保留防御性任务。
回过头看,这次发布被拨动的开关是成本曲线:1.67 美元落在企业愿意为单次任务试错的价格区间里,4.43 美元落不在。榜单分数可以质疑其来自官方图表,案例视频可以怀疑是摆拍,价目表上的数字没有争议空间。Qwen4-Max 在终端工程上还没赢 Kimi K3.1 和 Opus 5.5,它赢的是让长程 agent 第一次能按生产预算排期、进日常流程——下一代旗舰发布,参数规模大概还会排在第二行,成本曲线已经接过了那个位置。
参考链接:
- Qwen 官方博客:Qwen4-Max 发布公告
- DataLearner 模型榜单收录页
- Simon Willison:四档思考模式绘图测试记录