2026년 11월 16일, 알리바바 통의천문 팀이 네 번째 플래그십 클로즈드소스 모델 Qwen4-Max를 공개했다. 총 2.4조 파라미터의 희소 MoE(Mixture of Experts), 토큰당 71B 활성화, 네이티브 비전, 1M 컨텍스트가 특징이다. 공식 내러티브의 무게중심이 옮겨갔다. 벤치마크 점수 대신 Work360에서 나온 비용 숫자가 주인공이 됐고, 태스크당 평균 비용은 4.43달러에서 1.67달러로 62% 낮아졌다.
한 번 실행에 4.43달러 드는 에이전트는 데모 영상 속에만 머물 수 있다. 1.67달러로 내려와야 일상적인 생산 파이프라인에 스케줄될 자격이 생긴다. Qwen4-Max가 이번 공개로 한 일이 바로 그것이다. 플래그십 경쟁의 초점을 “얼마나 잘 대답하는가”에서 “얼마나 완전하게 산출하는가”로 옮긴 것.
태스크당 비용 4.43달러 → 1.67달러, 62% 절감
Work360은 알리바바가 자체 개발한 오피스 태스크 평가 프레임워크로, 26개 대분류 도메인, 182개 중분류 하위 도메인, 721개 세부 영역을 커버한다. Qwen4-Max는 여기서 52.69점을 받았고, 전 세대 Qwen3.8-Max는 47.74점이었다. 5점 상승, 비용은 62% 감소다. 5점 상승은 능력의 한 걸음 전진이지만, 62% 감소는 다른 이야기다. 토큰 사용량이 내려간 것이다.
Xhigh와 High 두 사고 레벨의 Work360 토큰 사용량은 각각 약 24%와 35% 감소했고, Terminal-Bench 4.0에서는 약 48%와 49% 감소했다. 장기 실행 에이전트 청구서의 대부분은 사고 토큰이 차지하고, API 단가는 차지하는 비중이 작다. 국내 API 가격은 백만 토큰당 12/36위안에서 10/30위안으로 16.7%만 내렸다. 캐시 히트 가격은 0.5위안/M으로 약 66.7% 내렸고, 글로벌 QwenCloud 캐시 히트는 0.075달러/M으로 입력가의 약 20분의 1이다. 에이전트 세션은 도구 호출을 수십 라운드씩 반복하므로, 캐시 히트율이야말로 장기 세션 청구서를 결정하는 변수다.
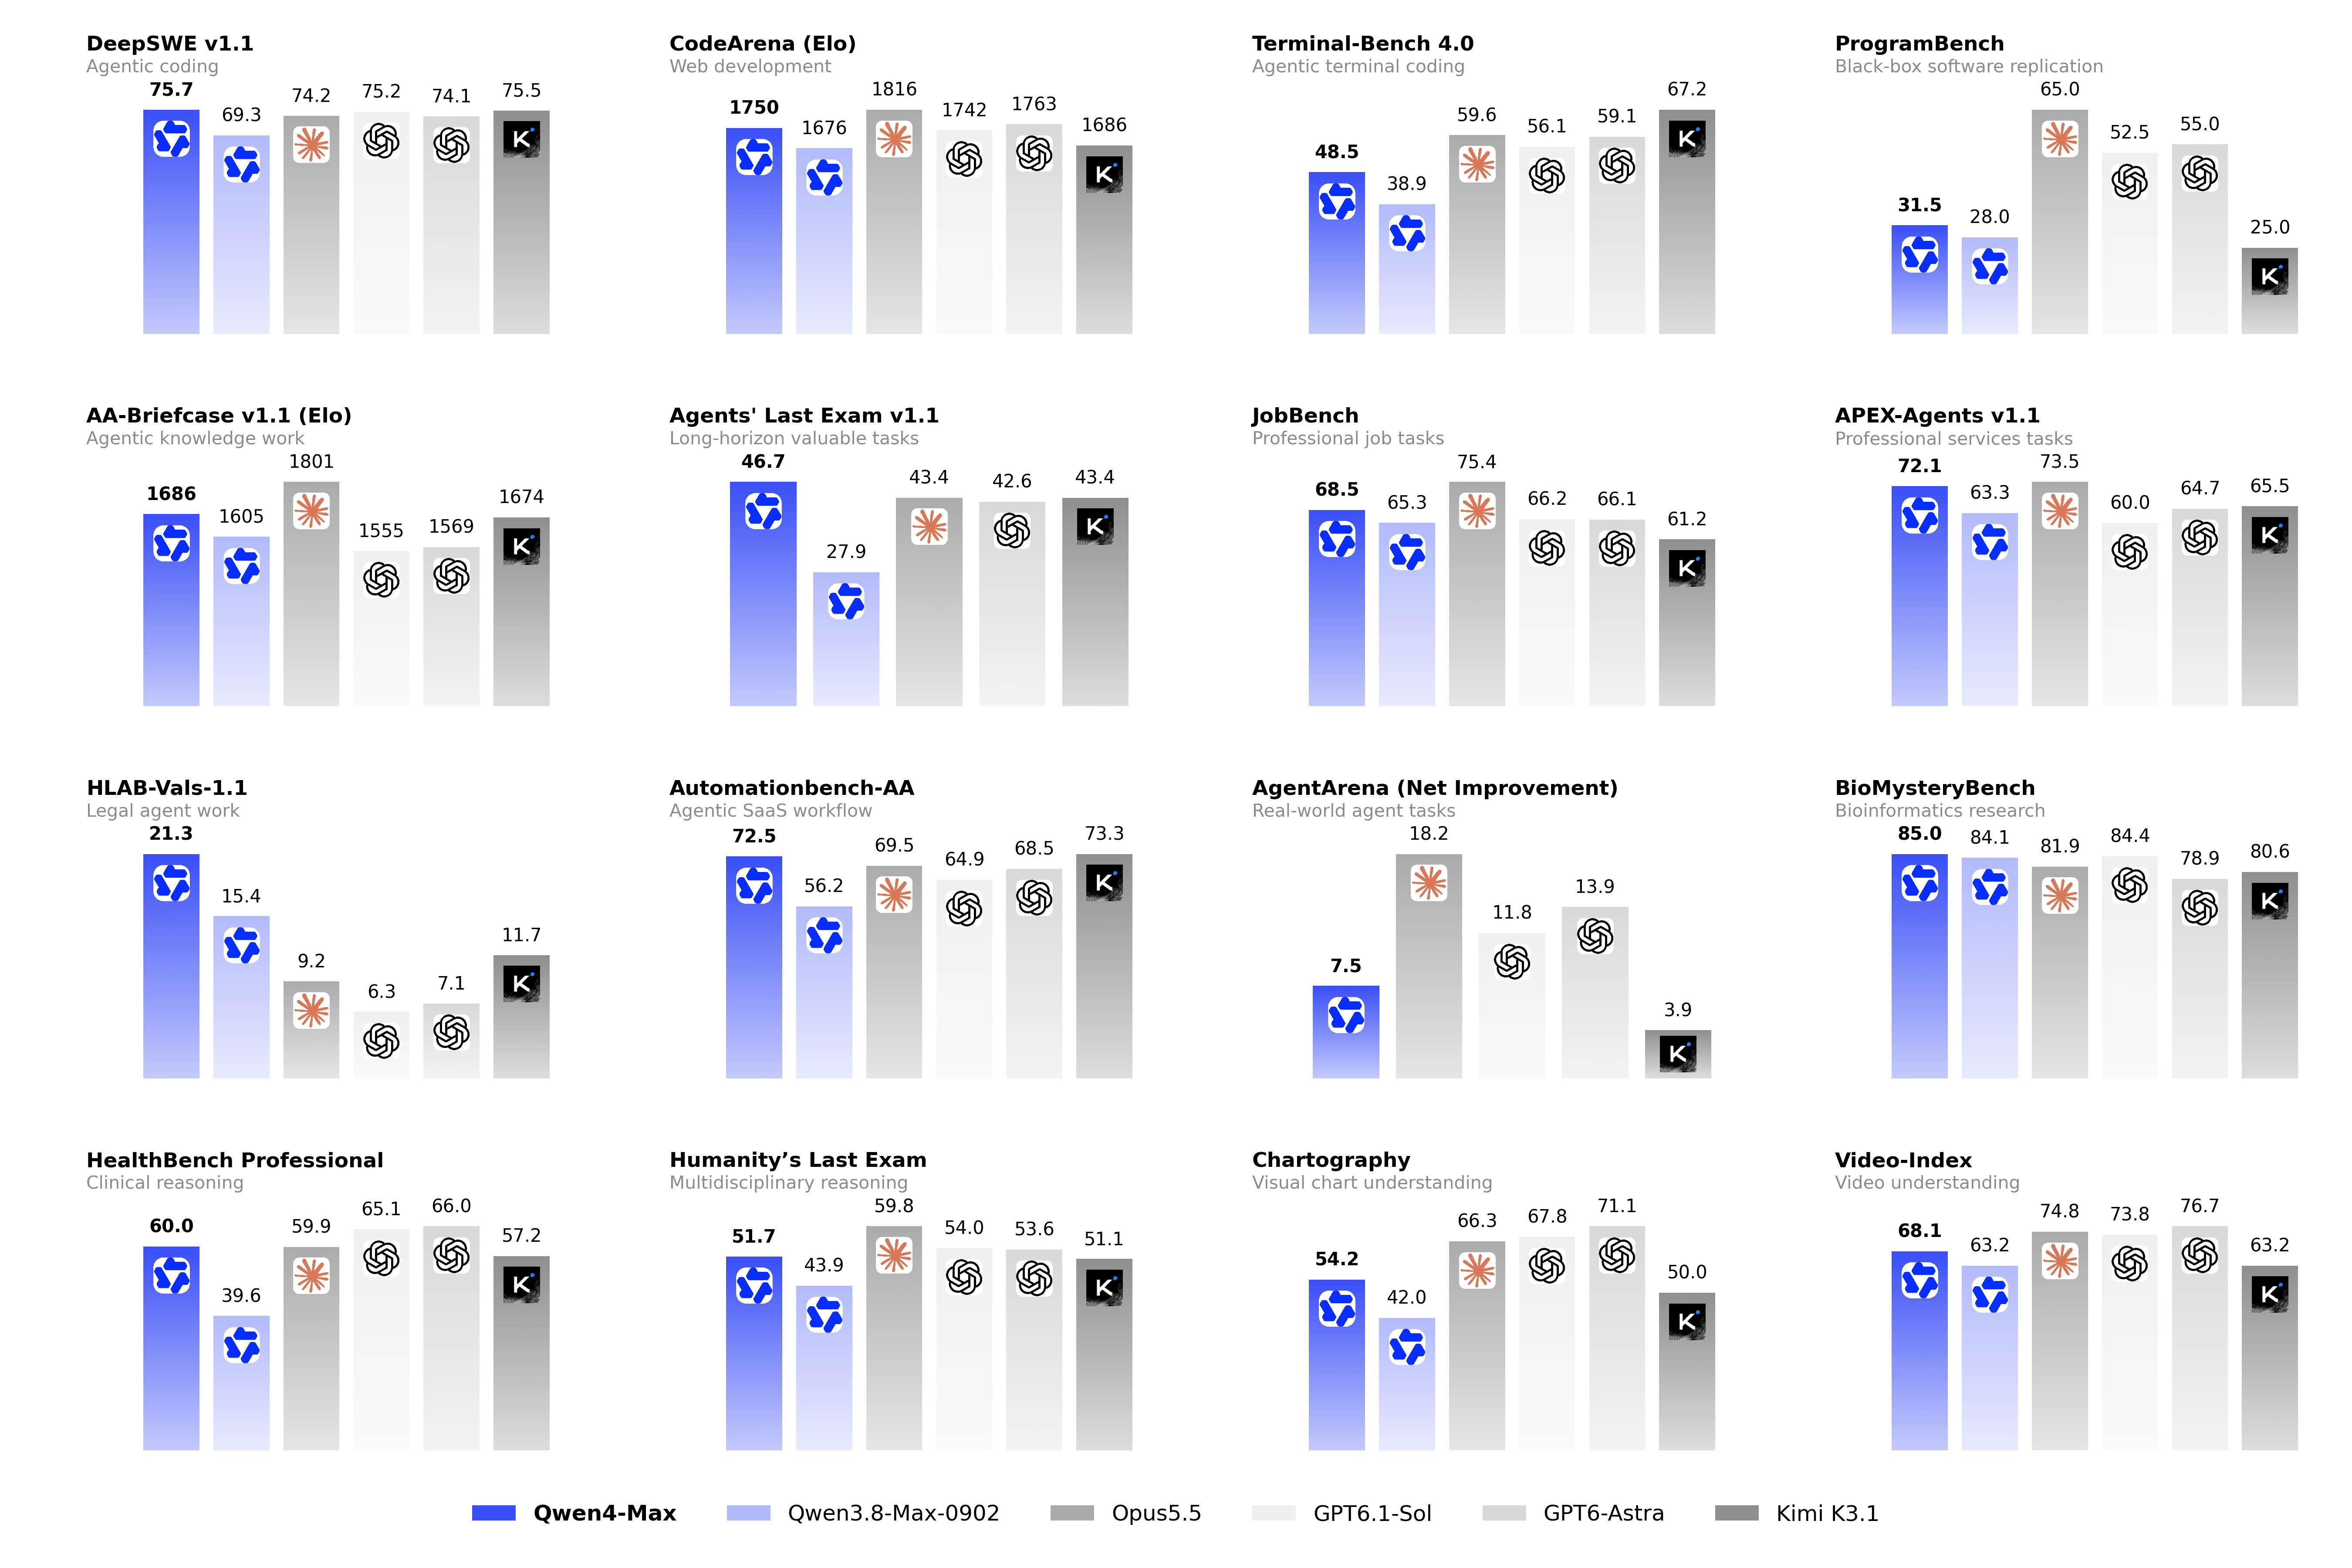
그림: 공식 종합 성능 비교. Qwen4-Max를 전 세대 Qwen3.8-Max와 코딩·오피스·장기 태스크 세 가지 시나리오에서 비교했다. 비교 대상이 자사 전 세대이고, 제3자 독립 평가는 아직 뒤따르지 않았다. 출처: Qwen 공식 블로그
2.4조 파라미터에 71B 활성화, 아키텍처 변경의 목표는 청구서
총 파라미터 2.4조, 토큰당 활성화 71B, 그리고 별도의 328B N-gram Embedding 파라미터. 이런 파라미터는 모델 용량을 늘리면서도 연산량을 거의 늘리지 않는다. 세 가지 아키텍처 변경은 각자 역할이 있다. GDN(Gated DeltaNet)과 Qwen Sparse Attention(QSA)은 장기 컨텍스트 비용을 담당하고, Gated Residual은 학습 안정성을, N-gram Embedding은 국소 토큰 패턴 표현을 담당한다.
QSA의 방식은 먼저 각 레이어에서 세 개의 Gated DeltaNet 레이어로 히스토리를 고정 크기 상태로 압축한 뒤, 가벼운 indexer가 micro-block 단위로 관련 컨텍스트를 골라내는 것이다. 긴 시퀀스의 attention 비용과 인덱싱 비용이 동시에 줄어든다. Gated Residual은 동적 읽기·쓰기 게이트로 네 개의 병렬 잔차 브랜치 간 레이어 정보 흐름을 제어하고, 이득은 학습 안정성에 떨어진다. 증거는 직접적이다. 2.4조 규모 사전학습 전체 과정에서 loss가 매끄럽게 하강했고 스파이크(spike)가 없었다. 이 체급에서 전 과정 무 스파이크는 조 단위 학습에서 흔치 않다.
Base 수준의 계산도 맞아떨어진다. 자체 4도메인 평가(Knowledge / Code / QA / STEM, 10 × BPB, 낮을수록 좋음)에서 Qwen4-Max-Base의 BPB는 전 세대보다 약 5–13% 낮았고, 활성화 파라미터는 25% 더 적었다. 희소도를 높이면서 능력을 트레이드오프하지 않았다는 뜻이다. 비교 항목의 GLM-5.3과 Kimi-K3.1-Pro는 post-trained checkpoint로, 공식 스스로 비교 가능성이 제한된다고 명시했다. 이 숫자들은 우선 공식 일방 발표로만 받아둘 필요가 있다.
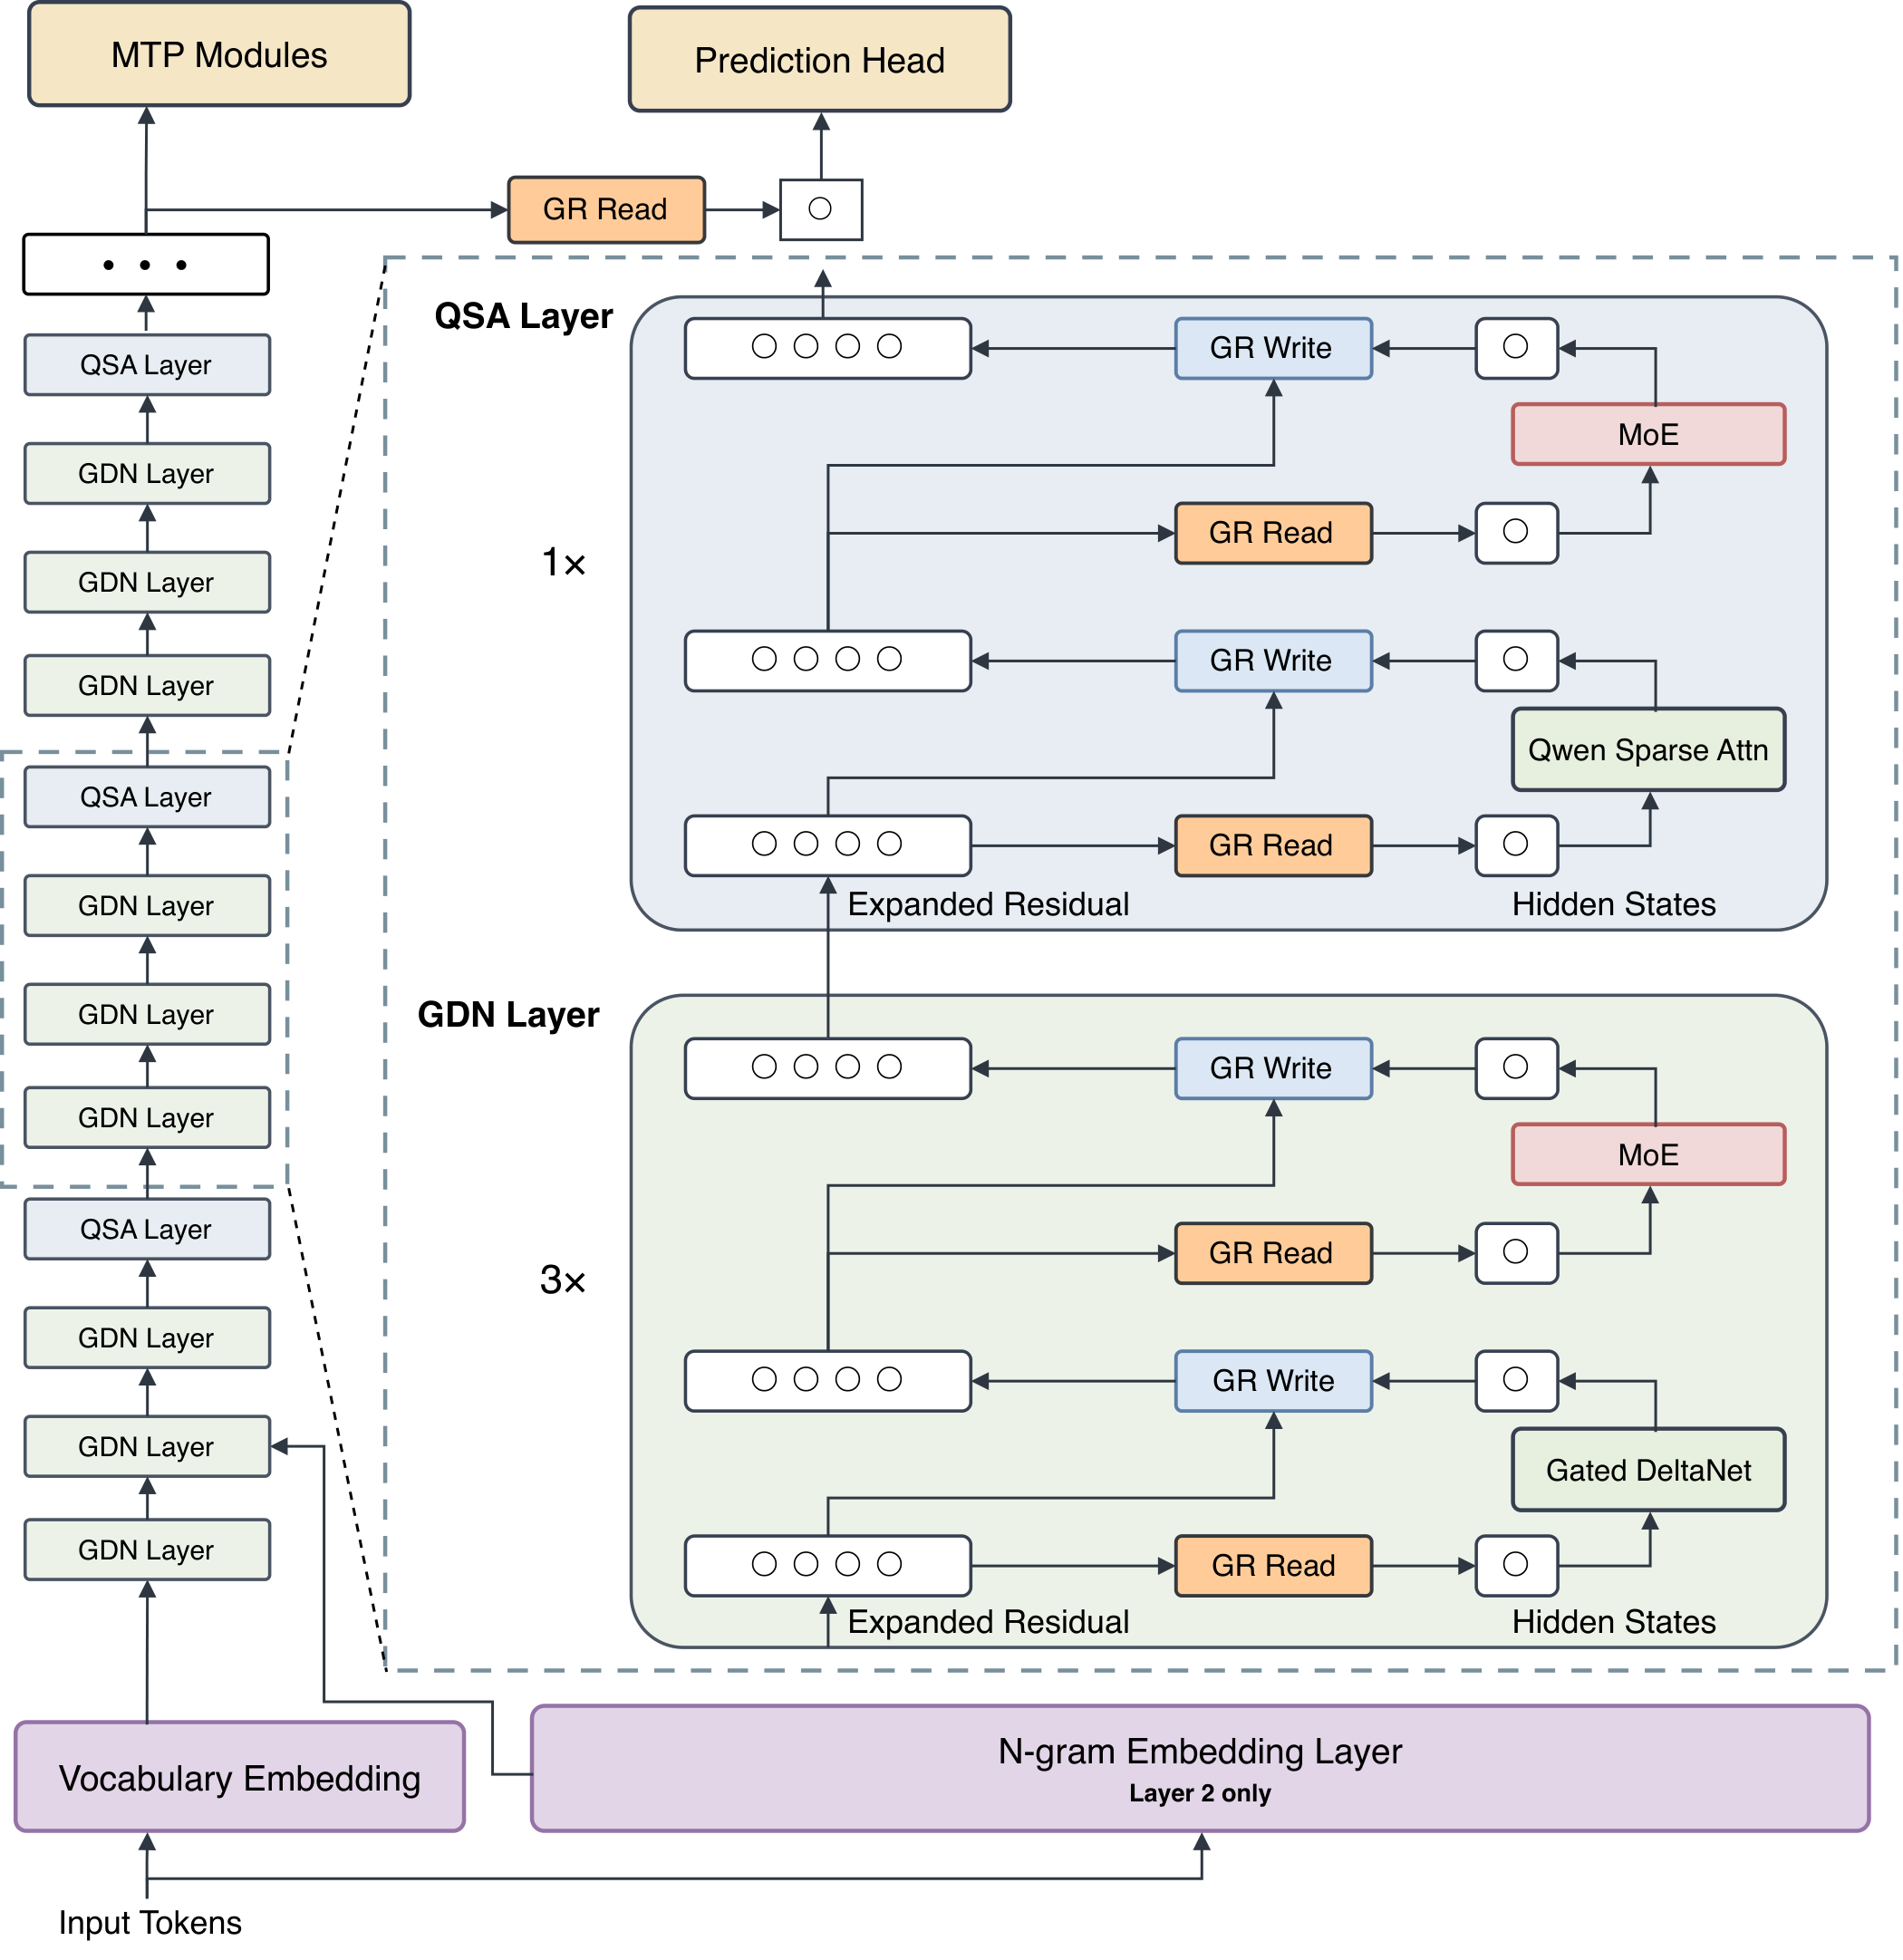
그림: Qwen4-Max 아키텍처. 각 레이어의 QSA 앞에 놓인 세 개의 Gated DeltaNet 레이어가 히스토리를 고정 크기 상태로 압축한다. 장기 세션 attention 비용을 줄일 수 있는 구조적 기반이 바로 여기다. 출처: Qwen 공식 블로그
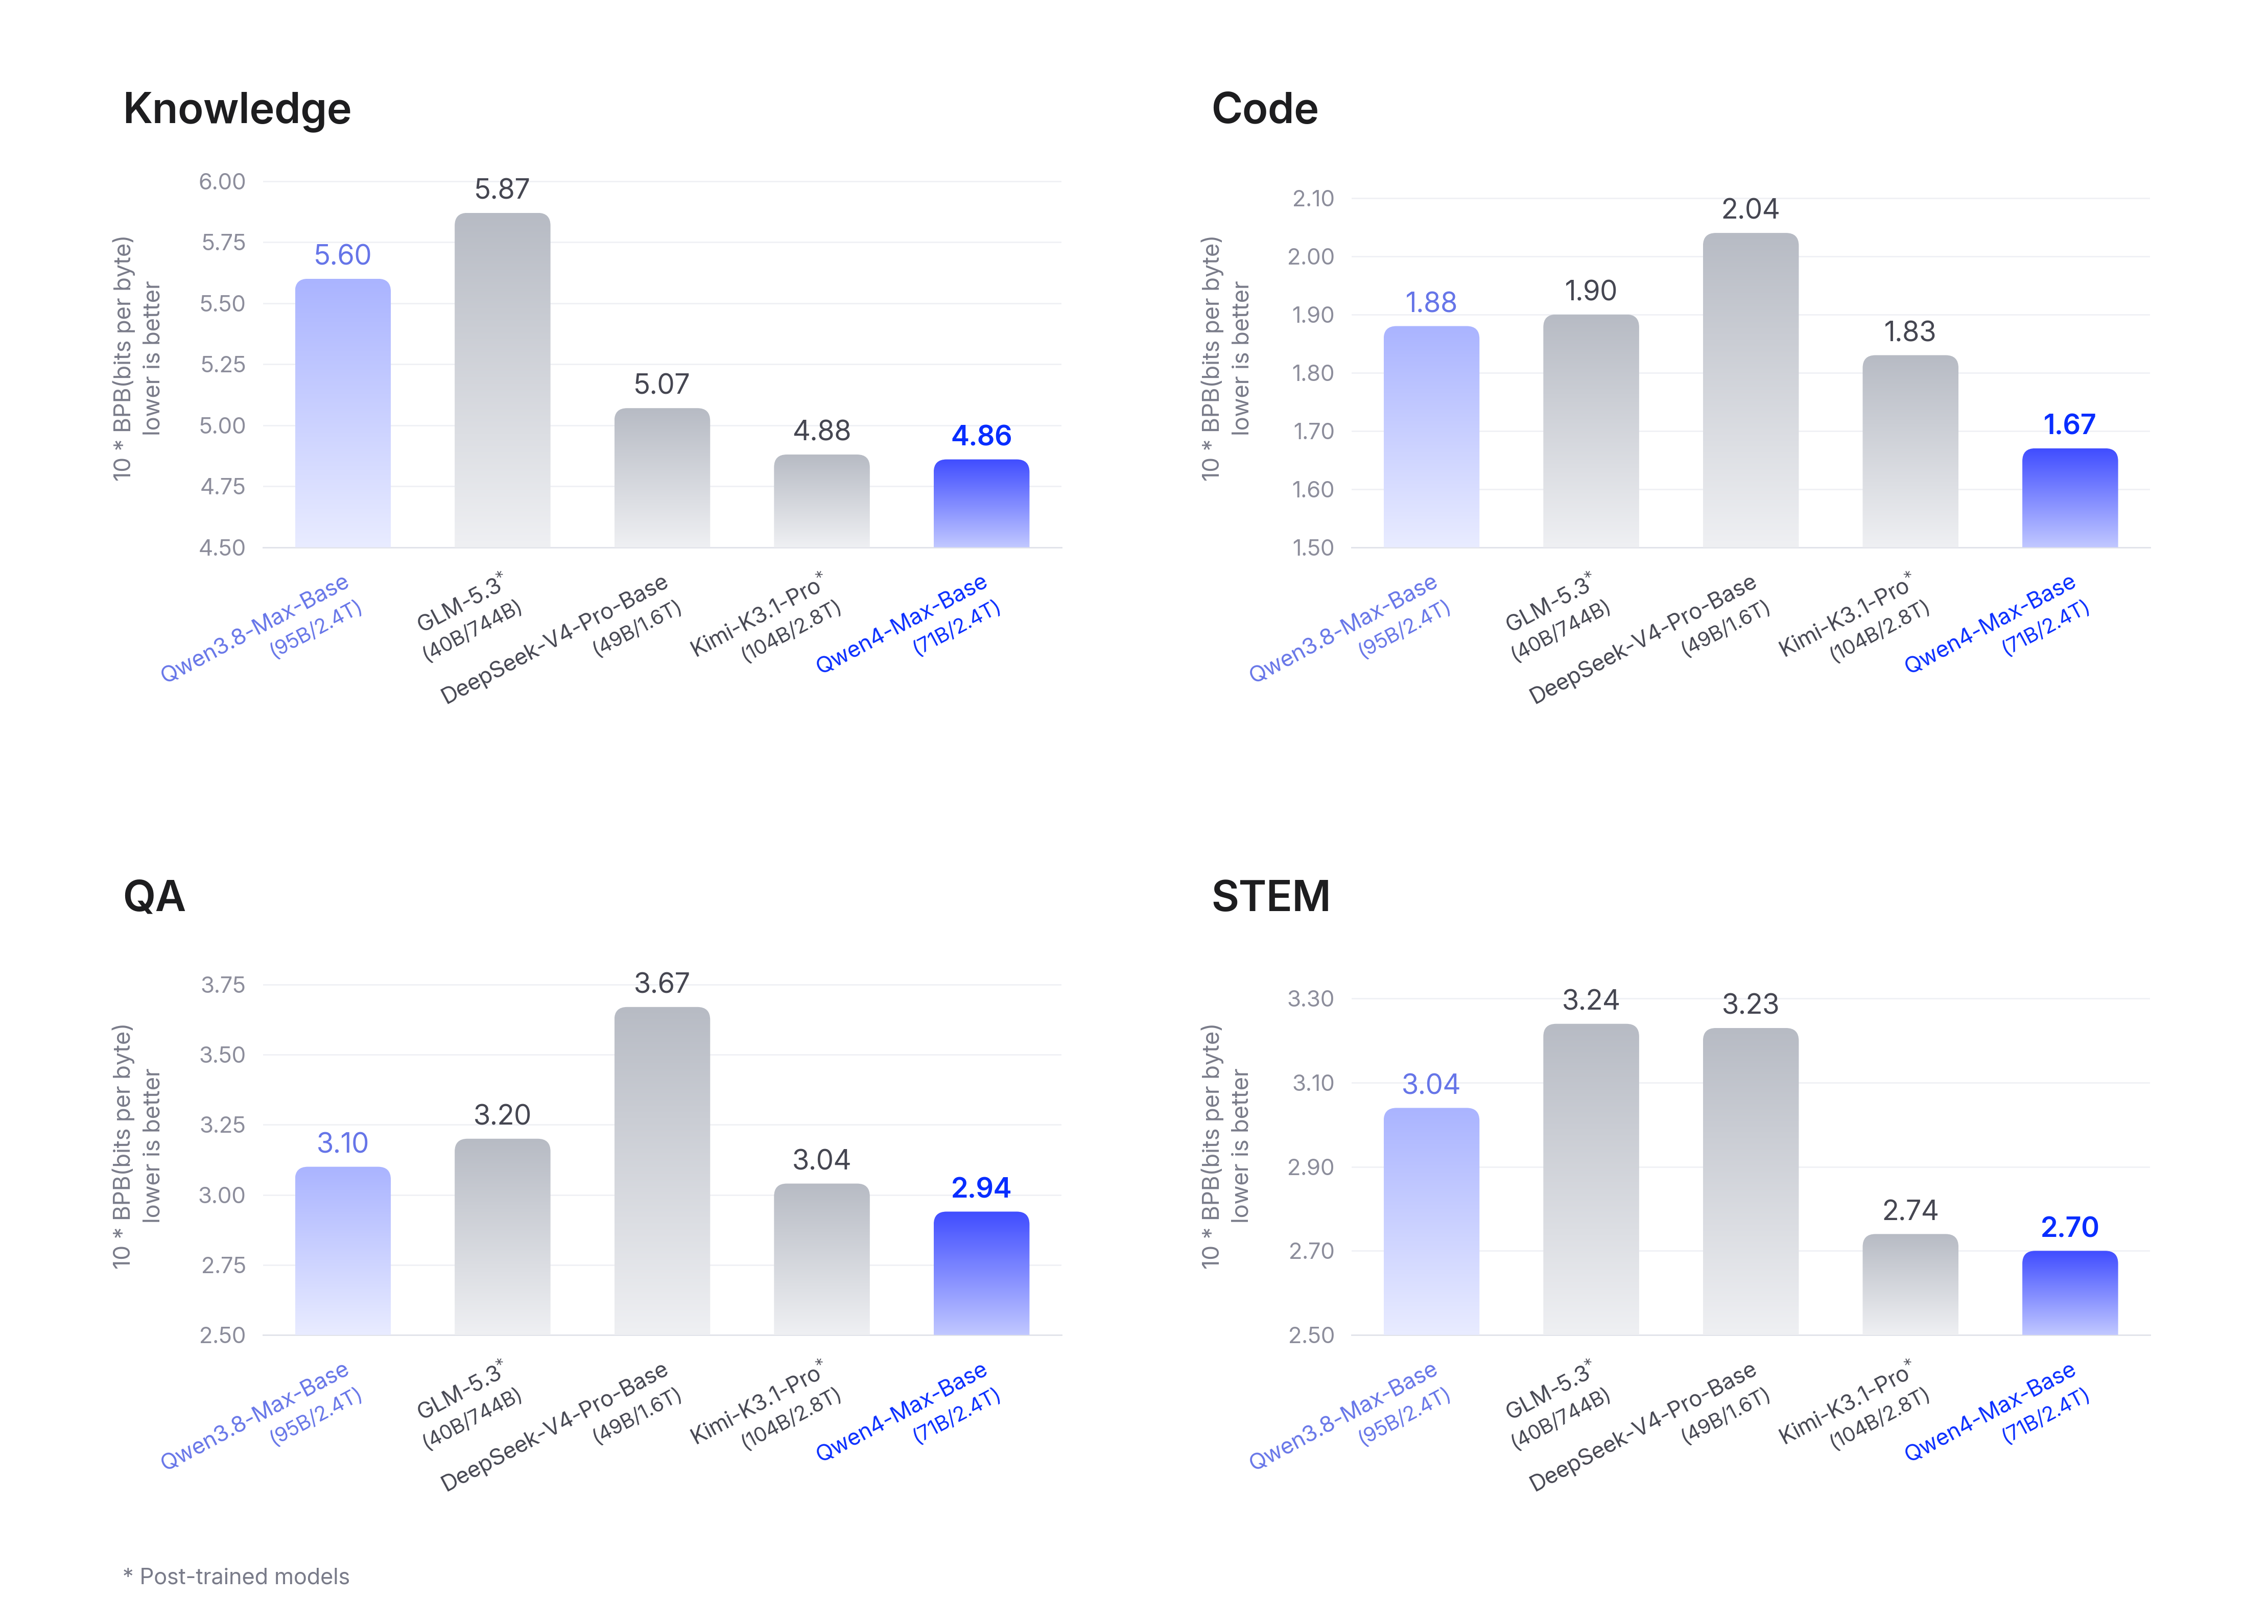
그림: 사전학습 평가는 10 × BPB(낮을수록 좋음)를 사용했다. Qwen4-Max-Base는 네 도메인 모두에서 다섯 개 checkpoint 중 최저치였고, 활성화 파라미터는 전 세대보다 25% 적다. 출처: Qwen 공식 블로그
컨텍스트는 1M 토큰(표준 입력 상한 991K), 출력 상한은 사고 과정을 포함해 393,216 토큰, 사고 레벨은 none부터 xhigh까지 다섯 단계다. 출력 상한이 40만 토큰에 육박하면 한 번의 agent run이 긴 사고 전체와 완성된 산출물까지 담을 수 있다. 다섯 단계 레벨은 비용 관리를 위한 다이얼이고, 같은 능력을 시나리오에 따라 청구서로 조절하는 셈이다.
48시간 무인 운영, 한 건의 연구 주제를 끝내다
Deep Principle의 Mira 건습(dry-wet) 실험실 플랫폼에 연결되자, 모델은 48시간 동안 무인으로 재료 발견 파이프라인 하나를 완주했다. 후보 공간은 270만 개 분자. 구조 스크리닝, 특성 예측, 제1원리 계산, 역합성 분석과 실험 계획을 거친 뒤, 자동화 습식 실험실에 시약 조제·합성·분리 정제·테스트를 지시했다. “설계→합성→테스트→능동 학습” 사이클 네 번을 돌고 실험으로 검증된 신규 냉각 분자 하나를 얻었고, 목표 시나리오는 차세대 고전력 칩의 데이터센터 냉각이다.
이런 태스크는 피드백 주기가 ‘일’ 단위고 보상 신호가 희소해서, 예전에는 자동화 시스템에 맡길 수 없었다. 막혔던 전제는 두 개다. 모델이 장기 일관성을 버티지 못한다는 것, 그리고 한 번의 시행착오가 너무 비싸다는 것. 뒤의 전제가 바로 1.67달러가 풀고 있는 문제다.
클라우드 스케줄링 사례의 숫자는 알리바바 클라우드의 실제 비즈니스에서 왔다. 데이터 라벨링의 모델 호출 스케줄링 비용은 평균 10.42% 감소했고, 온라인 GPU 할당의 전체 장비 유휴 용량 시간은 4.62% 늘었으며, 오프라인 CPU 재스케줄링은 최적 목표 도달 속도가 14.61배 이상 빨라졌다. 10.42%와 4.62%는 작아 보이지만 진짜 비즈니스 장부에서 나온 숫자다. 모델이 자기 자신을 학습시키는 시스템을 최적화하고 있고, 절약된 비용은 곧바로 알리바바의 재무제표로 돌아간다. 14.61배의 솔버 가속은 예상 범위 안이다. 제약 조건을 쓰고 솔버를 튜닝하는 일은 원래 LLM의 편안한 영역이다.
약물 발견의 시행착오 밀도는 더 높다. DP Technology의 PharmMaster 플랫폼에서 알츠하이머병 관련 NLRP3 인플라마좀을 대상으로 엔드투엔드 연구를 수행했고, 454회 도구 호출, 3,239회 계산 지표 평가, 24개 후보 분자 끝에 선별된 분자의 상대 결합 자유 에너지(RBFE) 추정치가 참조 분자의 약 3.6배로, 습식 실험 검증에 들어갈 가치가 있다고 판단됐다. 454개 의사결정 지점의 시행착오를 옛 비용 구조로 하려면, 이 연구 라인은 예산 단계에서 승인이 안 됐을 것이다.
공개 자료에는 산업 현장의 산출물 목록도 이어진다. SANF와 Pacific Union의 실제 생산 라인에서 단일 부품 프로그래밍 인공 시간이 8시간 가까이에서 24분으로 줄어 약 95% 절감됐다. 이름이 뒤죽박죽인 198건의 법률 원고가 14개 폴더로 정리되고, 12개 검토 영역을 커버하는 86페이지 보고서가 나왔으며, 결론 하나하나가 특정 원고로 역추적 가능하다. 중환자의학의 한 케이스는 1,433장의 원본 영상과 수만 자 병정 기록을 담고 있었고, 단 한 번의 대화로 추출부터 의사결정 지원까지 전체 과정을 완수했다. 공통점은 인수 기준이 명확하다는 것이다. 보고서, 돌아가는 프로그램, 생산 라인 코드 — 산출물을 검증할 수 있어야 에이전트가 생산 프로세스에 들어갈 자격이 생긴다.
리더보드 1위는 공식 데이터, 가격표는 아니다
DataLearner가 수집한 순위에서 Qwen4-Max는 Agents’ Last Exam v1.1(46.70, 1/26), BioMysteryBench(85, 1/26), AutomationBench-AA(72.50, 1/4), Code Arena WebDev(1750, 1/4) 등에서 1위를 기록했다. 데이터 출처는 대부분 공식 블로그가 배포한 차트이고, Artificial Analysis, LMArena 같은 제3자 독립 리더보드에는 아직 수록되지 않았다. Work360은 알리바바 자체 개발 프레임워크이고, 사례 영상은 전부 벤더 측에서 나왔다. 자사 벤치마크에 공식 차트 순위까지, 이 증거 사슬은 할인해서 봐야 한다.
가격에는 할인할 여지가 없다. 국내 사이트 입력 10위안·출력 30위안(백만 토큰당), 글로벌 사이트 입력 1.5달러·출력 4.5달러, 캐시 히트 0.075달러. 가격표는 플랫폼에 그대로 공개되어 있고, 계약 사실이므로 평가 방법론 논쟁의 여지가 없다.
경쟁 경계도 인정해야 한다. 복잡한 터미널 엔지니어링과 블랙박스 재현 시나리오에서 Kimi K3.1과 Opus 5.5는 여전히 뚜렷한 점수 우위를 유지한다. Qwen4-Max는 Terminal-Bench 4.0에서 48.48점으로 13/58, Vibe Code Bench v1.1에서 15/120에 그쳤다. 가성비 우위는 캐시 재사용이 높은 시나리오, 장기 컨텍스트 멀티모달 오피스, 법률·바이오인포매틱스 에이전트에 집중되어 있고, 터미널의 딱딱한 뼈는 아직 씹어내지 못했다.
커뮤니티 당일 가장 뜨거운 논의는 “펠리컨 자전거 타기” 그림 테스트였다. Simon Willison이 none/low/high/xhigh 네 레벨로 각각 돌려 봤고, 이런 테스트는 이미 학습 세트에 들어갔다는 지적하는 댓글도 나왔다. 신모델 공개 당일 손에 쥘 수 있는 독립 신호는 거의 0이다. 평가 체계의 보편적 딜레마이고, Qwen4-Max는 그저 최신 샘플일 뿐이다.
플래그십은 클로즈드, 오픈소스는 소형을 기다려야
Qwen4-Max는 가중치를 공개하지 않고 클로즈드 API와 플랫폼 서비스만 제공하며, 인터페이스는 OpenAI와 Anthropic 두 포맷을 모두 지원한다. 공식 발표에 따르면 Qwen4 시리즈 소형 모델은 같은 기술로 학습되어 순차적으로 오픈소스화되지만, Max 플래그십의 오픈소스화는 약속하지 않았다. 프라이빗 배포가 필요하다면 이 세대에서도 여전히 Qwen3.8-Max의 공개 가중치를 써야 한다. 클로즈드 플래그십으로 상업 수익을 확보하고, 오픈소스 소형으로 생태계를 키우는 조합 — 알리바바는 이미 이 공식을 능숙하게 쓰고 있다.
보안 코딩은 놓치기 쉬운 항목이다. Last Secure Code Bench에서 기능과 보안을 동시에 통과하는 기능 수준 비율이 22.0%에서 31.8%로 올라갔다. 함수·파일·리포지토리 세 가지 그래뉼러리티에서 동시에 안전하게 생성된 비율은 8%에서 14.7%로, 거의 두 배가 됐다. 절대값은 여전히 낮다. 세 그래뉼러리티 동시 안전 생성이 15%에 못 미치므로, 에이전트가 보안 민감 코드를 쓸 때 사람 검토 단계는 한 줄도 줄일 수 없다. 그래도 8%에서 14.7%로 가는 기울기의 방향은 맞고, 공식은 공격적 사이버보안 데이터를 학습 세트에서 제외하고 방어적 태스크만 남겼다.
돌이켜보면 이번 공개에서 건드린 스위치는 비용 곡선이다. 1.67달러는 기업이 단일 태스크 시행착오에 지불할 의사가 있는 가격 구간 안에 떨어지고, 4.43달러는 그렇지 않다. 리더보드 점수가 공식 차트에서 나왔는지 의심할 수 있고, 사례 영상이 연출인지 의심할 수 있지만, 가격표의 숫자에는 논쟁 여지가 없다. Qwen4-Max는 터미널 엔지니어링에서 아직 Kimi K3.1과 Opus 5.5에 이기지 못했다. 그것이 이긴 것은 장기 실행 에이전트가 처음으로 생산 예산으로 스케줄되고 일상 프로세스에 들어갈 수 있게 만든 것이다. 다음 플래그십 공개에서는 파라미터 규모가 아마 둘째 줄로 밀려나고, 비용 곡선이 이미 그 자리를 물려받았다.
참고 링크:
- Qwen 공식 블로그: Qwen4-Max 공지
- DataLearner 모델 리더보드 수록 페이지
- Simon Willison: 네 가지 사고 모드 그림 테스트 기록