2026年11月16日、アリババの通義千問(Qwen)チームは第4世代フラッグシップのクローズドソースモデル Qwen4-Max を発表した。総パラメータ2.4兆のスパースMoE(Mixture of Experts)で、1トークンあたり71Bをアクティベート、ネイティブの視覚入力と1Mコンテキストに対応する。注目すべきは公式の語りの重心の移動だ。場を支えるのがベンチマークのスコアから、Work360上の一連のコスト数値に変わった。1タスクあたりの平均コストは4.43ドルから1.67ドルへ、62%の低下である。
1回のタスクに4.43ドルかかるエージェントはデモ動画の中にしか存在できない。1.67ドルまで下がって初めて、日常の生産フローに組み込める。Qwen4-Max の今回の発表がやったのはそれだ。「どれだけうまく答えるか」から「どれだけ完全に納品できるか」へ、フラッグシップ競争の焦点を移すこと。
1タスクのコストを4.43ドルから1.67ドルへ、62%削減
Work360 はアリババが自社開発したオフィスタスク評価フレームワークで、26の第一階層ドメイン、182の第二階層サブドメイン、721の第三階層の細分領域をカバーする。Qwen4-Max はそこで52.69点を獲得。前世代の Qwen3.8-Max は47.74点で、5点の伸びと62%のコスト削減を同時に達成した。5点の向上は能力の小さな前進だが、62%の削減は別の出来事を意味する。つまりトークン使用量が下がったのだ。
Xhigh と High の2つの思考レベルでの Work360 上のトークン使用量はそれぞれ約24%、35%低下し、Terminal-Bench 4.0 では約48%、49%低下した。長時間稼働するエージェントの請求額の大半を占めるのは思考トークンであり、API単価はその小さな部分に過ぎない。国内API価格は100万トークンあたり12/36元から10/30元へ、わずか16.7%の低下。キャッシュヒット価格は0.5元/Mまで下がり約66.7%の低下、国際サイトの QwenCloud ではキャッシュヒットが0.075ドル/Mで、入力価格の約20分の1だ。エージェントのセッションは道具の呼び出しが数十回に及ぶことも珍しくなく、キャッシュヒット率こそが長時間セッションの請求額を決める変数なのだ。
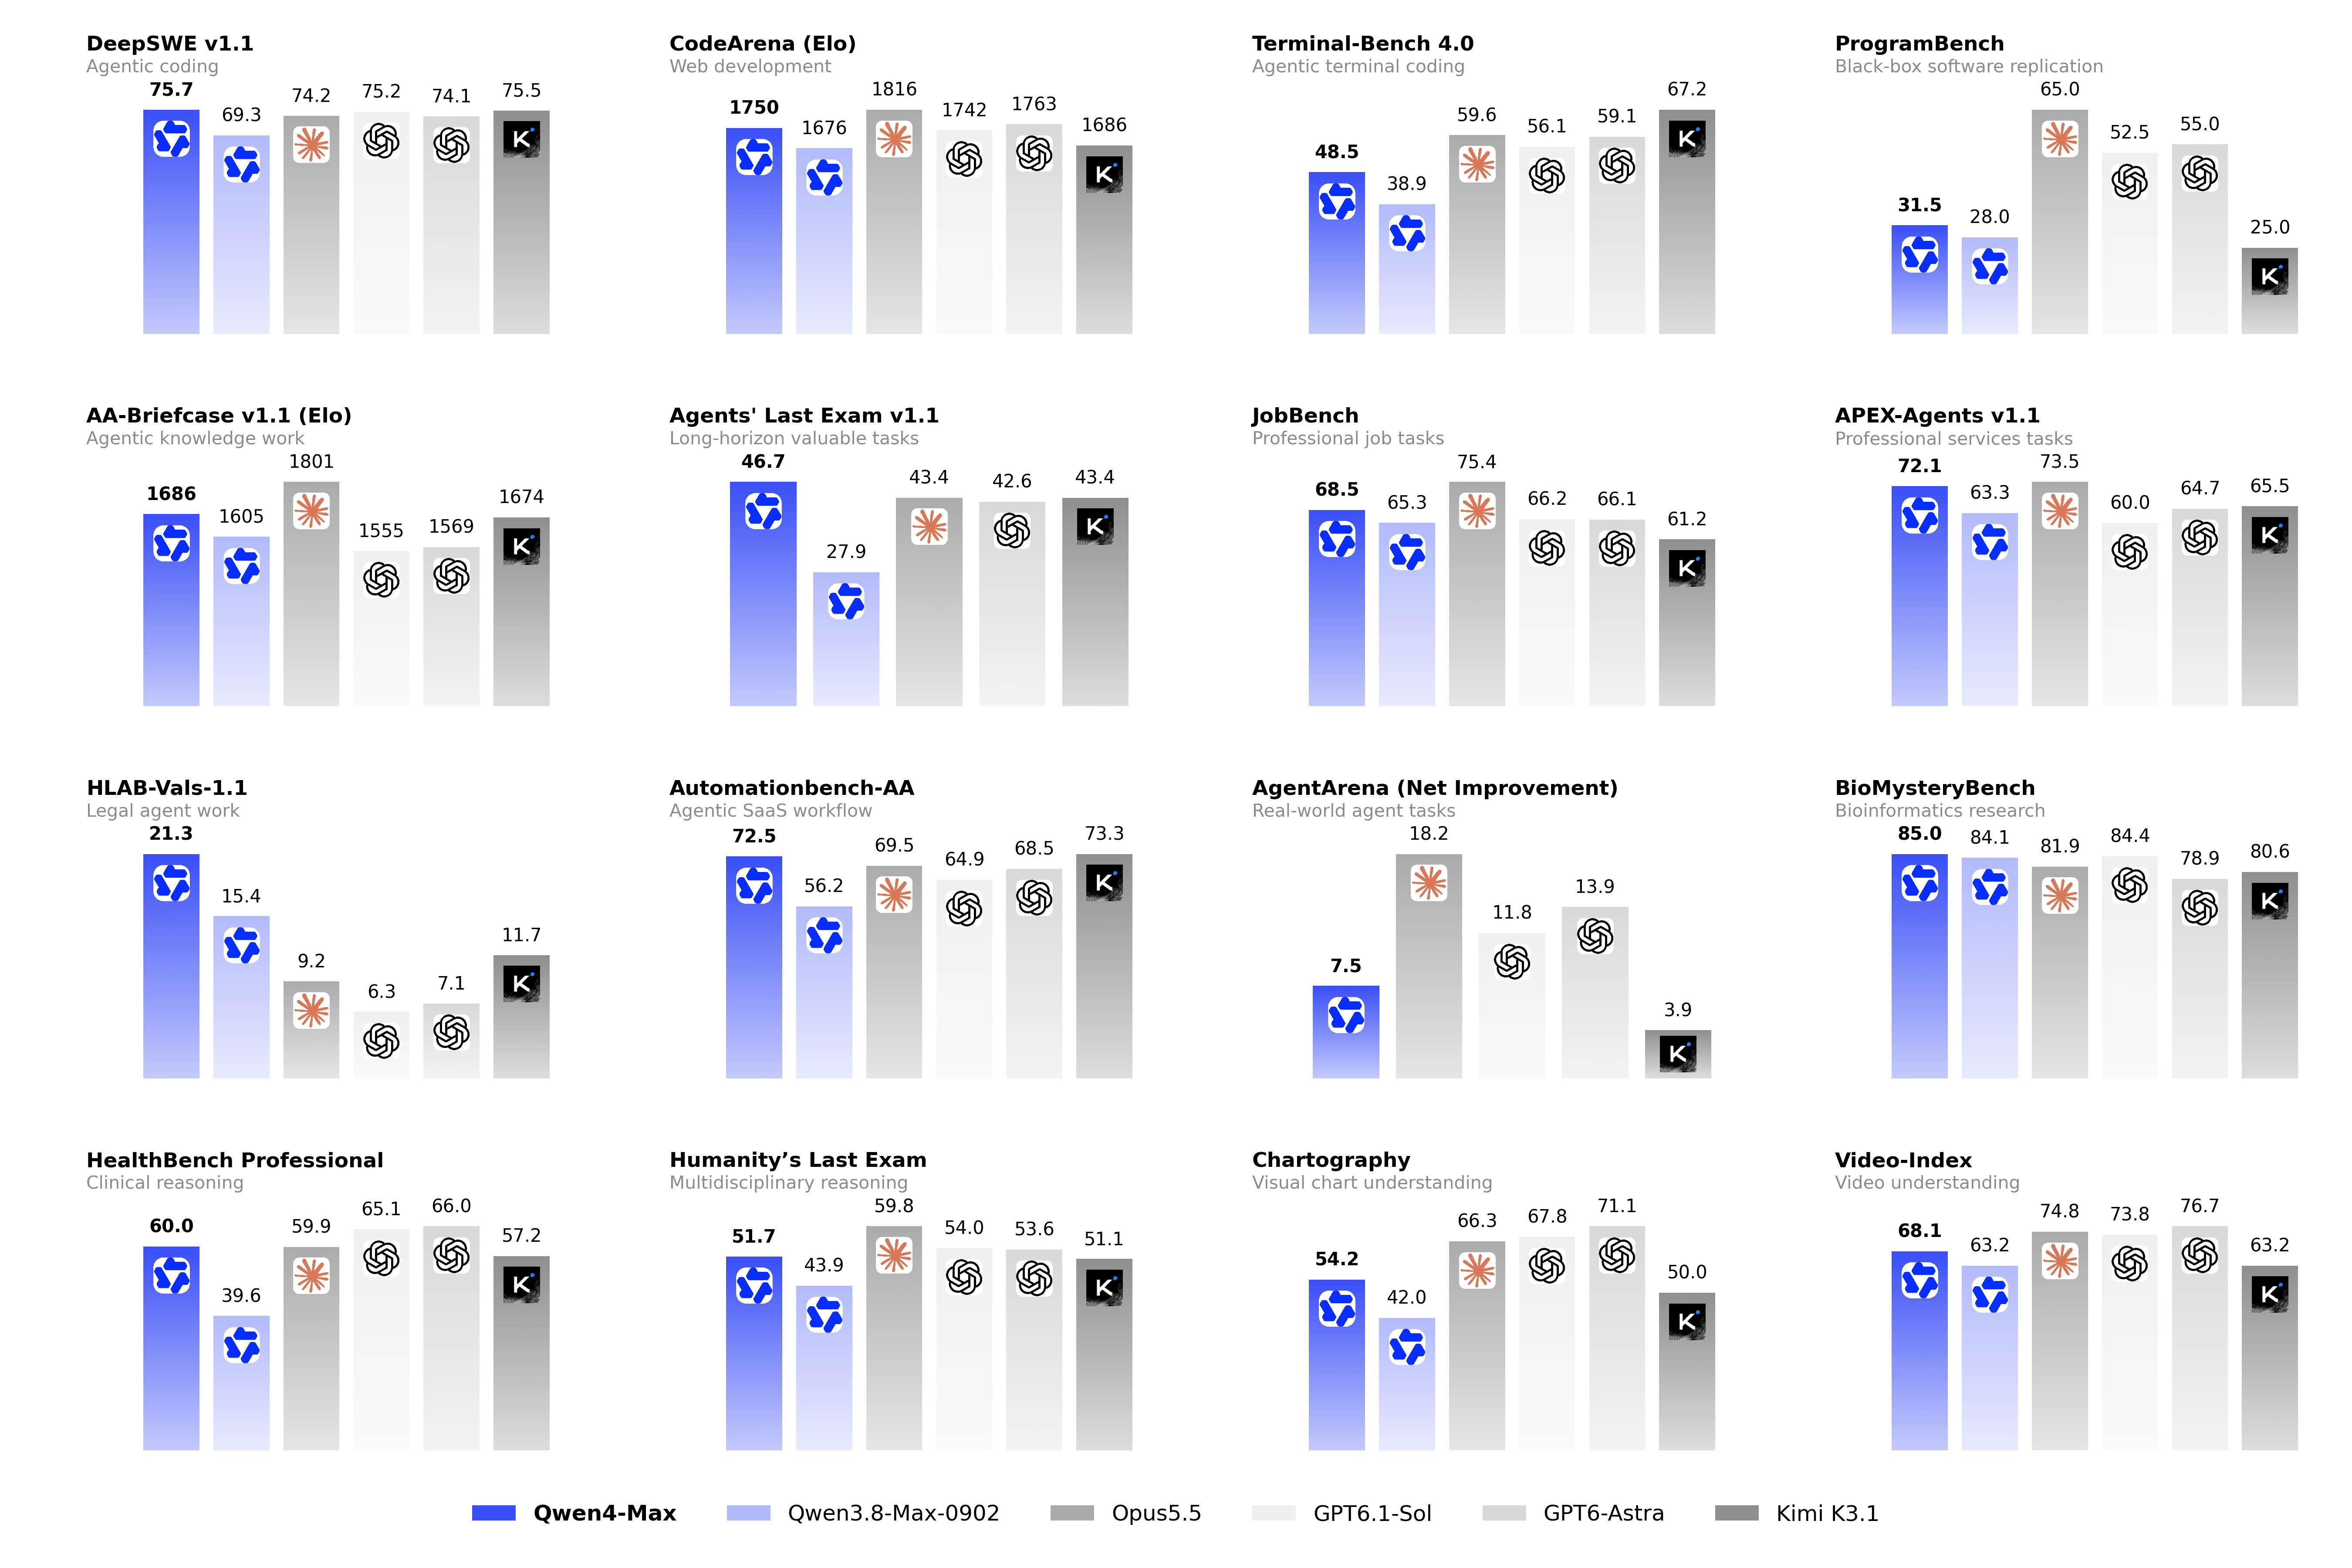
図:公式の総合性能比較。Qwen4-Max を前世代 Qwen3.8-Max と比較し、コーディング、オフィス、長時間タスクの3シナリオを示す。比較対象が自家の前世代であり、第三者による独立評価はまだ追いついていないことに注意。出典:Qwen公式ブログ
2.4兆パラメータと71Bアクティベート——アーキテクチャの変更は請求額を狙っている
総パラメータ2.4兆、1トークンあたりのアクティベートは71B、さらに328BのN-gram Embeddingパラメータを持ち、この種のパラメータはモデルの容量を拡大しながら計算量をほとんど増やさない。3つのアーキテクチャ変更はそれぞれ役割が分かれている。GDN(Gated DeltaNet)と Qwen Sparse Attention(QSA)が長コンテキストのコストを担い、Gated Residual が学習の安定性を、N-gram Embedding が局所的なトークンパターンの表現を担う。
QSAのやり方は、各層でまず3層の Gated DeltaNet で履歴を固定サイズの状態に圧縮し、次に軽量な indexer が micro-block 粒度で関連するコンテキストを選別するというもの。長系列の attention コストとインデックスコストを同時に圧縮できる。Gated Residual は動的な読み書きゲートで4つの並列残差分岐間の層を跨ぐ情報の流れを制御し、その利得は学習の安定性に現れる。証拠は端的だ。2.4兆規模の事前学習で loss が全行程を通じて滑らかに下降し、スパイク(spike)が一切発生しなかった。この規模で全行程スパイクなしというのは、兆級の学習では決して多くない。
Baseレベルの勘定も合う。独自の4ドメイン評価(Knowledge / Code / QA / STEM、10 × BPB、低いほど良い)において、Qwen4-Max-Base の BPB は前世代より約5〜13%低く、アクティベートされるパラメータは25%少ない。スパース性の向上が能力と交換されていないことを示す。比較対象に含まれる GLM-5.3 と Kimi-K3.1-Pro は post-trained checkpoint であり、公式自身が比較可能性に影響があると注記している。これらの数値はまず公式の一方的主張として見ておくべきだろう。
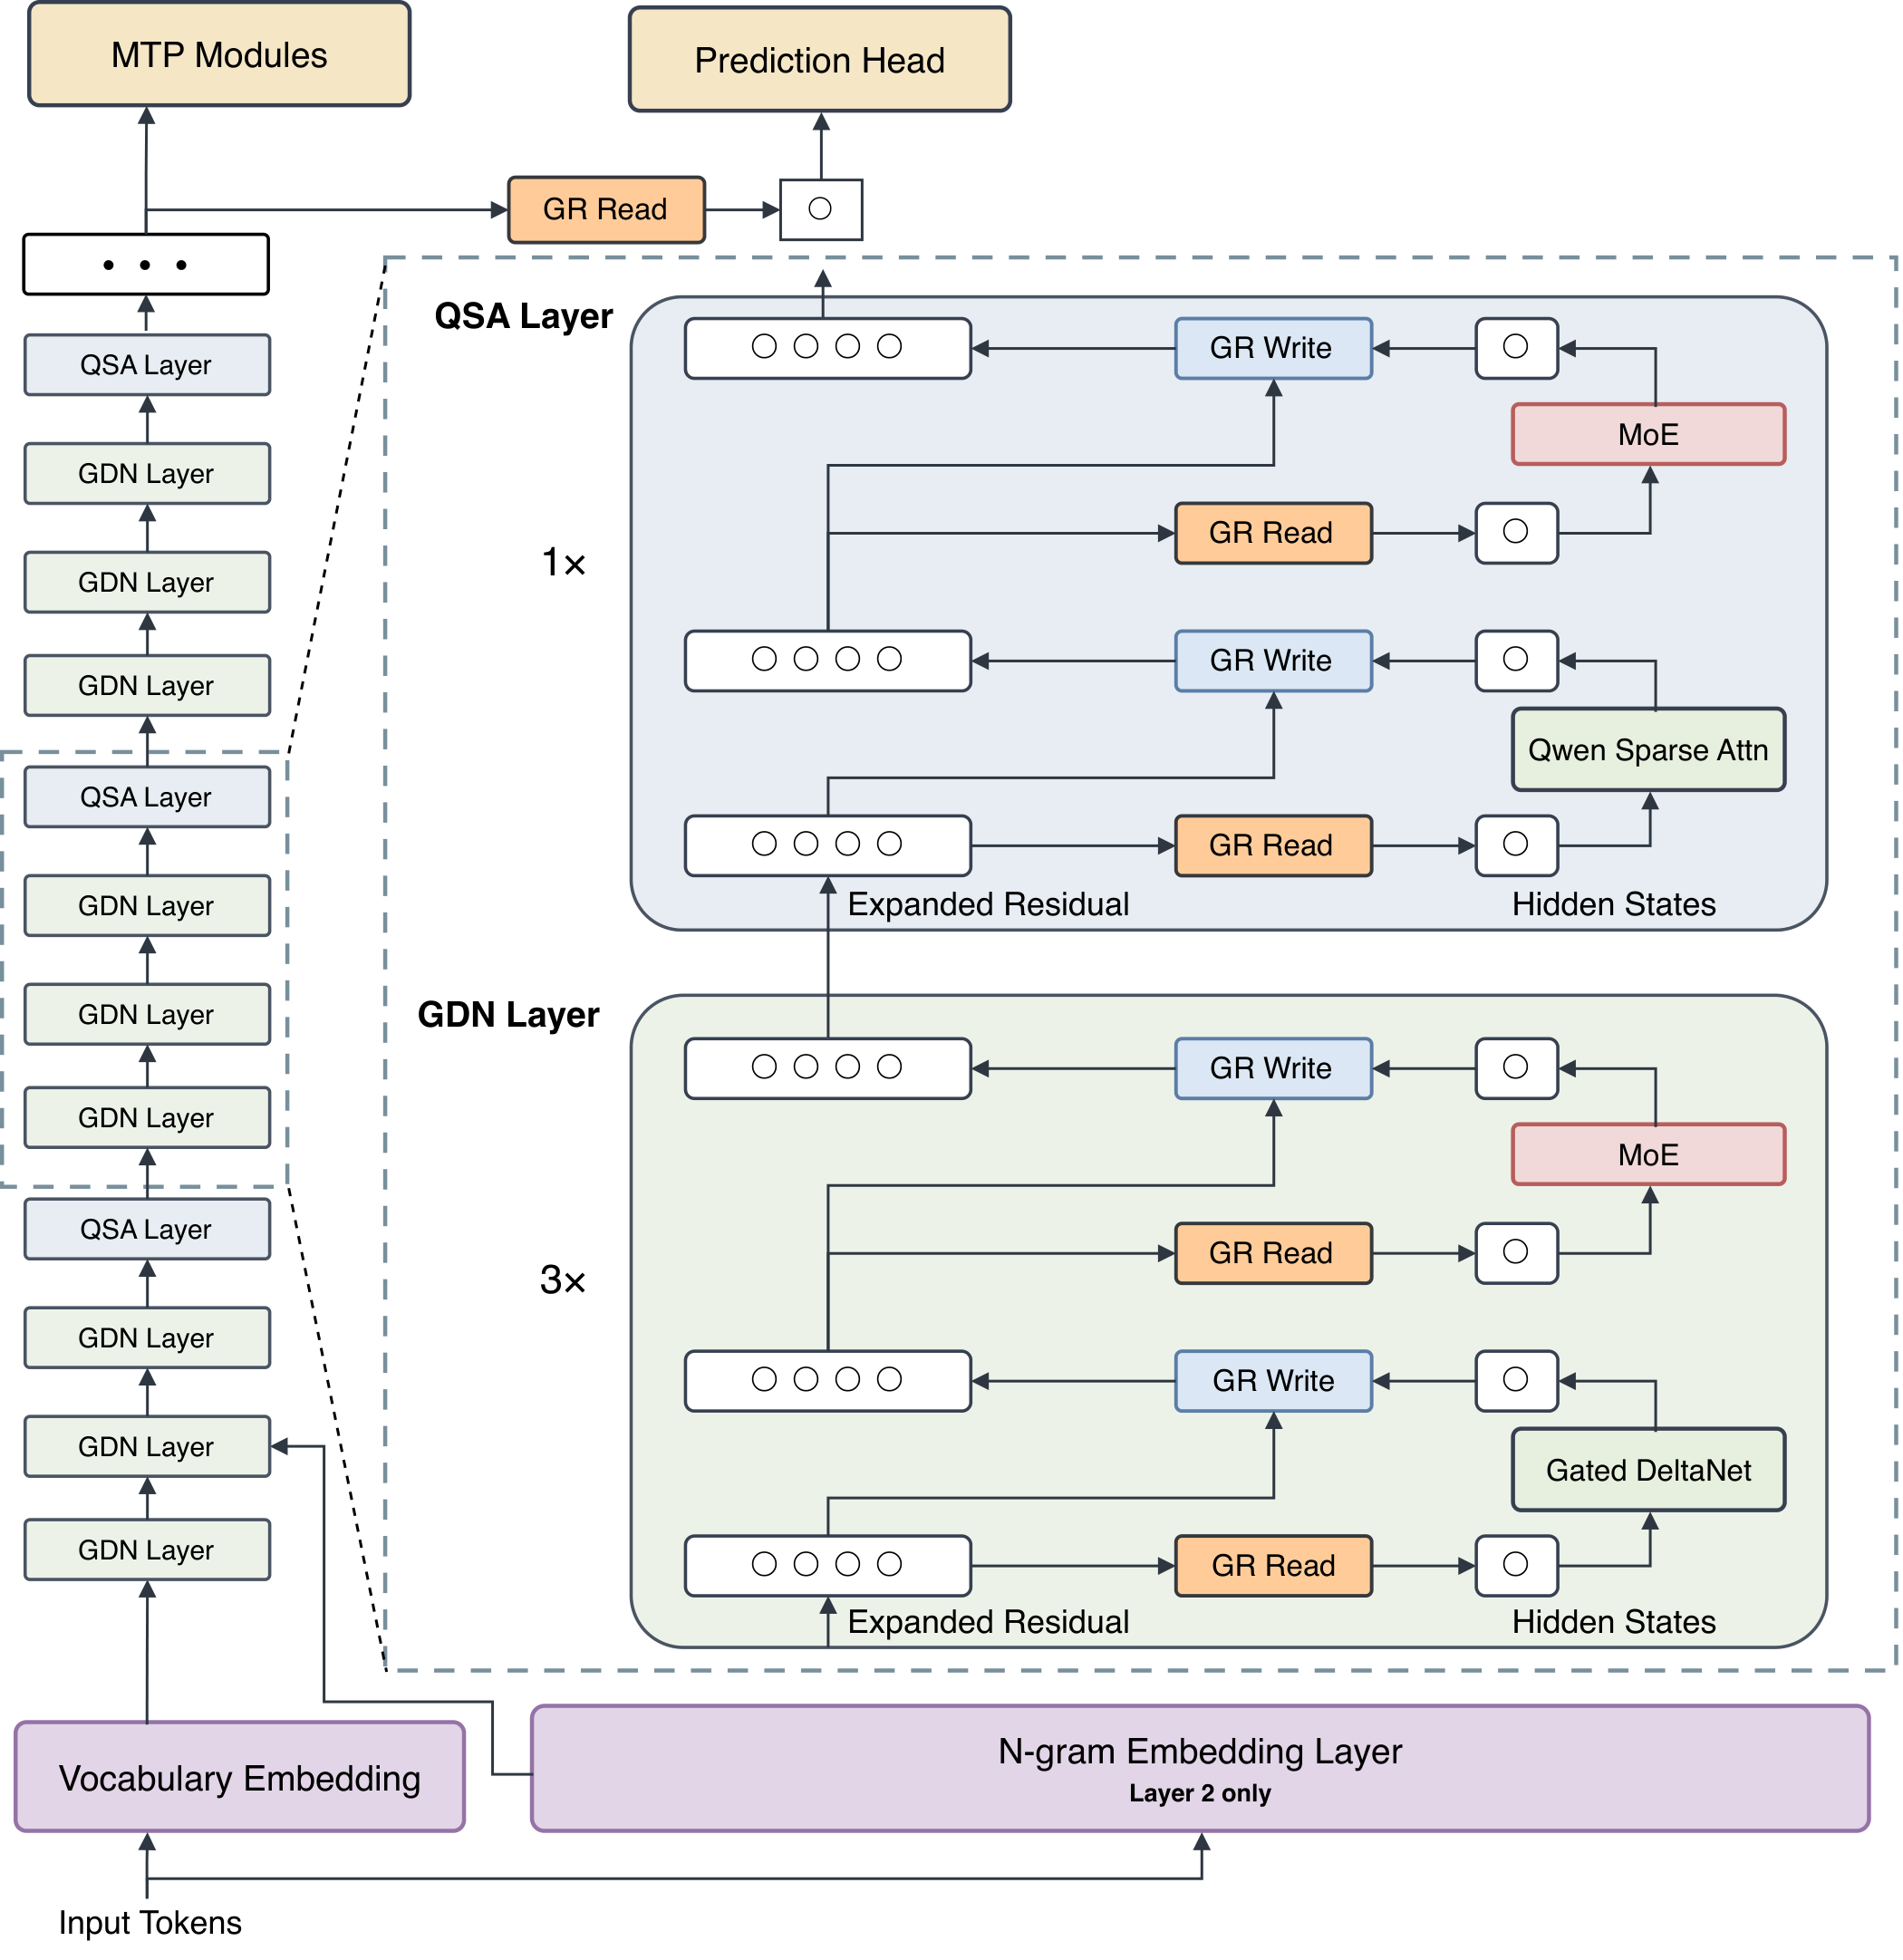
図:Qwen4-Max のアーキテクチャ。各層の QSA の前に置かれた3層の Gated DeltaNet で履歴が固定サイズの状態に圧縮される。これが長時間セッションの attention コストを圧縮できる構造的な基盤だ。出典:Qwen公式ブログ
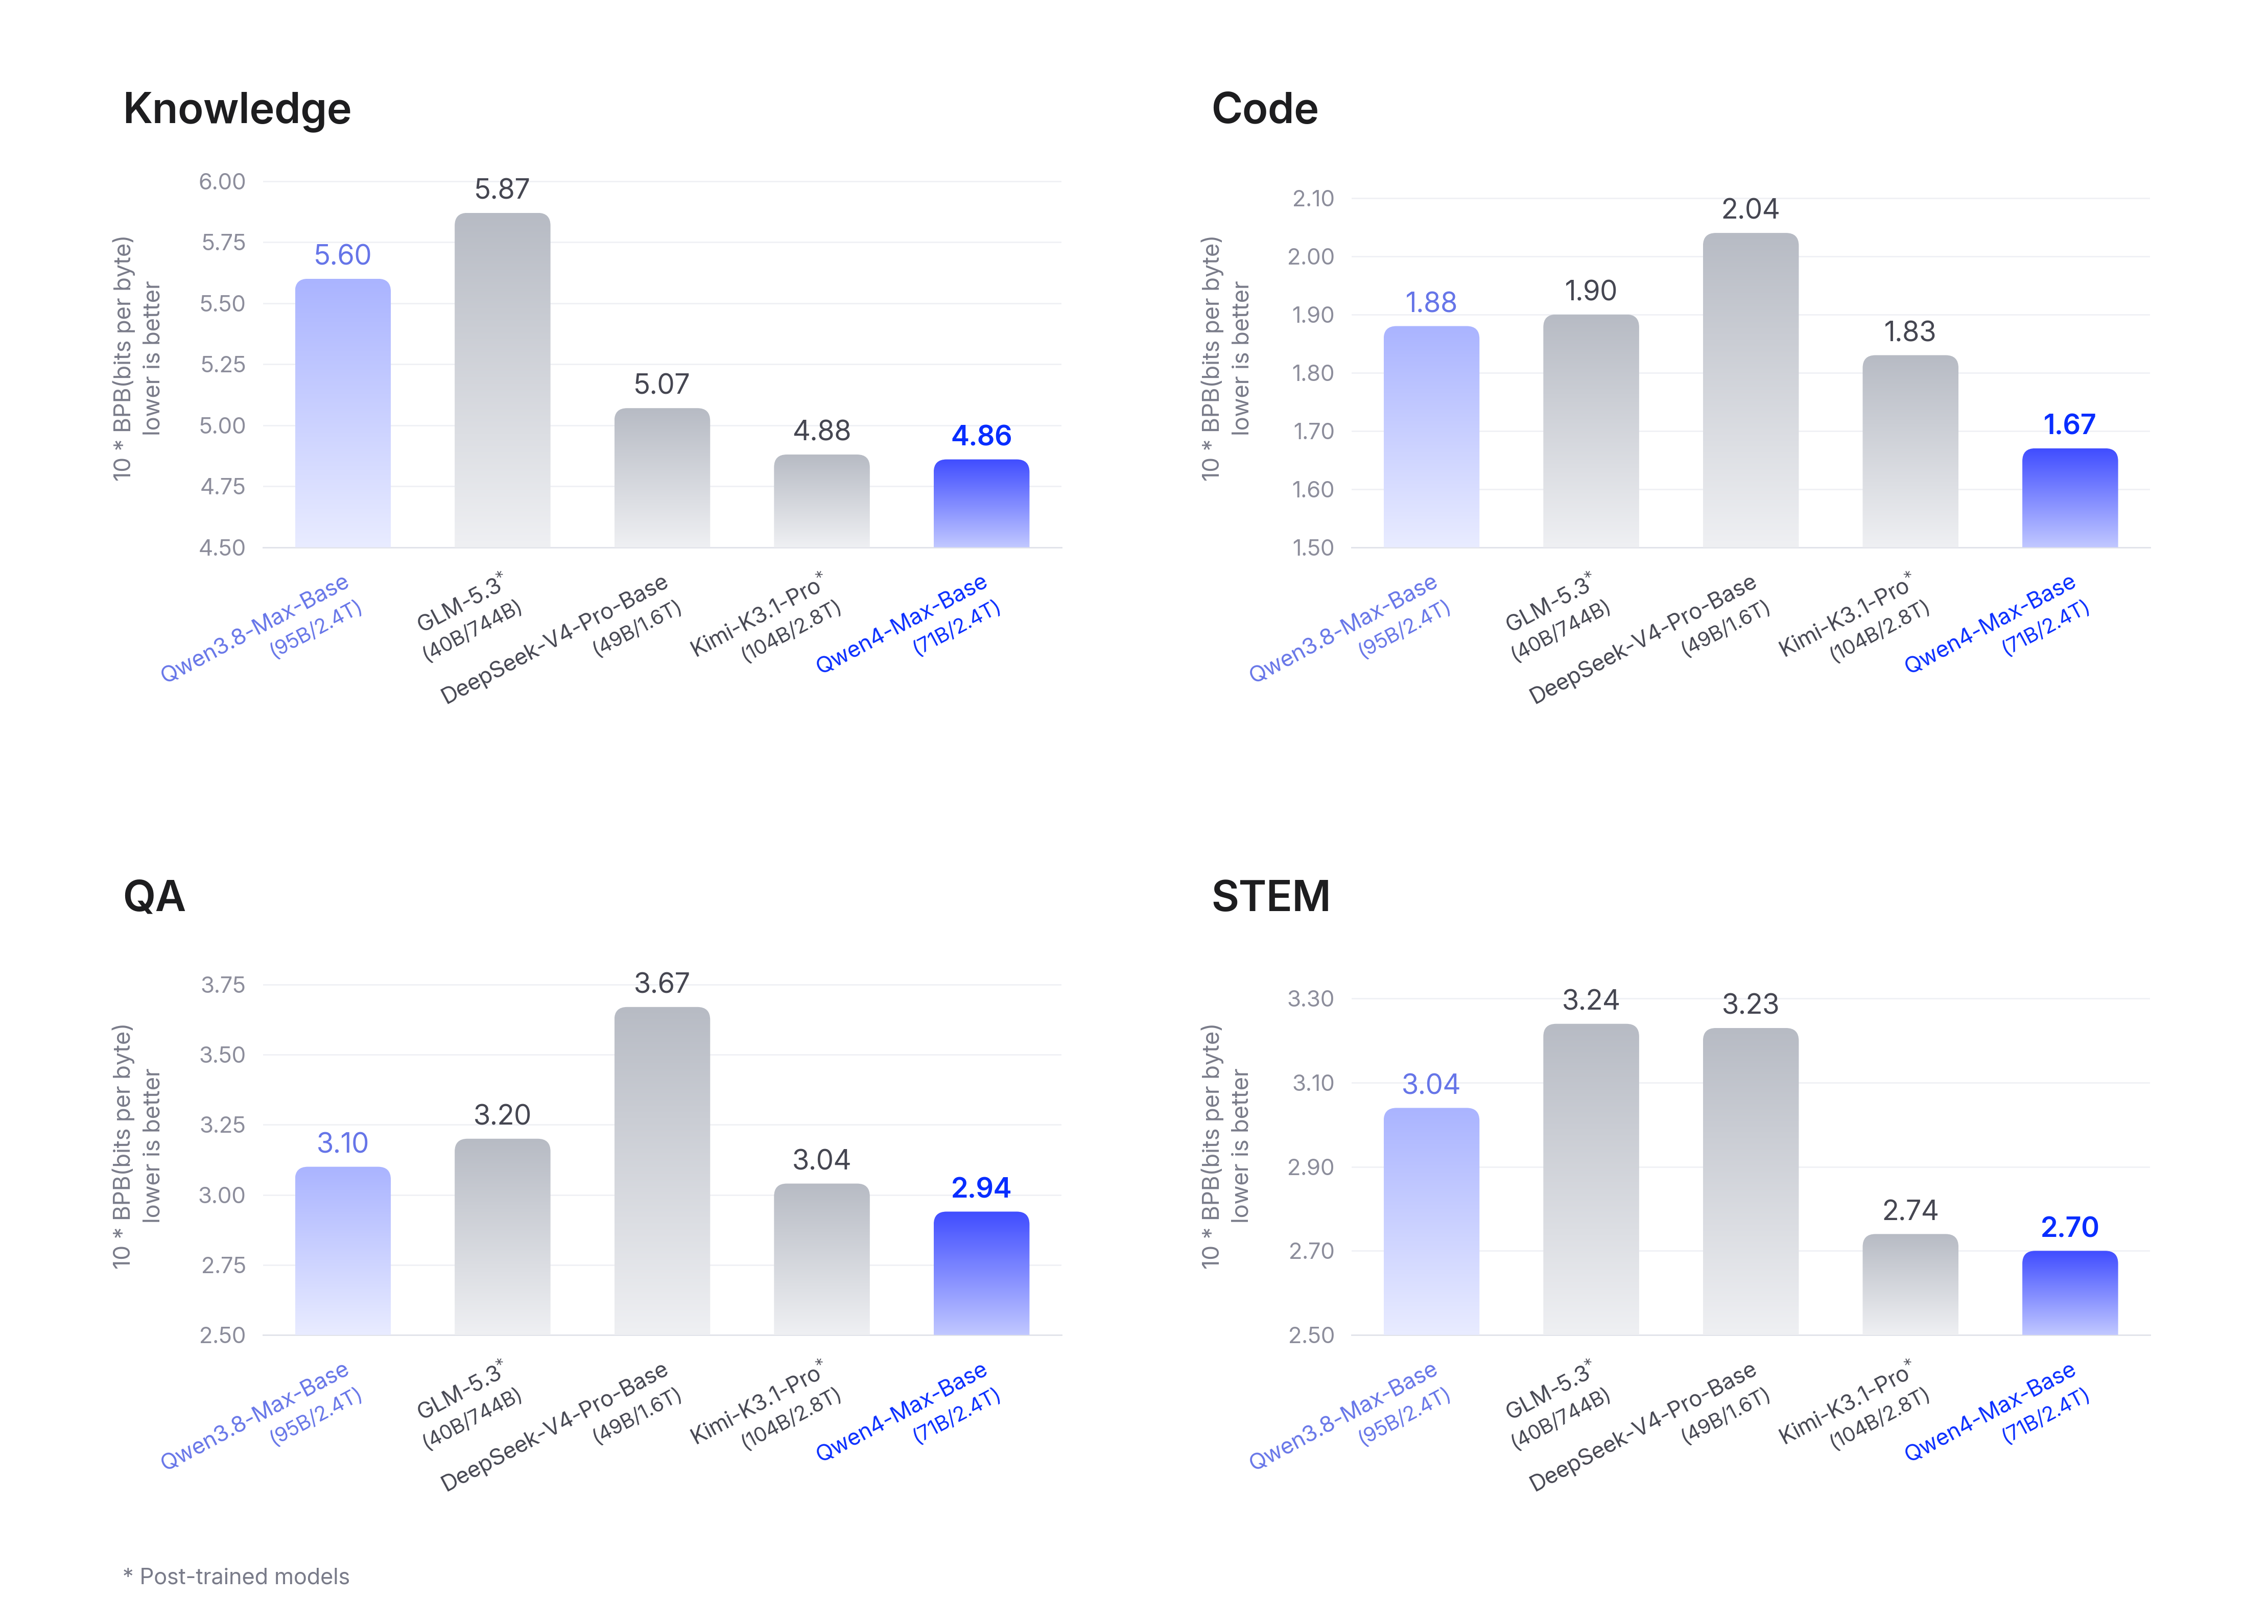
図:事前学習評価は 10 × BPB(低いほど良い)を採用。Qwen4-Max-Base は4ドメインすべてで5グループの checkpoint 中最低値を記録し、アクティベートパラメータは前世代より25%少ない。出典:Qwen公式ブログ
コンテキストは1Mトークン(標準入力の上限は991K)、出力の上限は思考連鎖を含め393,216トークン、思考レベルは none から xhigh までの5段階。出力上限は40万トークンに迫り、1回のエージェント実行で一連の思考と成果物一式を完遂するのに十分だ。5段階のレベル設定はコスト管理のためのノブであり、同じ能力でも請求額をシナリオごとに調整できる。
48時間の無人運転で、ひとつの研究室課題を完遂
Deep Principle の Mira ドライ・ウェットラボ統合プラットフォームに接続すると、モデルは48時間にわたり無人で材料探索のラインを完走した。候補空間は270万分子。まず構造スクリーニング、物性予測、第一原理計算、逆合成解析と実験計画を行い、次に自動化ウェットラボを指揮して試薬調合、合成、分離精製と測定を完遂する。「設計→合成→測定→アクティブラーニング」のサイクルを4周した後、実験で検証済みの新しい冷却液分子を1つ獲得した。目標シナリオは次世代の高消費電力チップ向けデータセンター冷却である。
この種のタスクのフィードバックサイクルは「日」単位であり、報酬信号は疎だ。これまで自動化システムには渡せなかった。妨げになっていたのは2つの前提——モデルが長時間の一貫性に耐えられないこと、そして1回の試行錯誤が高すぎること——だ。後者の前提こそ、1.67ドルが解いている問題である。
クラウドスケジューリングの事例の数値はアリババクラウドの実ビジネスから来ている。データアノテーションのモデル呼び出しスケジューリングコストは平均10.42%削減、オンラインGPU割り当てのマシン全体の空き容量時間は4.62%増加、オフラインCPUの再スケジューリングは最適解到達速度が14.61倍以上向上した。10.42%と4.62%は大きく見えないかもしれないが、これらは実ビジネスの帳簿から出た数字であり、モデルは自分自身を訓練しているシステムを最適化しており、削減したコストは直接アリババの決算に戻る。14.61倍の求解加速は期待の範囲内で、制約を書き、ソルバーを調整するのはもともとLLMの得意分野だ。
創薬の試行錯誤密度はさらに高い。DP Technology の PharmMaster プラットフォーム上で、アルツハイマー病関連の NLRP3 インフラマソームを対象にエンドツーエンドの研究を行い、454回のツール呼び出し、3,239回の計算指標評価、24の候補分子を経て、選抜された分子の相対結合自由エネルギー(RBFE)の推定値は参照分子の約3.6倍となり、ウェット実験での検証に進む価値があると判断された。454の意思決定ポイントにわたる試行錯誤を旧コスト構造の下で行えば、この研究ラインの予算は立項の段階で承認されなかっただろう。
発表資料には一連の業界向け納品事例もある。SANF と Pacific Union の実生産ラインでは、単品工件のプログラミングに必要な工数が8時間近くから24分へ、約95%削減された。命名が混乱していた198件の法務資料は14のフォルダに整理され、12の審査領域をカバーする86ページのレポートを生成し、すべての結論が個別の資料に遡って検証できる。重症医学では1つの症例に1,433枚の原画像と数万字に及ぶ経過記録が含まれ、1回の対話で抽出から意思決定支援までの全フローを完遂した。共通点は検収基準が明確なこと——レポート、動くプログラム、生産ラインのコード。成果物が検証可能でなければ、エージェントは生産フローに入る資格を得られない。
ランキング1位は公式データ、価格表は違う
DataLearner が収録した順位では、Qwen4-Max は Agents’ Last Exam v1.1(46.70、1/26位)、BioMysteryBench(85、1/26位)、AutomationBench-AA(72.50、1/4位)、Code Arena WebDev(1750、1/4位)などのランキングで1位を獲得しているが、データの出所はほぼ公式ブログが公開したチャートであり、Artificial Analysis や LMArena などの第三者による独立ランキングはまだ収録していない。Work360 はアリババの自社開発フレームワークであり、事例動画はすべてベンダー提供のものだ。自社ベンチマークと公式チャートによる順位、この証拠連鎖は割り引いて見る必要がある。
価格は割り引く必要がない。国内サイトは入力10元、出力30元(100万トークンあたり)、国際サイトは入力1.5ドル、出力4.5ドル、キャッシュヒット0.075ドル。料金表はプラットフォーム上に明記されており、契約上の事実であり、評価方法論の争いの余地はない。
競争の境界も認める必要がある。複雑なターミナルエンジニアリングとブラックボックスの再現シナリオでは、Kimi K3.1 と Opus 5.5 が依然として顕著なスコア優位を保っており、Qwen4-Max は Terminal-Bench 4.0 で48.48点の13/58位、Vibe Code Bench v1.1 で15/120位にとどまる。そのコストパフォーマンスの優位は、キャッシュ再利用率の高いシナリオ、長コンテキストのマルチモーダルオフィス業務、法務やバイオインフォのエージェントといった分野に集中しており、ターミナルの硬い骨はまだ噛み砕けていない。
コミュニティで当日最も熱かった議論は「ペリカンが自転車に乗る」描画テストだった。Simon Willison が none/low/high/xhigh の4段階それぞれで実行し、「こうしたテストはとっくに訓練セットに入っている」と疑問を投げかけるコメントもあった。新モデルの発表当日、手元で使える独立シグナルはほぼゼロ——これは評価体系全体に共通するジレンマであり、Qwen4-Max はその最新のサンプルに過ぎない。
フラッグシップはクローズドソース、オープンソースは小型を待つ
Qwen4-Max はウェイトを公開せず、クローズドソースのAPIとプラットフォームサービスのみを提供し、インターフェースは OpenAI と Anthropic の両形式に互換する。公式によれば Qwen4 シリーズの小型モデルは同じ技術セットで訓練され順次オープンソース化されるというが、Max フラッグシップのオープンソース化は約束されていない。プライベートデプロイが必要な場合、この世代では引き続き Qwen3.8-Max の公開済みウェイトを使うしかない。クローズドのフラッグシップで商業収入を確保し、オープンソースの小型モデルでエコシステムを育てる——この組み合わせをアリババはすでに使い慣れている。
セキュアコーディングは見落とされがちな項目だ。Last Secure Code Bench では、機能とセキュリティを同時に通過する機能レベルの比率が22.0%から31.8%へ上昇し、関数・ファイル・リポジトリの3粒度で同時にセキュアな生成ができた比率は8%から14.7%へ、ほぼ倍増した。絶対値は依然として高くなく、3粒度同時のセキュア生成は15%未満であり、エージェントがセキュリティに敏感なコードを書く際には人間のレビュー工程を1行たりとも省けない。しかし8%から14.7%という傾きの方向は正しく、公式はさらに攻撃的サイバーセキュリティのデータを訓練セットから除外し、防御的なタスクのみを残した。
振り返って見ると、今回の発表で撥ねられたスイッチはコスト曲線だ。1.67ドルは企業が1回のタスクの試行錯誤に払ってもよいと考える価格帯に収まるが、4.43ドルは収まらない。ランキングのスコアは公式チャート由来だと疑う余地があり、事例動画は演出だと疑う余地があるが、料金表の数字には争いの余地がない。Qwen4-Max はターミナルエンジニアリングではまだ Kimi K3.1 と Opus 5.5 に勝っていない。勝ったのは、長時間稼働するエージェントが初めて生産予算でスケジュールを組み、日常フローに入れるようになったことだ——次世代フラッグシップの発表では、パラメータ規模はおそらく2行目に回り、コスト曲線がすでにその座を受け取っている。
参考リンク:
- Qwen公式ブログ:Qwen4-Max 発表アナウンス
- DataLearner モデルランキング収録ページ
- Simon Willison:4段階の思考モードによる描画テスト記録