Am 16. November 2026 hat das Tongyi-Qianwen-Team von Alibaba das Closed-Source-Flaggschiff der vierten Generation veröffentlicht: Qwen4-Max, ein sparsames Mixture-of-Experts-Modell (MoE) mit 2,4 Billionen Gesamtparametern, davon 71B aktivierte Parameter pro Token, nativer Bildverarbeitung und 1M Kontext. Die offizielle Erzählung hat ihren Schwerpunkt verlagert: Statt Benchmark-Scores trägt nun ein Satz von Kostenzahlen aus Work360 die Argumentation – die Durchschnittskosten pro Aufgabe fallen von 4,43 auf 1,67 Dollar, eine Reduktion um 62 Prozent.
Ein Agent, der 4,43 Dollar pro Aufgabe kostet, bleibt im Demo-Video; erst bei 1,67 Dollar lässt er sich in den regulären Produktionsablauf einplanen. Genau das leistet diese Veröffentlichung von Qwen4-Max: den Fokus des Flaggschiff-Wettbewerbs von der Frage „Wie gut wird geantwortet?” auf die Frage „Wie vollständig wird geliefert?” zu verschieben.
Kosten pro Aufgabe von 4,43 auf 1,67 Dollar gedrückt – minus 62 Prozent
Work360 ist Alibis eigenes Evaluierungsframework für Bürotätigkeiten und umfasst 26 Domänen der ersten Ebene, 182 Subdomänen der zweiten Ebene und 721 feingliedrige Bereiche der dritten Ebene. Qwen4-Max erreicht dort 52,69 Punkte, der Vorgänger Qwen3.8-Max lag bei 47,74 – ein Plus von fünf Punkten bei gleichzeitig 62 Prozent niedrigeren Kosten. Die fünf Punkte sind ein kleiner Fähigkeitsschritt; die 62 Prozent sind etwas anderes: Der Token-Verbrauch ist gesunken.
Die beiden Denkstufen Xhigh und High verbrauchen in Work360 rund 24 bzw. 35 Prozent weniger Token, in Terminal-Bench 4.0 etwa 48 bzw. 49 Prozent. Der größte Posten in der Rechnung langlebiger Agenten sind Denk-Token, der API-Stückpreis macht nur einen kleinen Teil aus. Die chinesische API-Preisgestaltung sinkt von 12/36 auf 10/30 Yuan pro Million Token – nur 16,7 Prozent; der Cache-Trefferpreis fällt auf 0,5 Yuan/M, rund 66,7 Prozent günstiger; auf der internationalen Plattform QwenCloud kostet ein Cache-Treffer 0,075 Dollar/M, etwa ein Zwanzigstel des Eingabepreises. Agentensitzungen umfassen Dutzende Tool-Aufrufe – die Cache-Trefferquote ist die entscheidende Variable in der Rechnung langer Sitzungen.
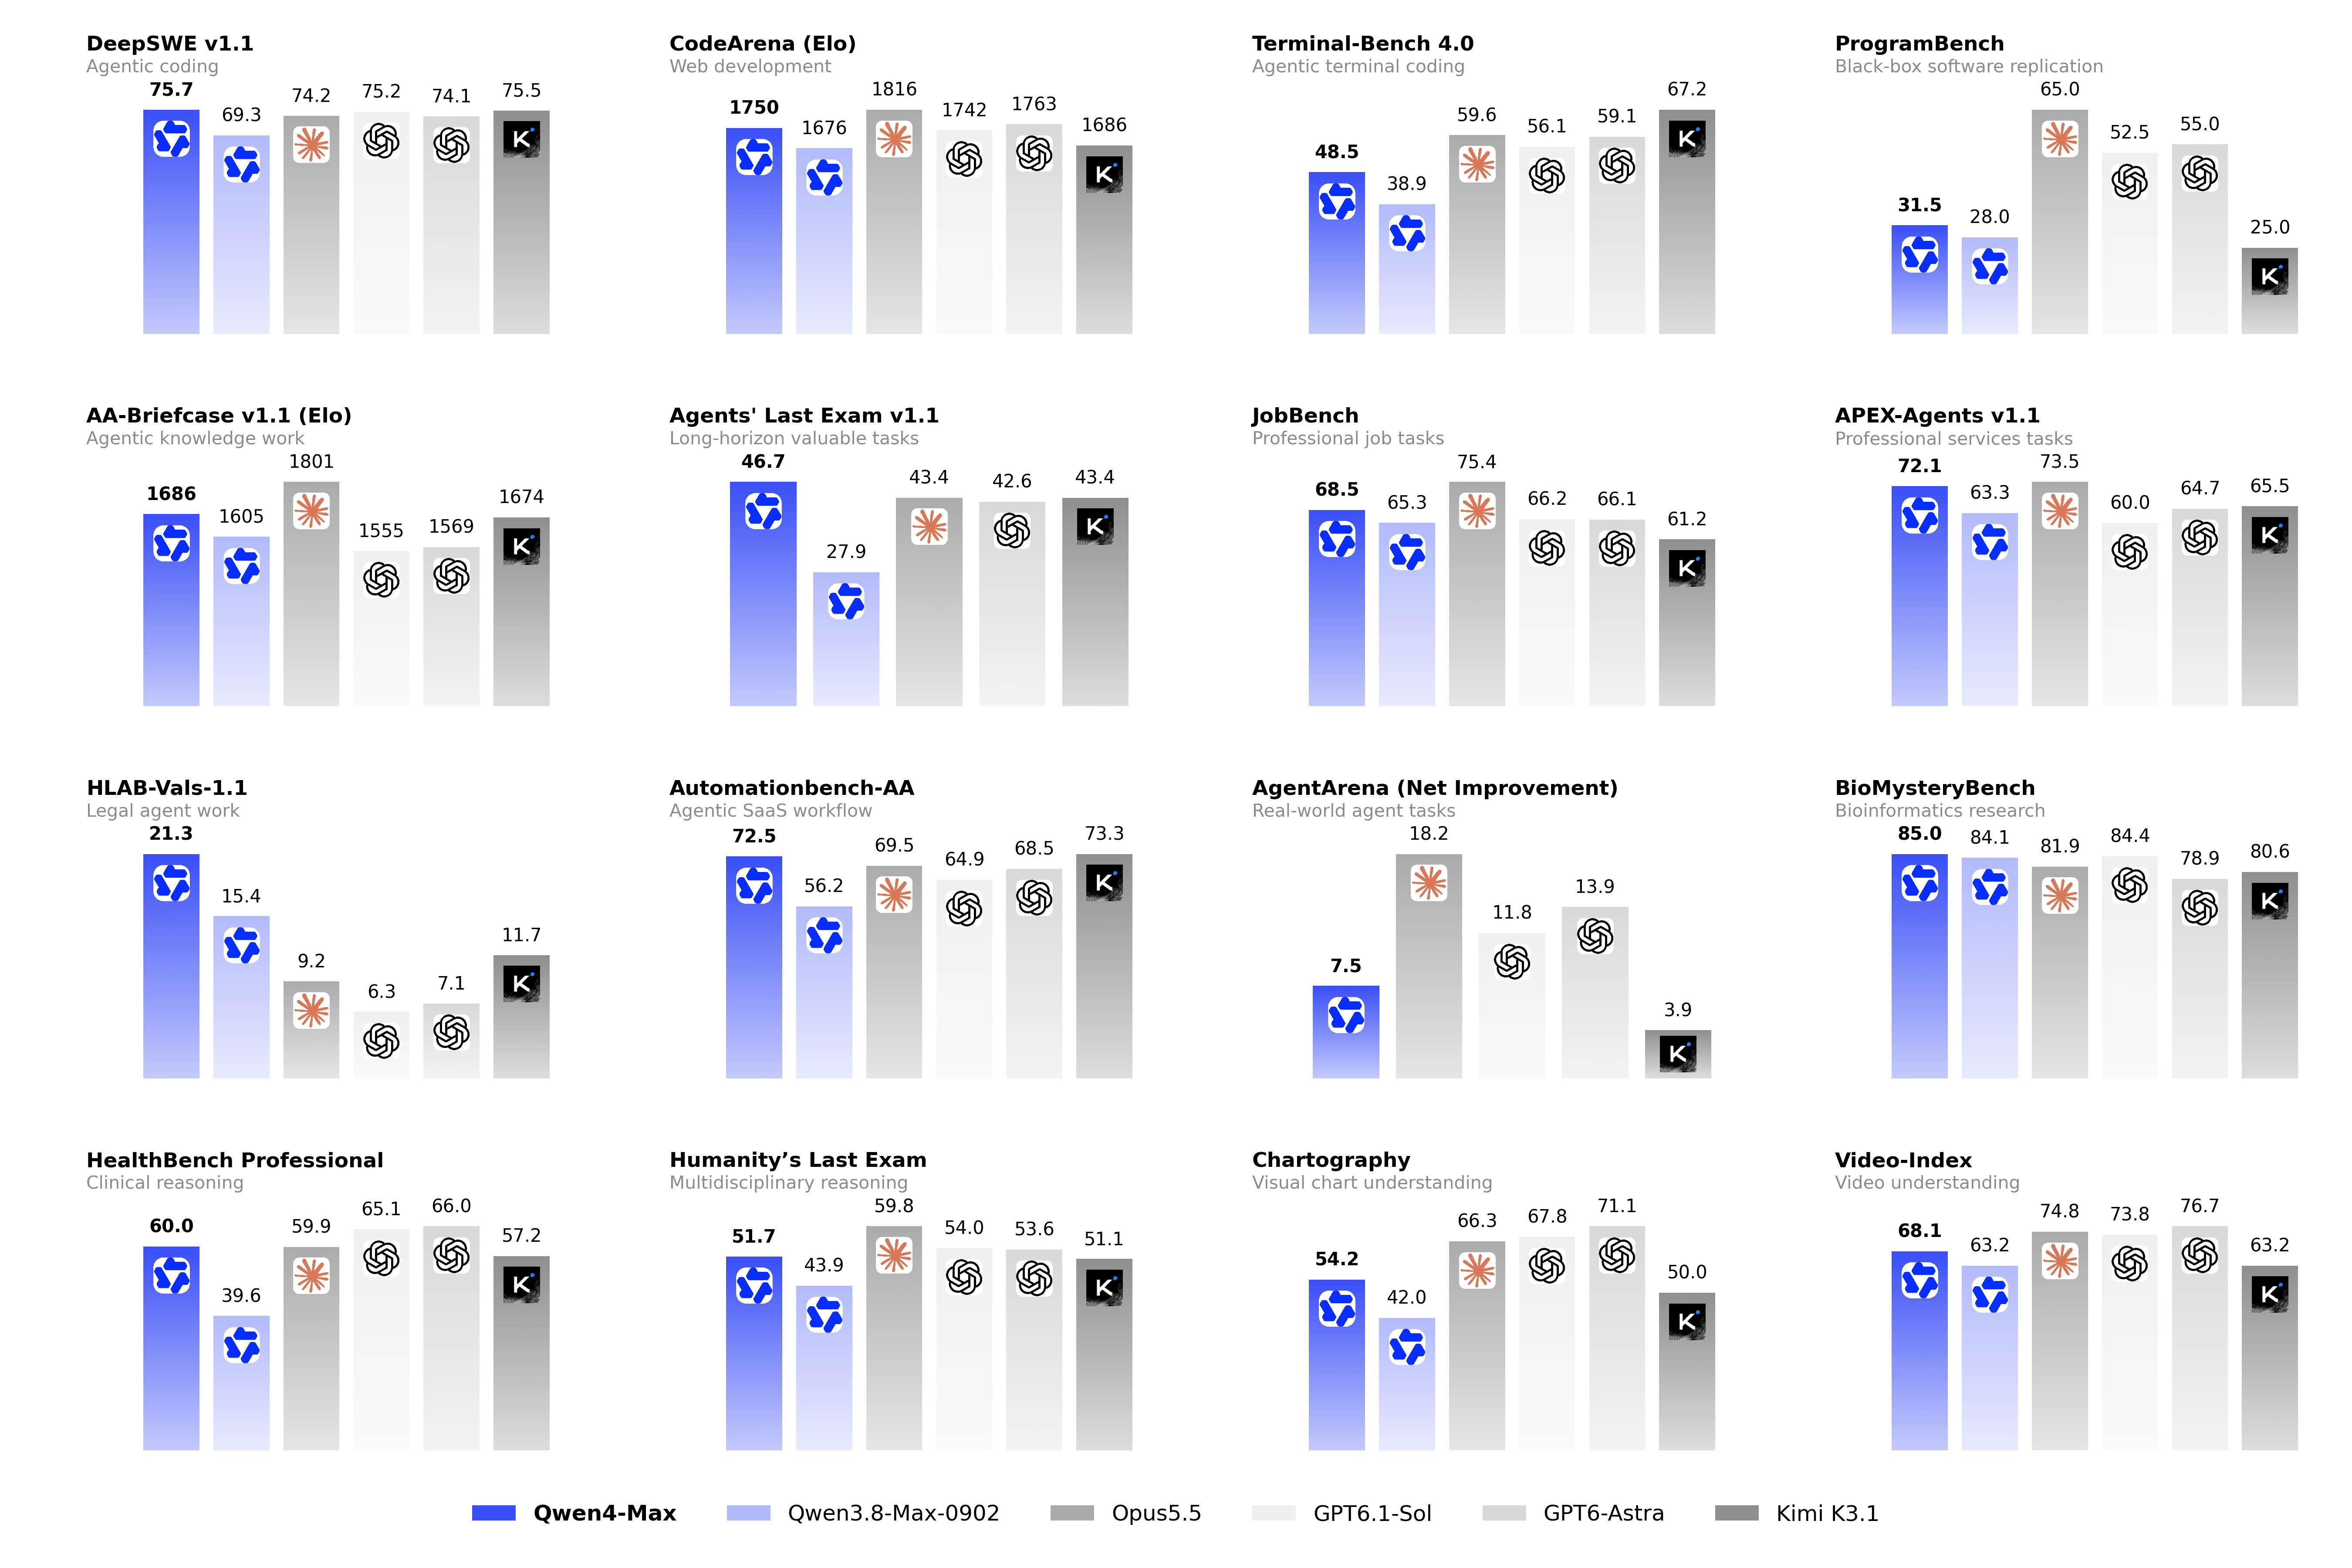
Abbildung: Offizieller Gesamtvergleich, Qwen4-Max gegenüber dem Vorgänger Qwen3.8-Max in den drei Szenarien Coding, Büro und langlaufende Aufgaben. Zu beachten: Verglichen wird nur mit dem eigenen Vorgänger; unabhängige Dritt-Evaluationen stehen noch aus. Quelle: Offizieller Qwen-Blog
2,4 Billionen Parameter plus 71B aktiviert – die Architekturänderungen zielen auf die Rechnung
2,4 Billionen Gesamtparameter, 71B pro Token aktiviert, dazu 328B N-gram-Embedding-Parameter – Letztere vergrößern die Modellkapazität, ohne den Rechenaufwand nennenswert zu erhöhen. Die drei Architekturänderungen haben jeweils eigene Zuständigkeiten: GDN (Gated DeltaNet) zusammen mit Qwen Sparse Attention (QSA) senkt die Kosten langer Kontexte, Gated Residual sichert die Trainingsstabilität, und die N-gram-Embeddings übernehmen die Repräsentation lokaler Token-Muster.
QSA arbeitet so, dass pro Schicht zunächst drei Gated-DeltaNet-Schichten die Historie in einen Zustand fester Größe komprimieren, bevor ein leichtgewichtiger Indexer auf Micro-Block-Ebene den relevanten Kontext auswählt – die Attention- und Indexierungskosten langer Sequenzen werden gleichzeitig gedrückt. Gated Residual steuert mit einem dynamischen Lese-Schreib-Gate den informationfluss über vier parallele Residual-Zweige hinweg; der Gewinn liegt in der Trainingsstabilität. Die Belege sind eindeutig: Beim Pretraining in Billionenmaßstab fällt die Loss-Kurve durchgehend glatt und ohne Spikes. Ein trainingslanger Verlauf ohne Spikes ist in dieser Größenordnung alles andere als üblich.
Auf Base-Ebene geht die Rechnung auf: Im eigenen Vier-Domänen-Benchmark (Knowledge / Code / QA / STEM, 10 × BPB, niedriger ist besser) liegt der BPB von Qwen4-Max-Base rund 5–13 Prozent unter dem Vorgänger – bei 25 Prozent weniger aktivierten Parametern. Die höhere Sparsity wurde nicht auf Kosten der Fähigkeiten erkauft. Die Vergleichskandidaten GLM-5.3 und Kimi-K3.1-Pro sind post-trained Checkpoints; das Offizielle weist selbst darauf hin, dass die Vergleichbarkeit eingeschränkt ist – diese Zahlen sind zunächst als einseitige Herstellerangabe zu lesen.
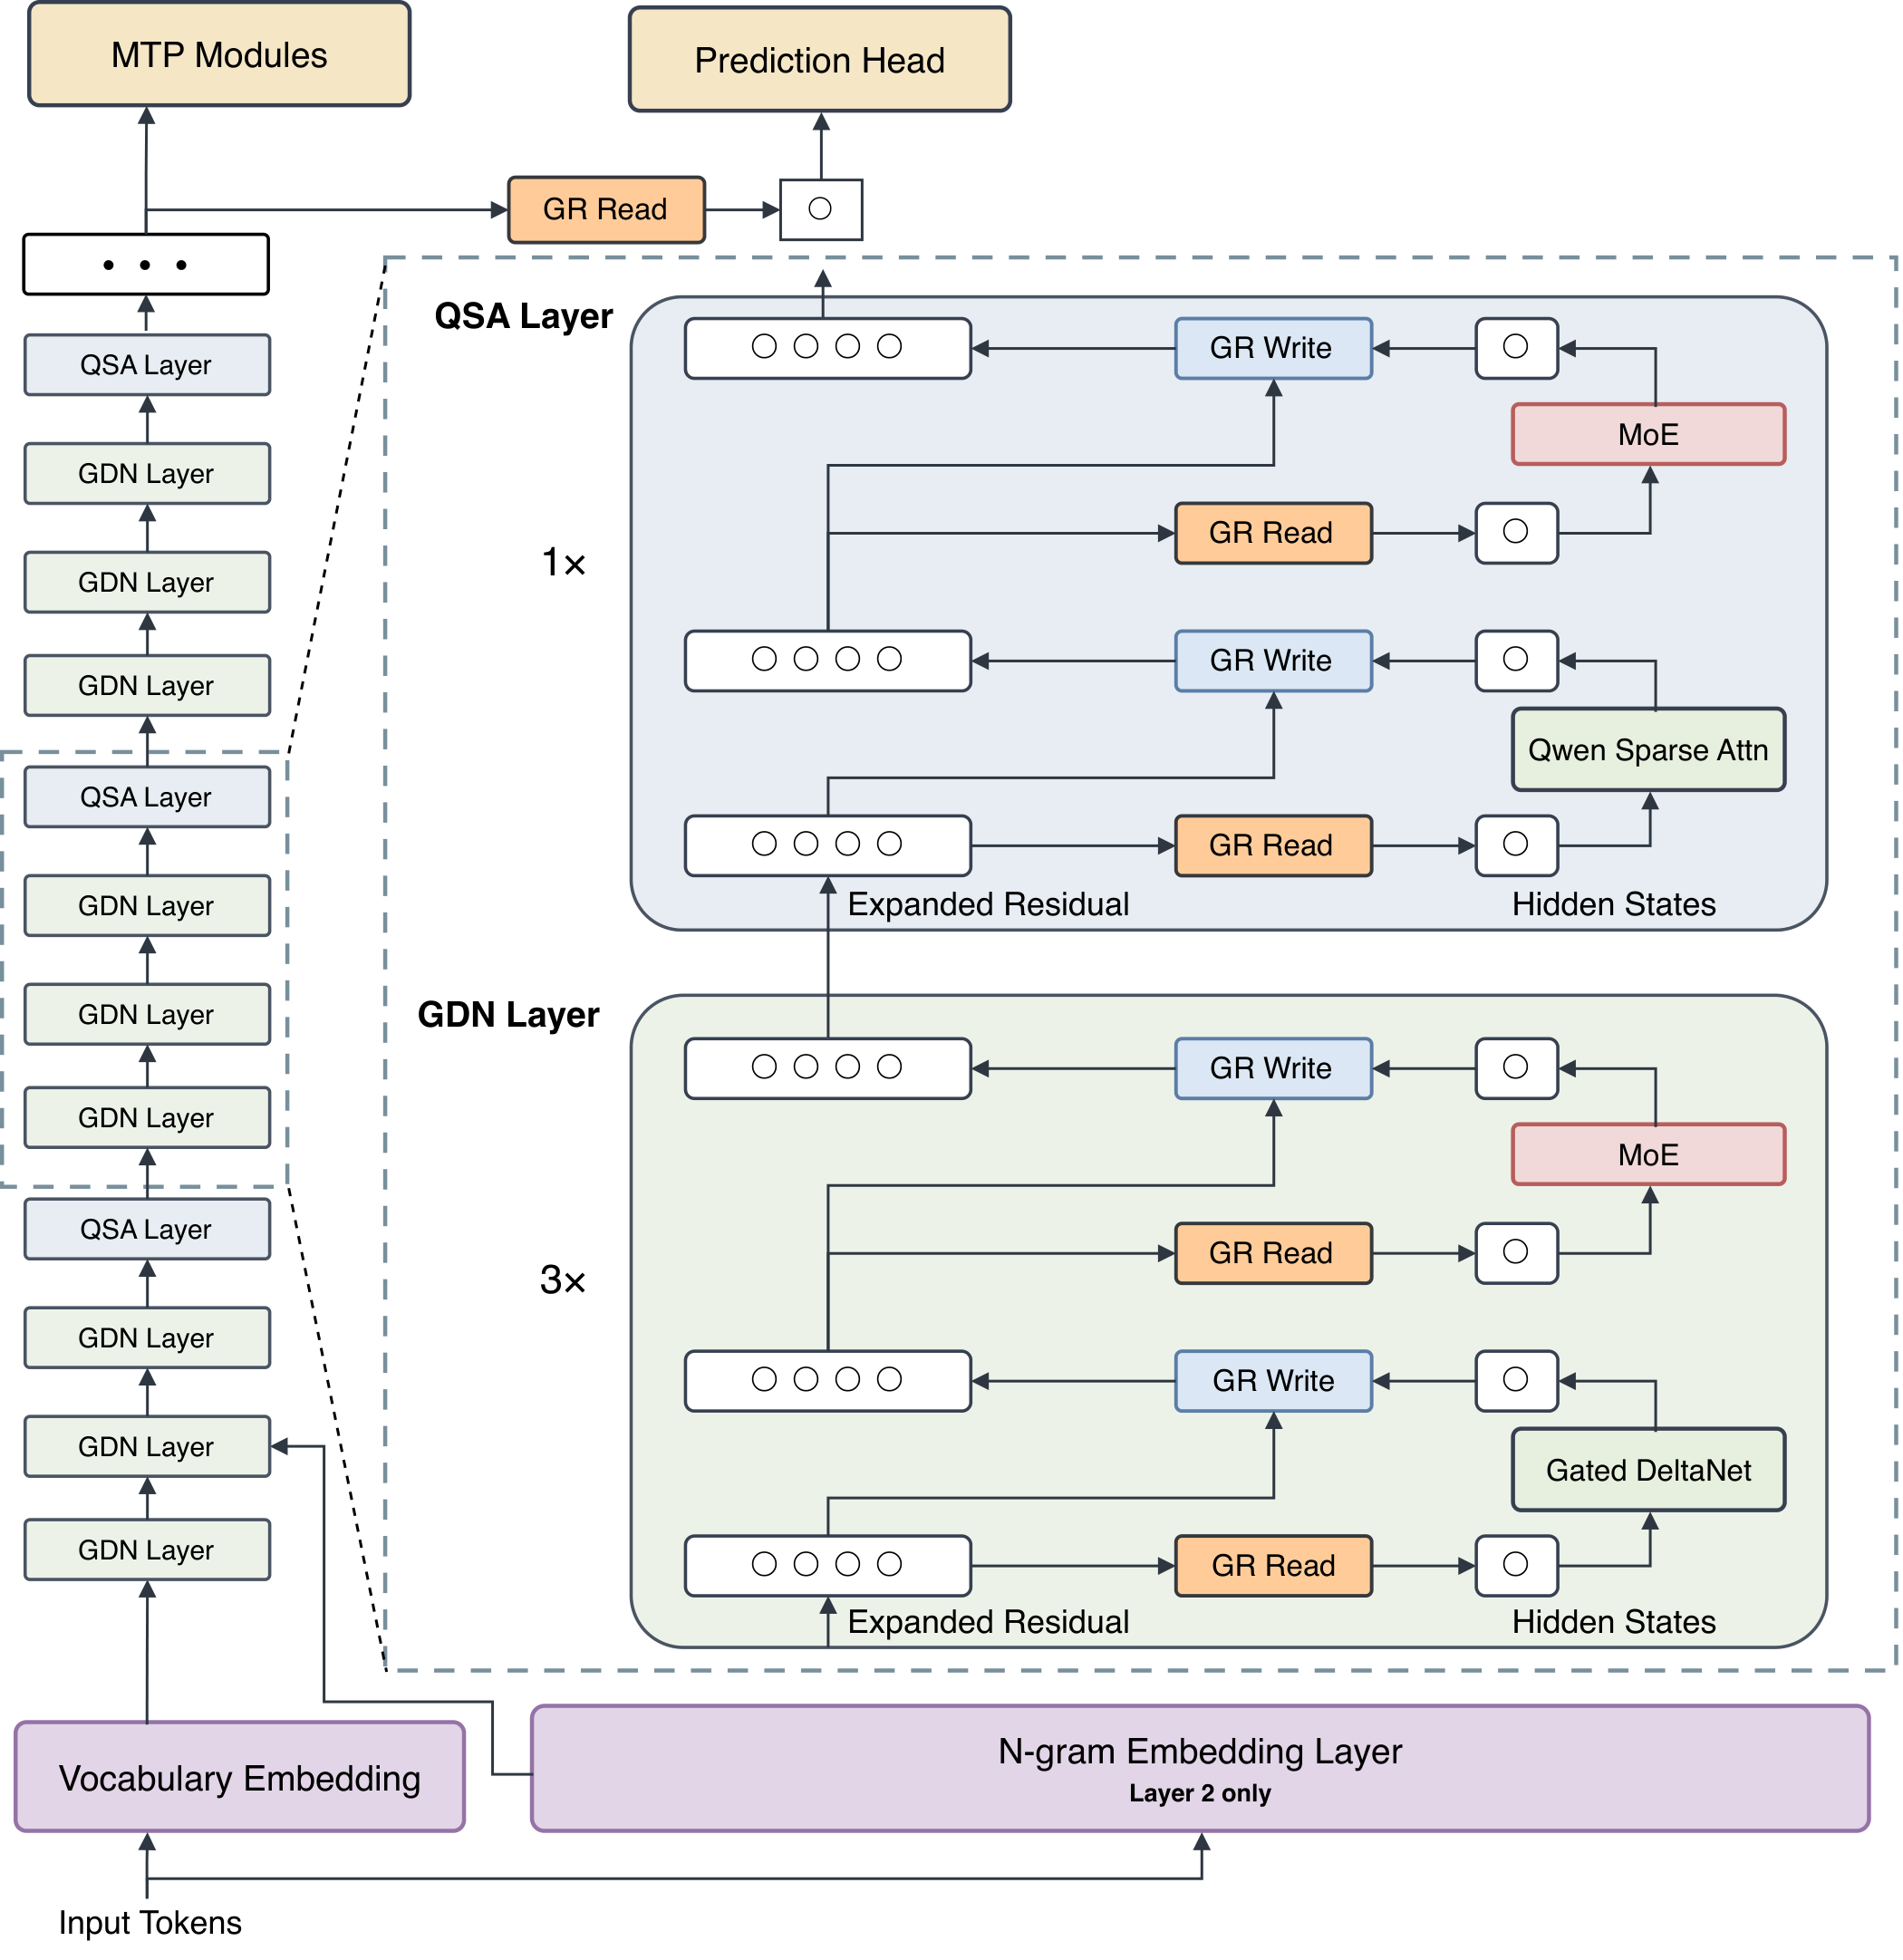
Abbildung: Die Qwen4-Max-Architektur. Zu sehen sind die drei Gated-DeltaNet-Schichten vor der QSA jeder Schicht, die die Historie in einen Zustand fester Größe komprimieren – die strukturelle Grundlage dafür, dass sich die Attention-Kosten langer Sitzungen drücken lassen. Quelle: Offizieller Qwen-Blog
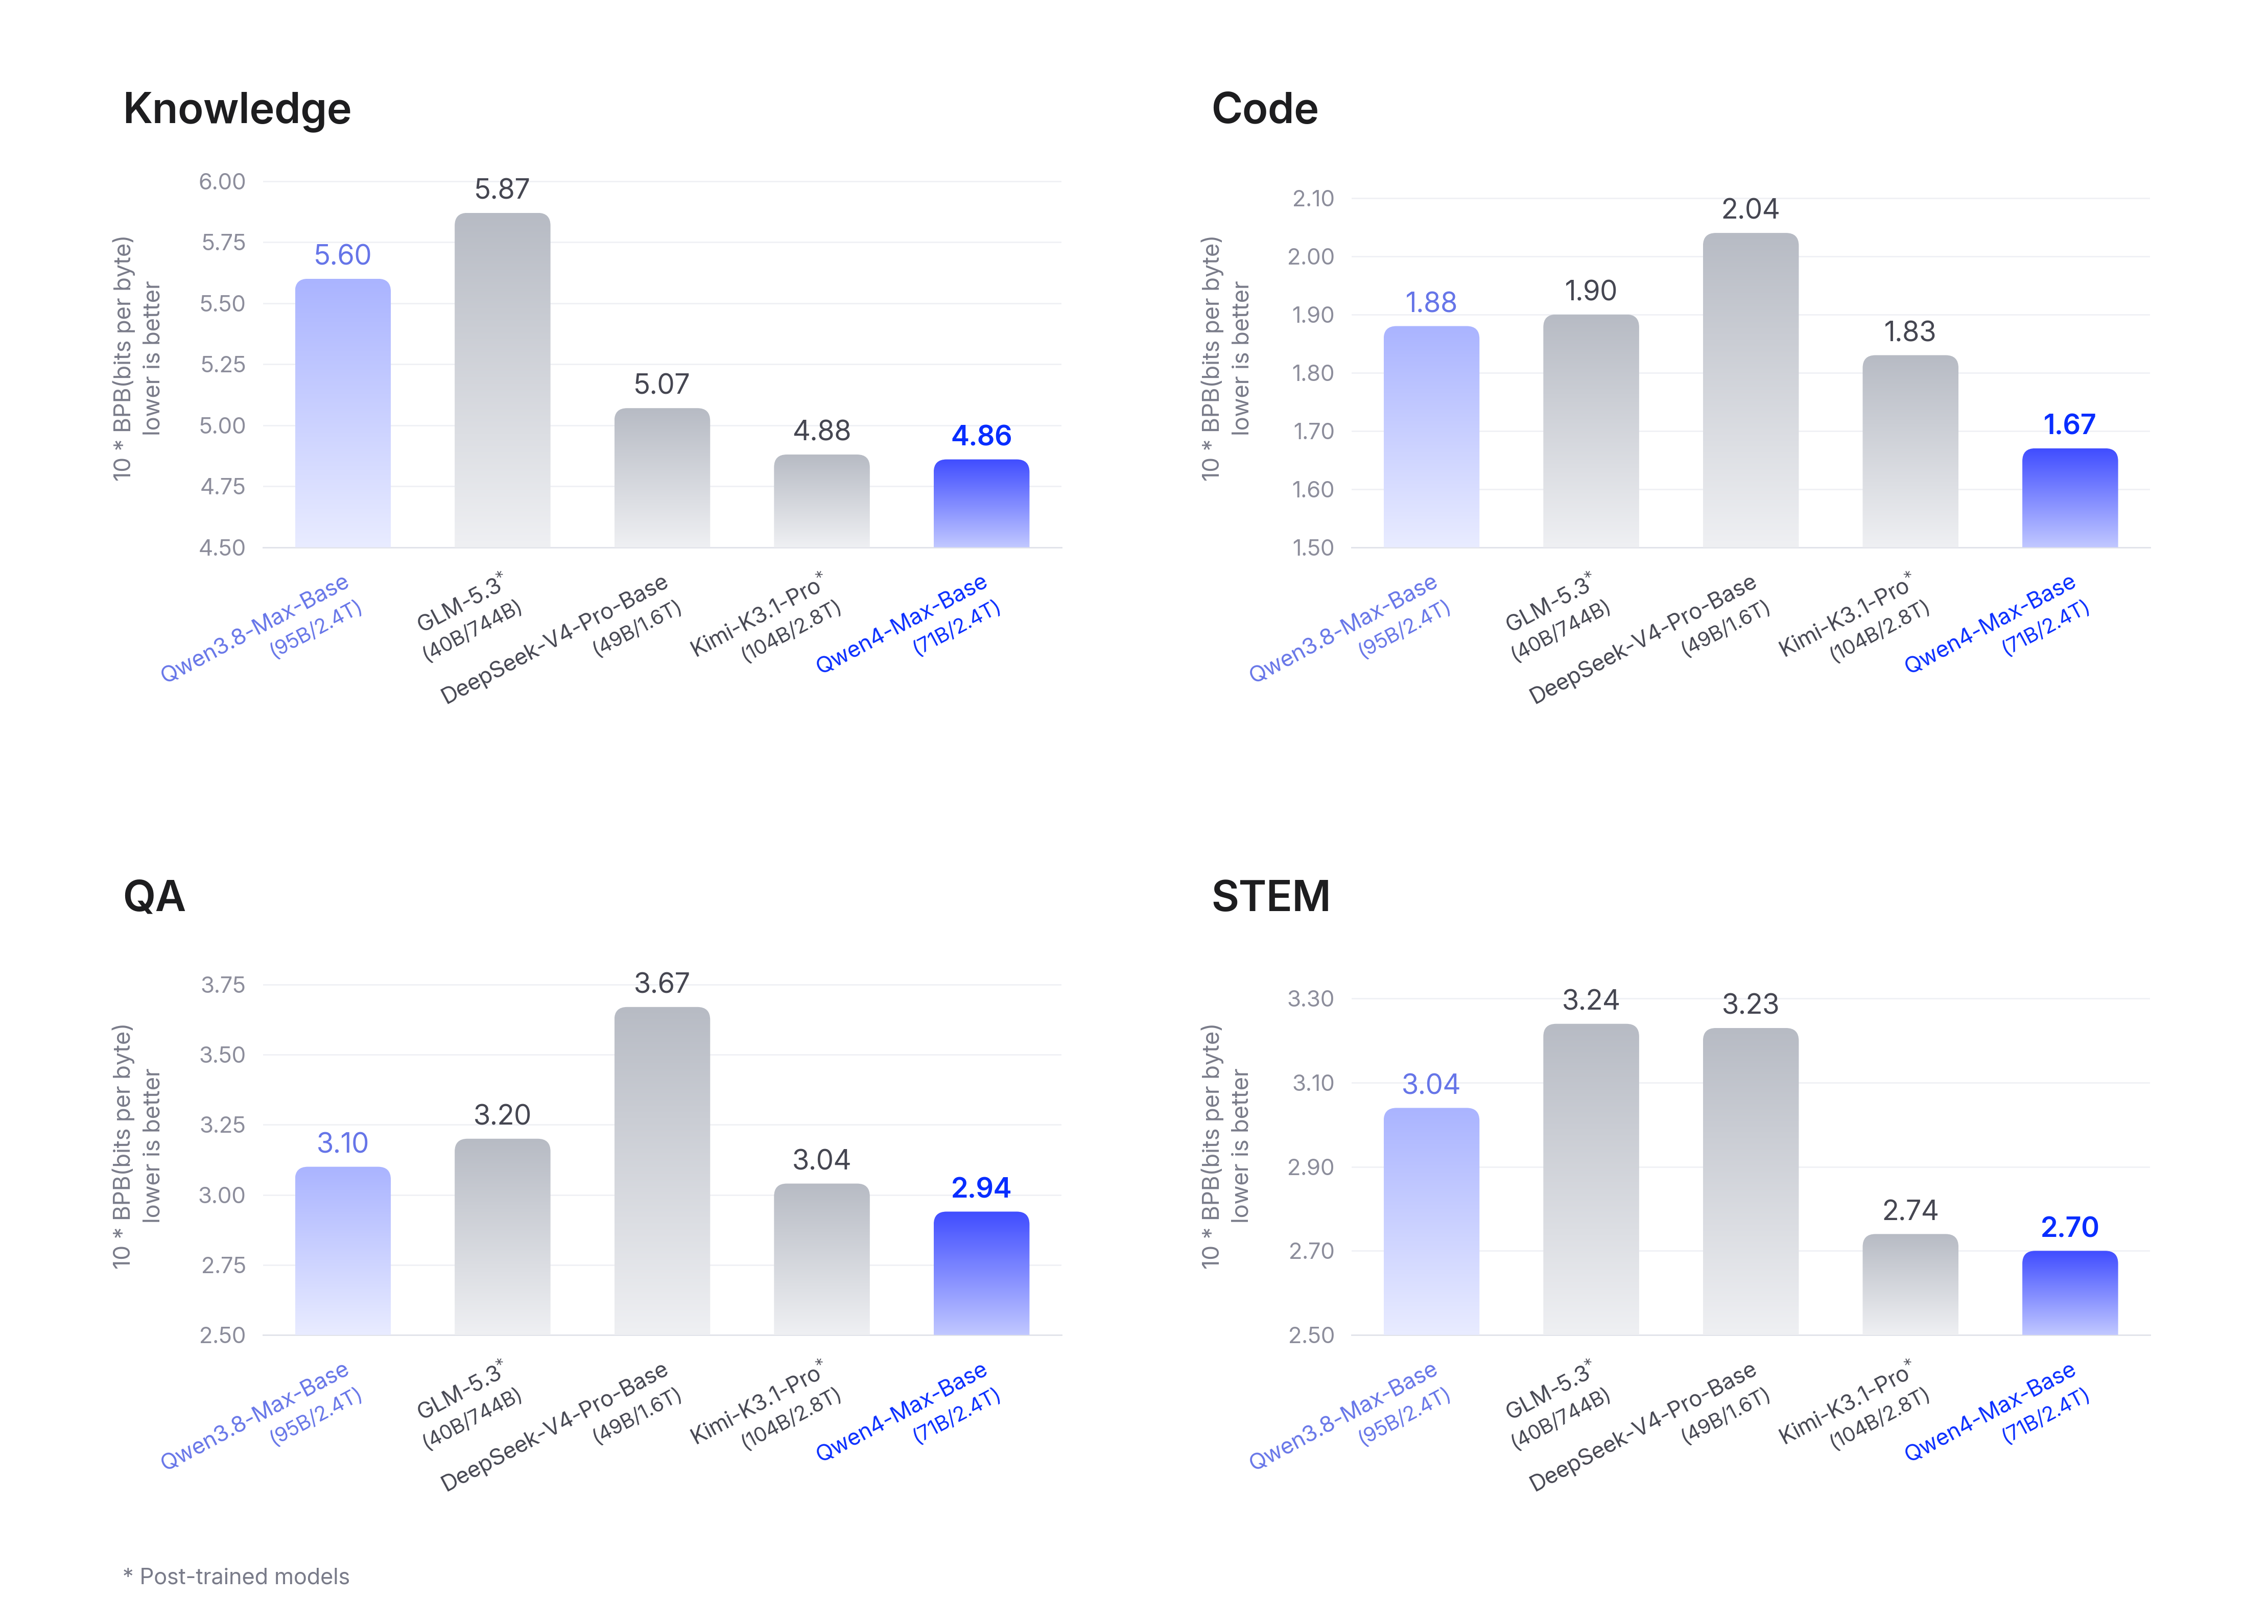
Abbildung: Die Pretraining-Evaluation nutzt 10 × BPB (niedriger ist besser). Qwen4-Max-Base ist in allen vier Domänen der niedrigste von fünf Checkpoints und aktiviert zugleich 25 Prozent weniger Parameter als der Vorgänger. Quelle: Offizieller Qwen-Blog
Der Kontext umfasst 1M Token (Standard-Eingabelimit 991K), das Ausgabelimit liegt bei 393.216 Token inklusive Chain-of-Thought, die Denkstufen reichen von none bis xhigh in fünf Stufen. Ein Ausgabelimit nahe 400.000 Token reicht, damit ein einzelner Agent-Run die komplette Kette aus Denken und Ergebnis liefern kann; die fünf Stufen sind das Drehkreuz der Kostenkontrol – dieselbe Fähigkeit, die Rechnung je nach Szenario justiert.
48 Stunden ohne menschliches Eingreifen – ein komplettes Laborprojekt
Nach der Anbindung an Miras „Deep Principle”-Wet-Lab-Plattform hat das Modell eine Materialforschungslinie 48 Stunden am Stück ohne Eingreifen durchlaufen. Der Kandidatenraum umfasste 2,7 Millionen Moleküle: zunächst Strukturfilterung, Eigenschaftsvorhersage, First-Principles-Berechnung, retrosynthetische Analyse und Experimentplanung, dann die Steuerung eines automatisierten Nasslabors für Reagenzienherstellung, Synthese, Trennung und Reinigung sowie Messung. Nach vier Zyklen aus „Design → Synthese → Test → Active Learning” stand ein experimentell verifiziertes neues Kühlmittel-Molekül fest – Zielszenario ist die Datenzentrumskühlung der nächsten Generation stromhungriger Chips.
Bei Aufgaben dieser Art liegen die Feedback-Zyklen in Tagen, die Belohnungssignale sind spärlich – bislang ließ sich das nicht an automatisierte Systeme übergeben. Gescheitert ist es an zwei Voraussetzungen: Das Modell hielt keine langfristige Konsistenz durch, und ein einzelner Fehlversuch war zu teuer. An der zweiten Voraussetzung arbeitet genau die 1,67-Dollar-Marke.
Die Zahlen aus dem Cloud-Scheduling stammen aus dem realen Geschäft von Alibaba Cloud: Die Scheduling-Kosten der Modellaufrufe in der Datenannotation sanken um durchschnittlich 10,42 Prozent, die nutzbaren Leerlaufstunden der Maschinen bei der Online-GPU-Zuteilung stiegen um 4,62 Prozent, und beim Offline-CPU-Rescheduling beschleunigte sich die Lösungsfindung bis zum Optimum um mehr als Faktor 14,61. 10,42 und 4,62 Prozent wirken klein, aber sie stammen aus echten Geschäftsunterlagen: Das Modell optimiert das System, das es selbst trainiert, und die eingesparten Gelder fließen direkt in Alibis Bilanz. Die 14,61-fache Lösungsbeschleunigung entspricht den Erwartungen – Constraints schreiben und Solver tunen sind ohnehin der Komfortbereich von LLMs.
Die Fehlversuchsdichte in der Wirkstoffforschung ist noch höher: Auf der PharmMaster-Plattform von DP Technology lief ein End-to-End-Projekt zum NLRP3-Inflammasom im Kontext der Alzheimer-Krankheit mit 454 Tool-Aufrufen, 3.239 berechneten Metrik-Evaluationen und 24 Kandidatenmolekülen. Das bevorzugte Molekül erreichte eine geschätzte relative Bindungsfreienergie (RBFE) von rund dem 3,6-fachen des Referenzmoleküls und gilt als validierungswürdig für Nassexperimente. 454 Entscheidungsstellen an Versuchen – unter der alten Kostenstruktur wäre das Budget dieser Forschungslinie schon im Genehmigungsstadium gescheitert.
Die Veröffentlichung listet zudem eine Reihe von Branchenlieferungen: Bei SANF und Pacific Union sank der Personalaufwand für die Programmierung eines Einzelwerkstücks auf realen Fertigungslinien von knapp 8 Stunden auf 24 Minuten, rund 95 Prozent weniger; 198 chaotisch benannte Rechtsquellendokumente wurden in 14 Ordner einsortiert, mit einem 86-seitigen Bericht über 12 Prüfgebiete, in dem jede Schlussfolgerung bis zum konkreten Quelldokument zurückverfolgbar ist; ein intensivmedizinischer Fall mit 1.433 Rohbildern und zehntausenden Worten Verlaufsdokumentation wurde in einer einzigen Konversation vom Extrahieren bis zur Entscheidungsunterstützung durchlaufen. Der gemeinsame Nenner: klare Abnahmekriterien. Ein Bericht, ein lauffähiges Programm, Produktionsliniencode – nur wenn das Ergebnis prüfbar ist, darf ein Agent in den Produktionsablauf.
Listenplatz eins lautet „offizielle Daten” – die Preisliste nicht
In der von DataLearner erfassten Rangliste belegt Qwen4-Max Platz eins bei Agents’ Last Exam v1.1 (46,70, Platz 1/26), BioMysteryBench (85, Platz 1/26), AutomationBench-AA (72,50, Platz 1/4) und Code Arena WebDev (1750, Platz 1/4). Die Datenquellen sind im Wesentlichen Diagramme aus dem offiziellen Blog; unabhängige Ranglisten wie Artificial Analysis oder LMArena haben das Modell noch nicht erfasst. Work360 ist ein firmeneigenes Framework, alle Fallvideos stammen vom Hersteller. Eigene Benchmarks plus Rangplätze aus offiziellen Diagrammen – diese Beweiskette ist mit Abschlag zu lesen.
Die Preise brauchen keinen Abschlag. Auf der chinesischen Plattform kosten Eingabe 10 und Ausgabe 30 Yuan pro Million Token, international 1,50 bzw. 4,50 Dollar, Cache-Treffer 0,075 Dollar. Die Preisliste steht auf der Plattform – das ist ein vertragliches Faktum, da gibt es keinen methodischen Spielraum.
Auch die Wettbewerbsgrenze muss man benennen: In komplexer Terminal-Engineering- und Black-Box-Reproduktion behalten Kimi K3.1 und Opus 5.5 einen deutlichen Punktvorsprung. Qwen4-Max erreicht in Terminal-Bench 4.0 nur 48,48 Punkte (Platz 13/58) und Platz 15/120 in Vibe Code Bench v1.1. Sein Preis-Leistungs-Vorteil konzentriert sich auf Szenarien mit hoher Cache-Wiederverwendung, langem multimodalem Bürokontext sowie Rechts- und Bioinformatik-Agenten – die harte Nuss Terminal hat es noch nicht geknackt.
Die lebhafteste Community-Diskussion am Veröffentlichungstag drehte sich um den Zeichentest „pelican riding a bicycle”. Simon Willison führte ihn über alle vier Stufen none/low/high/xhigh aus; in den Kommentaren wurde bezweifelt, dass solche Tests längst im Trainingsset stecken. Am Veröffentlichungstag eines neuen Modells sind brauchbare unabhängige Signale praktisch null – ein generelles Dilemma der Evaluationslandschaft, und Qwen4-Max ist nur das jüngste Beispiel.
Flaggschiff geschlossen, Open Source erst in kleinen Größen
Qwen4-Max kommt ohne offene Gewichte, nur als Closed-Source-API und Plattformdienst, mit Schnittstellenkompatibilität zu beiden Formaten von OpenAI und Anthropic. Offiziell ist angekündigt, dass die kleinen Modelle der Qwen4-Serie mit derselben Technologie trainiert und schrittweise als Open Source veröffentlicht werden – für das Max-Flaggschiff gibt es kein Versprechen. Wer privat deployen will, muss in dieser Generation weiter auf die offenen Gewichte von Qwen3.8-Max zurückgreifen. Das geschlossene Flaggschiff sichert die kommerziellen Einnahmen, die offenen kleinen Modelle pflegen das Ökosystem – dieses Muster beherrscht Alibaba längst.
Sichere Codegenerierung ist eine leicht übersehene Kennzahl: Auf dem Last Secure Code Bench stieg der funktionsbezogene Anteil, der Funktionalität und Sicherheit gleichzeitig besteht, von 22,0 auf 31,8 Prozent; der Anteil gleichzeitiger sicherer Generierung auf den drei Granularitäten Funktion, Datei und Repository stieg von 8 auf 14,7 Prozent – nahezu verdoppelt. Absolut bleibt die Zahl niedrig: Unter 15 Prozent gleichzeitiger sicherer Generierung auf drei Ebenen heißt, bei sicherheitskritischem Agent-Code ist die menschliche Review-Zeile nicht verzichtbar. Die Steigung von 8 auf 14,7 Prozent zeigt aber in die richtige Richtung; zudem hat der Hersteller offensive Cybersecurity-Daten aus dem Trainingsset entfernt und nur defensive Aufgaben behalten.
Rückblickend ist bei dieser Veröffentlichung der geschaltete Schalter die Kostenkurve: 1,67 Dollar liegen in der Preisspanne, in der Unternehmen für einen einzelnen Aufgabenversuch bereit sind zu zahlen; 4,43 Dollar liegen nicht darin. Bei den Listenpunkten darf man bezweifeln, dass sie aus offiziellen Diagrammen stammen, die Fallvideos darf man als Inszenierung verdächtigen – die Zahlen auf der Preisliste lassen keinen Streit zu. Qwen4-Max hat im Terminal-Engineering gegen Kimi K3.1 und Opus 5.5 noch nicht gewonnen; gewonnen hat es, dass langlaufende Agenten erstmals nach Produktionsbudget eingeplant und in den Tagesablauf übernommen werden können. Bei der nächsten Flaggschiff-Veröffentlichung dürfte die Parametergröße wohl in der zweiten Zeile stehen – die Kostenkurve hat diese Position bereits übernommen.
Referenzen:
- Offizieller Qwen-Blog: Veröffentlichungsankündigung zu Qwen4-Max
- DataLearner: Erfassungsseite des Modells in der Rangliste
- Simon Willison: Protokoll des Zeichentests über vier Denkstufen