输出价格除以 9,每任务成本除以 20
2026 年 11 月 16 日,腾讯混元发布 Hy4 flash。官方 API 价目表上,输出每百万 token 0.281 美元,上一代 Hy4 收 2.501 美元,输出价差约 8.9 倍;命中缓存的输入价差拉到 14 倍,0.003 美元对 0.042 美元。真正扎眼的数字藏在官方内部基准 WorkIndex 里:干同样的活,Hy4 flash 的平均每任务成本是 Hy4 的 1/20。
 图:Hy4 flash 发布页头图。来源:腾讯混元
大模型「降价」发布会过去两年见得多了,把「每任务成本」砍到二十分之一是头一回。token 是模型计费的最小单位,大约对应一个字或半个词,一个真实任务动辄消耗几十万 token。单价打折、任务变啰嗦,账单照样涨——腾讯这次干脆把比较的尺子从单价换成了任务,尺子一换,排名跟着换。
价格打到这个深度,靠发布会上的促销姿态撑不住,只能从模型和推理栈里一层层省。Hy4 flash 的省钱方案分三层:架构、推理工程、后训练。下面挨个拆。
按 token 标价,按任务付钱
WorkIndex 是腾讯自建的评测集,8 个项目全是能按件计费的具体活:做 PPT、改 PPT、人机共写 PPT、人机共写 Markdown、文档编辑、修电子表格、音视频处理、视觉理解。官方数据下,Hy4 flash 综合任务表现略高于 Hy4 preview,平均每任务成本是 Hy4 preview 的 1/13、Hy4 的 1/20,也是 DeepSeek-V4.1-Flash-1017 的 1/8(后者按 Max 档、高峰时段价格计)。
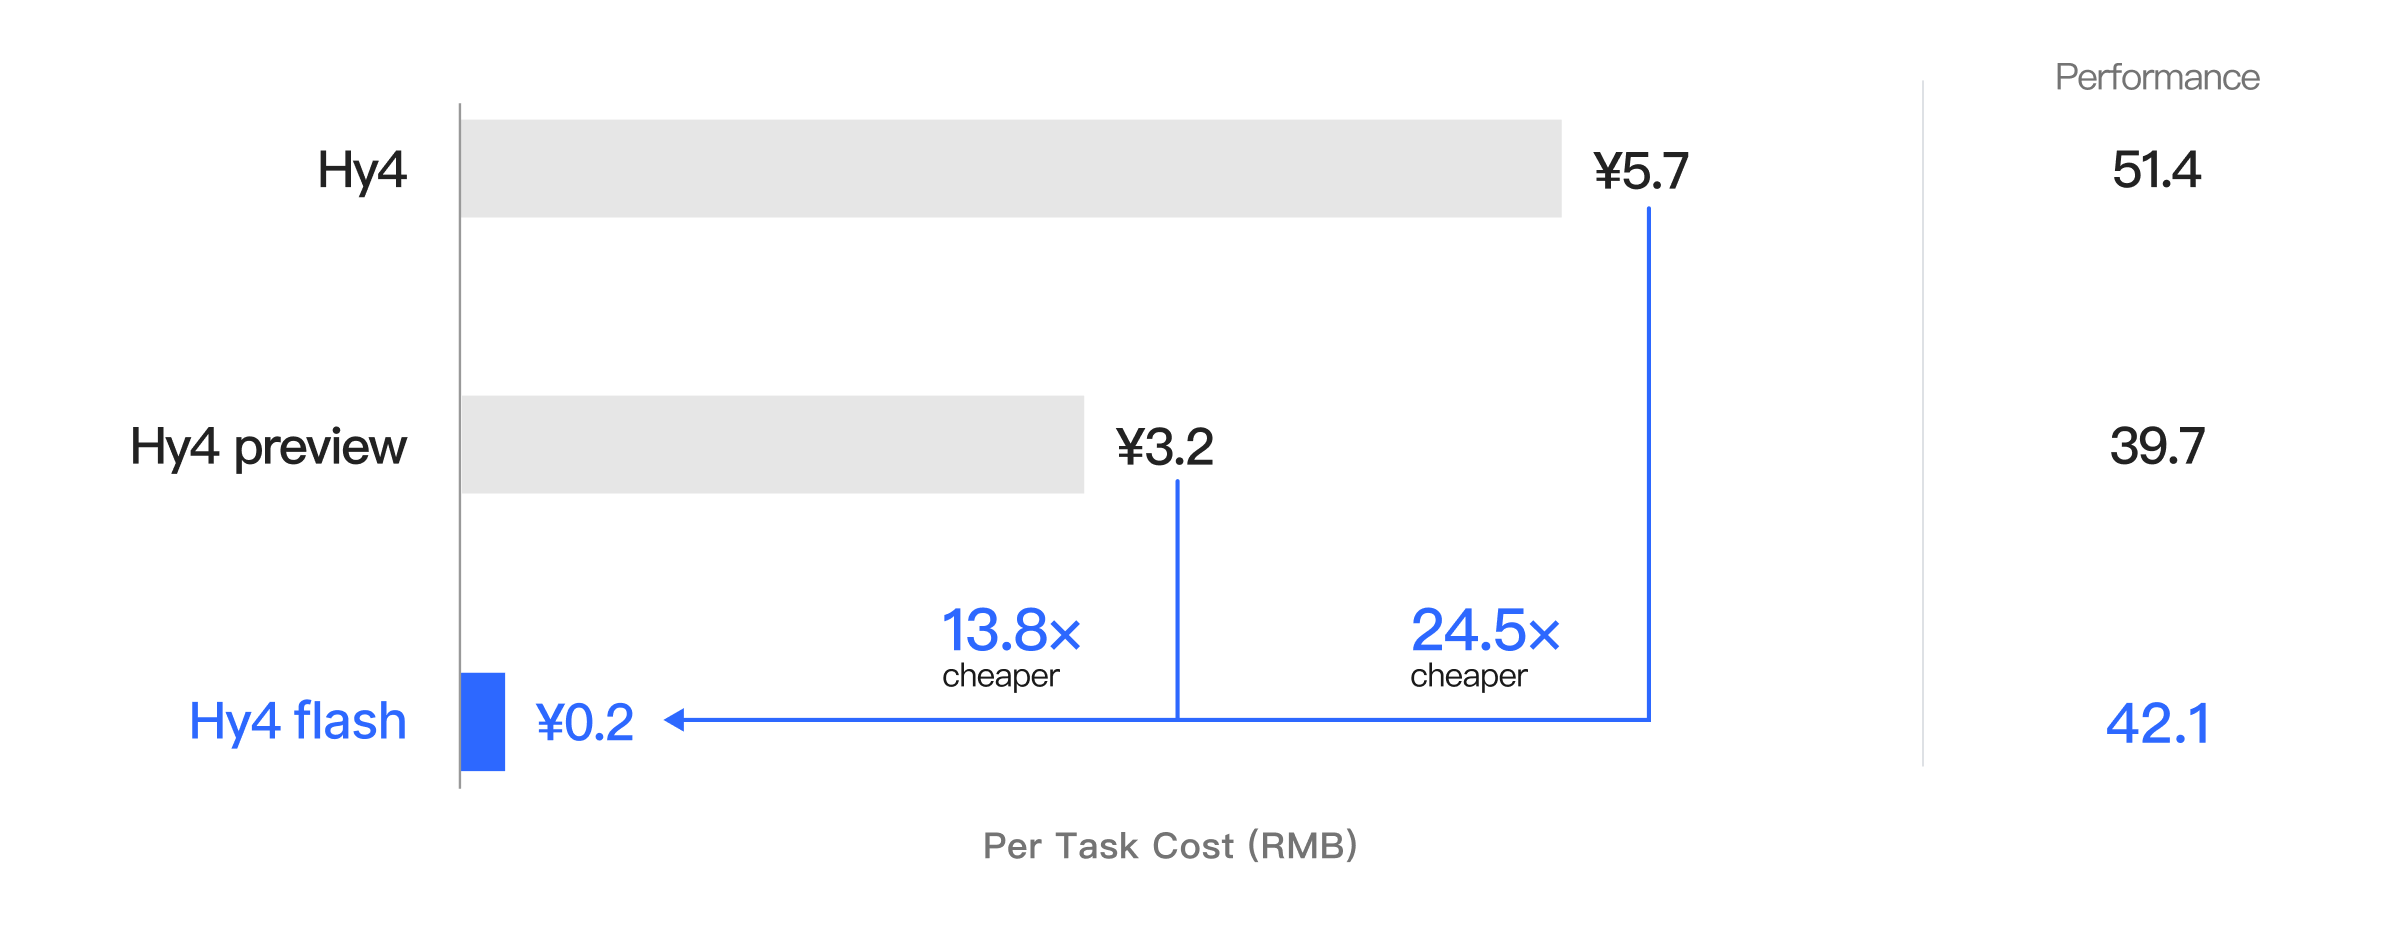 图:官方 Figure 1:内部 WorkIndex 8 个评测集与 7 项公开 agent 基准上的性能—成本分布。注意横轴是成本,不是分数。来源:腾讯混元
这组对比的读法写在图注里:分数几乎持平,成本掉到 1/8 到 1/20 之间。腾讯把成本画成了主轴,这张图摆出来的姿态本身就是表态——模型好不好用,先问贵不贵。各家公开榜单的分数咬得越紧,能拉开差距的变量就越往账单一栏挪。
省钱第一刀:KV cache 缩到 1/24
先讲 KV cache(Key-Value Cache,键值缓存)是什么。模型每读一段长文档,都要给自己记一套笔记——每个字和前文的关系,这套笔记就是 KV cache。笔记越厚,占的显存越大,每次生成要翻的页数越多,账单越贵;长上下文任务的成本大头就压在这本笔记上。
Hy4 flash 用混合注意力(不同段落用不同档次的注意力计算,简单活省着算)、LatentMoE(专家混合架构,模型大部分参数平时待命、按需启用)、Engram 三个架构件叠加,官方数据是 KV cache 缩到 Hy3 的 1/24、Hy4 的 1/6。笔记薄到原来的零头,1M token 的上下文窗口才养得起——百万字文档丢进去,显存不爆,价格才敢往下走。缓存输入 0.003 美元的定价是同一件事的另一面:重复的上下文不用重算,要存的笔记只有原来的几十分之一,存储成本跟着一起缩。
MoE 省的是算力:224B 总参数(其中 64B 是 Engram 模块的参数),每个 token 只激活 12B。一个大厅里 224 个员工待命,每个字进门只叫 12 个人干活,其余的不领工资。算力按需点兵,闲置参数不烧电,这是单价能压低的架构地基。
跑得快,再说得短
架构省的是存储,推理工程省的是时间。Hy4 flash 的推理栈三件套:megakernel(把整个解码循环压进一个高度融合的 GPU 程序,砍掉模块之间来回搬运的等待)、4bit 量化(模型参数从高精度数字压成 4 位存储,省显存省带宽)、DFly 调度,官方口径解码速度推到 150 token/s 以上。便宜的前提是快:同一张卡每秒吐出的 token 越多,每个 token 摊到的机器时间就越少,低价才不会亏本。
后训练省的是 token 本身。Hy4 flash 先从上一代 Hy4 自蒸馏——让大模型当老师,把通用能力教给新模型——再用强化学习训练它把话说明白但少说。官方数据:平均端到端输出 token 砍掉 50%。输出是三档价格里最贵的一档(0.281 对 0.070 美元),话说一半,账单先省一半,三层里这一层最直接。
三层乘起来才凑得出 1/20:架构把存储成本压到零头,推理把机器时间摊薄,后训练把最贵的输出砍半。任何单层单独拿出来都够不着一个数量级的价差。便宜是设计出来的,促销价是标出来的——前者能写进模型的架构,后者只能写进宣传页。
数字全来自官方,怎么读
先把数据来源说透:上面所有数字都出自腾讯官方口径,WorkIndex 是内部基准,评测集自己挑、对照组自己选,第三方目前无法复现。官方自评的成绩单,天然带着利于自己的偏差,要打折听。
但有几处交叉信号能对上。盲测一组:85 名内部 WorkBuddy 用户、259 个任务、27 个类别,Hy4 flash 满意度接近 Claude Haiku 5.5,端到端完成时间最短,每任务成本显著低于所有对照模型。业务侧几条线各自独立:办公助手 WorkBuddy 里平均任务耗时降 70%、成本约 Hy4 的 1/15;企业微信助手「大元」输出比 Hy4 快 88%,思考模式输出 token 少约 60%;QQ 的「小 Q」在音乐推荐、频道互动、Qzone、长文星座分析上满意度分别提升 6.16、2.84、0.92、2.22 个百分点;元宝的 agent 表现比 Hy3 提升 13.6%。
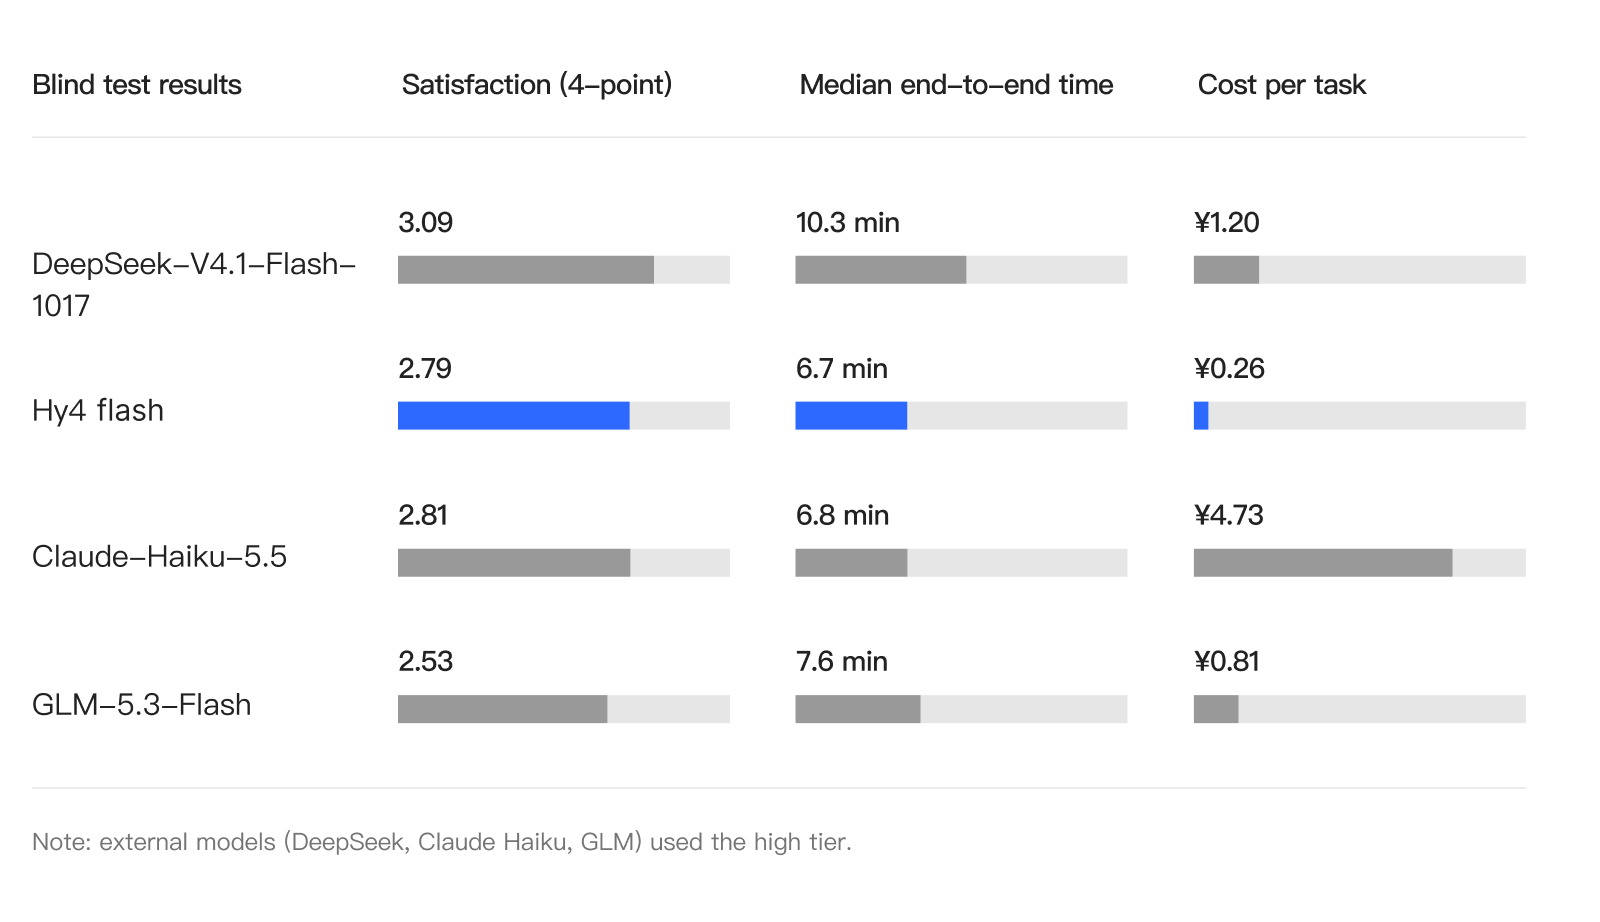 图:85 名 WorkBuddy 用户、259 个任务、27 个类别的盲测结果。满意度接近 Haiku 5.5,完成时间最短。来源:腾讯混元
内部基准可以挑,几个互不相干的业务场景一起变好就难挑。办公助手、社交机器人、agent 三条线方向一致,至少能看出这套省钱架构在真实产品里没有翻车。准确数字等第三方复现,方向可以先采信。
前沿竞赛换了计分板
腾讯在发布页里把边界画得清楚:日常生产力任务——深搜、文档处理、做幻灯片、简单前端 demo、computer use(让模型自己操作电脑界面完成任务)——推荐 Hy4 flash;长时程软件工程仍推荐 Hy4,理由是智力上限更高。两代并存,flash 赢账单,Hy4 赢上限,谁也没替代谁。
落地渠道已经铺开:腾讯云 TokenHub、WorkBuddy、元宝、企业微信、QQ、ima、Marvis,OpenRouter 即将上线;11 月 30 日前 WorkBuddy 免费、TokenHub API 五折。权重开源在计划之中,开源之后,这套「KV cache 缩到 1/24 + megakernel + 输出砍半」的组合有多少人跟进复用,才是检验它含金量的真考场。
回到开头那个数字。模型智商互相追平的时候,每任务成本是还能拉开数量级的变量;Hy4 flash 的便宜靠架构、推理工程、后训练一层层抠出来,通用能力没跟着掉,所以这份便宜写进了模型和推理栈,别人抄得走也挡不住。下一场前沿竞赛的计分板上有两栏:一栏记分数,一栏记账单——比谁更聪明比不出差距之后,比谁更便宜才刚刚开场。
参考链接:
- 腾讯混元 Hy4 flash 官方发布页