100万トークン(1M)の入力が100万トークンあたり通常1ドル、キャッシュ読み出しならわずか0.05ドル。しかも開発者の手元にあるのは、1Mコンテキストと総パラメータ600Bを誇る巨大な基盤モデルだ。2026年10月8日、中国のAI企業・StepFun(階躍星辰)は「Step 5 Preview」のAPI提供を開始し、近日中にオープンウェイト(モデル重み)を公開すると発表した。この動きは、LLMの性能競争の焦点を力づくでシステムエンジニアリングとコスト採算性の議論へと引き戻した。疎(スパース)なアーキテクチャによって総パラメータ数が計算コストから切り離された今、活性化パラメータ比率とキャッシュヒット率こそが新たな評価軸になりつつある。Step 5が示したメッセージは明快だ。オープンソースモデルの低価格はもはや「性能妥協の言い訳」ではなく、緻密に計算されたアーキテクチャ設計によって勝ち取られたハードウェア効率の指標である。同モデルは単発のコード生成タスクで圧倒的な瞬発力を発揮する一方で、長大なマルチステップ実行においては明確な技術的ボトルネックを露呈した。コストの限界線は押し広げられたが、長距離自律エージェントの壁は依然として立ちはだかっている。
600Bの巨大基盤モデルで活性化パラメータを27Bに抑制
Step 5 Preview の中核をなすエンジニアリングレバレッジは、その巨大なスパース MoE(Mixture of Experts)アーキテクチャに築かれている。600Bもの総パラメータは広範な世界知識を蓄積するが、推論時に個々のトークンを処理する際、モデルが実際に活性化させる計算パスはわずか27Bにすぎない。これにより、モデル開発の軍備競争の重心は総規模の拡大から活性化比率の極限までの圧縮へとシフトした。わずか4.5%という極めて低い活性化率は、圧倒的な生成速度と計算リソースの大幅な削減を同時にもたらした。
OpenRouter の3日間の統計データによると、Step 5 のスループット中央値(P50)は 81 tok/s に達し、長大ウィンドウにおけるピーク時(P99)は 163 tok/s にも及ぶ。1Mトークンという超長大コンテキストを実用化するには、それを素早く埋め尽くす力任せの生成速度が不可欠であり、この27Bという活性化パラメータは高並行な読み書きスループットを担保するために削ぎ落とされたものだ。さらに、Step 5 はテキスト、画像、動画のマルチモーダル入力をネイティブでサポートし、最大64Kトークンの出力を処理できる。公式発表の散布図は、同等のベンチマークスコアを獲得するにあたり、Step 5 の消費計算リソースが同クラスの競合製品よりはるかに少ないことを明確に示している。
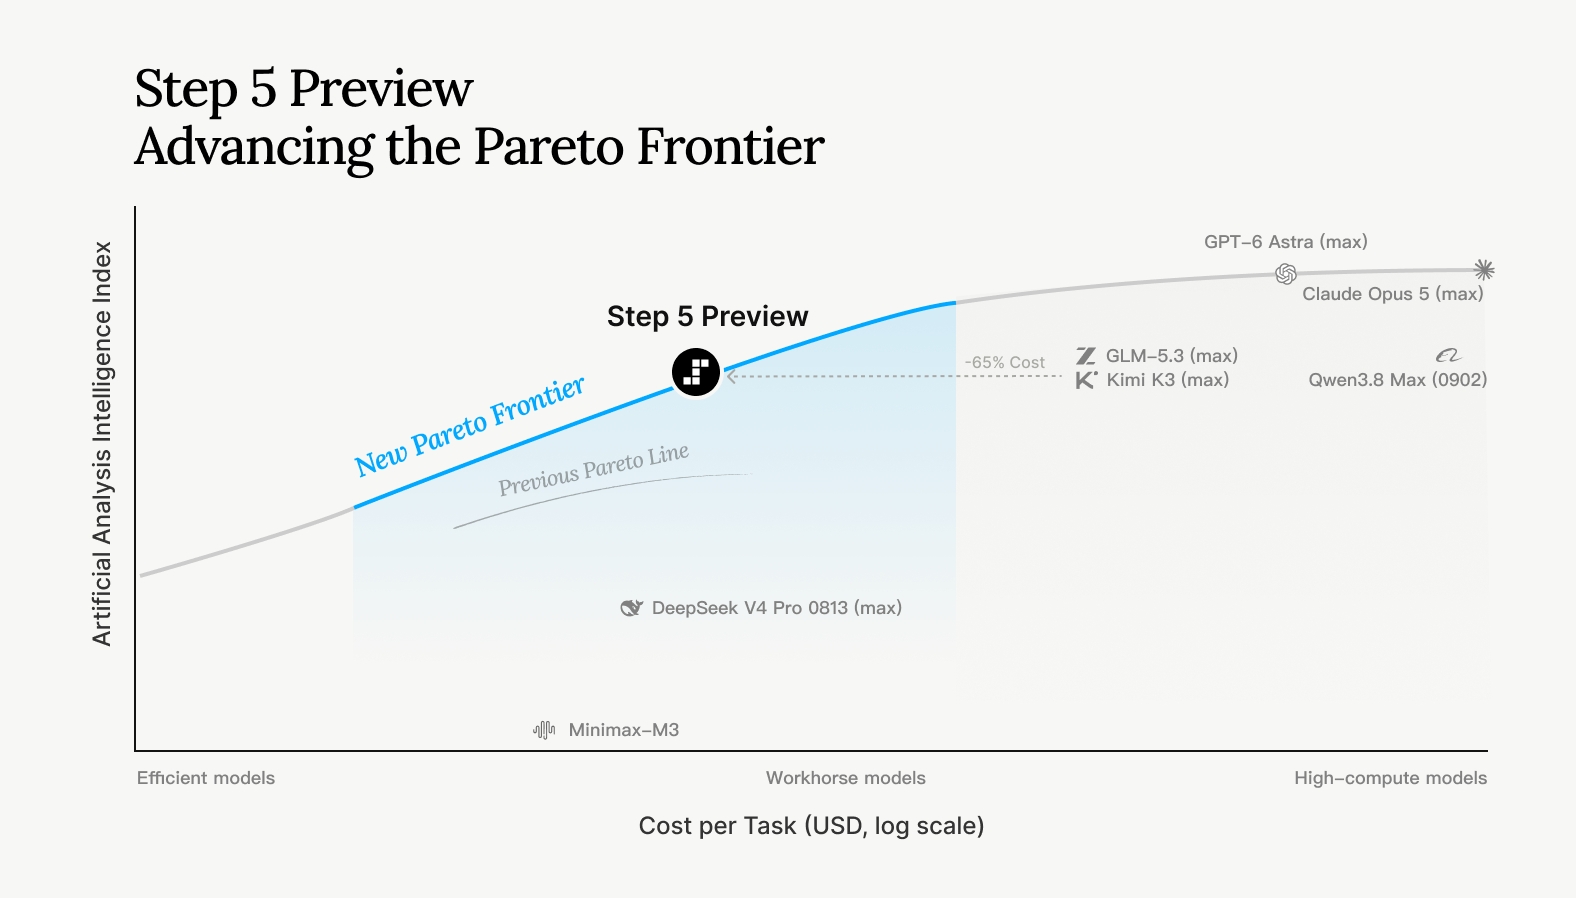 図:公式発表の「知能水準 vs タスク別コスト」散布図。同等の知能帯におけるStep 5のコスト優位性を示す。出典:StepFun公式リリース
この600Bという巨躯は、そもそも個人のローカル環境でオフライン動作させることを想定して作られたものではない。Hacker News 上のエンジニアたちも鋭く指摘しているように、この規模の静的重みはハイエンドワークステーションに一般的な128GBの統合メモリには到底収まらない。クラウドの大規模クラスタを前提とし、徹底したスパース化によってサーバー側のハードウェアコストを希釈する設計思想そのものが、クラウドネイティブAPIに特化した割り切りの産物である。
95.1%のキャッシュヒット率が公称単価を突き崩す
OpenRouter の公式リストにおいて、Step 5 の定価は入力100万トークンあたり1ドル、出力2.70ドルに設定されている。この数値単体を見れば、熾烈を極める近年のAPI価格競争の中では平均的な水準にすぎない。しかし、このモデルの真の破壊力は95.1%に達するキャッシュヒット率にあり、これによってキャッシュ読み出し単価はわずか0.05ドルへと急落する。キャッシュ機構を度外視して1MコンテキストのAPI価格を議論することに意味はない。頻繁に再利用されるシステムプロンプトや膨大なドキュメント背景は、実効請求額を極限まで押し下げる。
OpenRouter プラットフォームの3日間のモニタリング集計によれば、キャッシュ機構が効いた状態での実効加重平均入力価格は、100万トークンあたりわずか0.0966ドルにすぎない。プロンプトがサーバー側のキャッシュに維持されている限り、開発者は最先端マルチモーダルモデルの推論能力を、数百億パラメータ級の小規模モデルと同等の破格のコストで利用できる。StepFun は本モデルを自律型エージェント(agentic work)向けのフラッグシップと位置づけており、デモでは寝室の写真1枚から直接編集可能な3D空間を構築する「Room Planner」機能を披露した。
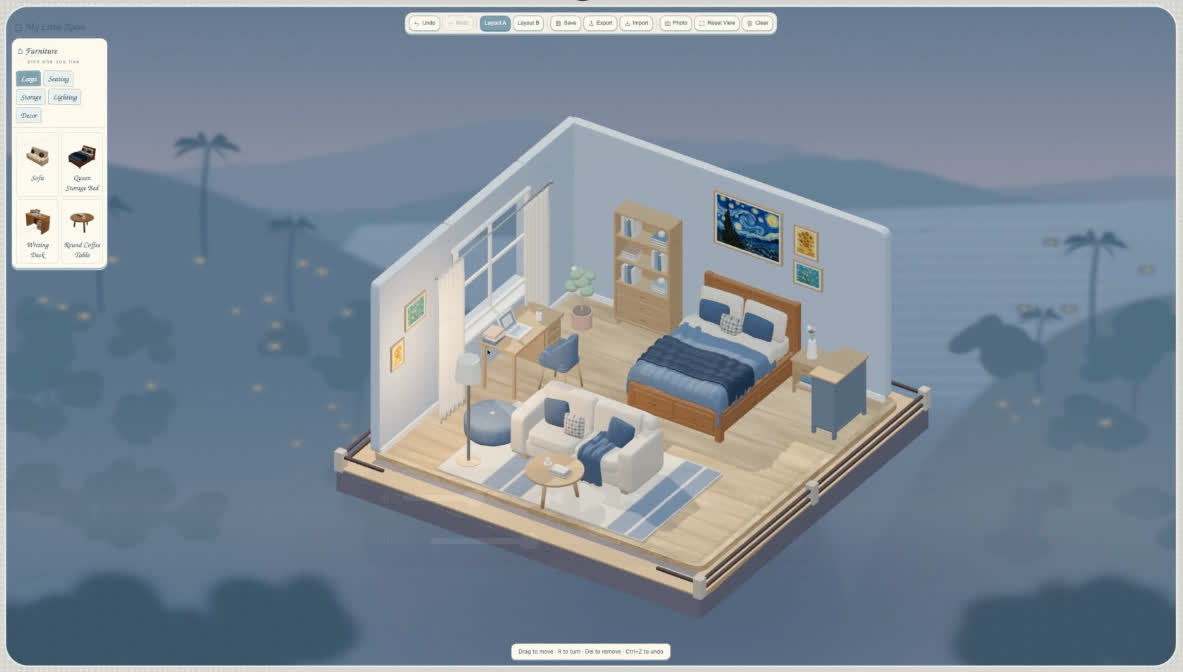 図:寝室の写真1枚から編集可能な3D空間を構築する公式デモ「Room Planner」。出典:StepFun公式リリース
画像状態を繰り返し入力しながら生成結果を微調整していくようなワークフローにおいて、長大コンテキストのキャッシュはシステムの応答速度を維持しつつコストを抑え込む唯一の現実解となる。この課金構造の非対称性は、「高機能=高価格」という従来の常識を揺るがす。高いキャッシュヒット率は入力処理フェーズにおける計算負荷を効果的に相殺し、モデルプロバイダーが極めて低い限界費用でサービスを提供することを可能にした。この経済的優位性が、10月15日のオープンウェイト公開という決断を後押ししている。
DeepSWEで競合を凌駕:単発タスクで見せたフロンティア級の瞬発力
コード生成や静的なバグ修正タスクにおいて、Step 5 は極めて鋭い瞬発力を発揮した。ソフトウェアエンジニアリング評価ベンチマーク「DeepSWE v1.1」において、同モデルは67.7点を記録し、同じオープンウェイト陣営の Kimi K3 Max(67.5点)や GLM-5.3 Max(66.9点)を僅差で上回った。また、StepFun 独自の StepCodeBench では49.0点を叩き出し、Kimi の43.9点や GLM の40.2点を大きく引き離している。
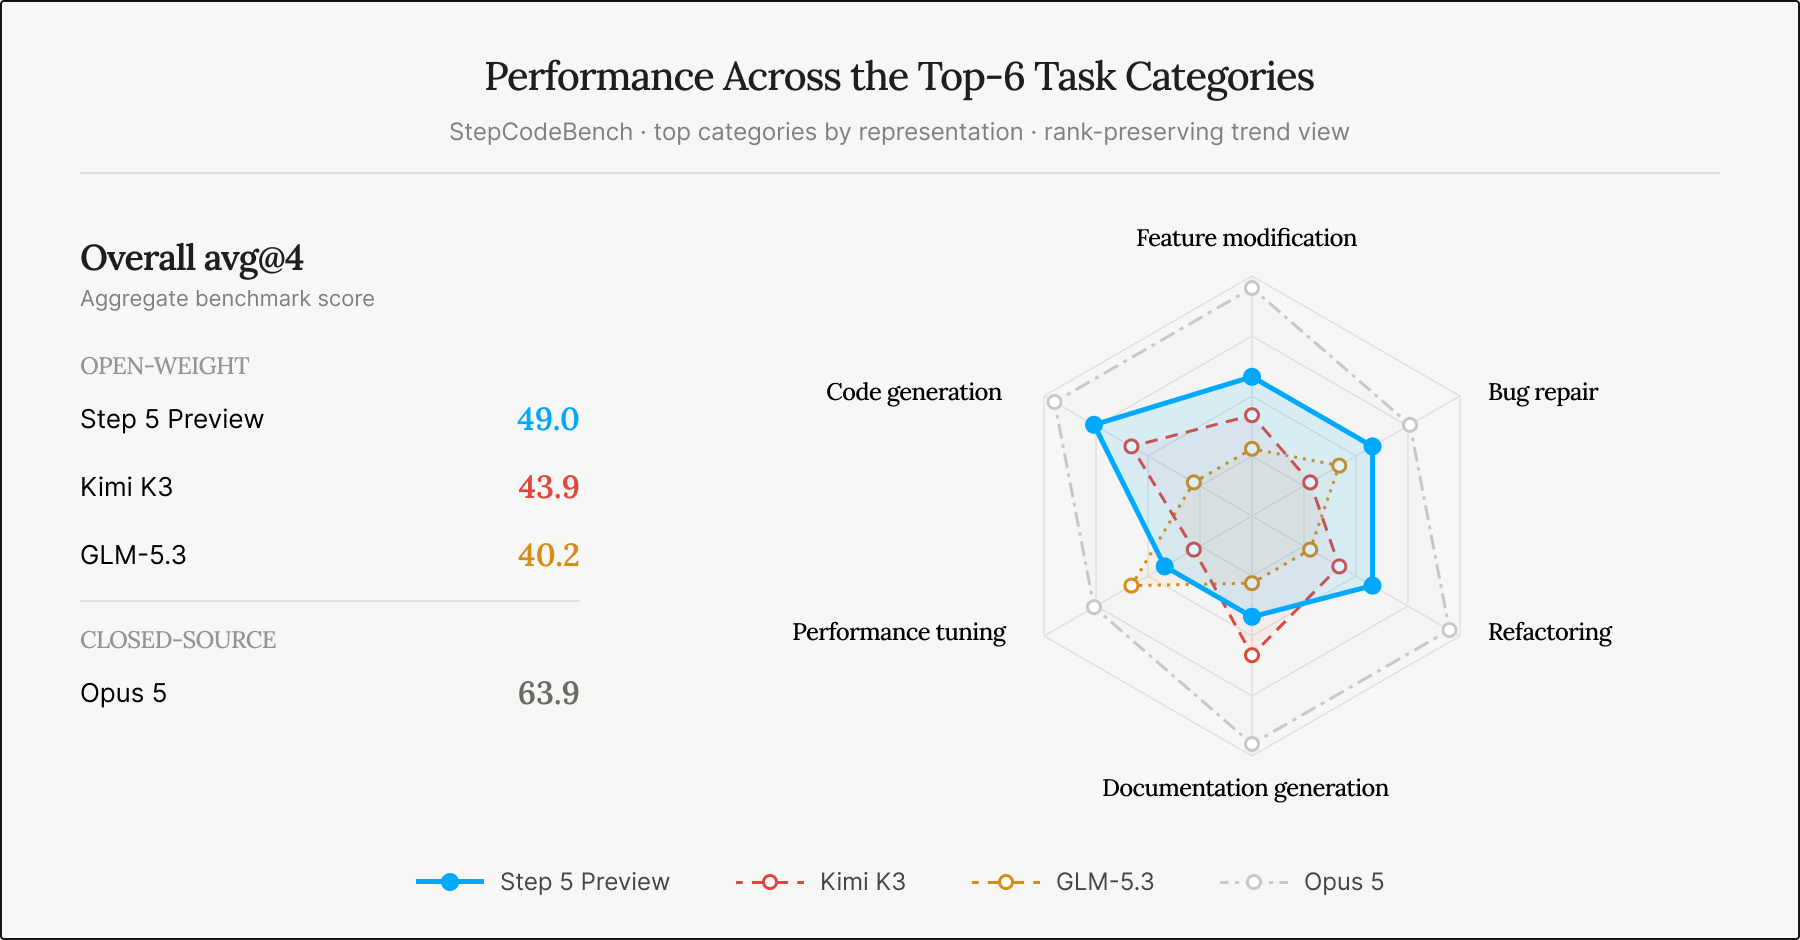 図:StepCodeBenchの6カテゴリにおける公式レーダー比較チャート。出典:StepFun公式リリース
静的なコード補完や不具合修正において、オープンソースモデルはフロンティア商用モデルである GPT-6 Astra(74.1点)を射程圏内に捉えつつある。StepFun はこの成果の客観性を裏付けるため、StepCodeBench が553のリポジトリ、9種類のタスク、33のプログラミング言語を網羅している点を強調する。専門性の高い ProgramBench と FrontierFinance でもそれぞれ80.5点、66.4点と高得点を獲得してオープンウェイト陣営で首位に立ち、特定の金融タスクでは Claude Opus 5 に肉薄した。
社内外のエキスパートを対象としたブラインド評価では、評価者の約70%が中〜高難易度のプログラミングタスクを自律的に完遂できる能力があると判定した。これらの静的ベンチマーク群は、明確にスコープが絞られた専門領域において極めて高い貫通力を持つツールとしてのモデル像を裏付けている。
3.47秒のレイテンシがTerminal-Benchの多段実行を阻む
しかし、静的ベンチマークにおける局所的な勝利は、動的な長距離タスクにおける Step 5 の脆さを覆い隠すことはできない。複雑な多段環境インタラクションを検証する Terminal-Bench v4 において、Step 5 のスコアは33.3点にとどまり、GLM-5.3 の41.9点に大きく水を開けられ、GPT-6 Astra の57.9点とは絶望的な差がついた。長距離エージェントタスクに求められるのは、単発のコード断片の正しさだけではない。数十回から数百回に及ぶファイル読み書きやツール呼び出しの連鎖の中で、コンテキストの状態を破綻させずに維持し続ける安定性である。
OpenRouter の監視データはこの急激な失速の背景を裏付けている。エンドツーエンドのP50レイテンシは13.05秒に達し、構造化出力のエラー率は15.15%に上る。10回以上の端末コマンドを連続して実行しなければならないテスト環境において、1ステップあたり3.47秒(P50)の初回トークン生成遅延は容赦なく蓄積される。Hacker News の議論でも指摘されたように、自律型エージェントの運用において、各ステップで1.5秒を超える遅延が発生すれば、スループットの速さによる恩恵は瞬く間に相殺されてしまう。
15.15%という構造化出力エラー率は、ツール呼び出しを前提とするループにとって致命的な摩擦となる。基礎的なツール呼び出しエラー率自体は1.81%と低いものの、構造化出力のわずかなズレがJSONやシェル構文の軽微な乱れを引き起こし、エージェントの実行パイプラインを途中でクラッシュさせる。Step 5 は膨大なコードを読み込んで的確な差分パッチを吐き出すことには長けているが、端末環境で自己検証を繰り返すループに入った途端、レイテンシと構造化出力の不安定さがシステムの進行を阻む障害となる。
総合スコアの劣勢と、特定性能に特化する実運用のアーキテクチャ選定
このような二面性を持つテスト結果を受け、エンジニアコミュニティの評価は二分している。Hacker News では Artificial Analysis のレーティング(Step 5 の総合指数は44)を引き合いに出し、あらゆる次元で平準化された指標では決してトップクラスではないと冷淡に見る向きもあった。しかし、すぐさま他の開発者から反論が上がった。総合指標の比較表はモデルベンダーのマーケティングには役立っても、現実のシステムを構築するエンジニアにとっては「突出した強み(長板)がどこにあるか」こそが重要だという指摘だ。
Step 3.5から3.7の世代を経て、StepFun はツール呼び出しとサブエージェントのオーケストレーション能力を一貫して磨いてきた。コミュニティが分析するように、Step 5 は汎用チャットのベンチマークで高得点を競うために作られたのではない。パーソナルアシスタントのクラスタにおいて特定タスクを担う実行ノードとして機能するという、明確なエンジニアリングパイプラインを意図して設計されている。大量のコンテキストコードを一気に読み込み、単一タスクの最適解を即座に出力する役割において真価を発揮する。
スパース構造と95%のキャッシュヒット率によって、Step 5 はオープンモデルの低コスト化を単なる妥協ではなく、アーキテクチャの中核目標へと昇華させた。その最大の工学的価値は、1Mコンテキストと高品質な専門コード生成の実行コストを劇的に押し下げたことにある。Terminal-Bench が浮き彫りにした多段自律実行の弱点は依然として明白だが、外部のオーケストレーションフレームワークによってレイテンシの罠を回避できる設計者にとって、この基盤モデルが提示するコストパフォーマンスは極めて魅力的な選択肢となるはずだ。
参考リンク:
- Step 5 Preview 公式発表ページ
- OpenRouter モデルページ
- Hacker News コミュニティ議論