A 1 dólar por millón de tokens de entrada estándar y solo 0,05 dólares para lecturas desde caché, los desarrolladores tienen acceso a un modelo base que combina una ventana de contexto de 1M de tokens con 600B de parámetros totales. El 8 de octubre de 2026, la firma de inteligencia artificial StepFun lanzó la API de Step 5 Preview y anunció la inminente liberación de sus pesos abiertos, arrastrando de nuevo el debate sobre las capacidades de los LLM al terreno de la ingeniería de sistemas y los costes operativos reales. Cuando las arquitecturas dispersas (sparse) desacoplan el número total de parámetros del gasto computacional directo, la proporción de parámetros activados y la tasa de acierto de caché se convierten en el verdadero baremo de evaluación. Step 5 muestra sus cartas con claridad: el bajo coste en modelos de pesos abiertos ya no es una coartada para justificar un rendimiento rezagado, sino una meta deliberada lograda mediante el diseño arquitectónico. Si bien demuestra una potencia demoledora en tareas puntuales de programación, sigue acusando notables carencias técnicas en la ejecución de agentes prolongados multietapa. La frontera del coste se ha derribado; la de la ejecución autónoma a largo plazo todavía resiste.
Una base colosal de 600B con solo 27B de parámetros activados
El principal catalizador de ingeniería en Step 5 Preview reside en su enorme arquitectura dispersa Mixture of Experts (MoE). Su base monumental de 600B de parámetros almacena un vasto conocimiento del mundo, pero al procesar cada token individual durante la inferencia, el modelo solo activa una ruta de cálculo de 27B de parámetros. Este enfoque traslada el centro de gravedad de la carrera armamentística de los modelos desde el tamaño bruto hacia la optimización de la tasa de activación. Reducir los parámetros activos a un magro 4,5% se traduce de inmediato en un salto cuantitativo de velocidad y un ahorro sustancial de cómputo.
Los datos de telemetría de OpenRouter durante tres días reflejan un rendimiento medio (P50) de 81 tok/s, con picos en ventanas largas de hasta 163 tok/s en el percentil 99 (P99). Una ventana colosal de 1M de tokens exige una velocidad de generación contundente para resultar práctica, y estos 27B de parámetros activos fueron diseñados precisamente para dar paso a un caudal de lectura y escritura altamente concurrente. Por si fuera poco, Step 5 admite de forma nativa entradas multimodales de texto, imagen y vídeo, permitiendo generar salidas de hasta 64K tokens. El gráfico de dispersión publicado por la compañía demuestra con claridad que Step 5 consume significativamente menos cómputo que sus competidores directos para obtener puntuaciones equivalentes.
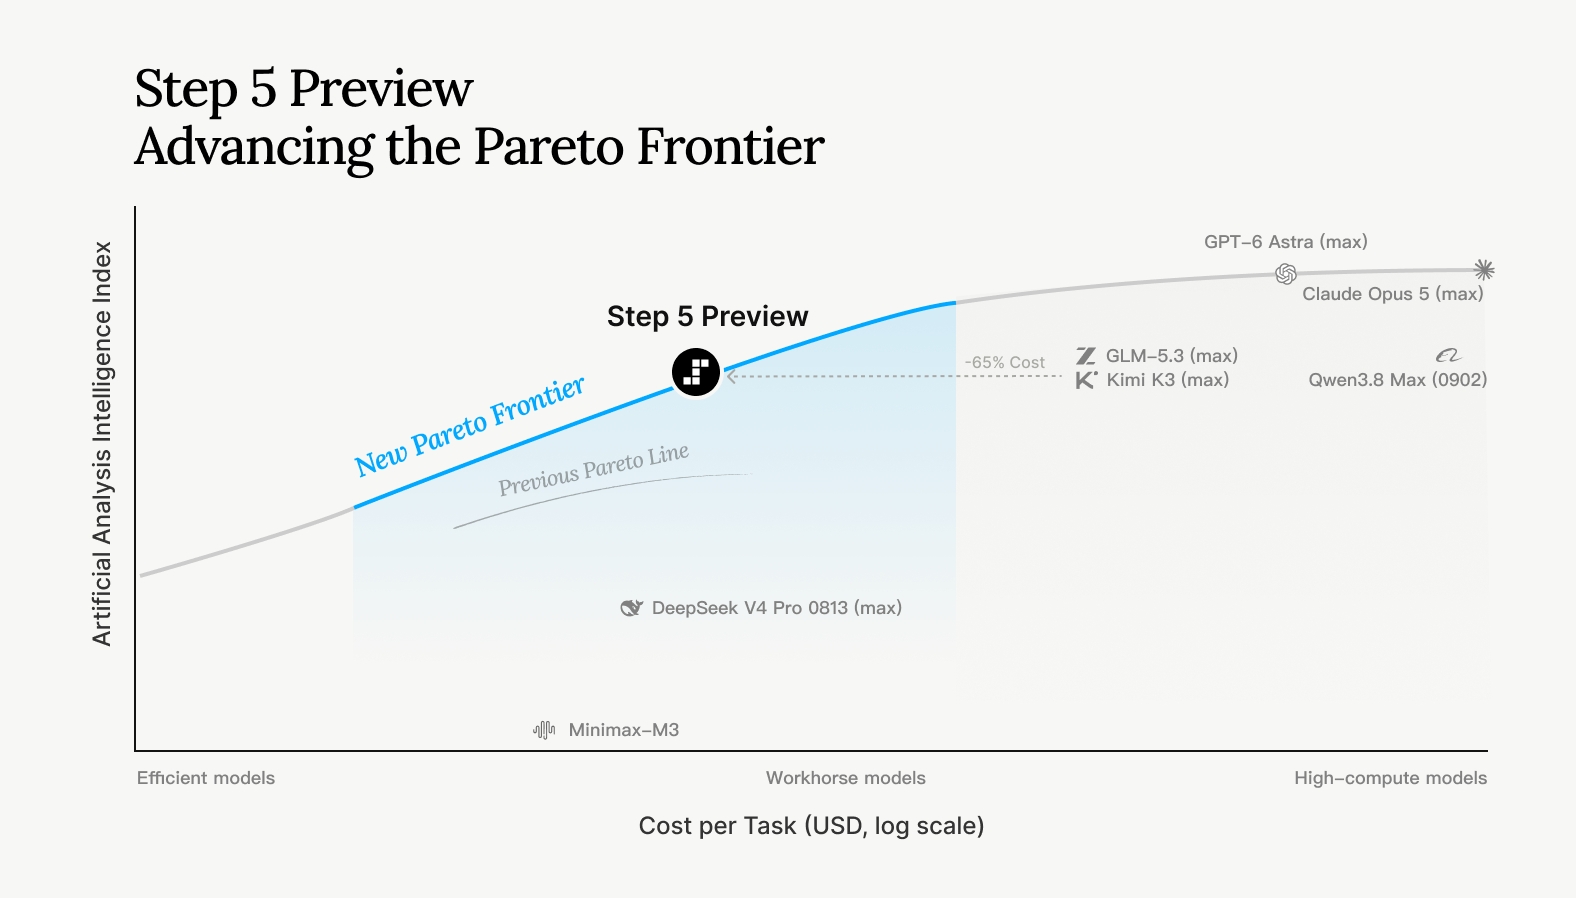 Figura: Gráfico de dispersión oficial de “Nivel de inteligencia vs. coste por tarea”, que ilustra la competitividad en costes de Step 5 ante un rendimiento equivalente. Fuente: Publicación oficial de StepFun
Un gigante de 600B nunca estuvo pensado para ejecutarse de forma local y desconectada en hardware de consumo. Varios usuarios en Hacker News señalaron con agudeza que pesos estáticos de semejante envergadura son incompatibles con los 128 GB de memoria unificada habituales en estaciones de trabajo para desarrolladores. Step 5 requiere imperativamente clústeres a gran escala en la nube, donde la extrema dispersión permite amortizar la infraestructura del proveedor. Es, por definición, una propuesta adaptada a la entrega mediante API nativa en la nube.
Un 95,1% de acierto en caché que pulveriza la tarifa nominal
En el catálogo oficial de OpenRouter, Step 5 figura con un precio oficial de 1,00 dólar para entrada y 2,70 dólares para salida por millón de tokens. Tomadas de forma aislada, estas cifras resultan simplemente moderadas en el contexto de la agresiva guerra de precios actual. Sin embargo, su verdadero golpe de efecto radica en una tasa de acierto de caché del 95,1%, que hace que el coste de lectura desde caché caiga en picado hasta los 0,05 dólares. Evaluar los precios de una API con 1M de contexto ignorando la caché carece de sentido: los avisos de sistema reutilizados continuamente y los extensos documentos de referencia reducen las facturas reales a una fracción mínima.
Según la monitorización de tres días en OpenRouter, al incorporar el mecanismo de caché, el precio medio ponderado real de entrada se sitúa en apenas 0,0966 dólares por millón de tokens. Siempre que el prompt permanezca caliente en la caché del servidor, los desarrolladores acceden a la capacidad de razonamiento de un modelo multimodal de vanguardia al precio de un modelo ligero de decenas de miles de millones de parámetros. StepFun ha posicionado explícitamente a Step 5 como un buque insignia orientado a tareas agénticas (agentic work), exhibiendo en sus casos de demostración la herramienta “Room Planner”, capaz de reconstruir un entorno 3D editable a partir de una simple fotografía de un dormitorio.
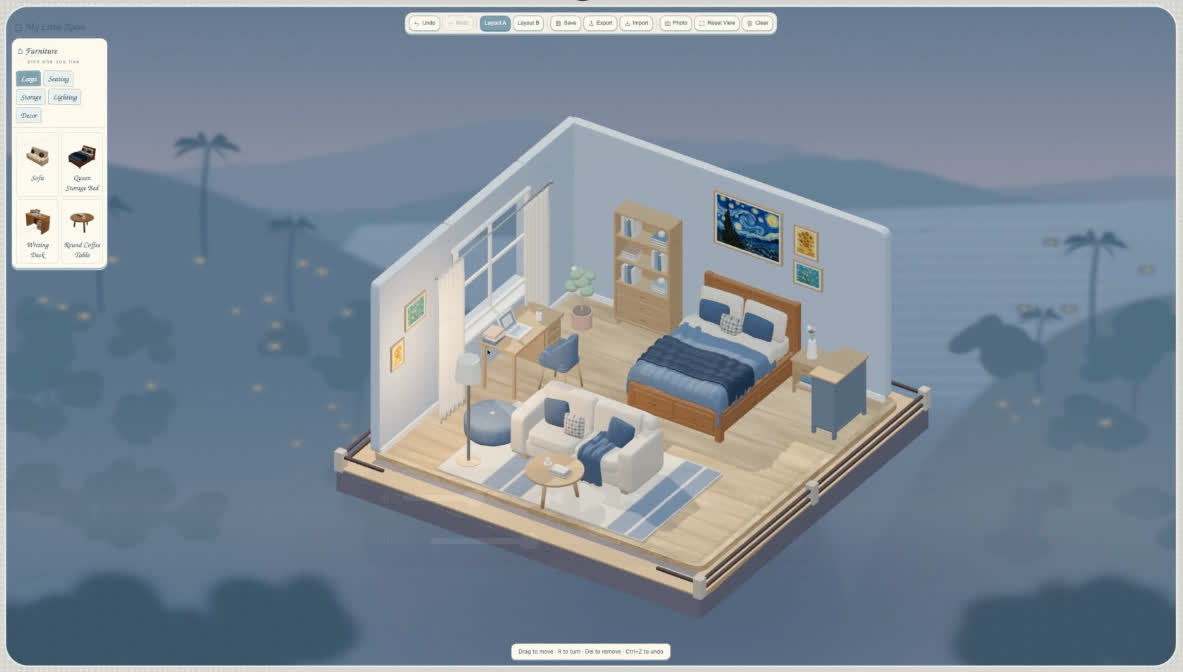 Figura: Demostración oficial “Room Planner”: generación de un entorno 3D editable a partir de una única fotografía de dormitorio. Fuente: Publicación oficial de StepFun
En flujos de trabajo iterativos donde el estado visual se reenvía una y otra vez para ajustar el resultado, la caché de contexto prolongado es la única vía para sostener la agilidad de respuesta y contener el gasto. Esta asimetría tarifaria desmantela la vieja premisa de que una mayor inteligencia debe pagarse forzosamente con precios de token elevados. La alta tasa de acierto en caché subsidia con creces el esfuerzo computacional de la fase de prellenado (prefill), permitiendo ofrecer el servicio con un coste marginal insignificante. Este colchón económico es el que brindó a StepFun la seguridad para fijar la publicación de sus pesos abiertos para el 15 de octubre.
Liderazgo en DeepSWE: potencia explosiva en tareas puntuales
En la generación de código y la reparación estática de fallos, Step 5 exhibe una contundencia sobresaliente en tareas directas. En el banco de pruebas DeepSWE v1.1 alcanzó una puntuación de 67,7, superando por estrecho margen a competidores de pesos abiertos como Kimi K3 Max (67,5) y GLM-5.3 Max (66,9). En la evaluación propia de la compañía, StepCodeBench, Step 5 amplió su ventaja con 49,0 puntos frente a los 43,9 de Kimi y los 40,2 de GLM.
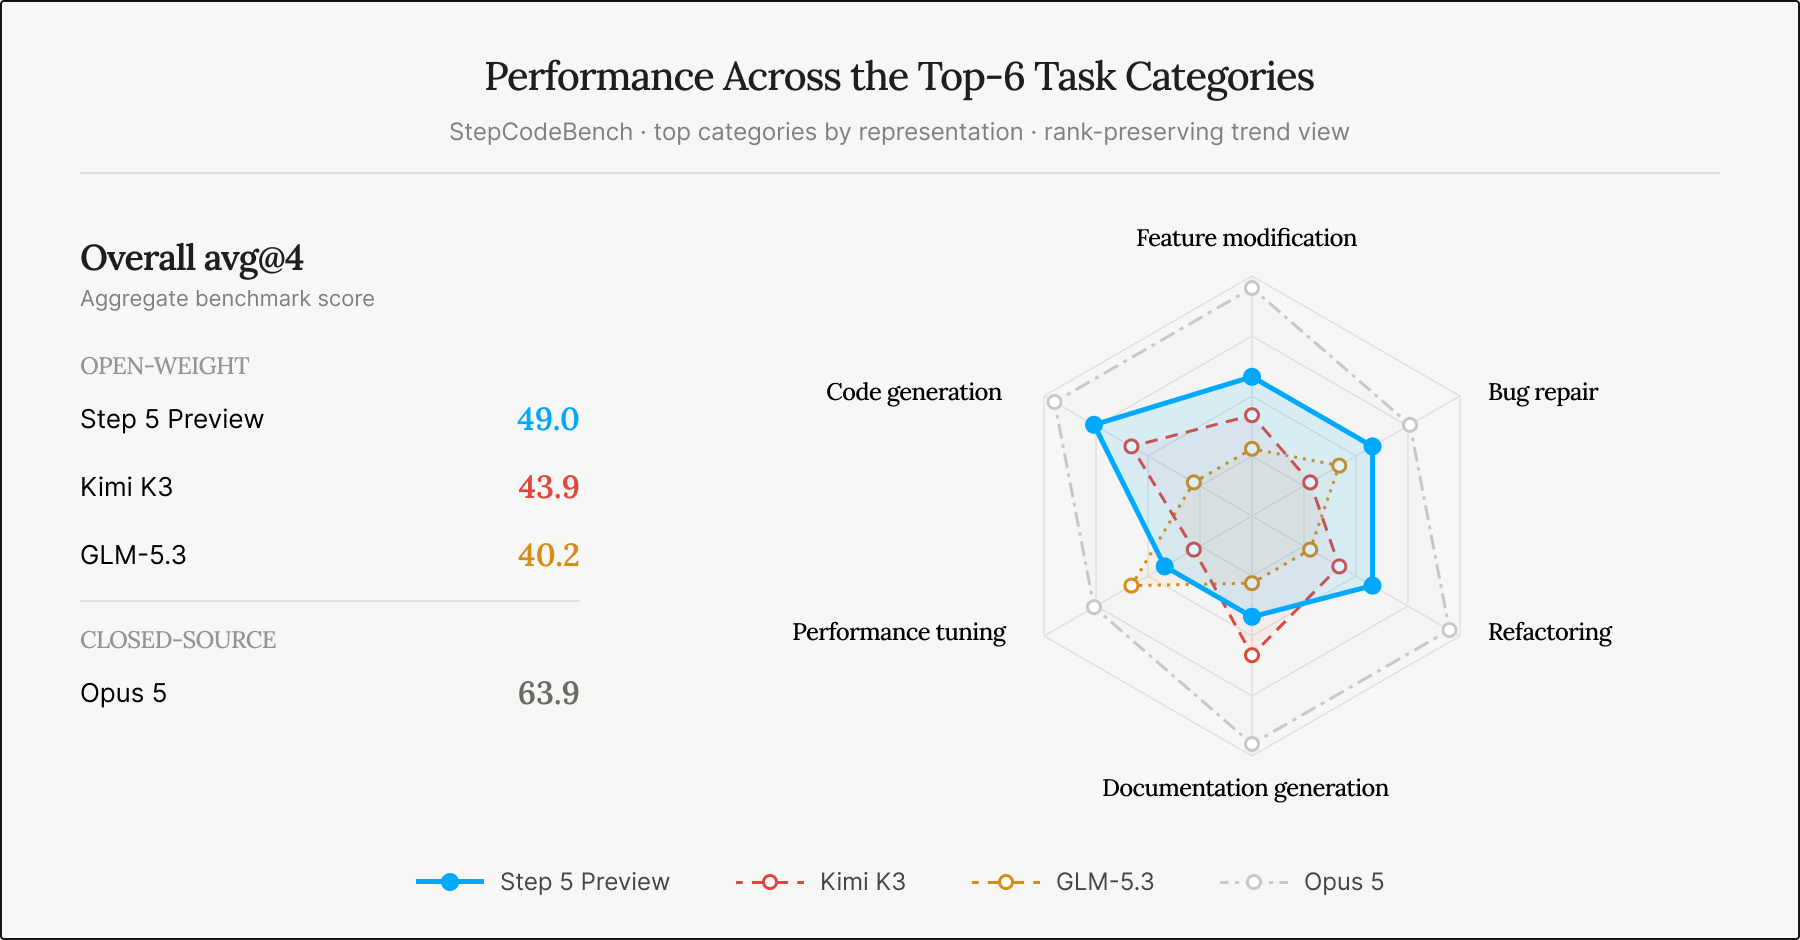 Figura: Gráfico de radar oficial que compara seis categorías de tareas en StepCodeBench. Fuente: Publicación oficial de StepFun
En tareas estáticas de completado de código y corrección de errores, los modelos abiertos están acortando distancias de manera consistente con modelos propietarios de primera línea como GPT-6 Astra (74,1). StepFun recalca que StepCodeBench abarca 553 repositorios independientes, 9 tipos de tareas y 33 lenguajes de programación. En evaluaciones de alta exigencia especializada como ProgramBench y FrontierFinance, Step 5 cosechó puntuaciones de 80,5 y 66,4 respectivamente, situándose a la cabeza del entorno open-weight y aproximándose a Claude Opus 5 en tareas financieras concretas.
En revisiones a ciegas realizadas por expertos internos y externos, cerca del 70% de los evaluadores consideró que el modelo es plenamente capaz de resolver de forma autónoma tareas de desarrollo de dificultad media y alta. Estos indicadores estáticos configuran el perfil de un modelo-herramienta altamente penetrante en dominios técnicos específicos.
3,47 segundos de latencia lastran la ejecución multietapa en Terminal-Bench
Los triunfos en pruebas estáticas no logran maquillar la fragilidad de Step 5 en entornos dinámicos y prolongados. En Terminal-Bench v4, benchmark que evalúa la interacción interactiva en consola a lo largo de múltiples pasos, Step 5 se quedó en unos discretos 33,3 puntos, situándose muy por detrás de GLM-5.3 (41,9) y a enorme distancia de los 57,9 de GPT-6 Astra. Las tareas complejas de agentes no solo demandan que el fragmento de código inicial sea correcto; exigen mantener intacto el estado del contexto tras decenas o centenares de lecturas de archivos y llamadas a herramientas.
Los registros de telemetría de OpenRouter aclaran en parte este descalabro: la latencia P50 de extremo a extremo alcanza los 13,05 segundos, mientras que la tasa de error en salidas estructuradas se eleva al 15,15%. En baterías de pruebas donde es necesario encadenar más de una decena de comandos en terminal, una latencia al primer token (P50) de 3,47 segundos se acumula de forma exponencial. Tal como señalaron miembros de la comunidad en Hacker News, en arquitecturas de agentes, cualquier latencia por paso superior a 1,5 segundos neutraliza con rapidez las ventajas del caudal de generación.
Una tasa de error en salida estructurada del 15,15% representa un lastre considerable para los bucles de ejecución de herramientas. Si bien la tasa de fallo en invocación básica es de solo el 1,81%, las desviaciones al formatear JSON o generar sintaxis de comandos provocan fallos que interrumpen el flujo del agente. Step 5 asimila con brillantez grandes volúmenes de código fuente y devuelve parches impecables, pero en cuanto se le exige ejecutar y verificar de forma continuada en un entorno de terminal, los tiempos de espera y los desajustes sintácticos bloquean el sistema.
Sin ventaja en el índice global: la ingeniería premia los picos de especialización
Ante este rendimiento polarizado, las opiniones de la comunidad de desarrolladores se han fracturado. En Hacker News, algunos usuarios citaron el índice general de Artificial Analysis, donde Step 5 obtuvo una puntuación compuesta de 44, argumentando que no destaca si se analizan todas las métricas de forma agregada. Sin embargo, otros ingenieros respondieron con rapidez que las tablas agregadas resultan útiles para el marketing comercial, pero quienes diseñan arquitecturas reales priorizan la magnitud de los picos de rendimiento en áreas clave.
Desde las etapas de Step 3.5 y 3.7, StepFun ha perfeccionado minuciosamente las llamadas a funciones y la orquestación de sub-agentes. Tal como concluyen en la comunidad, Step 5 no busca ganar torneos en pruebas de conversación genérica, sino que ha sido concebido para un flujo de ingeniería específico: servir como nodo ejecutor en clústeres de asistentes personales, procesando ingentes cantidades de código contextual para resolver problemas acotados a gran velocidad.
Mediante la dispersión arquitectónica y una tasa de acierto en caché del 95%, Step 5 ha transformado la ventaja en costes de los modelos abiertos en una meta de diseño primordial, y no en una justificación para un rendimiento deficiente. Su mayor mérito radica en llevar el contexto de 1M y la generación de código técnico a un umbral de coste radicalmente asequible. Aunque sus tropiezos en ejecuciones multietapa como Terminal-Bench sigan siendo patentes, para aquellos equipos capaces de implementar frameworks externos que mitiguen las trampas de latencia, la relación coste-efectividad de este modelo base resulta irresistible.
Enlaces de referencia:
- Página de lanzamiento oficial de Step 5 Preview
- Página del modelo en OpenRouter
- Debate en la comunidad de Hacker News