À 1 dollar par million de tokens pour une entrée standard et à peine 0,05 dollar pour une lecture depuis le cache, les développeurs accèdent à un modèle de fondation doté d’une fenêtre de contexte de 1M de tokens et de 600 milliards de paramètres au total. Le 8 octobre 2026, l’entreprise d’intelligence artificielle StepFun a ouvert l’API de Step 5 Preview et annoncé la libération prochaine de ses poids en open source. Cette initiative a ramené avec vigueur le débat sur les capacités des LLM vers le terrain de l’ingénierie système et de la rentabilité économique. Dès lors que les architectures clairsemées (sparse) découplent le volume brut des paramètres des coûts effectifs de calcul, le ratio de paramètres activés et le taux de succès du cache s’imposent comme les véritables étalons de mesure. Step 5 joue franc jeu : le faible coût d’un modèle à poids ouverts n’est plus une excuse commode pour masquer un déficit de performances, mais un objectif assumé, dicté par une conception architecturale rigoureuse. S’il démontre une puissance de frappe redoutable sur les tâches de programmation ponctuelles, il montre encore des lacunes techniques évidentes dans l’exécution d’agents autonomes séquentiels. La frontière des coûts s’est effondrée ; celle de l’autonomie au long cours résiste encore.
Un socle massif de 600B pour seulement 27B de paramètres activés
Le principal levier d’ingénierie de Step 5 Preview repose sur son imposante architecture Mixture of Experts (MoE) clairsemée. Si sa base titanesque de 600B de paramètres emmagasine une vaste connaissance du monde, le modèle ne mobilise qu’un chemin de calcul de 27B de paramètres pour traiter chaque token lors de l’inférence. Cette approche déplace le centre de gravité de la course aux armements : l’enjeu n’est plus d’empiler des paramètres bruts, mais d’optimiser le ratio d’activation. Tomber à un taux d’activation de 4,5 % seulement procure un gain immédiat de débit et une économie substantielle de puissance de calcul.
Les données de télémétrie relevées sur trois jours par OpenRouter attestent d’un débit médian (P50) de 81 tok/s, grimpant jusqu’à un P99 de 163 tok/s sur les contextes longs. Une fenêtre d’un million de tokens exige une cadence de génération élevée pour être pleinement exploitable ; ces 27B de paramètres actifs ont précisément été calibrés pour fluidifier un débit de lecture et d’écriture à forte concurrence. Par ailleurs, Step 5 prend nativement en charge des entrées multimodales mêlant texte, image et vidéo, avec une capacité d’émission grimpant jusqu’à 64K tokens en sortie. Le nuage de points partagé par StepFun met en lumière le fait que Step 5 consomme nettement moins de puissance de calcul que ses concurrents directs pour un niveau de performance équivalent.
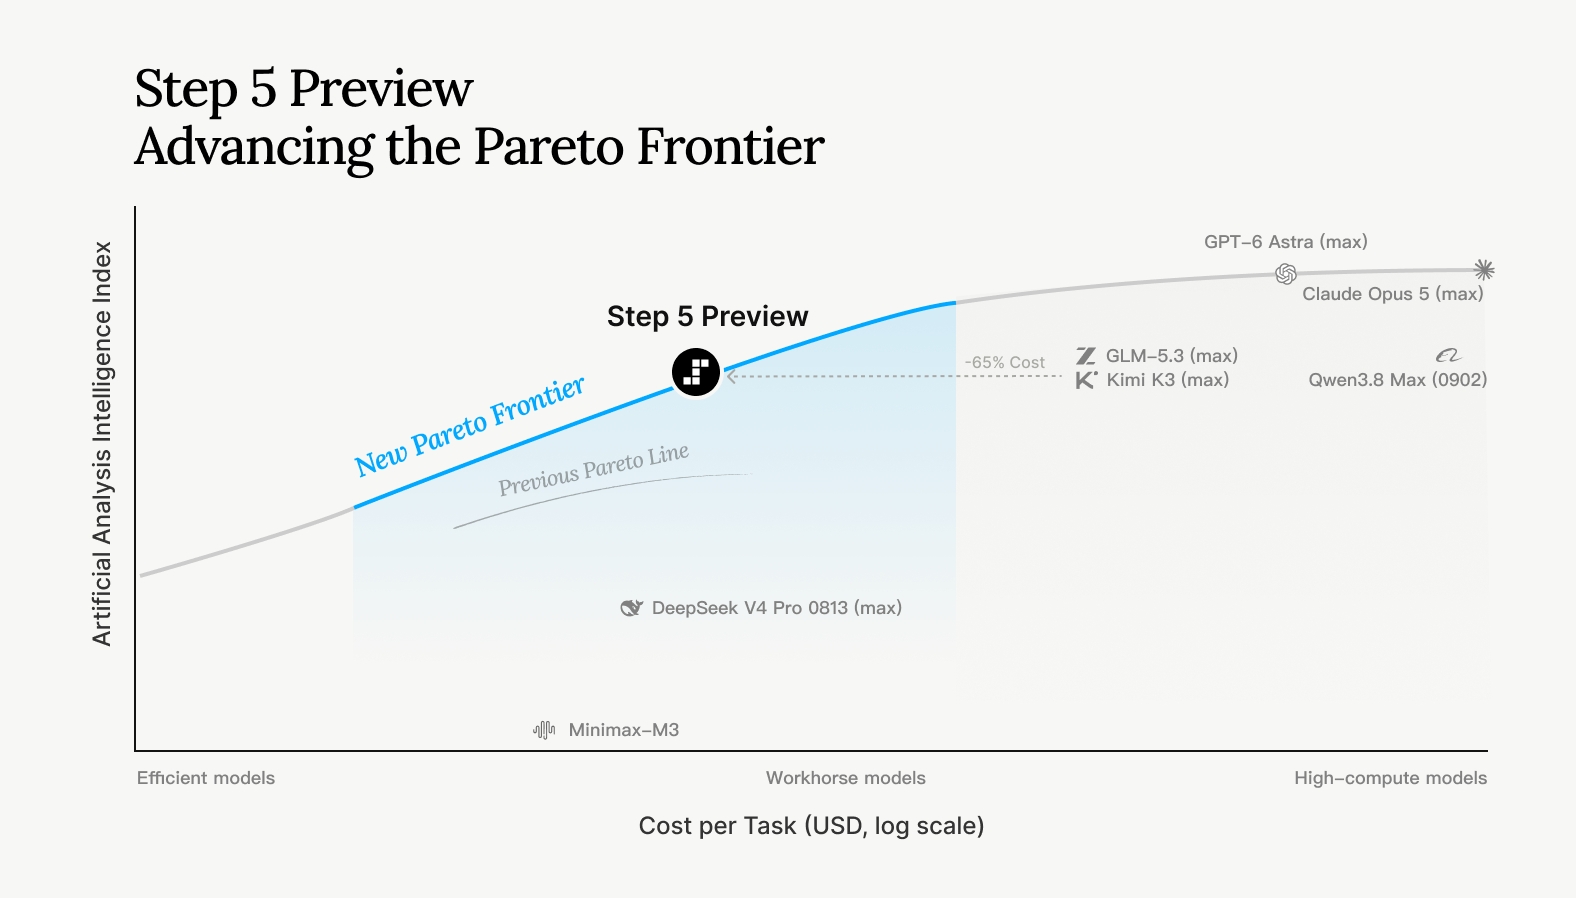 Figure : Graphique officiel “Niveau d’intelligence vs coût par tâche”, illustrant l’avantage économique de Step 5 à performance comparable. Source : publication officielle de StepFun
Un tel colosse de 600B n’a jamais été pensé pour tourner localement sur des stations de travail individuelles. Comme l’ont souligné plusieurs intervenants sur Hacker News, des poids statiques de cette envergure ne tiennent pas dans les 128 Go de mémoire unifiée couramment installés sur les machines de pointe. Step 5 exige impérativement des clusters cloud de grande envergure, capables d’amortir les coûts d’infrastructure grâce à une parcimonie extrême. Il s’agit, par essence, d’une solution taillée sur mesure pour les architectures d’API cloud-natives.
Un taux de succès de cache de 95,1 % qui pulvérise le tarif facial
Dans le catalogue d’OpenRouter, Step 5 est affiché à 1,00 dollar en entrée et 2,70 dollars en sortie par million de tokens. Isolés de leur contexte, ces chiffres s’inscrivent dans la moyenne de la guerre des prix actuelle des API. Cependant, la rupture provient d’un taux d’accès réussi au cache atteignant 95,1 %, qui fait chuter le tarif des requêtes en cache à seulement 0,05 dollar. Analyser la tarification d’une API à 1M de contexte sans intégrer la mise en cache n’a aucun sens : les instructions système réutilisées en continu et les volumineux documents de référence pulvérisent la facture effective.
D’après les relevés d’OpenRouter sur trois jours, le prix moyen pondéré réel en entrée tombe ainsi à 0,0966 dollar par million de tokens grâce au mécanisme de cache. Dès lors que le prompt reste actif dans le cache du serveur, l’utilisateur bénéficie des capacités de raisonnement d’un modèle multimodal de premier ordre au tarif dérisoire d’un petit modèle de quelques dizaines de milliards de paramètres. StepFun positionne ouvertement Step 5 comme son fer de lance pour les flux agentiques (agentic work), illustrant son potentiel avec la démonstration “Room Planner”, capable de générer un environnement 3D modifiable à partir d’une simple photo de chambre à coucher.
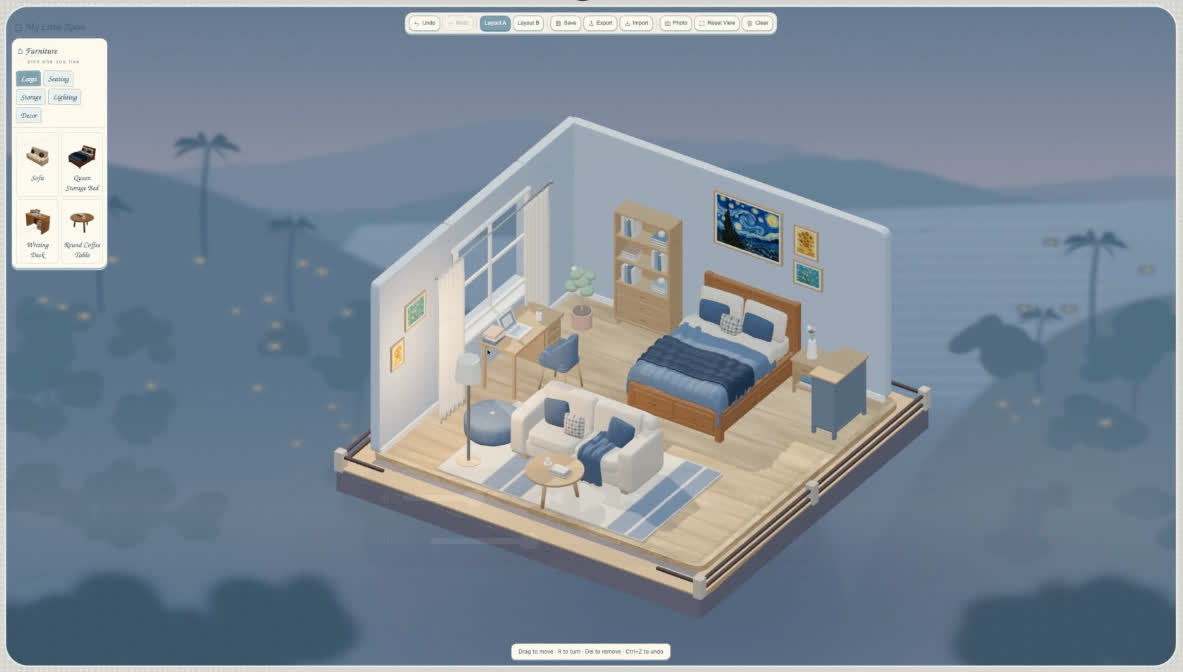 Figure : Cas d’usage officiel “Room Planner” générant un espace 3D modifiable à partir d’une simple photo de chambre. Source : publication officielle de StepFun
Dans des flux de travail itératifs où l’état visuel est continuellement réinjecté pour affiner le résultat, la mise en cache de contextes longs constitue la seule méthode viable pour garantir une réactivité satisfaisante tout en bridant les coûts. Cette rupture tarifaire met à mal le postulat selon lequel la qualité intellectuelle d’un modèle impliquerait nécessairement un prix élevé au token. Le taux élevé de cache compense largement l’effort de calcul consenti lors de la phase de pré-remplissage (prefill), permettant au fournisseur de délivrer son service à un coût marginal minime. C’est cette rentabilité qui a permis à StepFun d’annoncer avec assurance l’ouverture publique de ses poids pour le 15 octobre.
Supériorité sur DeepSWE : une puissance de frappe ponctuelle au niveau de l’état de l’art
Sur les tâches de génération de code et de correction statique d’anomalies, Step 5 fait preuve d’une efficacité redoutable sur un tour unique. Sur le benchmark de référence DeepSWE v1.1, il enregistre un score de 67,7, surpassant de justesse ses rivaux directs à poids ouverts, Kimi K3 Max (67,5) et GLM-5.3 Max (66,9). Sur le banc d’essai propriétaire StepCodeBench, il creuse nettement l’écart avec un score de 49,0 face aux 43,9 de Kimi et 40,2 de GLM.
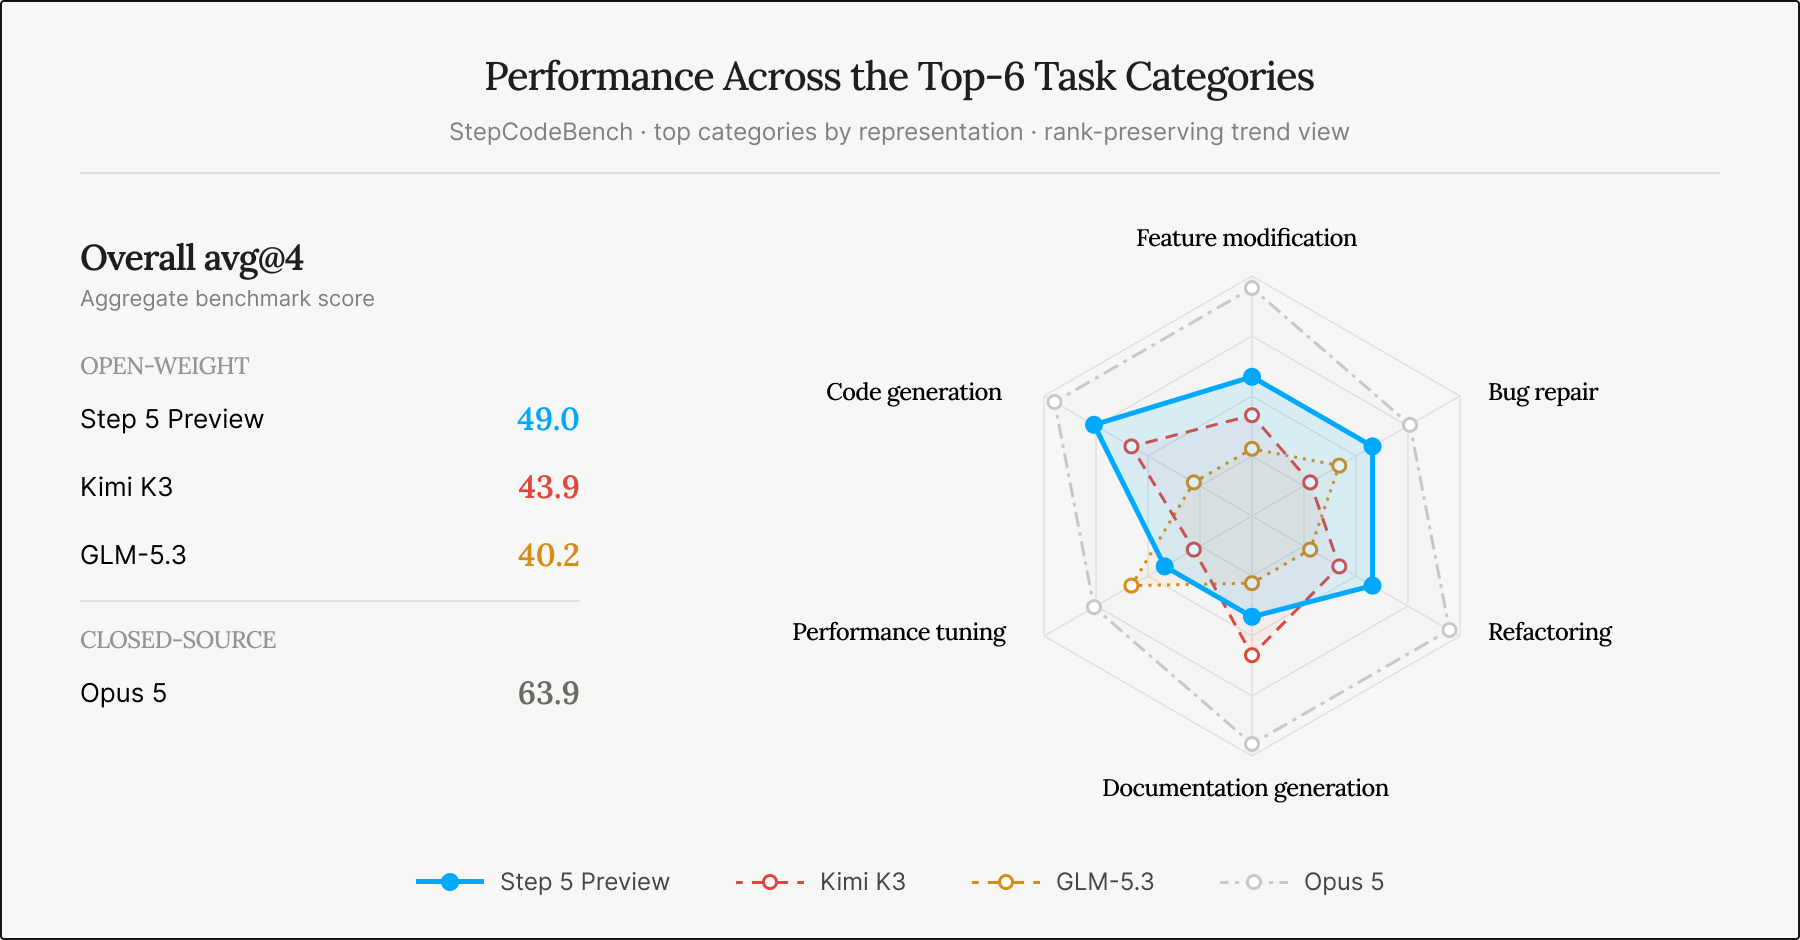 Figure : Graphique radar officiel comparant six catégories d’épreuves sur StepCodeBench. Source : publication officielle de StepFun
En complétion statique et en résolution de bugs, les modèles open source réduisent régulièrement l’écart avec les modèles propriétaires de pointe comme GPT-6 Astra (74,1). Pour attester de la robustesse de ces chiffres, StepFun précise que StepCodeBench englobe 553 dépôts distincts, 9 catégories de tâches et 33 langages de programmation. Lors d’épreuves hautement spécialisées telles que ProgramBench et FrontierFinance, Step 5 a récolté respectivement 80,5 et 66,4 points, s’imposant en tête du camp open source et côtoyant Claude Opus 5 sur certaines épreuves financières ciblées.
Dans les évaluations en aveugle menées auprès d’experts internes et externes, près de 70 % des participants ont jugé le modèle apte à mener à bien, de manière autonome, des développements de complexité moyenne à élevée. Ces indicateurs statiques confirment le profil d’un modèle-outil extrêmement percutant dans des domaines techniques bien délimités.
Une latence de 3,47 secondes qui pénalise l’exécution séquentielle sur Terminal-Bench
Ces victoires ponctuelles sur des classements statiques ne peuvent dissimuler la vulnérabilité de Step 5 dans des scénarios dynamiques et interactifs. Lors de l’évaluation Terminal-Bench v4, qui jauge les interactions complexes en ligne de commande sur de multiples étapes, Step 5 n’obtient que 33,3 points, restant très en retrait de GLM-5.3 (41,9) et à nette distance de GPT-6 Astra (57,9). Les tâches agentiques de longue haleine ne réclament pas seulement un fragment de code valide sur le coup ; elles exigent de maintenir la cohérence de l’état contextuel à travers des dizaines voire des centaines d’appels d’outils et de lectures de fichiers sans dérive.
Les métriques publiées par OpenRouter éclairent ce décrochage : le modèle enregistre une latence de bout en bout médiane (P50) de 13,05 secondes et un taux d’erreur sur les sorties structurées de 15,15 %. Dans des environnements de test où s’enchaînent plus d’une dizaine de commandes shell, un temps de premier token (P50) de 3,47 secondes s’accumule lourdement. Comme l’ont fait remarquer des participants sur Hacker News, au-delà de 1,5 seconde de latence par étape élémentaire dans un pipeline d’agents, tout le bénéfice du débit de génération est rapidement anéanti.
Ce taux de 15,15 % d’erreurs sur les sorties structurées représente une entrave majeure pour les boucles d’utilisation d’outils. Si le taux d’erreur sur les appels d’outils basiques ne dépasse pas 1,81 %, les légères déviations de syntaxe dans les JSON ou les commandes shell provoquent des dysfonctionnements qui interrompent prématurément le flux de l’agent. Step 5 assimile sans peine de volumineux dépôts et produit d’excellents correctifs, mais dès qu’on le charge de boucles d’auto-validation dans un terminal, la latence et les dérives de formatage deviennent des freins bloquants.
En retrait sur les indices composites : l’ingénierie privilégie les forces ciblées
Face à ce profil contrasté, les avis au sein de la communauté des développeurs se divisent. Sur Hacker News, certains utilisateurs ont mis en avant le score composite de 44 attribué par Artificial Analysis pour souligner que Step 5 ne se distingue pas sur l’ensemble des métriques généralistes. D’autres ont aussitôt répliqué que les classements généralistes profitent surtout au marketing des éditeurs, tandis que les architectes logiciels recherchent avant tout des modèles dont les points forts répondent précisément à leurs besoins.
Depuis les versions Step 3.5 et 3.7, StepFun a méthodiquement perfectionné les appels d’outils et l’orchestration de sous-agents. Comme le soulignent des praticiens, Step 5 n’a pas été conçu pour briller sur des classements de conversation généraliste, mais pour s’intégrer dans un pipeline d’ingénierie ciblé : servir de nœud d’exécution au sein d’un cluster d’assistants personnels, en digérant de volumineux contextes de code pour livrer des réponses ciblées dans un délai réduit.
En misant sur une architecture clairsemée et un taux de succès de cache de 95 %, Step 5 fait du faible coût d’exploitation un principe fondateur et non un simple palliatif à des concessions techniques. Sa véritable contribution réside dans sa capacité à faire basculer le contexte de 1M et la génération de code hautement technique dans une tranche de prix inédite. Bien que ses limites sur des scénarios séquentiels comme Terminal-Bench restent flagrantes, les concepteurs sachant s’appuyer sur des frameworks externes pour contourner les écueils de latence trouveront dans ce modèle socle une équation économique particulièrement séduisante.
Liens de référence :
- Page d’annonce officielle de Step 5 Preview
- Fiche du modèle sur OpenRouter
- Discussion sur la communauté Hacker News