1M(100만) 토큰 입력에 백만 토큰당 1달러, 캐시 읽기는 단 0.05달러. 그리고 개발자의 손에 쥐어진 것은 1M 컨텍스트와 600B 전체 파라미터를 갖춘 거대 기반 모델이다. 2026년 10월 8일, 중국 AI 기업 StepFun은 Step 5 Preview API를 출시하고 조만간 오픈소스 가중치를 공개하겠다고 발표했다. 이번 출시는 모델 성능 경쟁의 초점을 순수한 엔지니어링 비용과 시스템 단위 경제학의 영역으로 되돌려 놓았다. 희소(Sparse) 아키텍처를 통해 전체 파라미터 규모와 연산 비용이 분리되면서, 활성 파라미터 비율과 캐시 적중률이 새로운 척도로 자리 잡기 시작했다. Step 5가 던진 메시지는 명확하다. 오픈소스 모델의 저비용 구조는 더 이상 성능 저하를 감추기 위한 변명이 아니라, 아키텍처 설계를 통해 직접 달성한 하드웨어 효율의 결과물이라는 점이다. 단일 코드 생성 작업에서는 경이로운 폭발력을 보여주지만, 다단계 장기 실행 에이전트 작업에서는 여전히 기술적 한계를 드러낸다. 비용의 최전선은 열렸으나, 자율적 실행의 벽은 아직 허물어지지 않았다.
600B 거대 기반 모델에서 활성 파라미터를 27B로 압축한 구조
Step 5 Preview의 핵심 엔지니어링 지렛대는 거대한 희소 MoE(Mixture of Experts) 아키텍처에 있다. 600B에 달하는 방대한 전체 파라미터는 폭넓은 세계 지식을 저장하지만, 추론 과정에서 개별 토큰을 처리할 때 모델이 활성화하는 연산 경로는 27B에 불과하다. 이는 대규모 언어 모델의 파라미터 경쟁 초점을 단순한 규모 확대에서 활성화 비율 극대화로 전환시켰다. 4.5%에 불과한 활성 파라미터 비율은 눈에 띄는 속도 향상과 상당한 연산 자원 절감으로 이어졌다.
OpenRouter의 3일간 통계 데이터에 따르면 Step 5의 처리량(Throughput) 중간값(P50)은 81 tok/s에 달하며, 긴 컨텍스트 구간에서는 상위 1%(P99) 기준 최대 163 tok/s를 기록했다. 1M 토큰이라는 초장문 컨텍스트 윈도우를 실질적으로 활용하려면 빠른 생성 속도가 필수적인데, 27B 활성 파라미터는 높은 동시성 환경에서 읽기·쓰기 처리량을 확보하기 위해 마련된 설계다. 아울러 Step 5는 텍스트, 이미지, 비디오 입력을 네이티브 멀티모달로 지원하며, 최대 64K 토큰의 출력을 처리할 수 있다. 공식 발표된 산점도는 Step 5가 동일한 벤치마크 점수를 얻기 위해 소모하는 연산 자원이 동급 경쟁 모델보다 훨씬 적다는 사실을 보여준다.
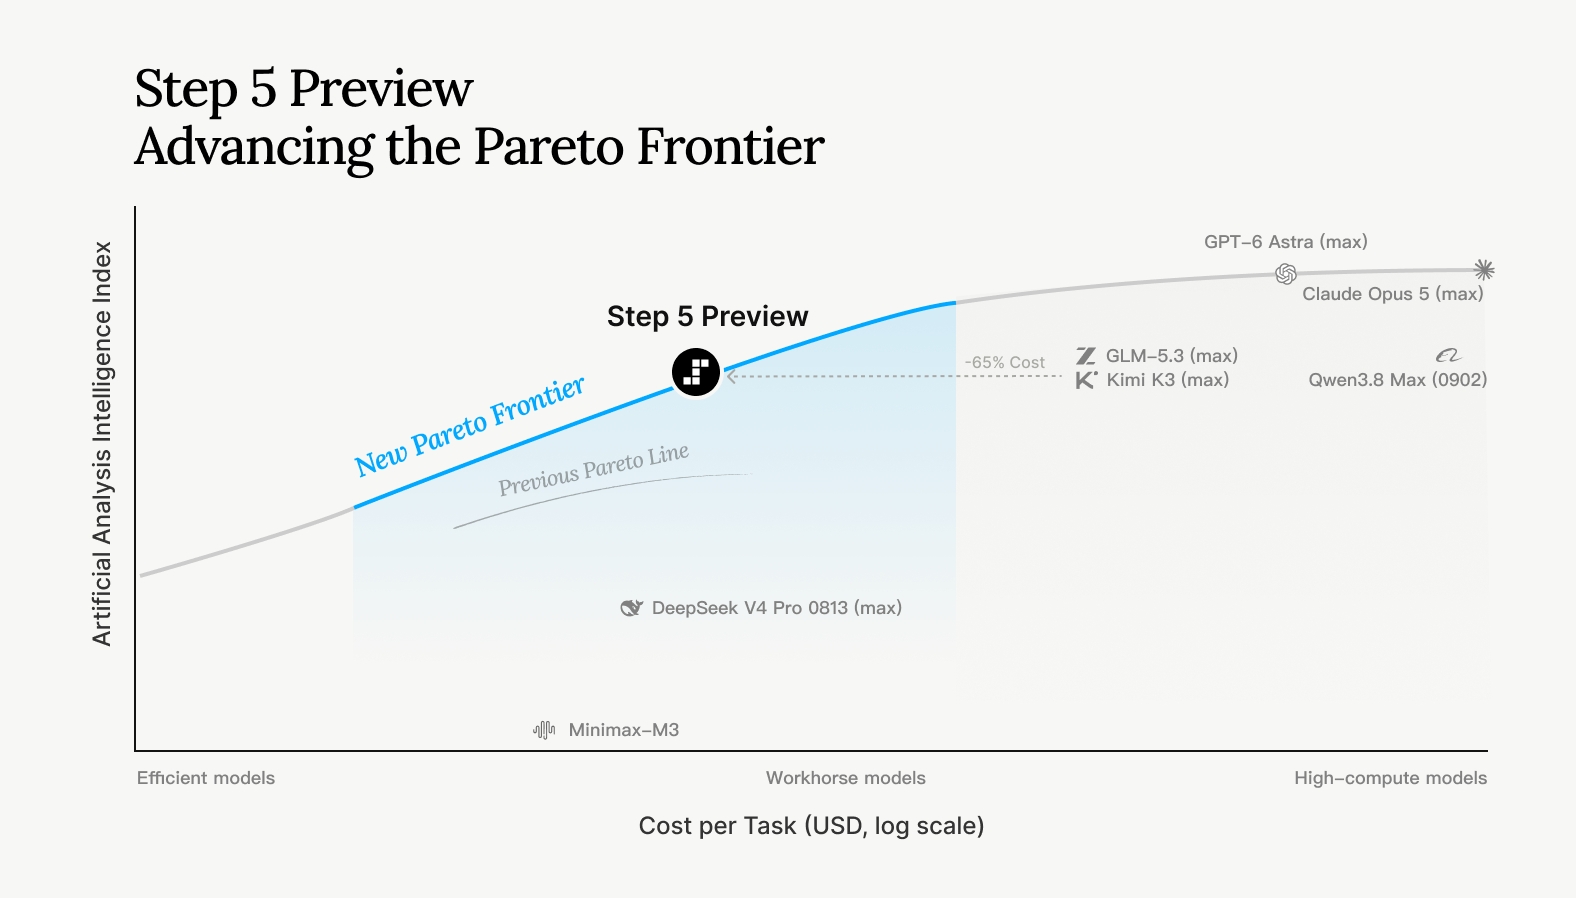 그림: 공식 발표된 「지능 수준 vs 작업별 비용」 산점도. 동일한 지능 구간에서 Step 5의 비용 우위를 보여준다. 출처: StepFun 공식 발표 페이지
600B 크기의 거대 모델은 애초에 개인 워크스테이션에서 오프라인으로 구동되도록 설계된 것이 아니다. Hacker News의 사용자들도 날카롭게 지적했듯, 이 정도 규모의 정적 가중치는 고급 개발자용 작업 환경에서 흔히 쓰이는 128GB 통합 메모리로는 감당할 수 없다. 대규모 클라우드 클러스터에 의존하고 고도의 희소화를 통해 서비스 인프라 비용을 분산하는 구조 자체가 클라우드 네이티브 API에 최적화된 설계다.
95.1% 캐시 적중률이 표기 가격을 무너뜨리는 방식
OpenRouter 공식 목록에서 Step 5의 정규 가격은 백만 토큰당 입력 1달러, 출력 2.70달러로 책정되어 있다. 이 수치만 본다면 치열한 API 가격 경쟁 속에서 평범한 수준으로 보일 수 있다. 하지만 진정한 파괴력은 95.1%에 달하는 캐시 적중률에 있으며, 이를 통해 캐시 읽기 단가는 0.05달러로 급락한다. 캐싱 메커니즘을 배제하고 1M 컨텍스트 API의 가격을 논하는 것은 무의미하다. 반복적으로 재사용되는 시스템 프롬프트와 방대한 문서 배경 데이터는 명목 청구 금액을 극적으로 낮춰준다.
OpenRouter 플랫폼의 3일간 모니터링 통계에 따르면, 캐싱 메커니즘이 적용된 실질 가중 평균 입력 가격은 백만 토큰당 0.0966달러에 불과하다. 프롬프트가 서버 측 캐시에 남아 있는 한, 호출자는 최신 프론티어 멀티모달 모델의 추론 역량을 수백억 파라미터 수준의 소형 모델 가격으로 이용할 수 있다. StepFun은 이 모델을 에이전트 작업(agentic work)을 겨냥한 플래그십으로 명확히 규정했으며, 침실 사진 한 장으로 편집 가능한 3D 공간을 생성하는 「Room Planner」 시연을 선보였다.
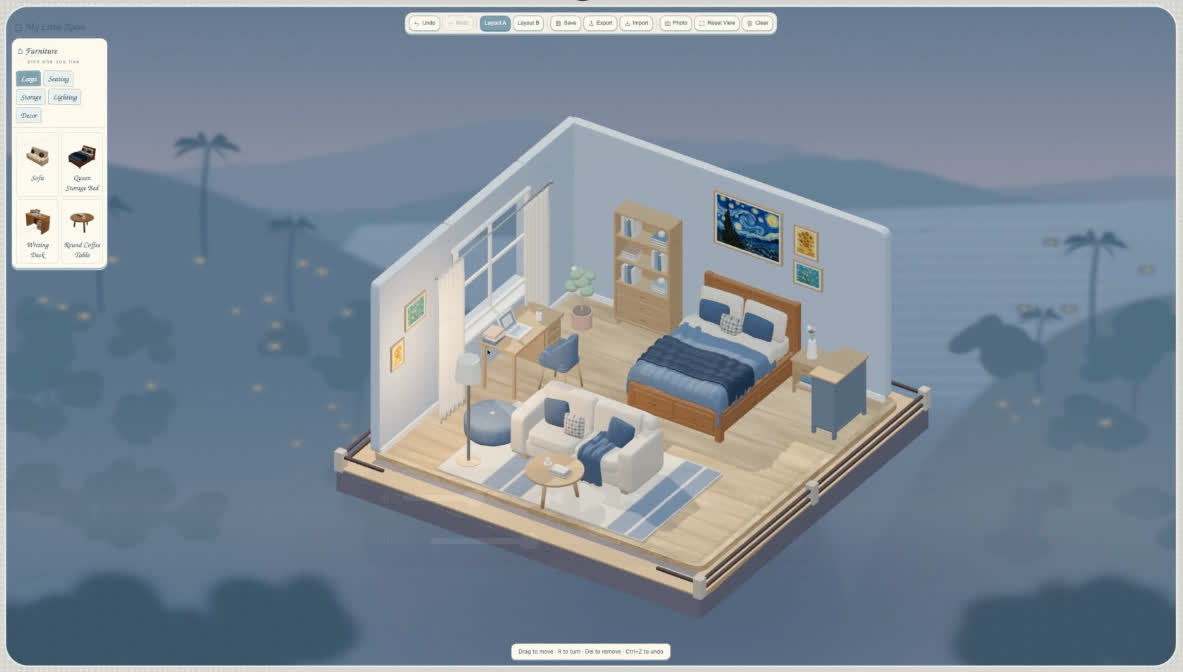 그림: 침실 사진 한 장으로 편집 가능한 3D 공간을 생성하는 공식 시연 「Room Planner」. 출처: StepFun 공식 발표 페이지
이미지 상태를 반복해서 입력하고 생성 결과를 미세 조정해야 하는 작업 흐름에서는 장문 컨텍스트 캐싱만이 시스템 응답 속도를 유지하고 비용을 억제할 수 있는 유일한 해결책이다. 이러한 과금 구조의 비대칭성은 성능과 가격이 정비례한다는 전통적인 통념을 뒤흔든다. 높은 캐시 적중률은 입력 처리 단계의 연산 소모를 효과적으로 상쇄하여, 모델 제공사가 극히 낮은 한계비용으로 서비스를 제공할 수 있도록 돕는다. 이러한 경제적 여유가 10월 15일 오픈소스 가중치를 공개하겠다는 결정의 배경이 되었다.
DeepSWE에서 경쟁 모델을 제치다: 단일 작업에서 입증된 폭발력
코드 생성 및 정적 버그 수정 영역에서 Step 5는 강력한 단일 턴 성능을 발휘했다. DeepSWE v1.1 평가 벤치마크에서 67.7점을 기록하며 동일한 오픈 가중치 진영의 Kimi K3 Max(67.5점)와 GLM-5.3 Max(66.9점)를 근소하게 앞섰다. StepFun 자체 StepCodeBench 평가에서는 49.0점을 기록해 Kimi의 43.9점과 GLM의 40.2점을 크게 따돌렸다.
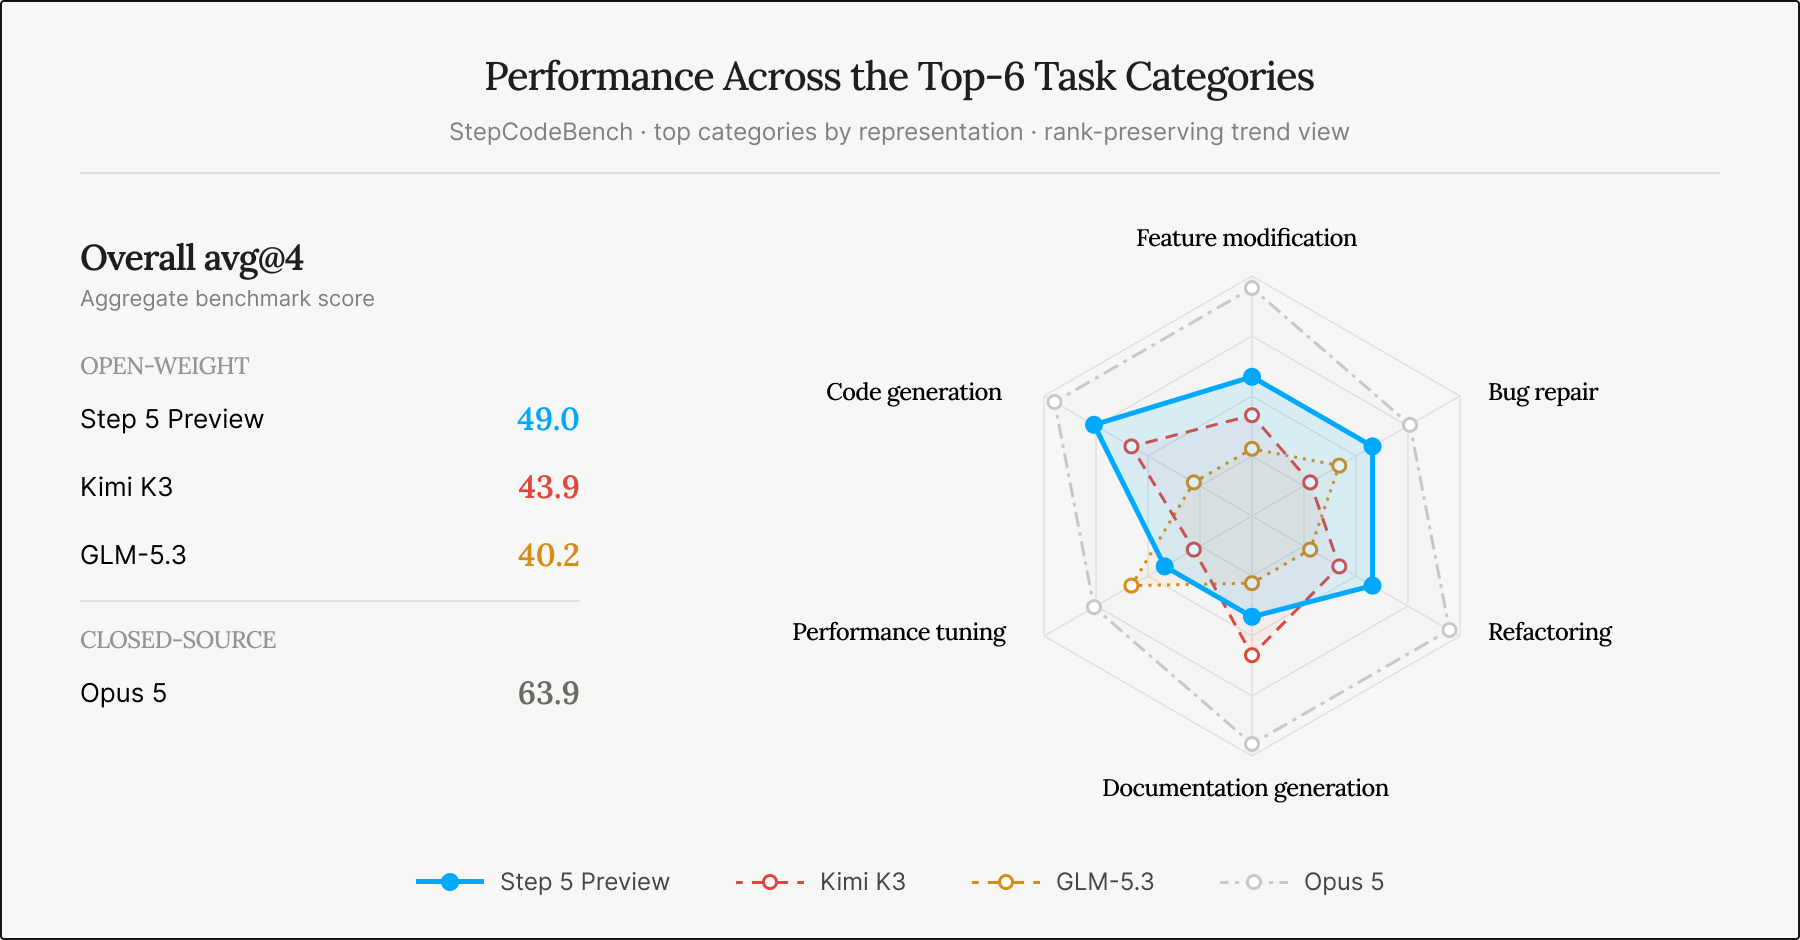 그림: 공식 StepCodeBench 6개 작업 영역 레이더 비교 차트. 출처: StepFun 공식 발표 페이지
정적 코드 자동 완성과 오류 수정 작업에서 오픈소스 모델은 프론티어 독점 모델인 GPT-6 Astra(74.1점)를 꾸준히 따라잡고 있다. StepFun은 이러한 성과의 객관성을 입증하기 위해 StepCodeBench가 553개의 독립 저장소, 9개 작업 범주, 33개 프로그래밍 언어를 포괄한다고 강조했다. 전문성이 두드러지는 ProgramBench와 FrontierFinance 테스트에서도 각각 80.5점과 66.4점을 얻어 오픈 가중치 진영 1위를 차지했으며, 특정 금융 항목에서는 Claude Opus 5에 근접했다.
사내외 전문가를 대상으로 한 블라인드 평가에서는 참여자의 약 70%가 이 모델이 중상급 복잡도의 프로그래밍 작업을 자율적으로 완수할 수 있다고 응답했다. 이러한 정적 데이터는 특정 전문 영역에서 뛰어난 돌파력을 발휘하는 전문 도구 모델의 모습을 보여준다.
3.47초의 지연 시간이 발목을 잡은 Terminal-Bench 다단계 실행
하지만 정적 벤치마크에서의 부분적 우위가 동적 장기 실행 환경에서 드러난 취약점을 가릴 수는 없다. 복잡한 다단계 환경 상호작용을 측정하는 Terminal-Bench v4 평가에서 Step 5는 33.3점에 그쳐 GLM-5.3(41.9점)에 크게 뒤처졌고, GPT-6 Astra(57.9점)와는 현격한 격차를 보였다. 장기 실행 에이전트 작업은 단일 턴의 정확한 코드 생성만을 요구하지 않는다. 수십 차례에서 수백 차례에 이르는 파일 읽기와 도구 호출 속에서도 컨텍스트 상태를 무너뜨리지 않고 유지해야 한다.
OpenRouter의 모니터링 데이터는 터미널 작업에서의 이러한 성능 저하 원인을 부분적으로 설명한다. 엔드투엔드 P50 지연 시간이 13.05초에 달하며, 구조화된 출력 오류율은 15.15%에 달했다. 10개 이상의 터미널 명령을 연쇄적으로 호출해야 하는 테스트 환경에서 단계당 3.47초에 달하는 첫 토큰 응답 지연 시간(P50)은 누적되어 증폭된다. Hacker News 커뮤니티의 지적대로, 에이전트 환경에서는 단일 단계 지연 시간이 1.5초를 넘는 순간 높은 처리 속도가 주는 이점이 빠르게 사라진다.
15.15%의 구조화된 출력 오류율은 도구 호출 루프에 심각한 장애물이다. 기본 도구 호출 오류율은 1.81%로 낮지만, 구조화된 출력에서 발생하는 미세한 어긋남이 JSON이나 셸 명령어에 문법 오류를 일으켜 에이전트 작업 흐름을 중단시킨다. Step 5는 방대한 코드를 파악하고 정확한 패치를 생성하는 데 능숙하지만, 터미널 환경에서 자체 검증을 거치는 다단계 루프에 들어가면 높은 지연 시간과 구조화 오류가 치명적인 병목으로 작용한다.
종합 지표의 열세 속에서 강점 중심의 엔지니어링 선택이 부각되는 이유
이러한 상반된 테스트 결과 앞에서 개발자 커뮤니티의 반응은 엇갈렸다. Hacker News의 일부 사용자는 Artificial Analysis 종합 순위에서 Step 5의 종합 지수가 44점에 머문 점을 들어 모든 영역에서 두드러진 모델은 아니라고 평가했다. 그러나 다른 엔지니어들은 종합 지표 순위표는 모델 공급사의 마케팅에 유용할 뿐이며, 실제 프로덕션 아키텍처를 설계하는 이들에게 중요한 것은 특정 강점이 얼마나 독보적인가 하는 점이라고 반박했다.
Step 3.5와 3.7을 거치며 StepFun은 도구 호출과 하위 에이전트 조율 역량을 지속적으로 개선해 왔다. 커뮤니티가 분석하듯 Step 5는 범용 챗봇 평가에서 고득점을 노리기 위해 만들어진 모델이 아니다. 개인 비서 클러스터에서 특정 작업을 전담하는 실행 노드로서, 대량의 배경 코드를 흡수하여 단일 작업의 해법을 빠르게 도출하는 명확한 파이프라인에 최적화되어 있다.
희소화 기법과 95%의 캐시 적중률을 통해 Step 5는 오픈소스 모델의 비용 절감을 단순한 타협이 아닌 핵심 아키텍처 목표로 승화시켰다. 이 모델의 가장 큰 엔지니어링 가치는 1M 컨텍스트와 고품질 전문 코드 생성을 전례 없이 저렴한 비용 구간으로 끌어내렸다는 데 있다. Terminal-Bench와 같은 다단계 실행에서의 약점은 여전히 분명하지만, 외부 오케스트레이션 프레임워크를 통해 지연 시간의 함정을 우회할 줄 아는 개발자에게 이 기반 모델의 가성비는 충분히 매력적이다.
참고 링크:
- Step 5 Preview 공식 발표 페이지
- OpenRouter 모델 페이지
- Hacker News 커뮤니티 토론