世界には長年、暗黙の了解として共有されてきた前提が存在した。機械に人の言葉を理解させるには、音声データを端末の外へと送信しなければならない。データはパッケージ化され、巨大テック企業のクラウドサーバーへと送られる。
過去数年間、私たちは巨大なクラウドモデルの高精度と引き換えに、プライバシーを手放すという取引を当たり前のものとして受け入れてきた。しかし2026年10月2日、Cactusチームが公開した音声認識モデル「Whistle」は、この前提を根底から解体した。
開発者の Jakub Mroz と Henry Ndubuaku が提示した成果物は、わずか16.9MBの単一ファイルで構成されている。この軽量モデルは、業界の標準ベンチマークである145.3MBの Whisper base よりも高速にローカル環境で動作する。極小のフットプリントをもって、音声認識サービスにおける「常時インターネット接続」が、もはや工学的な必須要件ではないことを証明したのである。
16.9MBを腕時計に収める:常時接続というドグマの解体
長らくの間、音声認識は重厚なクラウドサービスとして提供されてきた。主流モデルのサイズは数百メガバイトに達し、実行には複雑な依存環境の構築が求められる。Whistleが選んだアプローチはその対極にある。
公式が掲げるターゲット環境は極めて明快だ。スマートフォン、ウェアラブル端末、ロボティクス、スマートホーム機器、車載システム、そしてマイクロコントローラである。16.9MBというサイズは、スマートウォッチのオンボードチップやワイヤレスイヤホンのフラッシュメモリにも無理なく収まることを意味する。モデルは16kHzのモノラル音声をサポートし、最大30秒のオーディオを一度に処理できる。
英語やドイツ語を含む7言語に対応し、言語の自動検出機能も備える。すべてのコア処理はローカル上の3ステップで完結する。第1ステップは音声のテキスト書き起こし(トランスクリプション)だ。
第2ステップでは、単語単位のタイムスタンプと出現確率を出力する。そして第3ステップとして、80ミリ秒ごとのフレームから音声特徴量エンコーディングを抽出する。すべての音声データが端末内で完結して消費されるため、通信によるデータ漏洩のリスクは物理的に遮断される。
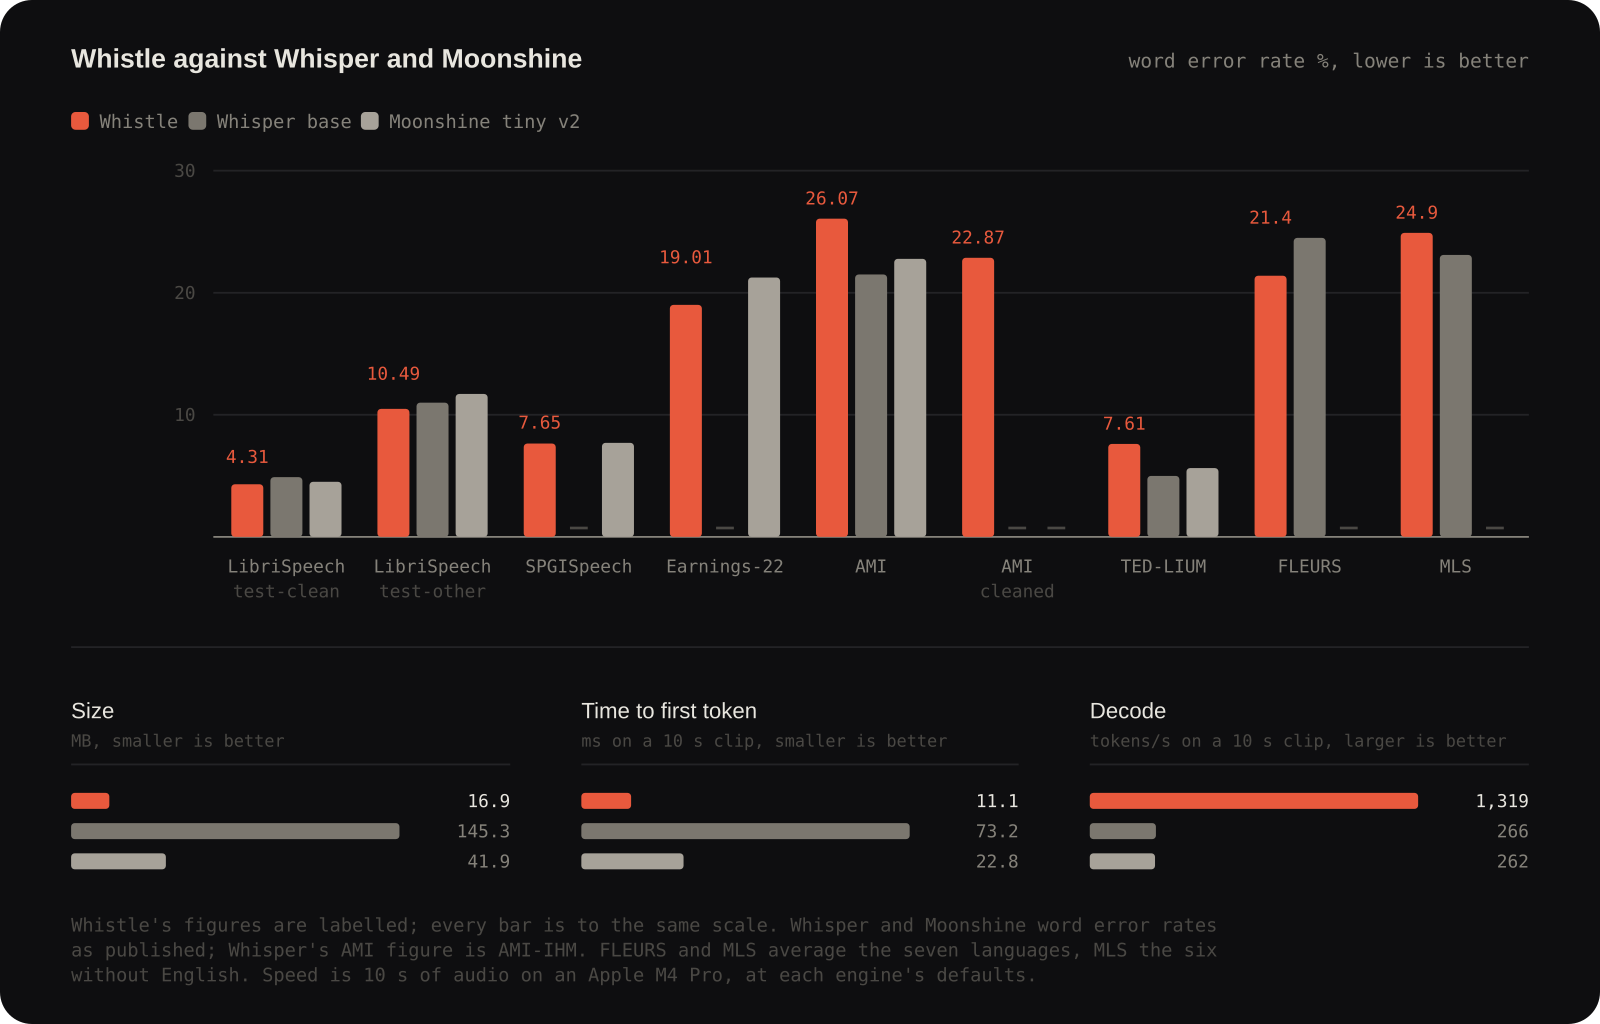 図:WhistleとWhisper base、Moonshine tiny v2における単語誤り率(WER)、モデルサイズ、初回トークン遅延、デコードスループットの比較。出典:Cactus 公式リポジトリ
11ミリ秒の初回トークン遅延:クラウドの往復速度を凌駕する
サイズに圧倒的な差がある状況において、小規模モデルがクラウドの巨大モデルに対抗するための最大の武器となるのが「速度」である。開発チームがApple M4 Proプロセッサ環境下で10秒間の音声を用いて検証したところ、純粋なCPU実行において、Whistleの初回トークン生成遅延はわずか11.1ミリ秒を記録した。
対照的に、同一条件で比較されたWhisper baseの初回トークン遅延は73.2ミリ秒に達した。また、別の軽量モデルであるMoonshine tiny v2でも22.8ミリ秒を要している。人間の知覚において、11.1ミリ秒は実質的に瞬時と言ってよい極小の時間幅だ。
発話者が文の前半を言い終える前に、画面にはすでに最初の単語が表示される。デコード全体の処理能力においても、Whistleは毎秒1,319トークンという圧倒的なスループットを叩き出した。8.6倍の体積を持つWhisper baseの毎秒266トークンを大きく突き放している。
ネットワークの往復遅延やパケット送信ロスの影響を一切受けないローカル環境において、軽量モデルは純粋な演算効率の高さによってインタラクションの主導権を奪い返した。
総合ベンチマークへの固執を捨てる:特定ドメインで勝てれば十分
わずか16.9MBのモデルである以上、あらゆる公開評価データセットで全勝することは初めから意図されていない。音声認識精度の核心指標である単語誤り率(WER)において、両者は一進一退の攻防を見せている。Whistleは日常的および実用的なドメインで優れた性能を発揮する。
LibriSpeechデータセットにおいて、Whistleはクリーン環境で4.31、ノイズ混じりの環境で10.49を記録した。さらに金融分野のSPGISpeech(7.65)や多言語データセットFLEURS(21.4)でも優位に立っている。一方で、Whisper baseは会議録音データセットAMI(26.07)、講演音声TED-LIUM(7.61)、多言語セットMLS(24.9)で巻き返しを見せた。
全世界のあらゆる訛りを網羅するような汎化性能を求めない単一タスクの現場であれば、この極小モデルはすでに実用的な最前線に到達している。ベンチマークの順位表で圧倒的な総合優勝を目指すのではなく、特定領域で「真に役立つ道具」となる道を選んだのだ。万人に向けた万能薬ではなく、特定デバイスに最適化された最も鋭利な単機能ナイフとしての設計である。
限界まで絞り出す性能:冗長性を徹底排除したエンジニアリング
極小サイズから最大限の性能を引き出すため、アーキテクチャには徹底した効率化が施されている。Cactusチームは車輪の再発明を行わず、自社のテキストモデル「Needle」の基盤コードを直接再利用した。音声認識タスク向けには、各デコーダ層にゲート付きクロスアテンション機構を1つ追加するにとどめている。
音声データが入力されると、モデルは必要な射影行列を一度に計算し、推論プロセス全体を通じて再利用する。5並列のビームサーチ探索経路においても、極小のテキストキャッシュを5つ保持するだけで済み、重い音声テンソルを5回繰り返して再計算する無駄を完全に排除した。
また、無音区間に対しては音声検出モジュールが即座に空の配列を返し、不要なデータが高コストなデコード処理に流入するのを未然に防ぐ。さらに特定固有名詞の認識率を向上させるため、従来のオートマトンアルゴリズムを用いたキーワードバイアス機構を導入した。ニューラルネットワーク全体に珍しい名称を丸暗記させることなく、開発者が狙った固有名詞のスコアを明示的に引き上げることが可能となっている。
音声入力を直接ツール呼び出しへ変換する単一バイナリ
デプロイ環境の観点では、macOSやLinuxといったデスクトップ環境から、Android、iOSなどのモバイルOS、さらにはブラウザ内のWebAssembly(WASI)に至るまで、実に17ものターゲット環境向けに事前コンパイルされている。
推論エンジンの実装は極めて簡潔であり、実行中にシステム環境変数を参照することは一切ない。すべての動作規則はコンパイル時に固定されたデフォルト値か、呼び出し側が明示的に指定した引数によってのみ制御される。さらに、Needleエンジンと共通の低レイヤ量子化形式を採用しているため、両者はシームレスに結合できる。
同一のバイナリでありながら、テキスト設定を読み込めば通常の文字起こしを出力し、ツール呼び出し用の設定を読み込めば、中間テキストの生成を飛び越えて、音声データから直接システムの実行コマンドへと変換することが可能だ。
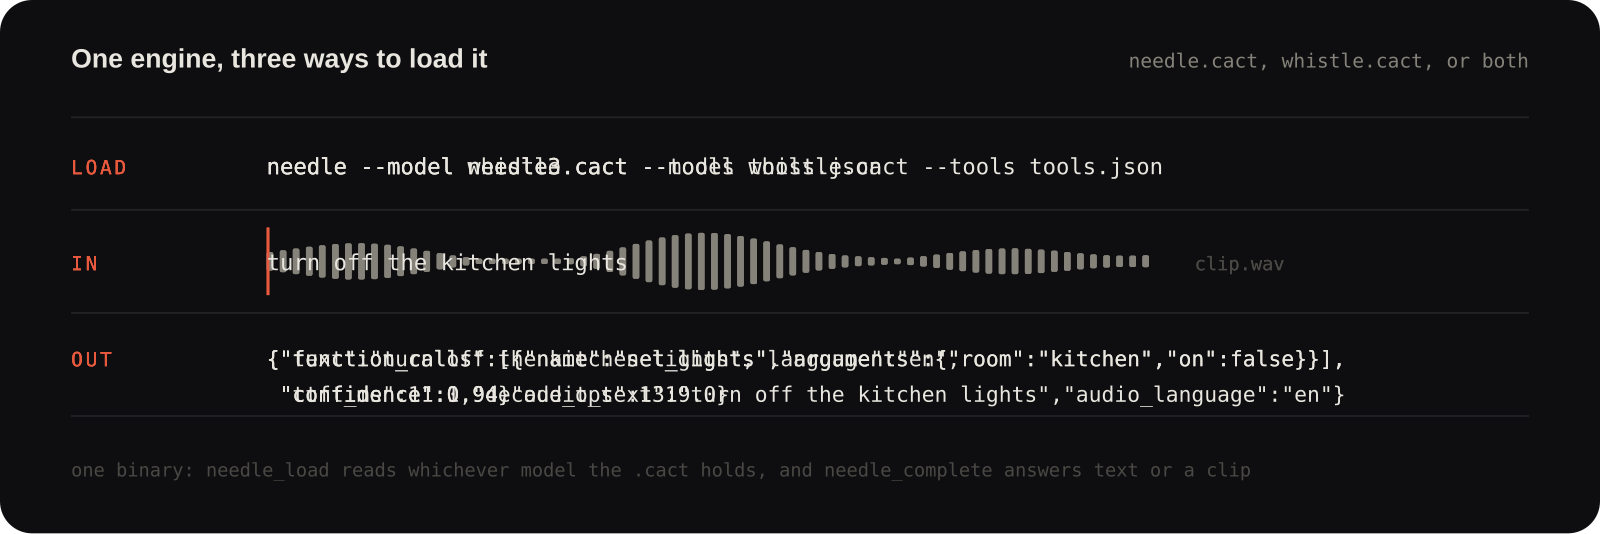 図:同一バイナリが読み込む設定に応じて異なる結果を出力するデプロイ構成の概要。出典:Cactus 公式リポジトリ
合成ベンチマークより重要な「現場の現実課題」の解決
技術コミュニティの関心は、ベンチマーク上の小数点以下の差にとどまらなかった。Hacker Newsのある投稿では、脳卒中の後遺症で口元が麻痺し、発話が不明瞭になってしまった84歳の父親を支えるユーザーの体験談が共有された。
そのユーザーは父親のためにローカル音声入力環境を構築した。父親はわずか10分で自伝の原稿1ページ分を口述できるようになり、何日もかけてキーボードを叩く苦痛から解放された。しかし、汎用的な音声認識モデルは、発話途中の言い淀みや咳払い、言い直しの言葉まで忠実に文字起こししてしまう。
父親が「象が……いや違う、猿が木に登った」と口述した際、汎用モデルはその修正過程をそのまま文字化してしまう。父親に本当に必要だったのは、言い直しの修正語を自律的に無視し、「猿が木に登った」という最終意図だけを出力する特化型の口述エンジンだった。
長文の音声口述が求められる現場において、あらゆる環境で満点を目指す万能クラウドサービスは必ずしも最適解ではない。極小のローカルエンジンで即座に下書きを記録し、軽量モデルで論理的な整形を行う。このアプローチのほうが、発話者に何度も録音をやり直させるよりもはるかに実用的である。
今回の発表は、スマートウォッチのチップに収まるほど小さなモデルであっても、オンデバイス処理が十分に実用的であることを証明した象徴的な出来事だ。何千億ものパラメータを競い合うクラウドの軍拡競争から離れ、通信の途絶えたオフライン環境において、特定タスクの効率を極限まで研ぎ澄ます。
電波の届かない古いスマートウォッチであっても、11ミリ秒で口述コマンドを理解できる。音声をクラウドに送らなければならない時代は、技術的な必然性を失ったのだ。
参考リンク:
- Cactus 公式発表およびベンチマーク
- Hacker News コミュニティディスカッション