Jahrelang galt in der Sprachverarbeitung eine stillschweigende Prämisse: Damit eine Maschine gesprochene Sprache versteht, muss die menschliche Stimme das lokale Gerät verlassen. Audiodaten wurden gebündelt und an die Rechenzentren eines Tech-Konzerns übertragen.
In den vergangenen Jahren gewöhnten wir uns an diesen Tauschhandel: Privatsphäre gegen die Präzision riesiger Cloud-Modelle. Doch am 2. Oktober 2026 veröffentlichte das Team von Cactus das quelloffene Sprachmodell Whistle – und hob diese Prämisse vollständig auf.
Das von Jakub Mroz und Henry Ndubuaku entwickelte Ergebnis ist eine eigenständige Binärdatei von lediglich 16,9 MB Größe. Auf einer lokalen CPU erreicht das Modell höhere Verarbeitungsgeschwindigkeiten als der 145,3 MB schwere Branchenstandard Whisper base. Mit diesem minimalen Speicher-Footprint stellt Whistle klar, dass eine permanente Internetverbindung für Sprachdienste aus ingenieurtechnischer Sicht keineswegs mehr zwingend erforderlich ist.
16,9 MB auf einer Smartwatch: Das Dogma der permanenten Online-Anbindung bricht
Lange Zeit wurde Spracherkennung als inhärent schwergewichtiger Cloud-Dienst konzipiert. Gängige Modelle belegen hunderte Megabyte Speicher und verlangen komplexe Laufzeitumgebungen. Whistle schlägt den entgegengesetzten Weg ein.
Die offizielle Produktpositionierung ist unmissverständlich: Smartphones, Wearables, Robotik, Smart-Home-Systeme, Infotainment im Automobilbereich und Mikrocontroller. Eine Dateigröße von 16,9 MB bedeutet, dass das Modell problemlos im Chip einer Smartwatch oder im Flash-Speicher kabelloser Ohrhörer Platz findet. Es verarbeitet 16-kHz-Mono-Audio in Sequenzen von bis zu 30 Sekunden Länge.
Das Modell unterstützt sieben Sprachen (darunter Deutsch und Englisch) inklusive automatischer Spracherkennung. Der gesamte Verarbeitungsprozess läuft lokal in drei Stufen ab. Die erste Stufe umfasst die reine Transkription in einem Durchlauf.
Die zweite Stufe liefert Zeitstempel auf Wortebene samt Wahrscheinlichkeitswerten. Als dritte Stufe werden Sprachmerkmals-Embeddings extrahiert, die auf Basis von 80-Millisekunden-Frames kodiert sind. Da sämtliche Audiodaten ausschließlich auf dem Endgerät verarbeitet werden, ist ein unbefugter Datenabfluss physisch ausgeschlossen.
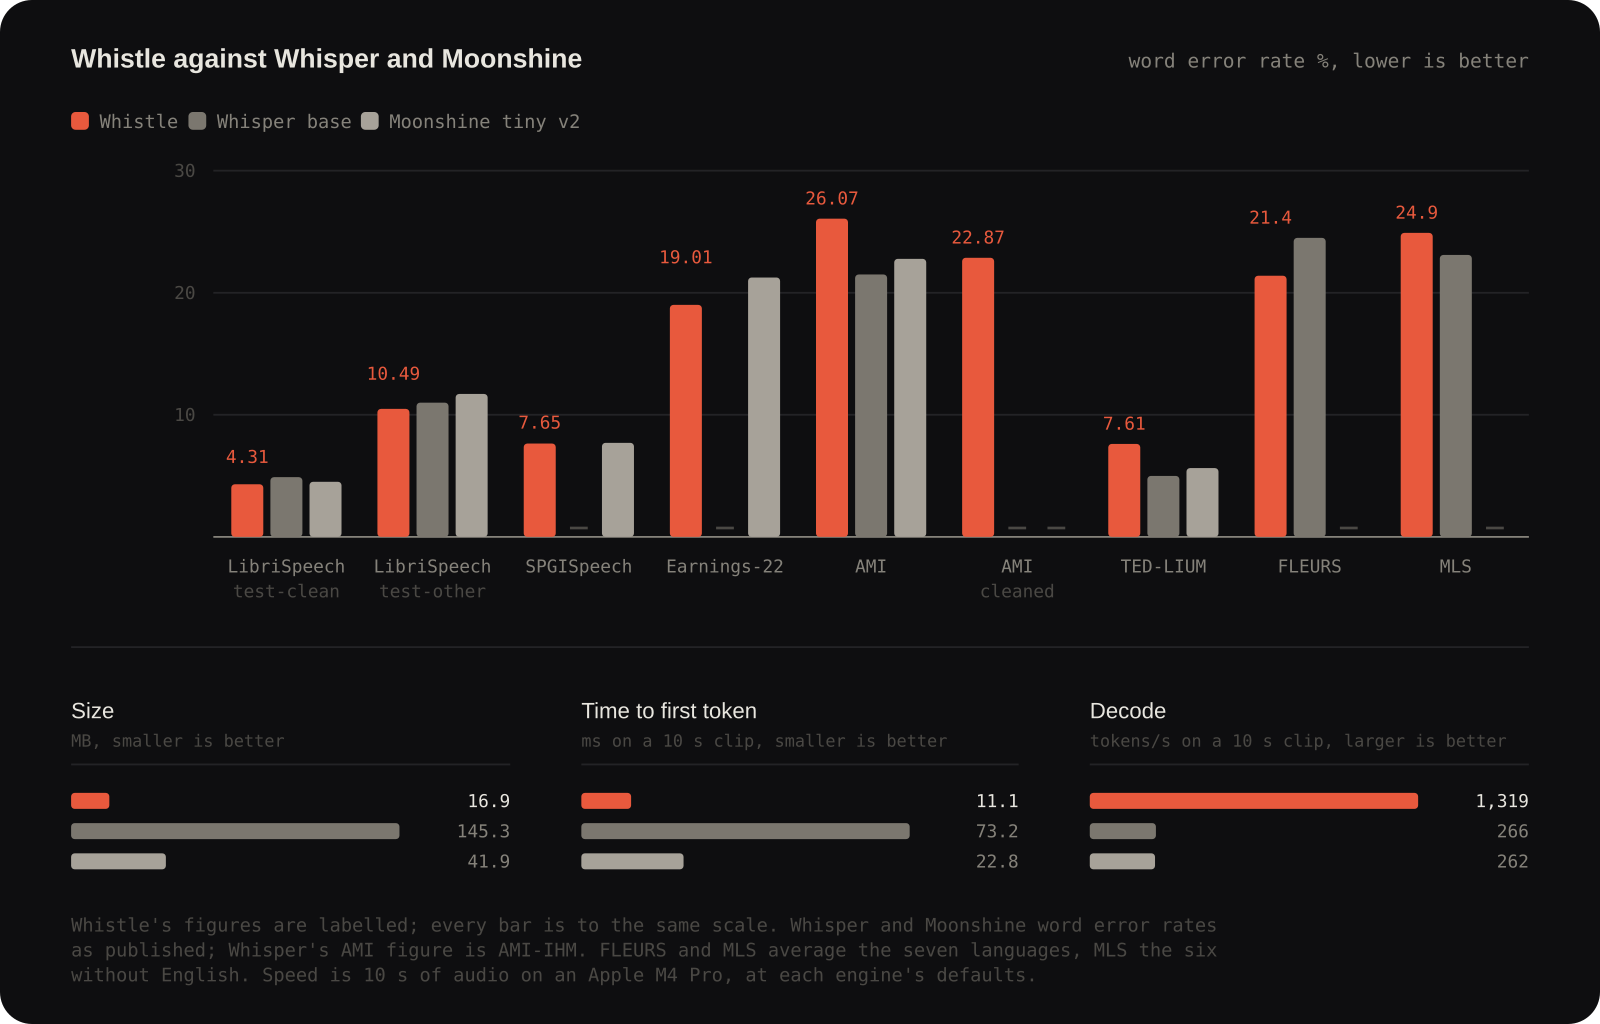 Abbildung: Vergleich von Whistle mit Whisper base und Moonshine tiny v2 hinsichtlich Wortfehlerrate (WER), Modellgröße, First-Token-Latenz und Decodierdurchsatz. Quelle: Offizielles Cactus-Repository.
11 ms First-Token-Latenz: Lokale Ausführung schlägt Cloud-Roundtrips
Bei einem derart drastischen Größenunterschied wird reine Geschwindigkeit zur schärfsten Waffe kompakter Modelle gegenüber Cloud-Giganten. In Tests auf einem Apple M4 Pro unter ausschließlicher CPU-Nutzung erzielte Whistle bei einem zehnsekündigen Audioclip eine First-Token-Latenz von lediglich 11,1 Millisekunden.
Im direkten Vergleich benötigte Whisper base unter identischen Bedingungen 73,2 Millisekunden, während das leichtgewichtige Modell Moonshine tiny v2 bei 22,8 Millisekunden lag. Menschlich wahrgenommen entsprechen 11,1 Millisekunden praktisch einem Wimpernschlag.
Noch bevor der Sprecher den ersten Halbsatz beendet hat, erscheint bereits das erste transkribierte Wort auf dem Bildschirm. Beim gesamten Decodierdurchsatz erreichte Whistle beeindruckende 1.319 Token pro Sekunde – und deklassierte damit das um das 8,6-fache größere Whisper base (266 Token/s) deutlich.
In einer autarken lokalen Laufzeitumgebung ohne Latenzen für Netzwerk-Handshakes und Paketverluste erobert das kompakte Modell durch reine Recheneffizienz die Kontrolle über die Reaktionszeit im Dialog zurück.
Jenseits des Benchmark-Fetischismus: Spezialisierung schlägt Allround-Ansprüche
Bei einer Größe von nur 16,9 MB kann kein Modell jeden synthetischen Testdatensatz dominieren. Bei der Wortfehlerrate (Word Error Rate, WER) – dem zentralen Maßstab für Transkriptionsgenauigkeit – liefern sich beide Seiten einen offenen Schlagabtausch. Whistle brilliert insbesondere in alltäglichen und domänenspezifischen Szenarien.
Im LibriSpeech-Datensatz erzielte Whistle im Testset für saubere Sprache 4,31 und unter gestörten Bedingungen 10,49. Auch bei Finanz-Audiodaten in SPGISpeech (7,65) sowie im mehrsprachigen FLEURS-Benchmark (21,4) liegt das Modell vorn. Whisper base wiederum konnte bei Besprechungsaufnahmen in AMI (26,07), Vorträgen in TED-LIUM (7,61) und dem mehrsprachigen Datensatz MLS (24,9) Boden gutmachen.
Für zielgerichtete Einzelaufgaben, die keine weltweite Akzent-Generalisierung über dutzende Sprachen hinweg erfordern, stoßen kompakte Edge-Modelle bereits an die technologische Leistungsgrenze vor. Statt hypothetischer Siege auf akademischen Bestenlisten strebt Whistle praktische Anwendbarkeit in ressourcenbeschränkten Umgebungen an: kein Allheilmittel für jede denkbare Tonspur, sondern ein hochpräzises Skalpell für dedizierte Endgeräte.
Kompromisslose Optimierung: Verzicht auf jede technische Redundanz
Um maximale Leistung aus einem stark begrenzten Speicherbudget herauszuholen, war eiserne ingenieurtechnische Disziplin erforderlich. Statt das Rad neu zu erfinden, griff das Cactus-Team direkt auf die Basisinfrastruktur von Needle zurück, ihrem hauseigenen Textmodell. Für Spracherkennungsaufgaben ergänzten sie jede Decoder-Schicht lediglich um einen gegateten Cross-Attention-Mechanismus.
Treffen Audiodaten ein, projiziert das Modell die benötigten Matrizen in einem einzigen Durchgang und verwendet diese während der gesamten Decodierungssequenz wieder. Ein fünfgleisiger paralleler Beam-Search-Pfad benötigt dadurch lediglich fünf kurze Text-Cache-Puffer – anstatt schwere Audiotensoren fünfmal redundant neu berechnen zu müssen.
Bei stillen Passagen liefert das Spracherkennungsmodul sofort ein leeres Ergebnis zurück, sodass ungenutzte Audiodaten gar nicht erst in die rechenintensive Pipeline gelangen. Zur Steigerung der Erkennungsgenauigkeit domänenspezifischer Eigennamen setzt die Engine auf klassische deterministische Automaten für Keyword-Biasing. Entwickler können die Gewichtung seltener Begriffe gezielt verstärken, ohne das neuronale Netz zu zwingen, diese im Vorfeld auswendig zu lernen.
Von der Audioaufnahme direkt zum Tool-Call in einer einzigen Binärdatei
Auch auf der Bereitstellungsebene überzeugt die Architektur: Whistle liegt vorkompiliert für 17 Zielplattformen vor. Die Spanne reicht von Desktop-Systemen wie macOS und Linux über mobile Betriebssysteme wie Android und iOS bis hin zu WebAssembly-Modulen (WASI) innerhalb moderner Browser.
Der Code der Inferenz-Engine ist außerordentlich schlank und greift während der Laufzeit unter keinen Umständen auf Systemumgebungsvariablen zu. Sämtliche Verhaltensweisen werden entweder durch feste Standardwerte zur Kompilierzeit oder durch explizit übergebene Parameter gesteuert. Da Whistle dasselbe Low-Level-Quantisierungsformat und dieselbe C++-Engine wie Needle nutzt, greifen beide Systeme nahtlos ineinander.
Wird dieselbe Binärdatei mit einer Standard-Textkonfiguration geladen, gibt sie Texttranskripte aus. Wird sie jedoch mit einer Werkzeugkonfiguration (Tool-Calling) versehen, überspringt sie die textuelle Zwischenstufe vollständig und wandelt Sprachbefehle unmittelbar in strukturierte Systembefehle um.
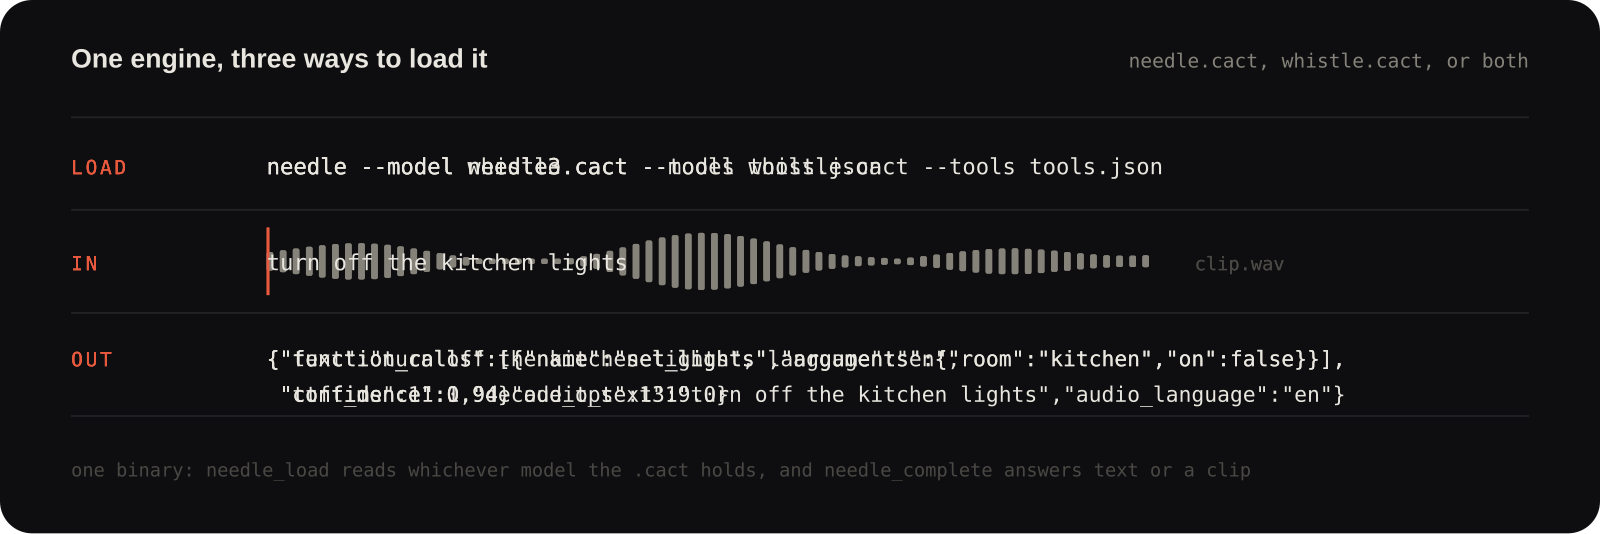 Abbildung: Bereitstellungsarchitektur: Eine einzige Binärdatei liefert je nach geladener Konfiguration unterschiedliche Ergebnisse. Quelle: Offizielles Cactus-Repository.
Reale Problemlösung statt synthetischer Benchmark-Punkte
In der Entwickler-Community verlagerte sich der Fokus rasch weg von marginalen Benchmark-Differenzen hin zum praktischen Nutzen im Alltag. In einem vielbeachteten Hacker-News-Kommentar schilderte ein Entwickler die Situation seines 84-jährigen Vaters, der infolge eines Schlaganfalls unter verwaschener Aussprache leidet.
Der Entwickler richtete für seinen Vater ein lokales Diktiersystem ein. Damit schaffte der Vater eine ganze Manuskriptseite seiner Memoiren in zehn Minuten – was ihm tagelanges, mühsames Tippen auf der Tastatur ersparte. Herkömmliche Allround-Sprachmodelle neigen jedoch dazu, jedes Zögern, Räuspern und jedes korrigierte Wort wortwörtlich niederzuschreiben.
Sagte der Vater etwa „ein Elefant, nein, ein Affe kletterte auf den Baum“, hielten Standardmodelle jeden Versprecher fest. Was der Vater tatsächlich benötigte, war eine spezialisierte Diktiereinheit, die Selbstkorrekturen automatisch verwirft und direkt das beabsichtigte Endergebnis liefert.
Bei der Diktatverarbeitung langer Texte suchen Anwender nicht nach einem Cloud-Dienst, der auf allen Geräten gleichermaßen perfekt wirken will. Ein winziges lokales Werkzeug für die sofortige Vorabschreibung, kombiniert mit einem sparsamen Modell für die logische Bereinigung, ist weitaus praxistauglicher, als den Nutzer zu ständigen Neuaufnahmen zu zwingen.
Whistle liefert den greifbaren Beweis dafür, dass On-Device-Verarbeitung wirtschaftlich und technisch sinnvoll wird, wenn das Modell auf Smartwatch-Größe schrumpft. Anstatt sich am Wettrüsten um Hunderte Milliarden Parameter in der Cloud zu beteiligen, reizt es die Effizienz in netzwerkisolierten Nischen bis an die Grenze aus.
Wenn eine netzwerkunabhängige Uhr gesprochene Befehle innerhalb von 11 Millisekunden versteht, verliert die Cloud-Pflicht für Sprachdienste jede technische Notwendigkeit.
Weiterführende Links:
- Offizielle Ankündigung und Benchmarks von Cactus
- Diskussion in der Hacker News Community