El despliegue de un modelo de 3 billones de parámetros exige habitualmente clusters de cientos de GPU de gama alta equipadas con amplias memorias HBM. La frecuente sincronización tensorial entre aceleradores genera una sobrecarga de comunicación que suele frenar la velocidad de generación a unas pocas decenas de tokens por segundo. Cerebras ha tomado un rumbo arquitectónico completamente diferente: coordinar 59 obleas WSE-3T para alcanzar un rendimiento de entre 1.000 y 2.000 tokens por segundo.
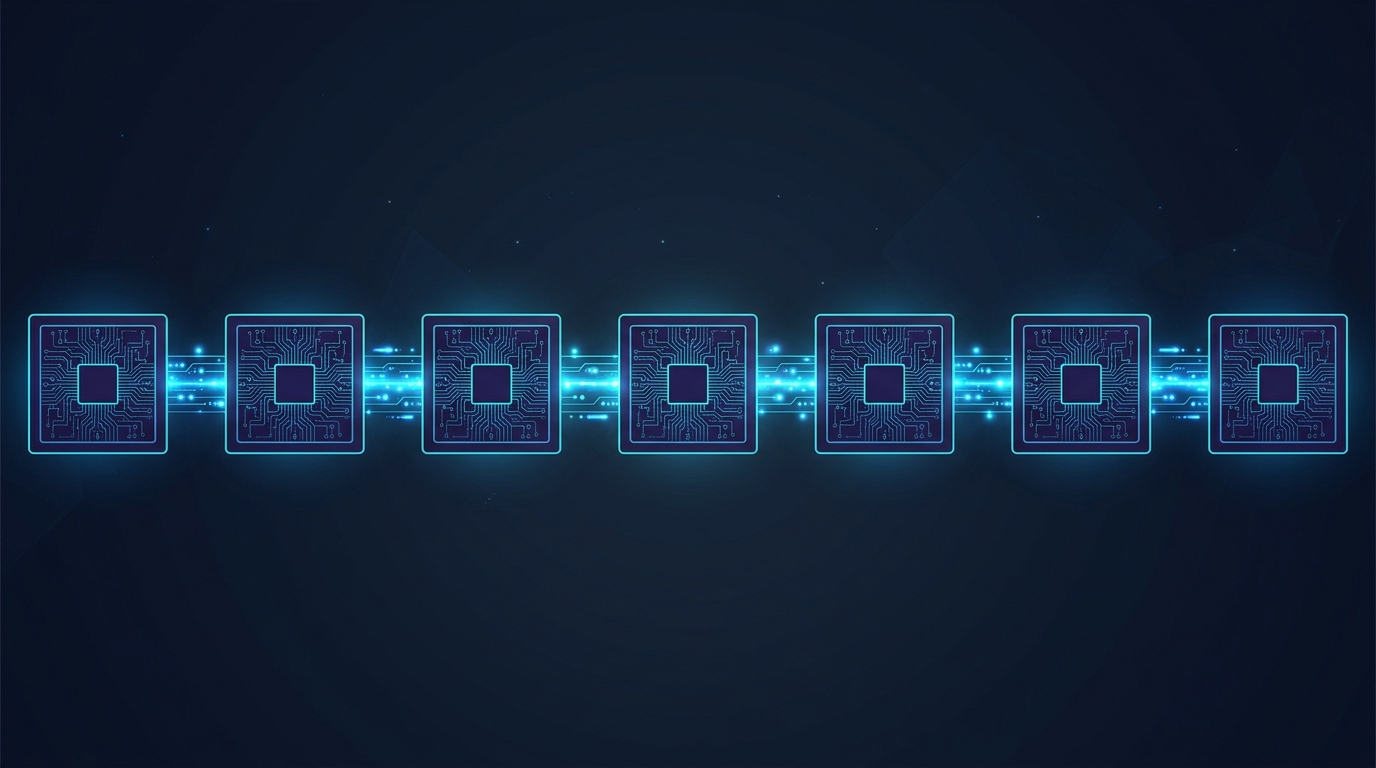
Esta solución rompe con la premisa tradicional de concentrar todo el modelo en un único pool de memoria compartida. Los ingenieros dividieron la red de 93 capas y fijaron de manera permanente sus pesos en la SRAM integrada de 59 obleas de silicio. La comunicación entre chips se redujo a la transmisión de valores de activación en microsegundos. Los chips dejan de comportarse como contenedores pasivos de almacenamiento para transformarse en puestos físicos de trabajo a lo largo de una línea de ensamblaje.
93 capas distribuidas en 59 obleas: pesos fijados permanentemente en la SRAM on-chip
El cuello de botella constante en la inferencia de grandes modelos reside en el ancho de banda de la memoria. Al alcanzar los 3 billones de parámetros, incluso con cuantización a 4 bits, el volumen de pesos asciende a 1,5 TB. En las arquitecturas GPU tradicionales, cada token generado obliga a trasladar ingentes matrices de pesos desde la DRAM externa hasta los núcleos de cómputo, un trasvase continuo de datos que atrapa la velocidad de ejecución tras el muro de la memoria (memory wall).
Una sola oblea WSE-3T integra 44 GB de memoria SRAM on-chip con un ancho de banda de red interno de 53,5 PB/s. Las 93 capas de Kimi K3 demandan una media aproximada de 16 GB de pesos por capa, adaptándose con precisión a la capacidad de una única oblea. Al cargar y anclar permanentemente los parámetros en la SRAM, los ingenieros eliminaron por completo las lentas lecturas hacia la memoria externa.
Al no desplazarse los pesos, la red al completo se despliega como un corredor continuo de silicio. Cada oblea procesa exclusivamente las capas que tiene asignadas, vinculando estrechamente los núcleos de cálculo con su almacenamiento local. Los datos fluyen a través de la topología física del hardware, proyectando de forma directa la estructura del modelo sobre el silicio.
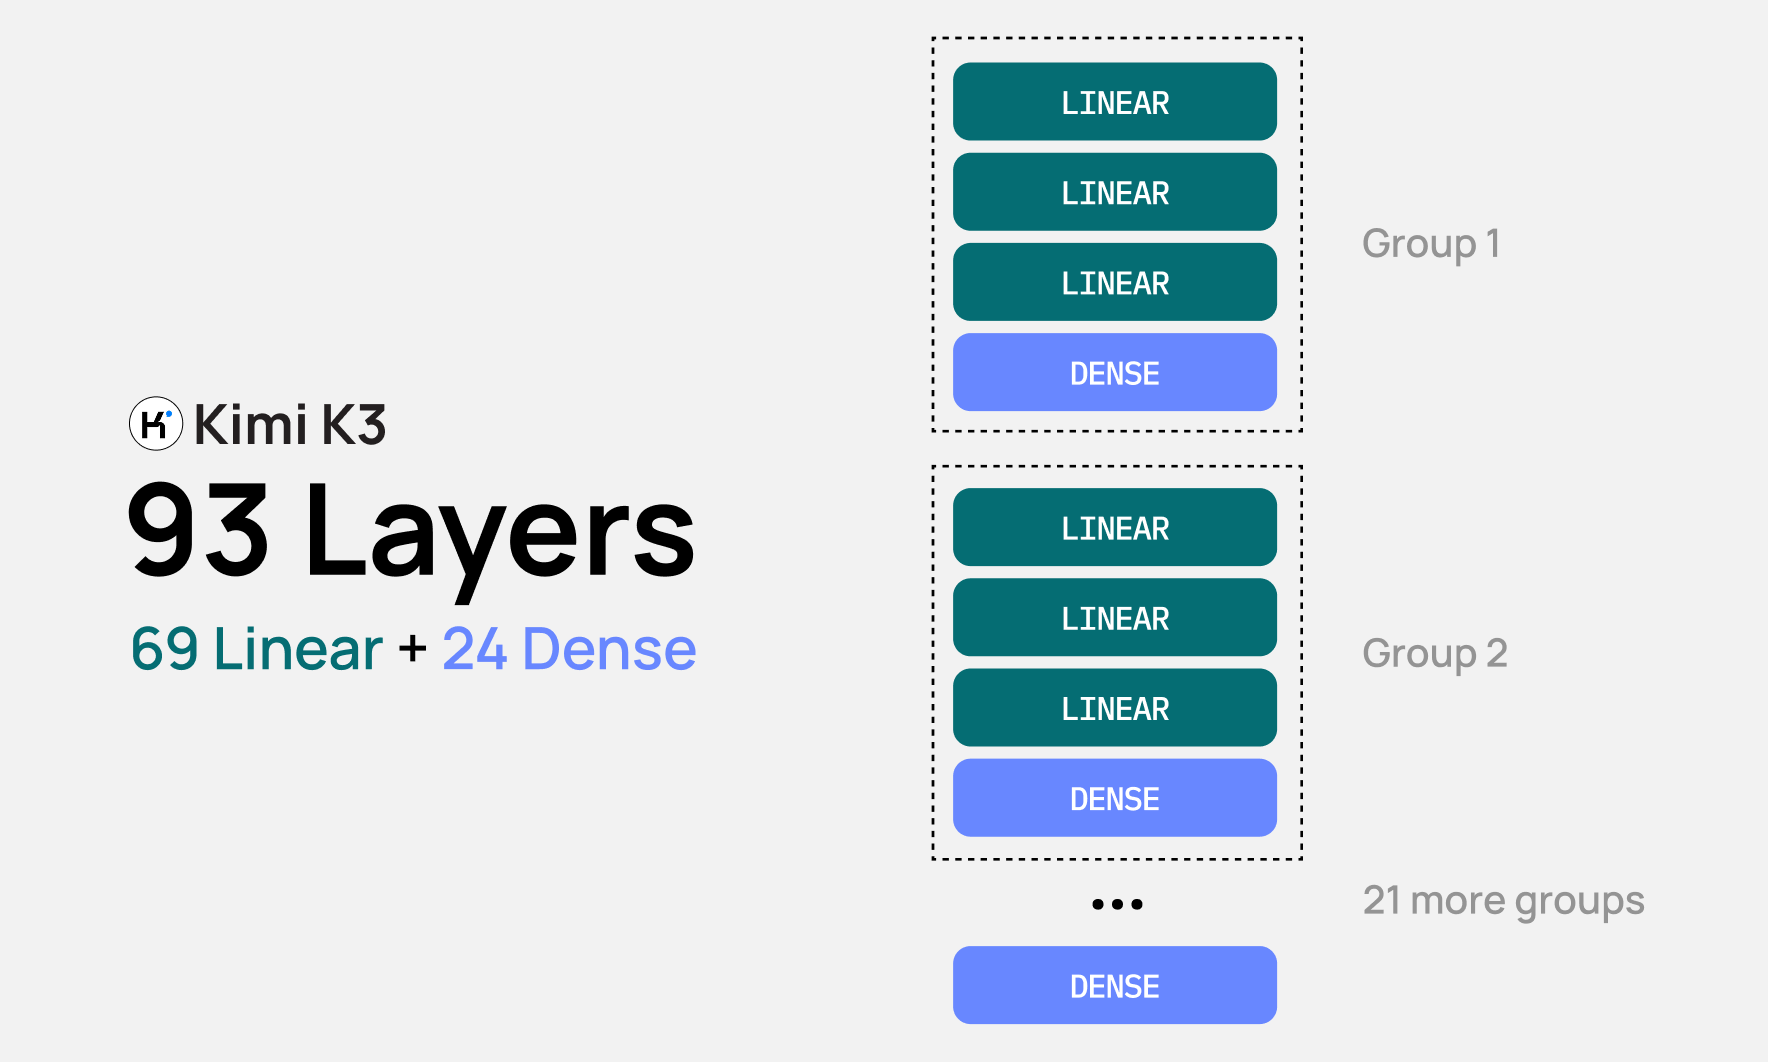 Figura: Estructura de capas de Kimi K3 y esquema de asignación en obleas. Fuente: Blog oficial de Cerebras
Desacoplamiento de capas lineales y densas: optimización de la SRAM al byte
Kimi K3 adopta una arquitectura híbrida compuesta por 69 capas de atención lineal y 24 capas de atención densa. Las pruebas de referencia oficiales de Cerebras contemplaron una longitud media de contexto de 256k tokens, pesos en 4 bits y cachés KV en 8 bits. Dado que ambos mecanismos de atención presentan requisitos de memoria diametralmente opuestos, la distribución exigió una partición meticulosa.
Las capas de atención lineal únicamente precisan mantener un estado oculto de tamaño fijo durante la inferencia. Este coste de almacenamiento permanece inalterable sin importar cuánto se prolongue el contexto de entrada. El peso acumulado de dos capas lineales suma 32 GB, lo que deja en una sola oblea un margen de 12 GB para el búfer de estado estático. De este modo, las 69 capas lineales se acomodan en tan solo 35 obleas.
Por el contrario, las capas de atención densa asumen toda la presión del crecimiento del contexto: una secuencia de 256k tokens provoca que cada petición activa acumule constantemente claves y valores (KV cache). El equipo optó por asignar una oblea completa a cada capa densa. Cada una aloja 16 GB de pesos y reserva los 28 GB restantes de SRAM exclusivamente para la caché KV dinámica. Las 24 capas densas consumen 24 obleas, que junto a las 35 obleas lineales completan el clúster de 59 obleas.
Traspaso exclusivo de activaciones: saltos de 2 microsegundos que impulsan el pipeline
Al quedar los pesos fijados en el chip, la naturaleza de la comunicación interchip cambia de forma radical. Los esquemas convencionales necesitan sincronizar divisiones tensoriales entre dispositivos, donde el ancho de banda del interconector limita la eficiencia global. En el pipeline de Cerebras, lo único que viaja por la red son las activaciones intermedias calculadas en cada capa.
El volumen de datos de activación en cada paso hacia adelante no suele superar unos pocos megabytes. En el sistema CS-4, cada rack integra tres obleas y reduce la latencia de salto entre chips a tan solo 2 microsegundos. Las activaciones se transmiten mediante RDMA sobre Ethernet, y ese coste mínimo de 2 microsegundos por salto mantiene la línea de producción en movimiento casi sin pausas.
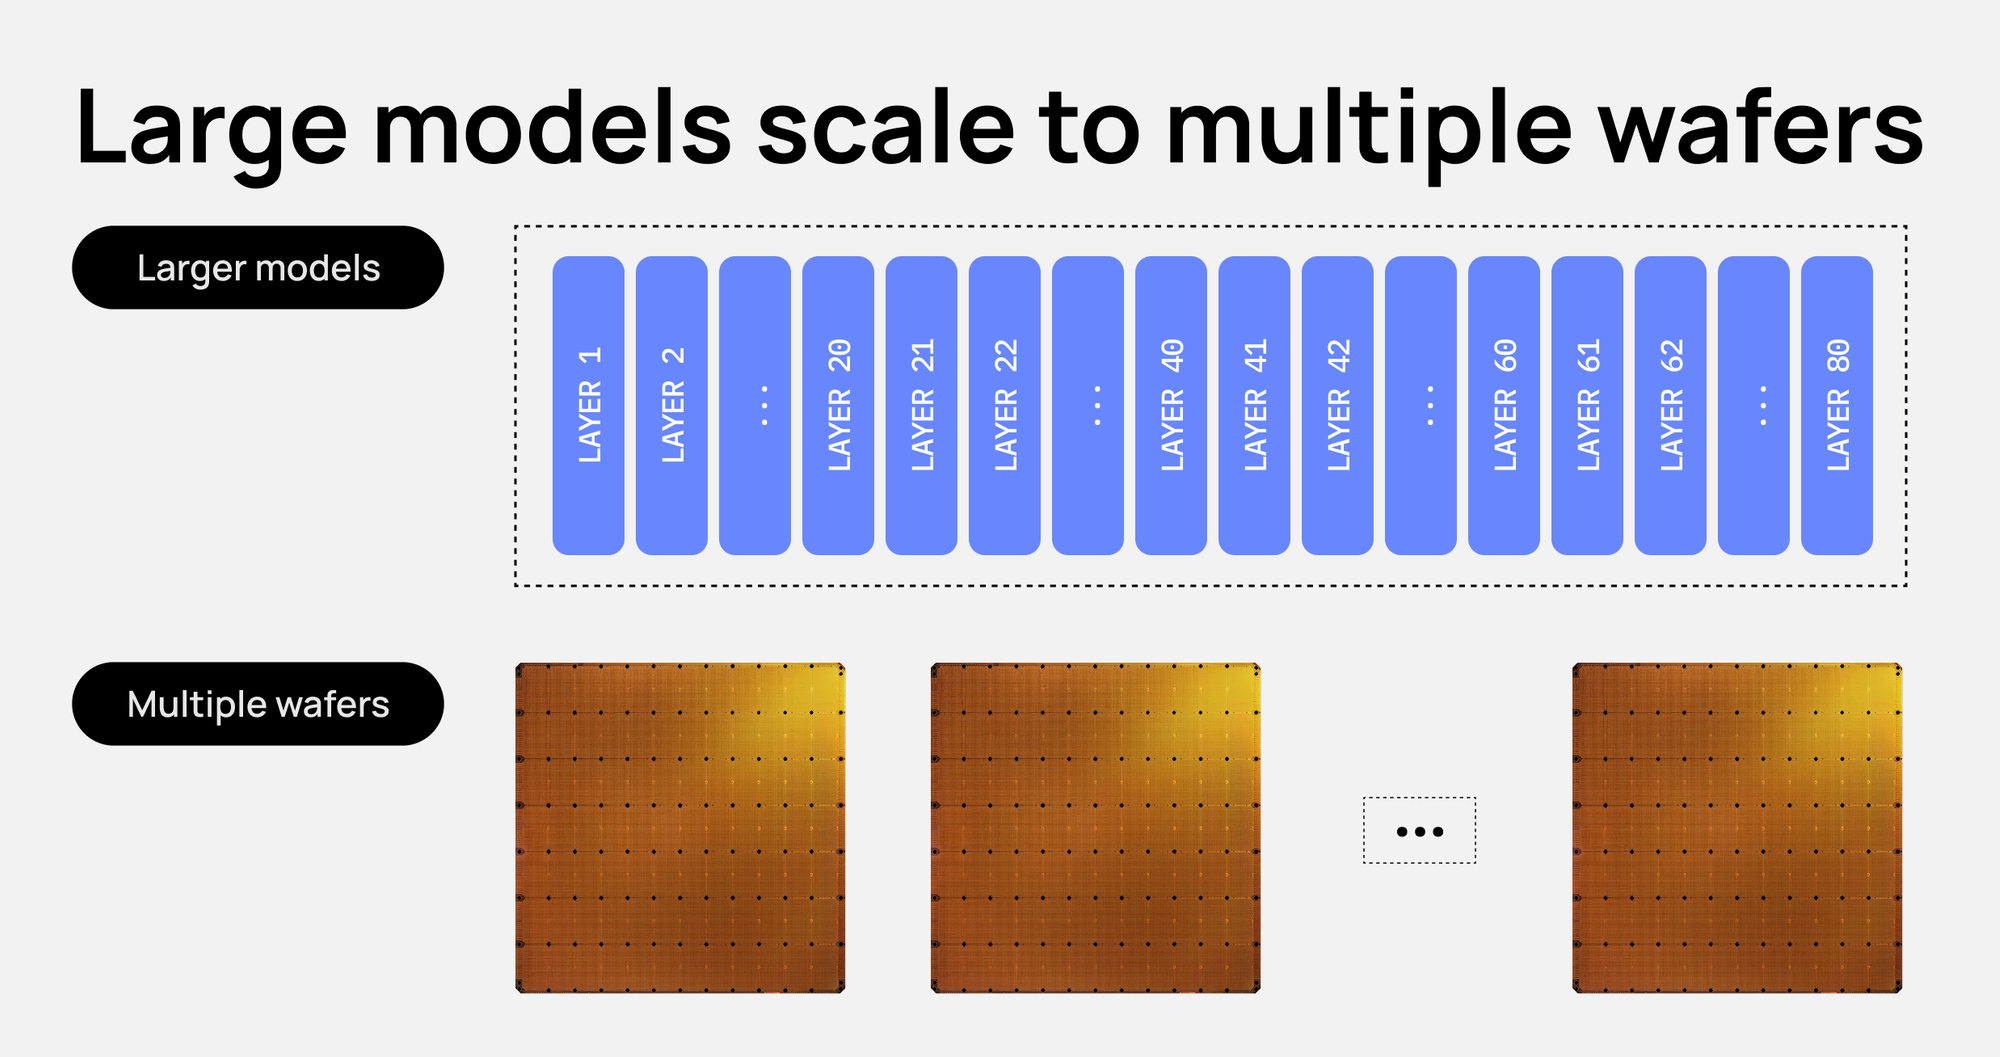 Figura: Topología de comunicación entre obleas en pipeline; las activaciones se transmiten mediante RDMA sobre Ethernet. Fuente: Blog oficial de Cerebras
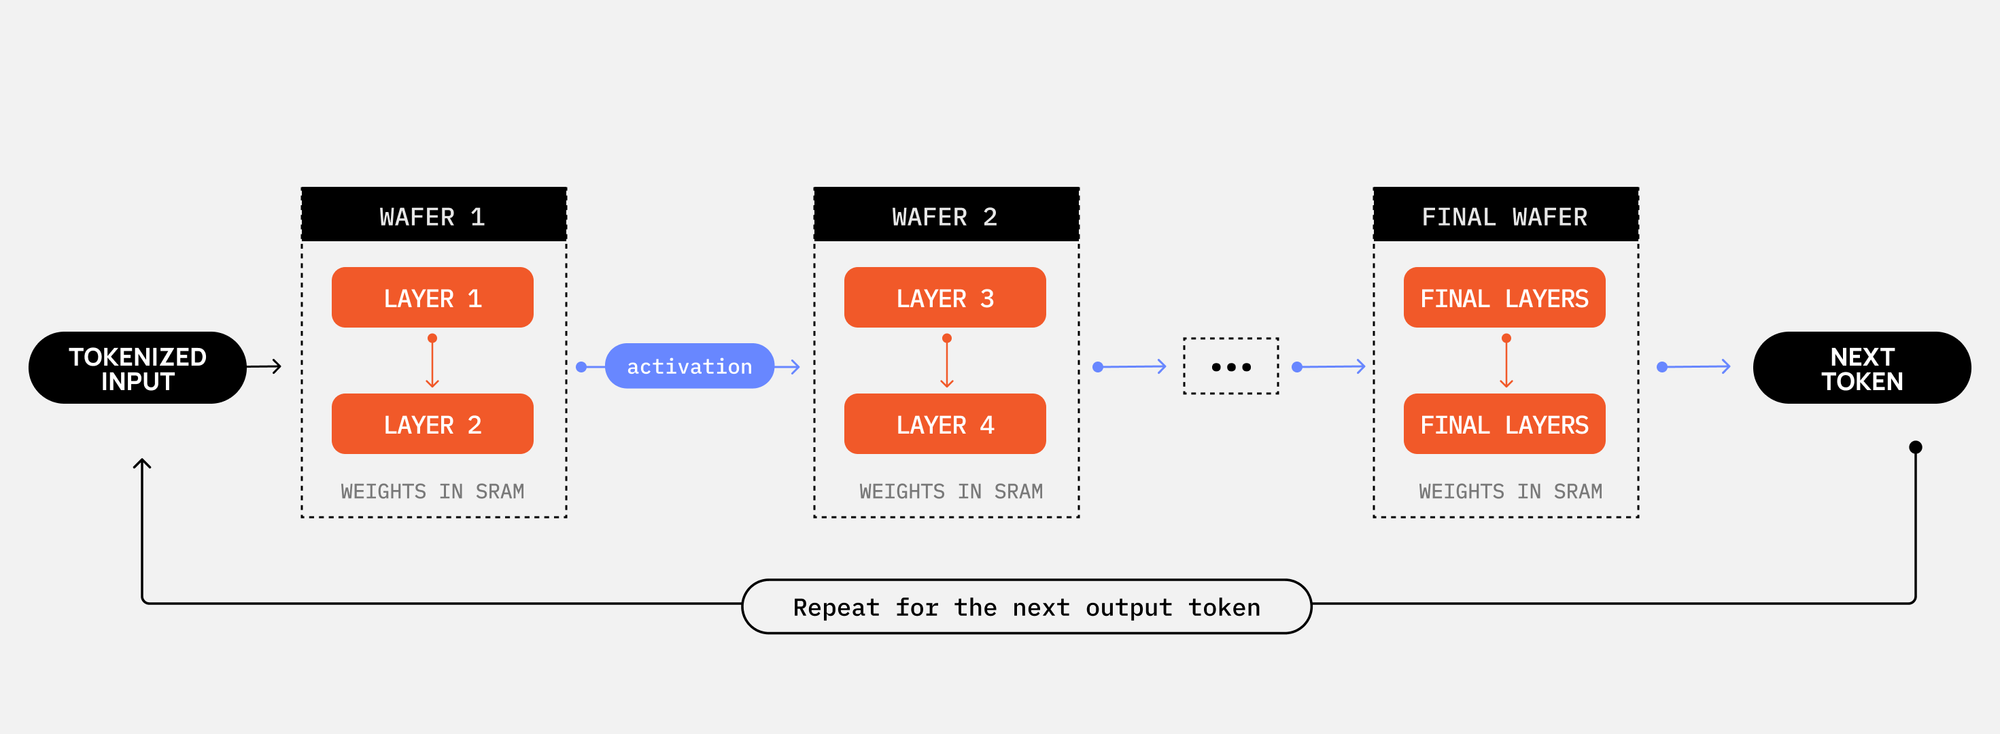 Figura: Perspectiva de línea de montaje con una sola petición fluyendo por las 59 etapas del pipeline. Fuente: Blog oficial de Cerebras
El funcionamiento conjunto del sistema recuerda al de una planta de montaje industrial. En cuanto la primera oblea concluye el cómputo de la entrada, las activaciones se transmiten de inmediato al puesto siguiente. La oblea anterior queda libre de inmediato para recibir la siguiente solicitud. Al sincronizarse las 59 obleas, la latencia de inferencia de cada petición individual se reduce hasta los límites físicos del hardware.
Tras los 2.000 tokens por segundo: la capacidad de SRAM fija el techo de concurrencia
La arquitectura en pipeline permite que distintos puestos procesen peticiones independientes de forma simultánea. Mientras la etapa 3 calcula para el usuario A, la etapa 2 puede procesar en paralelo un micro-batch para el usuario B. La cantidad de peticiones activas equivale aproximadamente al número de etapas del pipeline multiplicado por el tamaño del micro-batch. Los lotes reducidos minimizan la latencia de cada usuario, mientras que los lotes más amplios maximizan el rendimiento global del sistema.
Sin embargo, alcanzar velocidades vertiginosas para un solo usuario impone una restricción de capacidad ineludible. La concurrencia máxima del sistema está estrictamente limitada por la SRAM integrada en las 24 obleas de atención densa. Cada sesión activa debe reservar un espacio dedicado para la caché KV en cada una de las obleas densas. Los 28 GB de espacio disponible determinan de forma rígida el techo máximo de peticiones simultáneas.
La memoria SRAM on-chip proporciona velocidades de miles de tokens por segundo, pero limita la flexibilidad ante la concurrencia masiva. Los clústeres de GPU tradicionales sufren una latencia por petición mayor, pero pueden acoger a decenas de miles de usuarios concurrentes gracias a amplios bancos de memoria externa. En la solución con obleas, cuando la memoria caché se agota, el hardware pierde todo margen de amortiguación. La única vía para ampliar la concurrencia pasa por desplegar otra línea completa de 59 obleas.
Velocidad para un solo usuario frente a concurrencia masiva: dos caminos divergentes en computación
Kimi K3 ha demostrado un rendimiento puntero en las principales evaluaciones de referencia: alcanzó un 88,3% en Terminal-Bench 2.1, rozando el 88,8% de GPT-5.6 Sol, y registró un 91,2% en BrowseComp, superando ligeramente el 90,4% de Sol. Los resultados confirman la solidez de los modelos de pesos abiertos en tareas complejas con agentes autónomos.
Este avance está propiciando una división en los criterios con los que la industria mide la eficiencia en inferencia. Tradicionalmente, la industria ha priorizado el número de conexiones simultáneas y el rendimiento agregado por lotes. Cerebras propone redirigir la métrica hacia los tokens generados por megavatio a una velocidad de salida garantizada. Este indicador evalúa de forma directa la capacidad del sistema para transformar energía eléctrica en interactividad en tiempo real.
Ambas rutas de hardware responden a prioridades comerciales distintas. Los bucles de razonamiento de los agentes demandan respuestas instantáneas, y el pipeline en obleas consigue suprimir los tiempos de espera. Por el contrario, en servicios de API pública con una concurrencia masiva de usuarios, los grupos de memoria GPU compartida siguen ofreciendo una mayor elasticidad económica.
Haber ejecutado un modelo de 3 billones de parámetros en 59 obleas demuestra una vía física factible para superar el muro de la memoria. Al redefinir los chips como estaciones de trabajo activas en una línea de producción en lugar de meros contenedores de almacenamiento, el pipeline wafer-scale redefine los límites de latencia en la inferencia moderna. La próxima contienda tecnológica se decidirá en la fluidez con la que los flujos de datos circulen a través de topologías físicas multidimensionales.
Enlaces de referencia:
- Blog técnico oficial de Cerebras: How We Deploy Trillion-Parameter Frontier Models on Cerebras
- Informe de arquitectura y evaluaciones de rendimiento de Kimi K3
- Libro blanco del sistema Cerebras CS-4