部署 3 万亿参数模型,行业惯例是调集数百张配备大容量 HBM 的高端 GPU。各卡频繁同步张量切片,通信开销直接将生成速度锁在数十 token 每秒。Cerebras 换了一条路线:调用 59 片 WSE-3T 晶圆,跑出了每秒 1000 到 2000 个 token 的吞吐。
这套方案放弃了把完整模型塞进单一显存池的假设。工程师将 93 层网络拆散并固定在 59 片晶圆的片上 SRAM 中,片间通信只剩下微秒级的激活值传递。芯片从此脱离了传统存储容器的定义,转变为流水线上的物理工位。
93层切碎分给59片晶圆,权重钉死在片上
大模型推理的瓶颈长期卡在显存带宽。参数膨胀到 3 万亿时,4-bit 权重体积高达 1.5 TB。传统 GPU 每生成一个 token,都得从外部显存把海量权重搬进计算核心。这一搬运过程直接把生成速度拖入了内存墙困境。
单块 WSE-3T 晶圆拥有 44 GB 片上 SRAM,片上网络聚合带宽达到 53.5 PB/s。Kimi K3 的 93 层网络平均每层占用 16 GB 权重,单张晶圆刚好装得下。工程师将各层参数灌入晶圆并永久锁定,省去了向外读取权重的漫长开销。
参数不再移动,整个网络被拉平成一条晶圆长廊。每片晶圆只执行分配好的网络层,计算核心与存储紧密咬合。数据顺着硬件拓扑依次推进,硬件连接直接映射了模型结构。
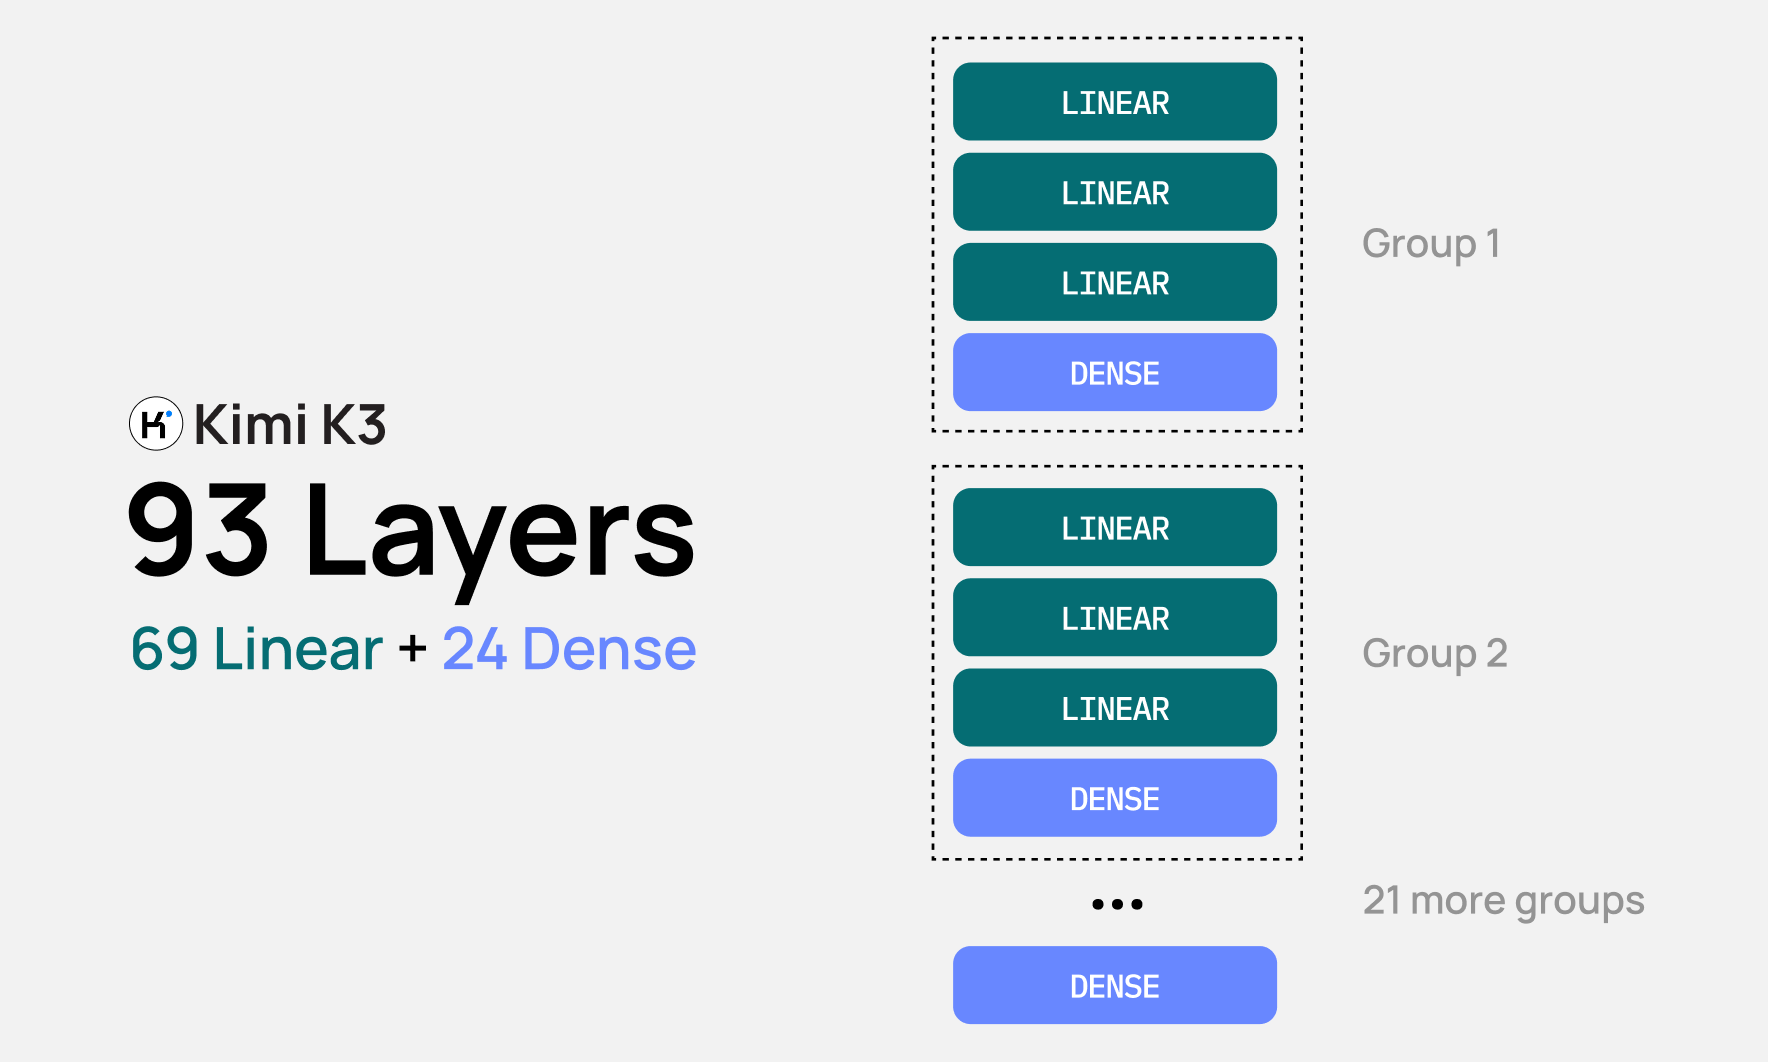 图:Kimi K3 的层结构与晶圆分配方案。来源:Cerebras 官方博客
线性层与稠密层分流,SRAM空间抠到字节级
Kimi K3 混合了 69 个线性注意力层与 24 个稠密注意力层。官方算例设定为 256k 平均上下文长度、4-bit 权重和 8-bit KV 缓存。两种注意力机制对显存的需求差异巨大,部署方案必须精细切分。
线性注意力层在推理时只需维护固定大小的隐藏状态。这一状态开销不随请求上下文拉长而增长。两层线性权重的体积合计 32 GB,单片晶圆还能留出 12 GB 存放固定状态。69 个线性层因此只需 35 片晶圆就能全部排开。
稠密注意力层要承受上下文膨胀的压力,256k 的超长序列让每个在飞请求都在持续累积键值缓存。团队为此采取了一张晶圆一层的分配方式。每片晶圆放置 16 GB 权重,腾出 28 GB SRAM 专门供给动态 KV 缓存。24 个稠密层消耗 24 片晶圆,与 35 片线性晶圆共同组成 59 片的总规模。
跨片只传激活值,2微秒一跳打通流水线
权重锁死在片上,跨芯片通信的内容随之改变。传统方案要在多卡间同步张量切片,带宽直接限制了效率。而在 Cerebras 的流水线中,链路上流动的只有各层计算输出的激活值。
单次前向传递的激活数据量通常只有数兆字节。在 CS-4 架构中,单机架整合三块晶圆,片间延迟被压缩至 2 微秒。激活值借助 RDMA 协议在网络上传递,两微秒一跳的开销几乎不会让流水线停顿。
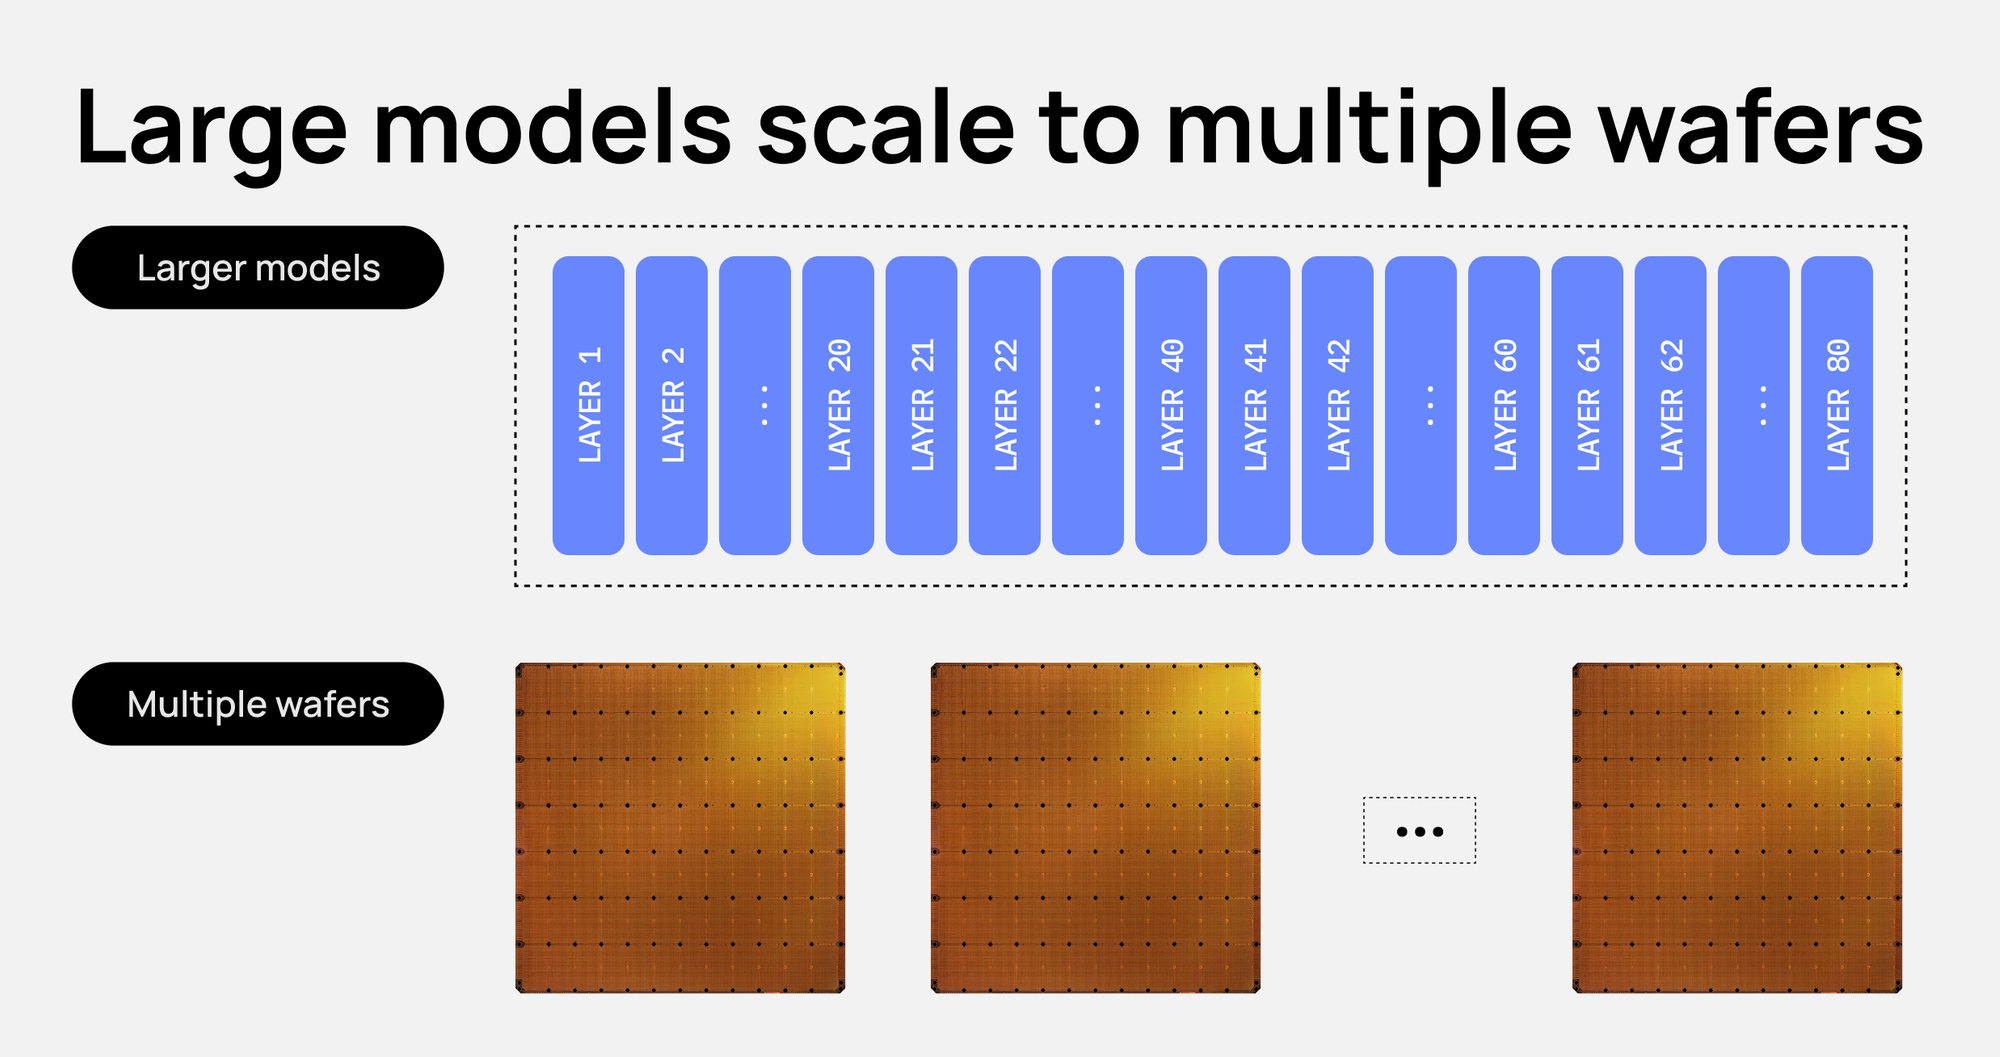 图:多片晶圆连成流水线的通信拓扑,激活值经 RDMA 以太网片间传递。来源:Cerebras 官方博客
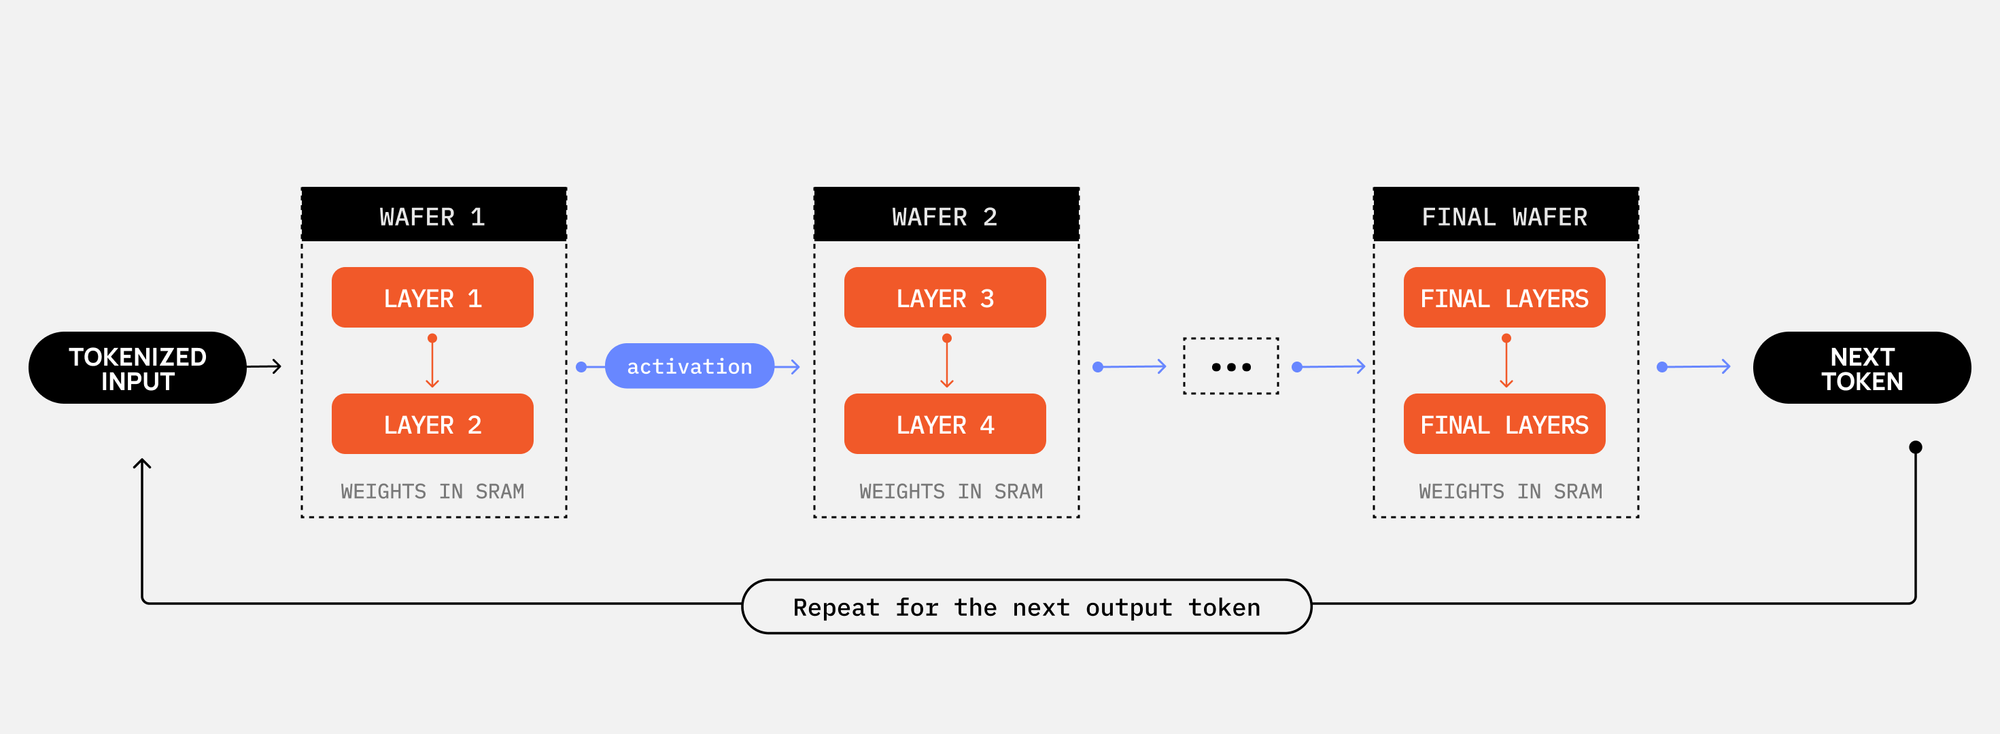 图:单个请求流经各级晶圆的流水线装配视角。来源:Cerebras 官方博客
整套系统运作起来像是一座工业装配车间。第一片晶圆处理完输入,激活值快速送往下游工位。上一级晶圆随即腾空,立刻接收下一个请求的计算指令。59 片晶圆协同运转,单请求处理延迟被压到了硬件极限。
每秒2000个Token背后,SRAM容量画出并发红线
流水线支持不同工位同时处理不同请求。当阶段三在计算用户 A 时,阶段二可以同步处理用户 B 的微批次。在飞请求数量约等于流水线阶段数乘以微批次大小。批次越小单请求响应越迅速,批次越大系统总吞吐越高。
超高的单用户生成速度伴随着严格的容量约束。系统能容纳的最大并发量,被 24 片稠密晶圆上的片上 SRAM 画出了红线。每个活跃请求都必须在每张稠密晶圆上分得一份 KV 缓存。28 GB 的可用空间直接锁死了并发容量上限。
片上 SRAM 换来了每秒数千 token 的生成速度,也限定了系统的并发弹性。 传统方案单请求延迟长,却能靠大容量显存池承接数万并发。晶圆方案的缓存一旦耗尽,硬件就失去了缓冲弹性。扩容并发的唯一手段,就是再部署一条 59 片晶圆的流水线。
单用户极速对抗海量并发,两派算力路线分道扬镳
Kimi K3 在基准测试中展现出顶尖性能。Terminal-Bench 2.1 取得 88.3%,逼近 GPT-5.6 Sol 的 88.8%。BrowseComp 跑出 91.2%,甚至略超 Sol 的 90.4%。测试数据证实,开源模型在复杂智能体任务中表现扎实。
这促使业界对推理效率的度量体系产生分化。长期以来,行业习惯拿并发连接数与批处理吞吐作为核心指标。Cerebras 建议将评估标尺转向同等输出速率下的每兆瓦代币生成量。这一指标直接衡量了系统将电力转化为实时交互能力的能效表现。
两种硬件路线在商业场景中展现出截然相反的权衡取向。智能体反思需要即时响应,晶圆流水线能够消除漫长的等待时间。面对海量并发的公共 API,传统 GPU 显存池依旧更具经济弹性。
59 片晶圆跑通 3 万亿参数模型,给出了突破大模型内存墙的物理路径。芯片脱离了存储容器的预设,转变为流水线上的物理工位。这种设计重写了前沿推理的延迟极限。未来的硬件角逐,将取决于数据流在多维物理拓扑中的流动效率。
参考链接:
- Cerebras 官方技术博客:How We Deploy Trillion-Parameter Frontier Models on Cerebras
- Kimi K3 架构与技术基准测试报告
- Cerebras CS-4 系统硬件白皮书