3兆パラメータ規模のモデルを運用する場合、大容量HBMを備えた数百台規模のハイエンドGPUクラスタを構築するのが業界の常道だった。しかしアクセラレータ間で頻繁に行われるテンソル同期の通信オーバーヘッドにより、生成スループットは毎秒数十トークン程度に抑え込まれてしまう。Cerebrasはこの課題に対して全く異なるアプローチを採った。59枚のWSE-3Tウェハを連携させ、毎秒1,000〜2,000トークンという驚異的なスループットを叩き出したのだ。
この構成は、単一の共有メモリプールにモデル全体を詰め込むという前提を完全に捨て去っている。エンジニアは93層のネットワークを細かく分割し、59枚のウェハのオンチップSRAM上に重みを恒久的に固定した。ウェハ間の通信はマイクロ秒単位のアクティベーション(活性化値)伝送のみに絞り込まれている。チップは従来の受動的なデータ保持コンテナから脱却し、ハードウェアパイプライン上の物理的な組み立てステーションへと進化した。
93層を59枚のウェハに分割配置、重みをオンチップSRAMに完全固定
フロンティアLLMの推論における最大のボトルネックは、長年にわたりメモリ帯域幅であり続けてきた。パラメータ数が3兆に達すると、4ビット量子化を行ってもモデルのサイズは1.5TBに及ぶ。従来のGPUではトークンを1つ生成するたびに、外部DRAMから計算コアへ膨大な重みテンソルを読み込み続けなければならず、このメモリアクセスが生成速度を「メモリの壁」に閉じ込めていた。
単一のWSE-3Tウェハは44GBのオンチップSRAMを内蔵し、チップ内ネットワークの集約帯域は53.5PB/sに達する。Kimi K3の93層は1層あたり平均約16GBの重みで構成されており、単一ウェハの容量に過不足なく収まる。各層のパラメータをウェハに直接展開して恒久的にロックすることで、外部メモリへの低速な読み出しオーバーヘッドを完全に排除した。
重みがチップ上から移動しなくなったことで、ネットワーク全体が連続するシリコンの回廊へと姿を変えた。各ウェハは割り当てられたネットワーク層の演算のみを担当し、計算コアとローカルメモリが緊密に直結する。データはハードウェアの物理トポロジーに沿って順次流れ、モデルの構造グラフがそのままシリコン上に投影されている。
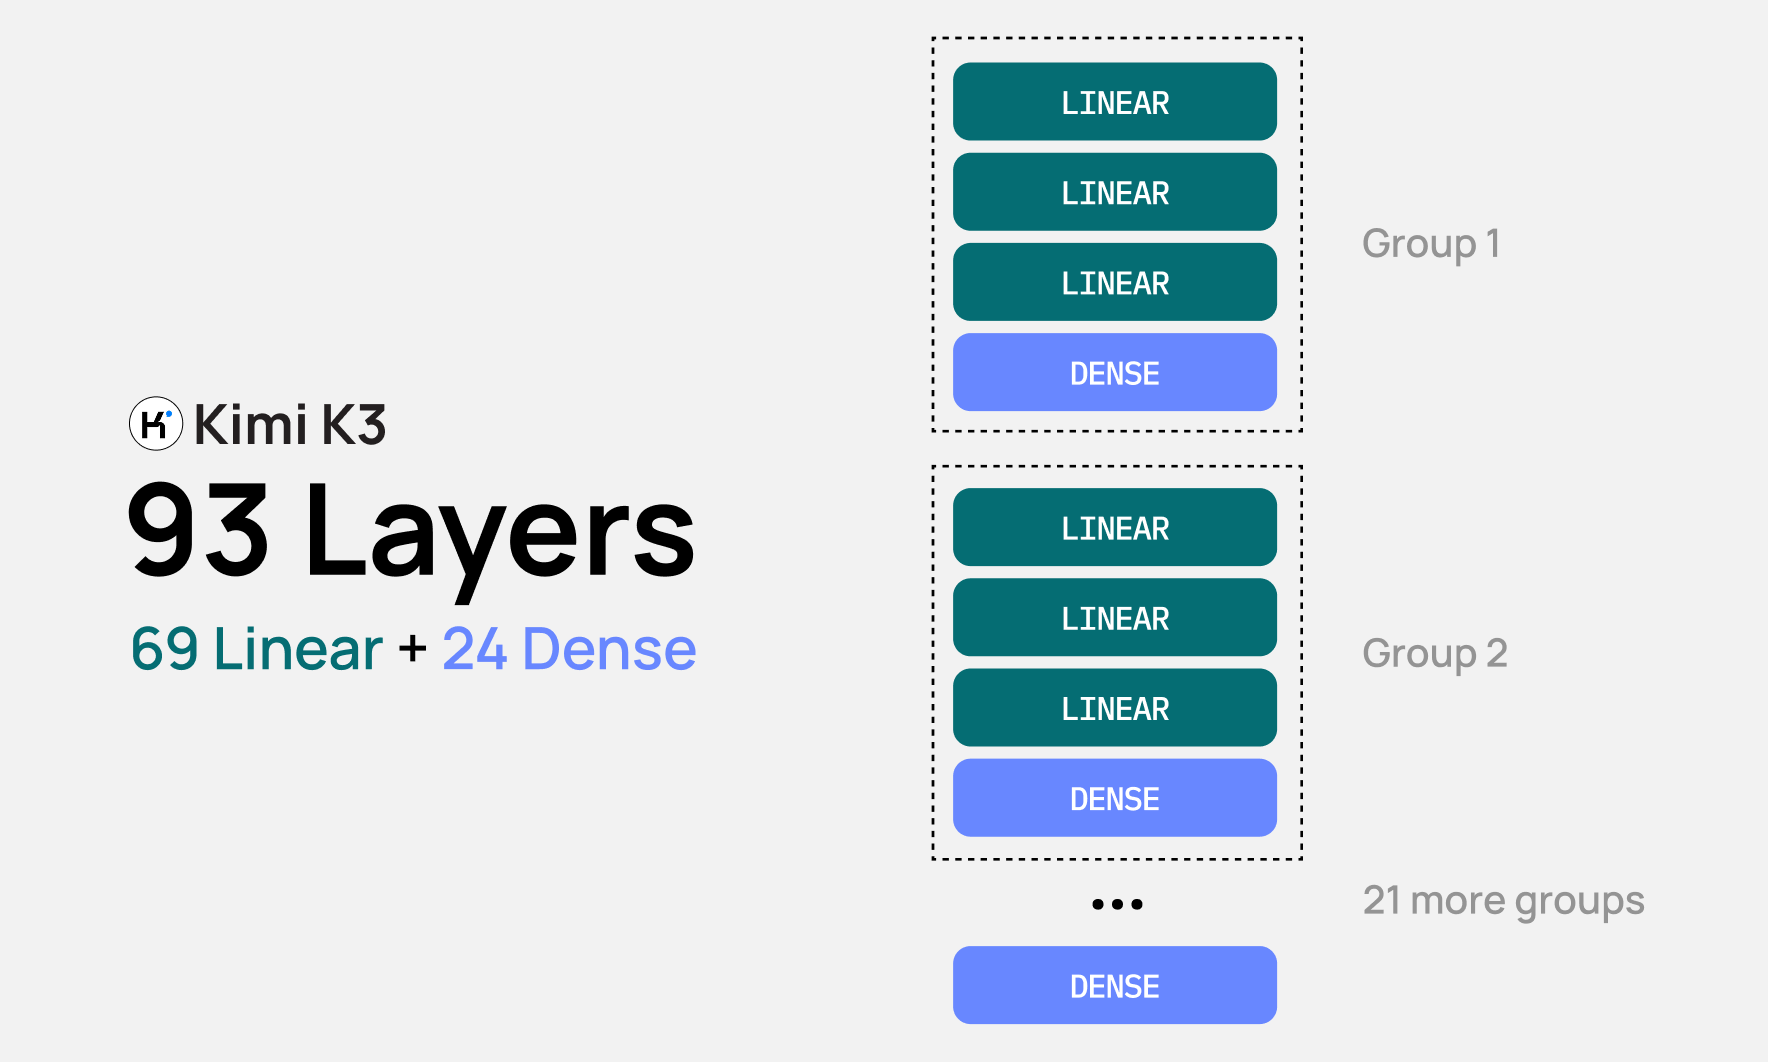 図:Kimi K3のレイヤー構成とウェハ割り当ての詳細。出典:Cerebras公式ブログ
線形アテンションと高密度アテンションの分離、バイト単位のSRAM最適化
Kimi K3は69層のリニアアテンション(線形注意)層と24層のデンスアテンション(高密度注意)層を組み合わせたハイブリッド構成を採用している。Cerebrasによる検証環境では、平均コンテキスト長256kトークン、4ビット重み、8ビットKVキャッシュが設定された。2つのアテンション機構はメモリフットプリントの性質が大きく異なるため、綿密なウェハ分割設計が不可欠となる。
リニアアテンション層は、推論時に固定サイズの隠れ状態のみを維持すればよい。この状態保持コストはコンテキスト長が伸びても肥大化しない。リニア層2回分の重みサイズは合計32GBであり、単一ウェハ上に12GBの固定状態バッファ領域を残すことができる。そのため、69のリニア層はわずか35枚のウェハですべて配置完了する。
一方、デンスアテンション層はコンテキスト伸長に伴うメモリ増大の負荷を直接受ける。256kの超長文シーケンスでは、処理中のリクエストごとにキー・バリュー(KV)キャッシュが継続的に蓄積される。そこで開発チームはデンス層1層につきウェハ1枚を丸ごと割り当てる方式を採用した。各ウェハに16GBの重みを載せ、残り28GBのSRAMを動的KVキャッシュ専用に確保した。24のデンス層に24枚のウェハを割り当て、リニア層向けの35枚と合わせて計59枚のクラスタを構成している。
ウェハ間は活性化値のみを伝送、2マイクロ秒のホップがパイプラインを貫く
重みがオンチップ上に常駐固定されたことで、チップ間通信の役割は根本から変わった。従来のマルチGPU環境ではテンソル分割の同期が必須であり、インターコネクト帯域がボトルネックとなっていた。しかしCerebrasのパイプラインでは、ネットワークを流れるデータは各層のフォワードパスで出力された活性化値(アクティベーション)のみである。
1回のフォワードステップで生成される活性化データは数メガバイト程度にすぎない。CS-4システムアーキテクチャでは、1ラックに3枚のウェハが収容され、ウェハ間のホップ遅延はわずか2マイクロ秒に圧縮されている。活性化値はRDMA over Ethernet経由で伝送され、2マイクロ秒のホップオーバーヘッドはパイプラインをほとんど停滞させない。
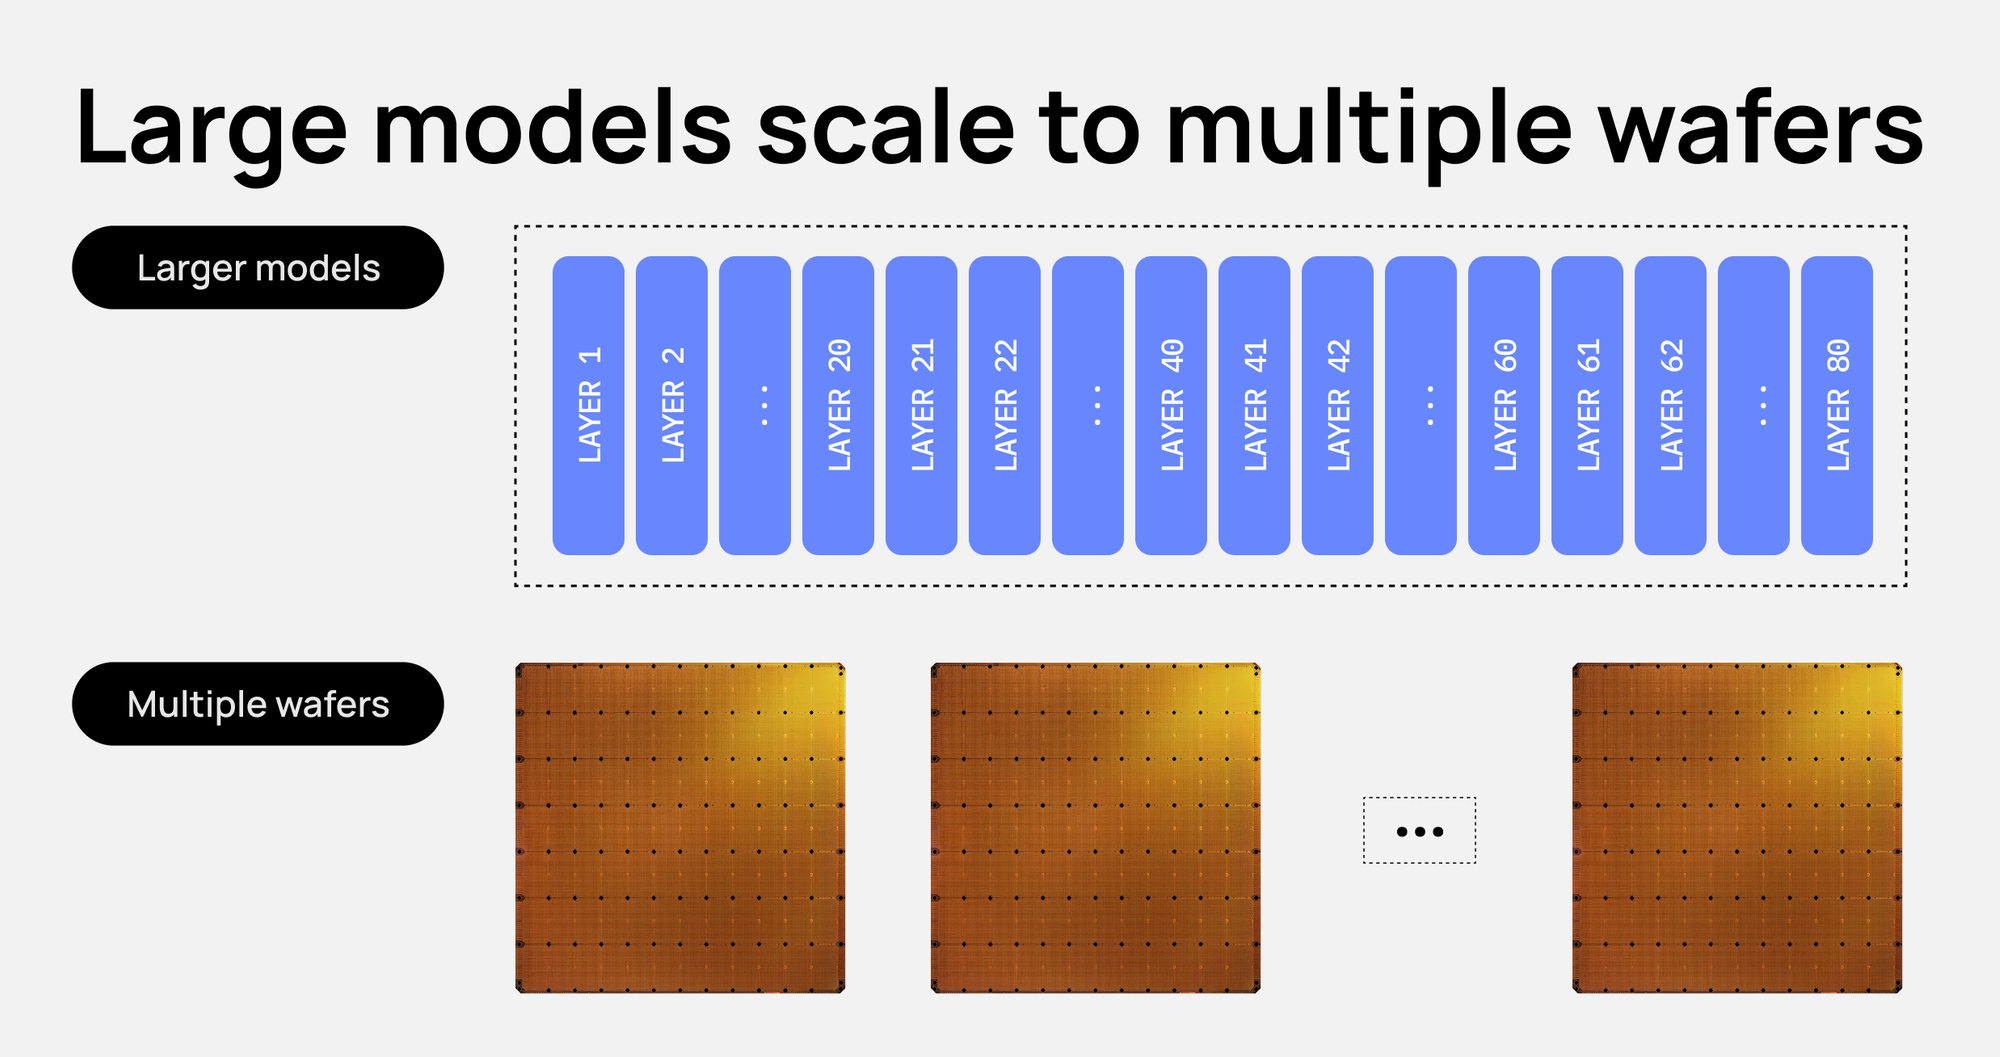 図:複数のウェハを連携させたパイプラインの通信トポロジー。活性化値はRDMA over Ethernet経由でチップ間を流れる。出典:Cerebras公式ブログ
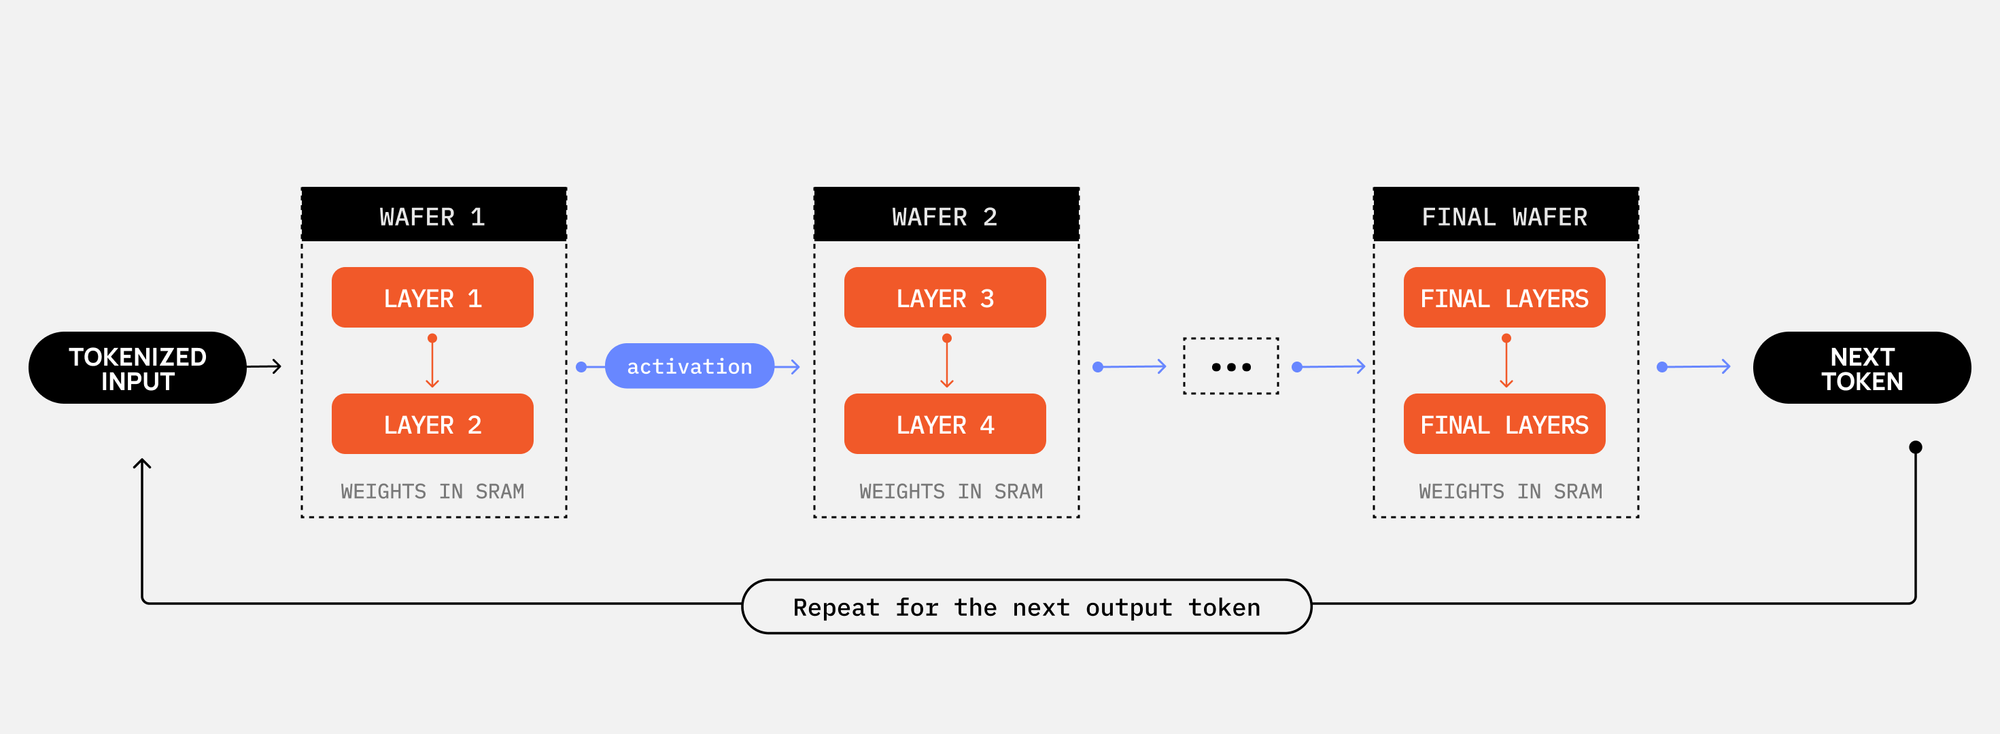 図:単一リクエストが各ウェハ段を流れるパイプライン組み立て工程の視点。出典:Cerebras公式ブログ
システム全体の稼働風景はまさに工業製品の組み立てラインそのものだ。最初のウェハが入力を処理し終えると、活性化値は即座に後続の作業ステーションへ送出される。前段のウェハは即座に解放され、次のリクエストの演算処理を直ちに取り込む。59枚のウェハが同期連動することで、単一リクエストの処理遅延はハードウェアの物理限界にまで削ぎ落とされる。
毎秒2,000トークンの裏側:SRAM容量が規定する同時実行数の境界線
パイプラインアーキテクチャは、異なるステーションが異なるリクエストを並行処理することを可能にする。ステージ3がユーザーAのリクエストを演算している最中に、ステージ2はユーザーBのマイクロバッチを同時に処理できる。システム内で並行稼働するインフライトリクエストの数は、概ね「パイプライン段数 × マイクロバッチサイズ」に比例する。バッチサイズを絞れば単一リクエストの応答が極限まで高速化し、バッチサイズを広げればシステム全体のスループットが向上する。
しかし、卓越した単一ユーザー生成速度には厳格な容量制約が伴う。システムが許容できる最大同時実行数は、24枚のデンスアテンションウェハ上のオンチップSRAM容量によって厳しく制限されている。各アクティブセッションは、すべてのデンスウェハ上でKVキャッシュ領域を確保しなければならない。28GBの利用可能SRAM領域が、同時実行セッション数の物理的上限を決定づけている。
オンチップSRAMは毎秒数千トークンという超高速生成を実現する一方で、同時実行の柔軟性を制約する。 従来のGPUクラスタは単一リクエストの遅延こそ大きいものの、広大な外部メモリプールによって数万単位の同時リクエストを吸収できる。ウェハ構成では一度キャッシュを使い果たすとバッファの余力が失われるため、同時実行容量を増やす唯一の手段は「59枚のウェハパイプラインを丸ごと追加配備すること」となる。
単一ユーザーの極速 vs 大規模同時実行:二極化する計算基盤の針路
Kimi K3はベンチマークにおいて世界最高水準の性能を記録した。Terminal-Bench 2.1で88.3%を記録してGPT-5.6 Solの88.8%に迫り、BrowseCompでは91.2%をマークしてSolの90.4%をわずかに上回った。オープンウェイトのフロンティアモデルが複雑な自律エージェントタスクにおいて確固たる実力を備えていることが実証された。
この成果は、推論効率に対する業界の評価軸に分化を促している。長年にわたり業界は、同時接続数やバッチスループットを主要指標として捉えてきた。しかしCerebrasは、一定の出力速度を維持した条件下での「1メガワットあたりのトークン生成効率」へと評価基準を移行すべきだと提言している。この指標は、システムが消費電力をリアルタイムな対話能力へどれほど高効率に変換できているかを如実に表す。
2つのハードウェアアーキテクチャは、ビジネス現場において明確に異なるトレードオフを示している。自律エージェントの思考プロセスには即座のフィードバックが求められ、ウェハパイプラインは待ち時間をほぼゼロにする。一方で、不特定多数の膨大なアクセスを捌くパブリックAPI環境では、従来のGPU共有メモリプールのほうが依然として優れた経済的弾力性を備えている。
59枚のウェハによって3兆パラメータモデルを稼働させた成果は、大規模モデルの「メモリの壁」を突破する新たな物理的指針を示した。チップを受動的なストレージからパイプラインの組み立て工程へと再定義する設計は、フロンティア推論の遅延限界を塗り替えた。今後のハードウェア競争は、多次元の物理トポロジーの中でデータフローをいかに無駄なく循環させられるかに委ねられている。
参考リンク:
- Cerebras 公式技術ブログ:How We Deploy Trillion-Parameter Frontier Models on Cerebras
- Kimi K3 アーキテクチャおよび技術ベンチマークレポート
- Cerebras CS-4 システムハードウェアホワイトペーパー