Pour déployer un modèle comptant 3 000 milliards de paramètres, l’usage établi consiste à mobiliser des grappes de centaines de GPU haut de gamme pourvus de vastes réserves de mémoire HBM. Mais la synchronisation tensorielle permanente entre accélérateurs entraîne une surcharge de communication qui bride le débit à quelques dizaines de tokens par seconde. Cerebras a emprunté une voie architecturale radicalement différente : orchestrer 59 wafers WSE-3T pour atteindre une cadence comprise entre 1 000 et 2 000 tokens par seconde.
Cette approche abandonne le postulat traditionnel consistant à loger l’intégralité du modèle dans un pool de mémoire partagé. Les ingénieurs ont découpé le réseau de 93 couches et figé les poids de manière permanente dans la mémoire SRAM on-chip de 59 wafers de silicium. La communication inter-puces se résume au transfert ultra-rapide des activations en quelques microsecondes. Les puces cessent d’être de simples conteneurs de stockage passifs pour devenir des postes de travail physiques le long d’une ligne d’assemblage matériel.
93 couches réparties sur 59 wafers : des poids verrouillés dans la SRAM on-chip
Le goulet d’étranglement historique de l’inférence des modèles de pointe réside dans la bande passante mémoire. À l’échelle de 3 000 milliards de paramètres, même quantifiés en 4 bits, les poids représentent un volume de 1,5 To. Sur les architectures GPU classiques, la génération de chaque token exige d’extraire d’imposants tenseurs de poids depuis la DRAM externe pour les injecter dans les cœurs de calcul. Ce transfert continu de données emprisonne la cadence d’exécution derrière le « mur de la mémoire » (memory wall).
Un unique wafer WSE-3T embarque 44 Go de SRAM intégrée, avec une bande passante réseau on-chip agrégée de 53,5 Po/s. Les 93 couches de Kimi K3 nécessitent en moyenne environ 16 Go de poids par couche, ce qui correspond exactement à la capacité d’un wafer. En chargeant et en verrouillant définitivement les paramètres dans la SRAM, les concepteurs ont éliminé le coût temporel des lectures en mémoire externe.
Puisque les poids restent immobiles, le réseau tout entier s’étend comme un long corridor de silicium. Chaque wafer exécute exclusivement les couches qui lui sont assignées, couplant directement les cœurs de calcul à leur mémoire locale. Les données progressent le long de la topologie physique du matériel : la structure du modèle se projette directement sur le silicium.
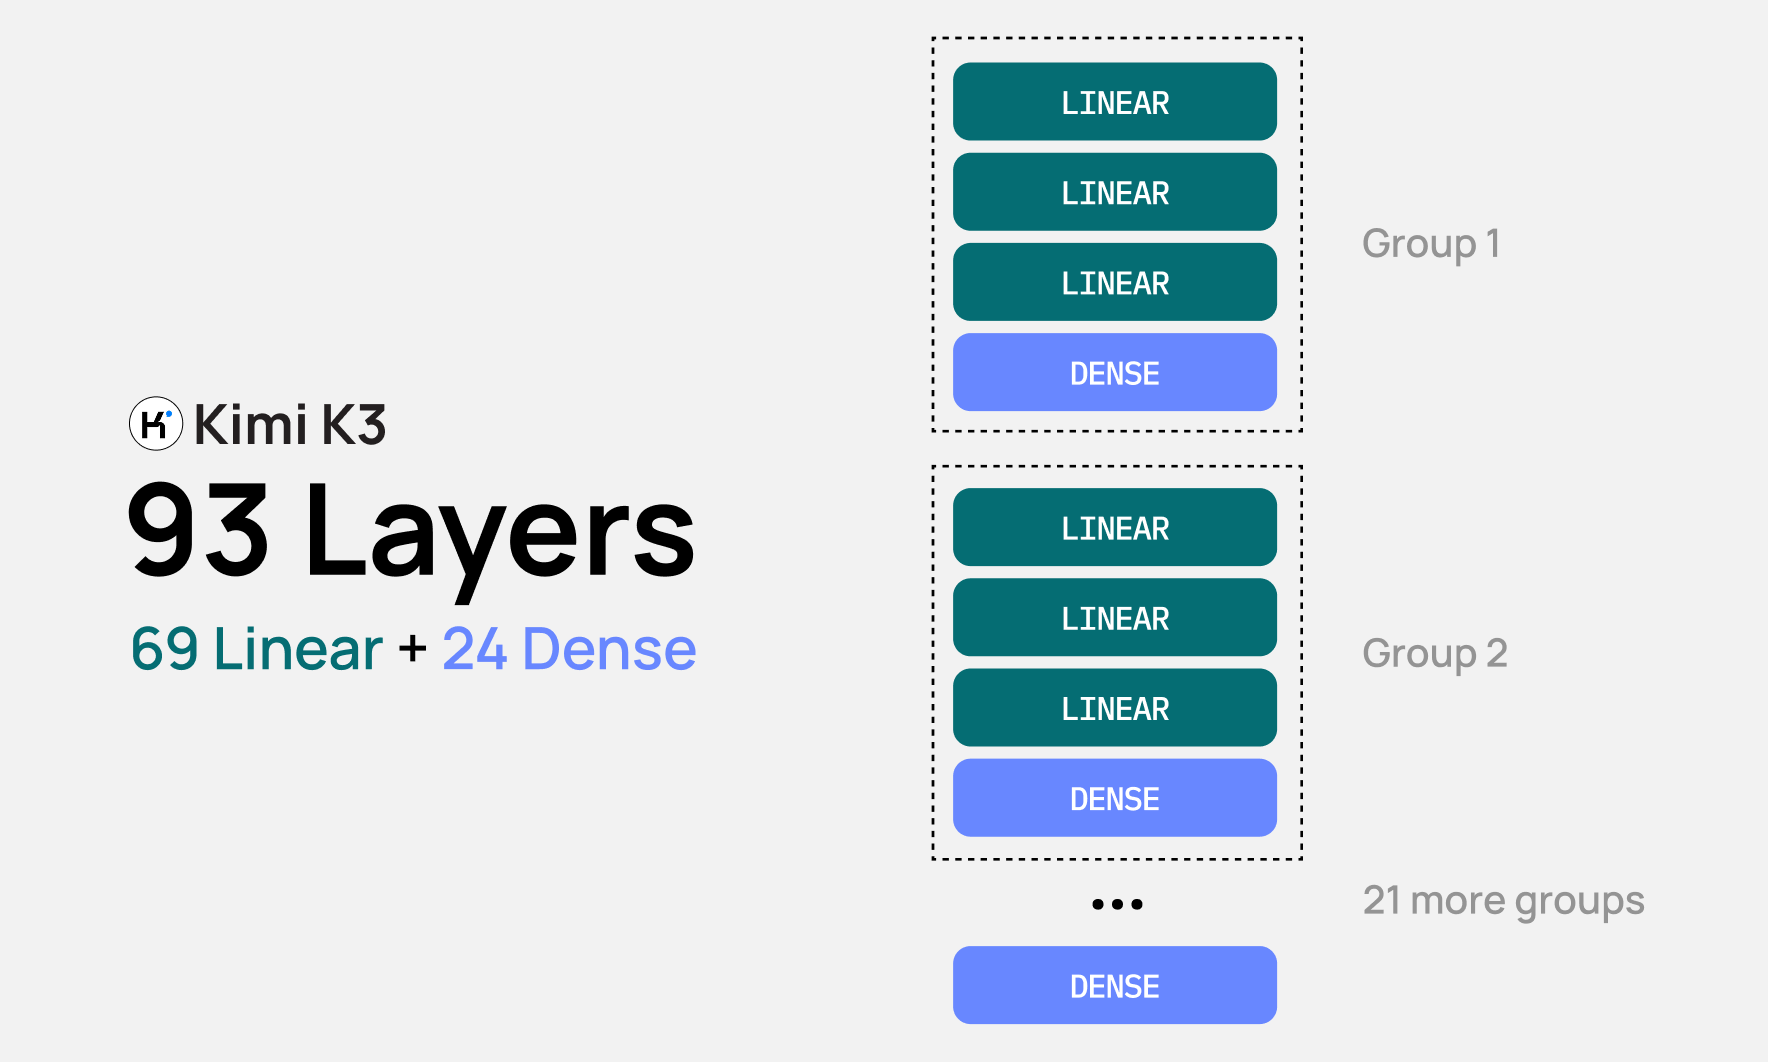 Figure : Architecture des couches de Kimi K3 et schéma de répartition par wafer. Source : Blog officiel de Cerebras
Découplage des couches linéaires et denses : une gestion de la SRAM ajustée à l’octet près
Kimi K3 repose sur une architecture hybride associant 69 couches d’attention linéaire et 24 couches d’attention dense. L’évaluation de référence menée par Cerebras a été calibrée sur une longueur de contexte moyenne de 256k tokens, avec des poids en 4 bits et des caches KV en 8 bits. Les deux mécanismes d’attention présentant des profils d’utilisation mémoire radicalement différents, le partitionnement a exigé un découpage rigoureux.
Les couches d’attention linéaire n’ont besoin de maintenir qu’un état caché de taille fixe au cours de l’inférence. Cette charge mémoire ne croît pas lorsque le contexte s’allonge. Deux couches linéaires cumulent 32 Go de poids, laissant une marge de 12 Go sur un seul wafer pour conserver les états statiques. Par conséquent, les 69 couches linéaires tiennent sur seulement 35 wafers.
À l’inverse, les couches d’attention dense absorbent toute la pression de l’expansion du contexte : sur une séquence de 256k tokens, chaque requête en cours accumule en continu des paires clés-valeurs (cache KV). L’équipe a donc choisi d’allouer un wafer complet par couche dense. Chaque wafer accueille 16 Go de poids et réserve les 28 Go de SRAM restants exclusivement au cache KV dynamique. Les 24 couches denses mobilisent 24 wafers, qui viennent compléter les 35 wafers linéaires pour former l’ensemble des 59 wafers.
Transfert exclusif des activations : des sauts de 2 microsecondes pour fluidifier le pipeline
Dès lors que les poids demeurent fixés sur la puce, la nature des communications inter-puces change du tout au tout. Les approches traditionnelles synchronisent des partitions de tenseurs entre processeurs, où la bande passante de l’interconnexion dicte la cadence. Dans le pipeline de Cerebras, seules transitent sur le réseau les activations issues du calcul de chaque couche.
Le volume de données d’activation pour une seule passe avant ne dépasse généralement pas quelques mégaoctets. Dans l’architecture du système CS-4, chaque rack regroupe trois wafers et ramène la latence de saut entre puces à seulement 2 microsecondes. Les activations cheminent via le protocole RDMA over Ethernet, et ce surcoût infime de 2 microsecondes par saut ne provoque quasiment aucun arrêt dans la chaîne de traitement.
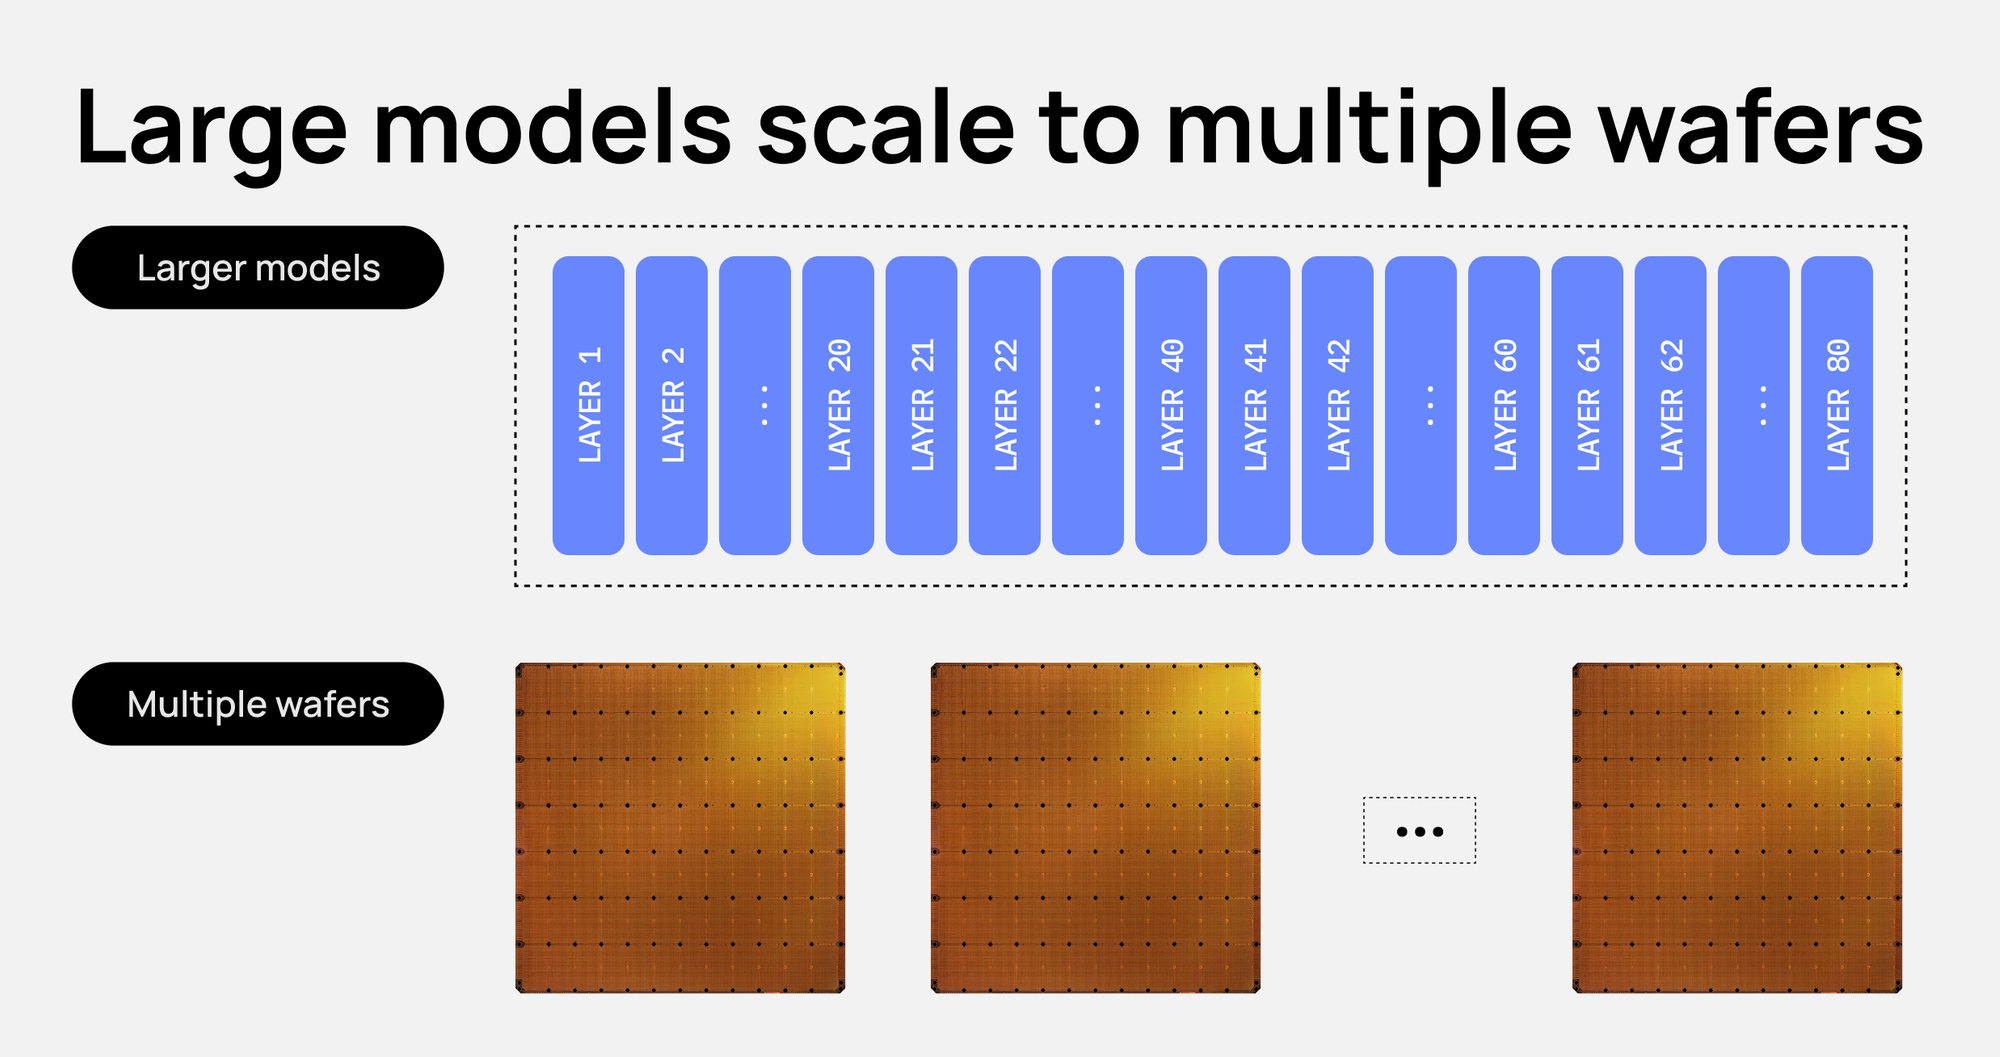 Figure : Topologie de communication entre wafers montés en pipeline ; les activations transitent via RDMA over Ethernet. Source : Blog officiel de Cerebras
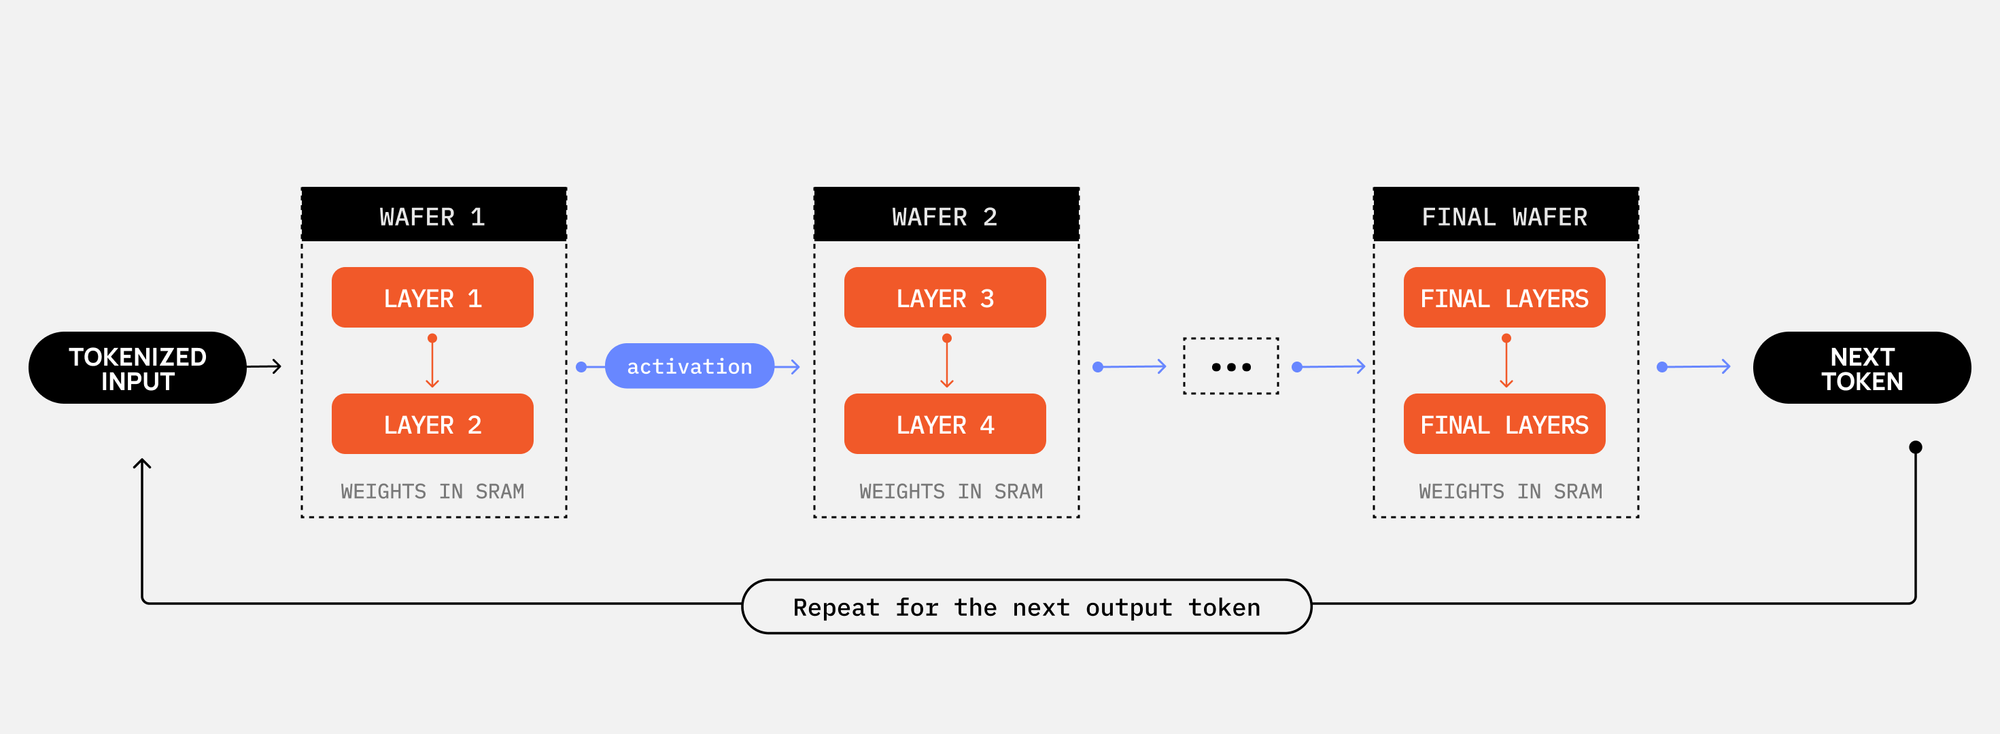 Figure : Vue en chaîne de montage d’une requête individuelle progressant à travers les 59 étapes du pipeline. Source : Blog officiel de Cerebras
L’ensemble fonctionne à la manière d’une usine d’assemblage automatisée. Dès que le premier wafer achève le traitement de son entrée, les activations sont immédiatement transmises au poste situé en aval. Le wafer amont se libère aussitôt pour accueillir les instructions de calcul de la requête suivante. Grâce à la synchronisation des 59 wafers, la latence de traitement pour chaque requête individuelle est abaissée aux limites physiques du silicium.
Derrière les 2 000 tokens/s : la capacité de SRAM impose le plafond de concurrence
L’architecture en pipeline autorise différents postes à traiter simultanément des requêtes distinctes. Pendant que l’étape 3 calcule pour l’utilisateur A, l’étape 2 peut traiter en parallèle un micro-lot pour l’utilisateur B. Le nombre de requêtes actives en cours de traitement correspond approximativement au nombre d’étapes du pipeline multiplié par la taille du micro-lot. Des lots réduits minimisent le temps de réponse pour chaque utilisateur, tandis que des lots plus grands maximisent le débit global du système.
Néanmoins, cette vitesse d’exécution exceptionnelle pour un utilisateur unique s’accompagne d’une contrainte de capacité stricte. La concurrence maximale supportée par le système est strictement plafonnée par la mémoire SRAM on-chip disponible sur les 24 wafers d’attention dense. Chaque session active doit disposer d’un espace réservé pour son cache KV sur chacun des wafers denses. Les 28 Go d’espace disponible fixent ainsi une limite infranchissable au nombre de requêtes simultanées.
La mémoire SRAM on-chip offre des débits de plusieurs milliers de tokens par seconde, mais restreint la souplesse face à une concurrence massive. Les clusters de GPU conventionnels souffrent d’une latence par requête plus élevée, mais peuvent absorber des dizaines de milliers d’utilisateurs simultanés grâce à leurs vastes pools de mémoire externe. Sur la solution à base de wafers, une fois le cache saturé, le matériel ne dispose plus d’aucune marge d’amortissement. La seule solution pour étendre la concurrence consiste à déployer une nouvelle chaîne complète de 59 wafers.
Vitesse mono-utilisateur contre concurrence massive : deux visions divergentes du calcul
Kimi K3 a démontré des performances de premier ordre lors des tests de référence : avec un score de 88,3 % sur Terminal-Bench 2.1, il talonne les 88,8 % de GPT-5.6 Sol ; sur BrowseComp, il atteint 91,2 %, devançant légèrement les 90,4 % de Sol. Ces mesures confirment la solidité des modèles ouverts dans l’exécution de tâches complexes d’agents autonomes.
Cette avancée conduit l’industrie à faire évoluer ses critères de mesure de l’efficacité de l’inférence. Pendant longtemps, l’accent a été mis sur le nombre de connexions simultanées et le débit global par lots. Cerebras préconise de faire évoluer cette métrique vers le volume de tokens générés par mégawatt à une vitesse d’exécution garantie. Cet indicateur mesure directement l’aptitude d’une infrastructure à convertir l’énergie électrique en réactivité conversationnelle en temps réel.
Ces deux philosophies matérielles répondent à des arbitrages économiques bien distincts. Les boucles de réflexion des agents d’IA exigent des retours quasi instantanés, un scénario où le pipeline wafer-scale efface tout temps d’attente. En revanche, pour des API publiques traitant un trafic simultané gigantesque, les réserves de mémoire partagée des GPU traditionnels conservent une meilleure élasticité économique.
Faire tourner un modèle de 3 000 milliards de paramètres sur 59 wafers ouvre une voie physique concrète pour franchir le mur de la mémoire. En redéfinissant la puce comme un poste d’assemblage actif plutôt que comme un simple réservoir passif, le pipelining wafer-scale redessine les limites de latence de l’inférence moderne. La prochaine bataille du matériel se jouera sur la fluidité avec laquelle les données circuleront au cœur de topologies physiques multidimensionnelles.
Liens de référence :
- Blog technique officiel de Cerebras : How We Deploy Trillion-Parameter Frontier Models on Cerebras
- Rapport sur l’architecture et les bancs d’essai de Kimi K3
- Livre blanc de l’architecture système Cerebras CS-4