Für den Betrieb eines 3-Billionen-Parameter-Modells bündelt die Branche üblicherweise Hunderte High-End-GPUs mit massiven HBM-Speicherkapazitäten. Häufige tensorparallele Synchronisationsschritte zwischen den Beschleunigern erzeugen jedoch immense Kommunikations-Overheads, die die Ausgabegeschwindigkeit auf wenige Dutzend Token pro Sekunde drosseln. Cerebras schlägt einen grundlegend anderen Weg ein: Über 59 gekoppelte WSE-3T-Wafer erzielt das System Durchsätze zwischen 1.000 und 2.000 Token pro Sekunde.
Dieser Ansatz bricht mit der Prämisse, ein vollständiges Modell in einen zentralen Speicherpool einpassen zu müssen. Ingenieure zerlegten das aus 93 Schichten bestehende Netzwerk und verankerten die Gewichte dauerhaft im On-Chip-SRAM von 59 Wafer-Scale-Engines. Die Kommunikation zwischen den Wafern beschränkt sich auf den Mikrosekunden-Transfer von Aktivierungswerten. Chips fungieren hier nicht mehr als passive Speicherbehälter, sondern als physische Fertigungsstationen entlang einer Hardware-Pipeline.
93 Schichten auf 59 Wafer aufgeteilt: Gewichte dauerhaft im On-Chip-SRAM verankert
Der dauerhafte Engpass bei der Inferenz moderner Frontier-Modelle liegt in der Speicherbandbreite. Bei 3 Billionen Parametern beanspruchen selbst 4-Bit-quantisierte Gewichte rund 1,5 TB Speicherplatz. Bei herkömmlichen GPU-Clustern müssen für jedes generierte Token gewaltige Gewichtstensoren aus dem externen DRAM in die Rechenkerne geschaufelt werden. Dieser ständige Datentransfer hält die Generierungsgeschwindigkeit hinter der Speicherwand (Memory Wall) gefangen.
Ein einzelner WSE-3T-Wafer integriert 44 GB On-Chip-SRAM bei einer aggregierten chipinternen Netzwerkbandbreite von 53,5 PB/s. Die 93 Schichten von Kimi K3 belegen im Schnitt etwa 16 GB an Gewichten pro Schicht – was exakt in die Kapazität eines einzelnen Wafers passt. Indem die Parameter direkt in den SRAM geladen und dauerhaft fixiert wurden, entfällt der zeitintensive Rückgriff auf externen Speicher vollständig.
Da sich die Gewichte nicht mehr bewegen müssen, streckt sich das gesamte Netzwerk wie ein durchgehender Silizium-Korridor. Jeder Wafer führt ausschließlich die ihm zugewiesenen Schichten aus, wodurch Rechenkerne und lokaler Speicher nahtlos ineinandergreifen. Die Daten fließen entlang der physischen Hardware-Topologie; die Modellarchitektur wird direkt auf das Silizium projiziert.
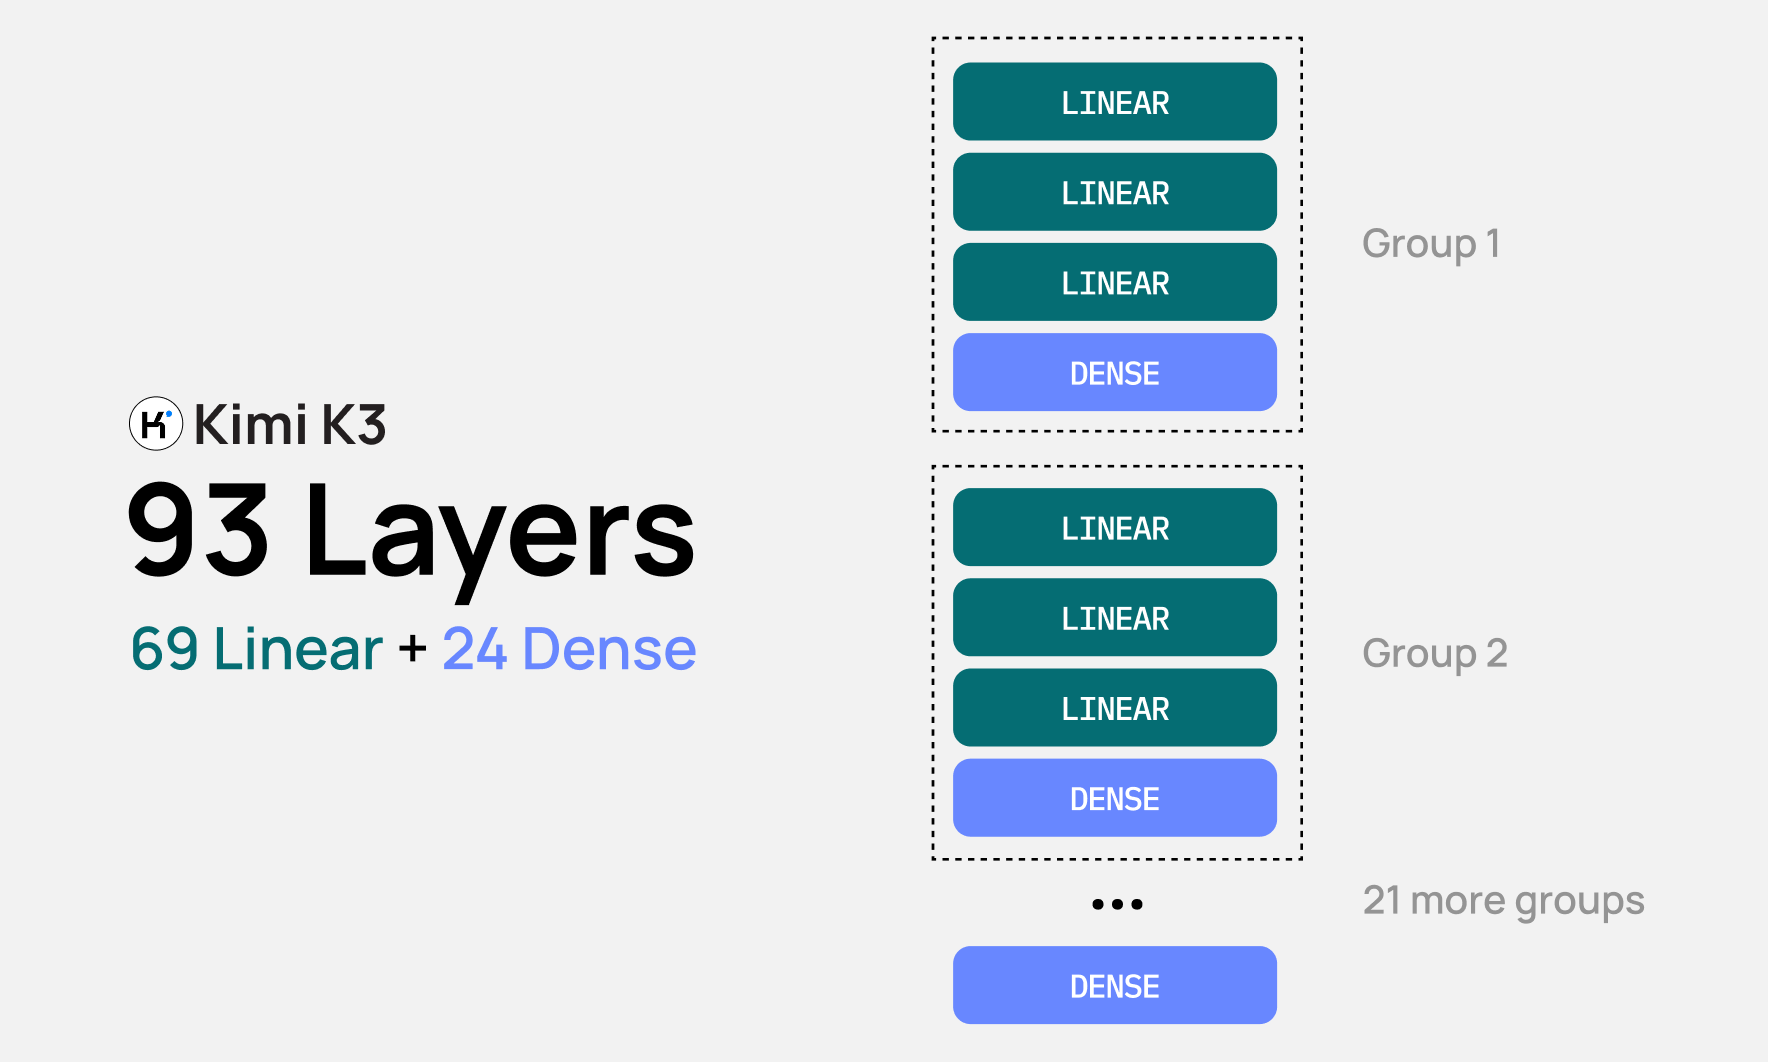 Abbildung: Schichtarchitektur von Kimi K3 und die Wafer-Zuweisungsstrategie. Quelle: Cerebras Blog
Entkopplung von Linear- und Dense-Layern: SRAM-Budgetierung bis aufs Byte
Kimi K3 setzt auf eine Hybrid-Architektur aus 69 linearen Attention-Schichten und 24 dichten (Dense-) Attention-Schichten. Das Referenz-Szenario von Cerebras basiert auf einer durchschnittlichen Kontextlänge von 256k Token, 4-Bit-Gewichten und 8-Bit-KV-Caches. Da beide Aufmerksamkeitsmechanismen völlig unterschiedliche Speicheranforderungen stellen, erforderte die Wafer-Zuordnung eine präzise Segmentierung.
Lineare Attention-Schichten müssen während der Inferenz lediglich einen Hidden State fester Größe vorhalten. Dieser Speicherbedarf wächst selbst bei massiver Verlängerung des Eingabekontexts nicht an. Zwei lineare Schichten beanspruchen zusammen 32 GB an Gewichten, sodass auf einem einzelnen Wafer 12 GB für statische Zustandspuffer verbleiben. Folglich lassen sich alle 69 linearen Schichten auf lediglich 35 Wafern unterbringen.
Dichte Attention-Schichten tragen hingegen die volle Last wachsender Kontexte: Bei 256k Token sammeln aktive Anfragen kontinuierlich KV-Caches an. Das Entwicklerteam wählte daher eine Zuordnung von genau einem Wafer pro Dense-Schicht. Jeder Wafer nimmt 16 GB an Gewichten auf und reserviert die verbleibenden 28 GB SRAM exklusiv für dynamische KV-Caches. Die 24 Dense-Schichten belegen somit 24 Wafer, die zusammen mit den 35 linearen Wafern den 59-Wafer-Verbund bilden.
Nur Aktivierungen im Fluss: 2-Mikrosekunden-Hops treiben die Pipeline an
Mit fest im Chip verankerten Gewichten wandelt sich auch die chipübergreifende Kommunikation grundlegend. Konventionelle Architekturen müssen Tensoren zwischen GPUs synchronisieren, wobei die Interconnect-Bandbreite zum Nadelöhr wird. In der Cerebras-Pipeline fließen über das Netzwerk ausschließlich die Aktivierungswerte, die am Ausgang der jeweiligen Schichten anfallen.
Das Datenvolumen der Aktivierungen für einen einzelnen Vorwärtspass liegt meist im Bereich weniger Megabyte. Im CS-4-System fasst ein Rack drei Wafer zusammen, wodurch die Latenz zwischen zwei Wafern auf 2 Mikrosekunden schrumpft. Aktivierungen werden per RDMA over Ethernet übertragen; der minimale Overhead von zwei Mikrosekunden pro Hop verursacht praktisch keinen Stillstand in der Pipeline.
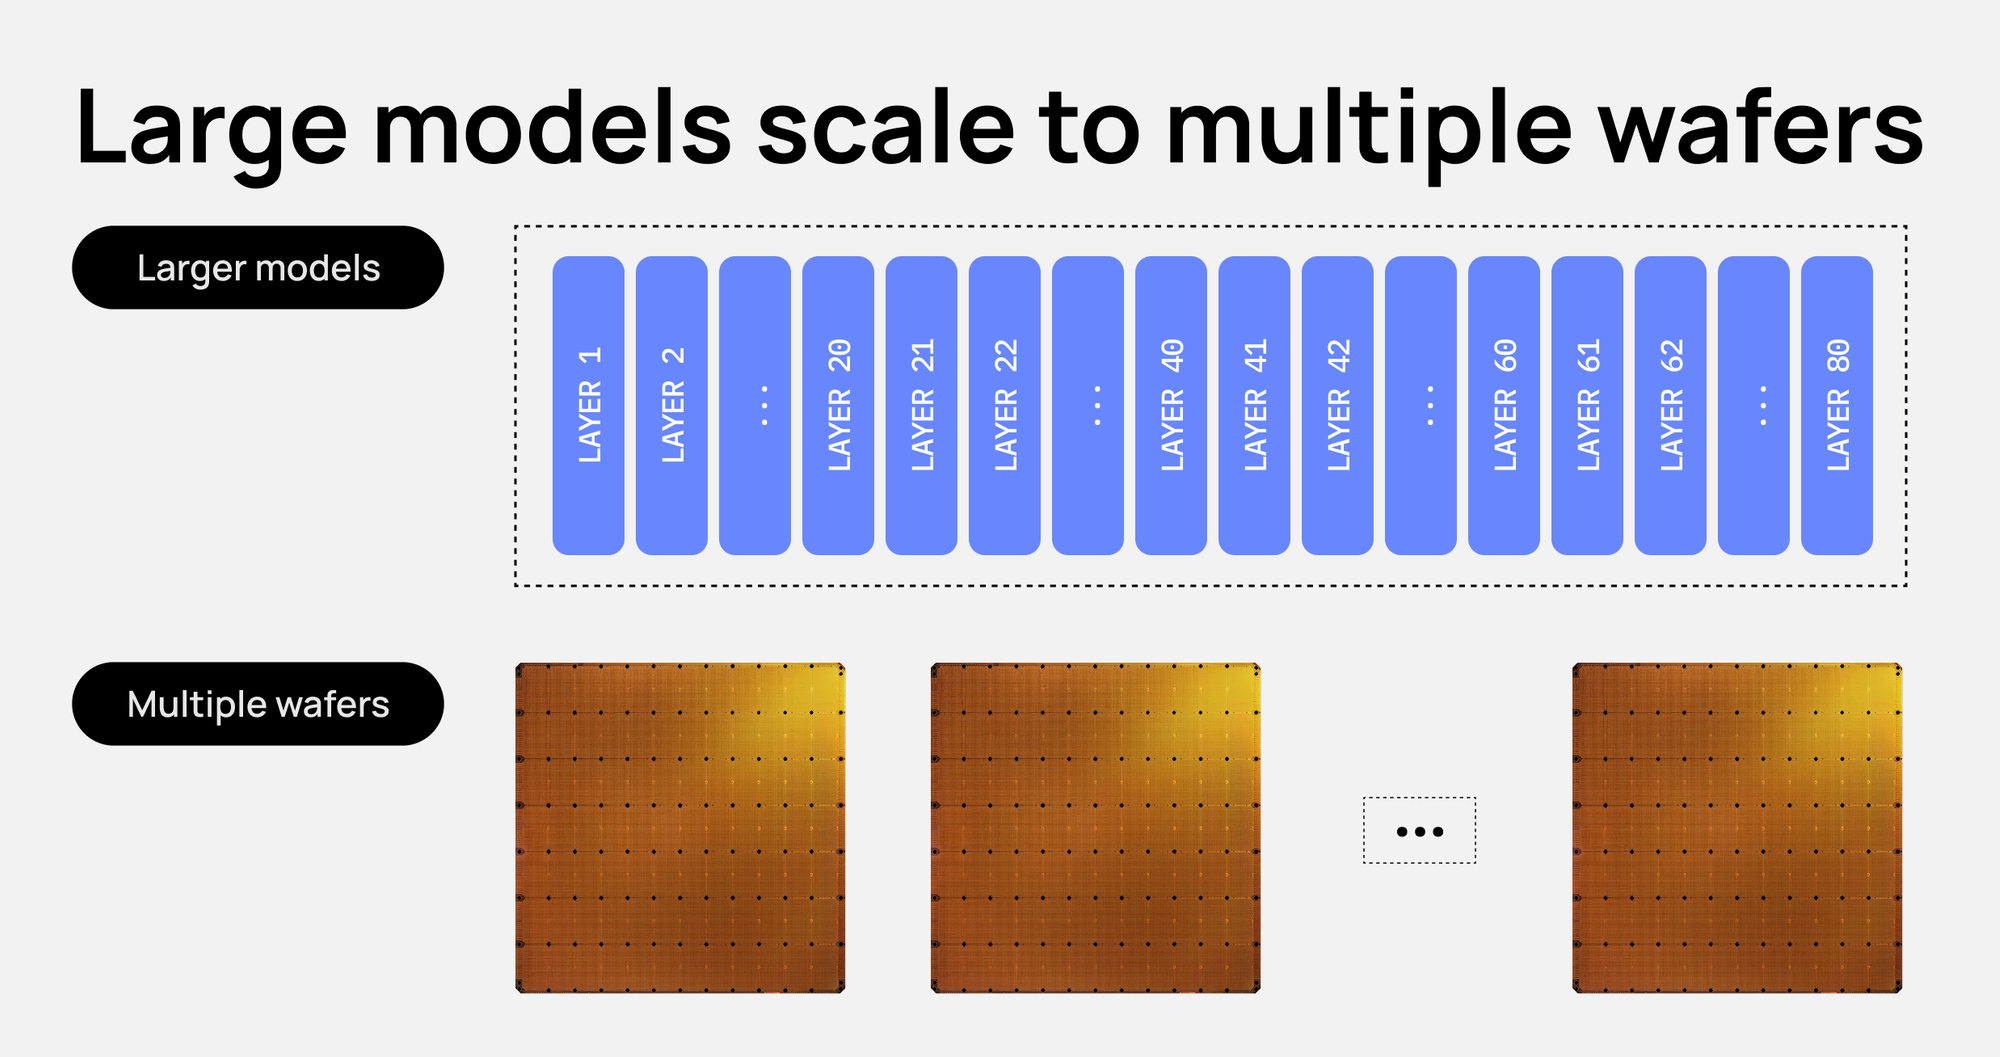 Abbildung: Kommunikationstopologie der verketteten Wafer-Pipeline; Aktivierungen werden per RDMA über Ethernet übertragen. Quelle: Cerebras Blog
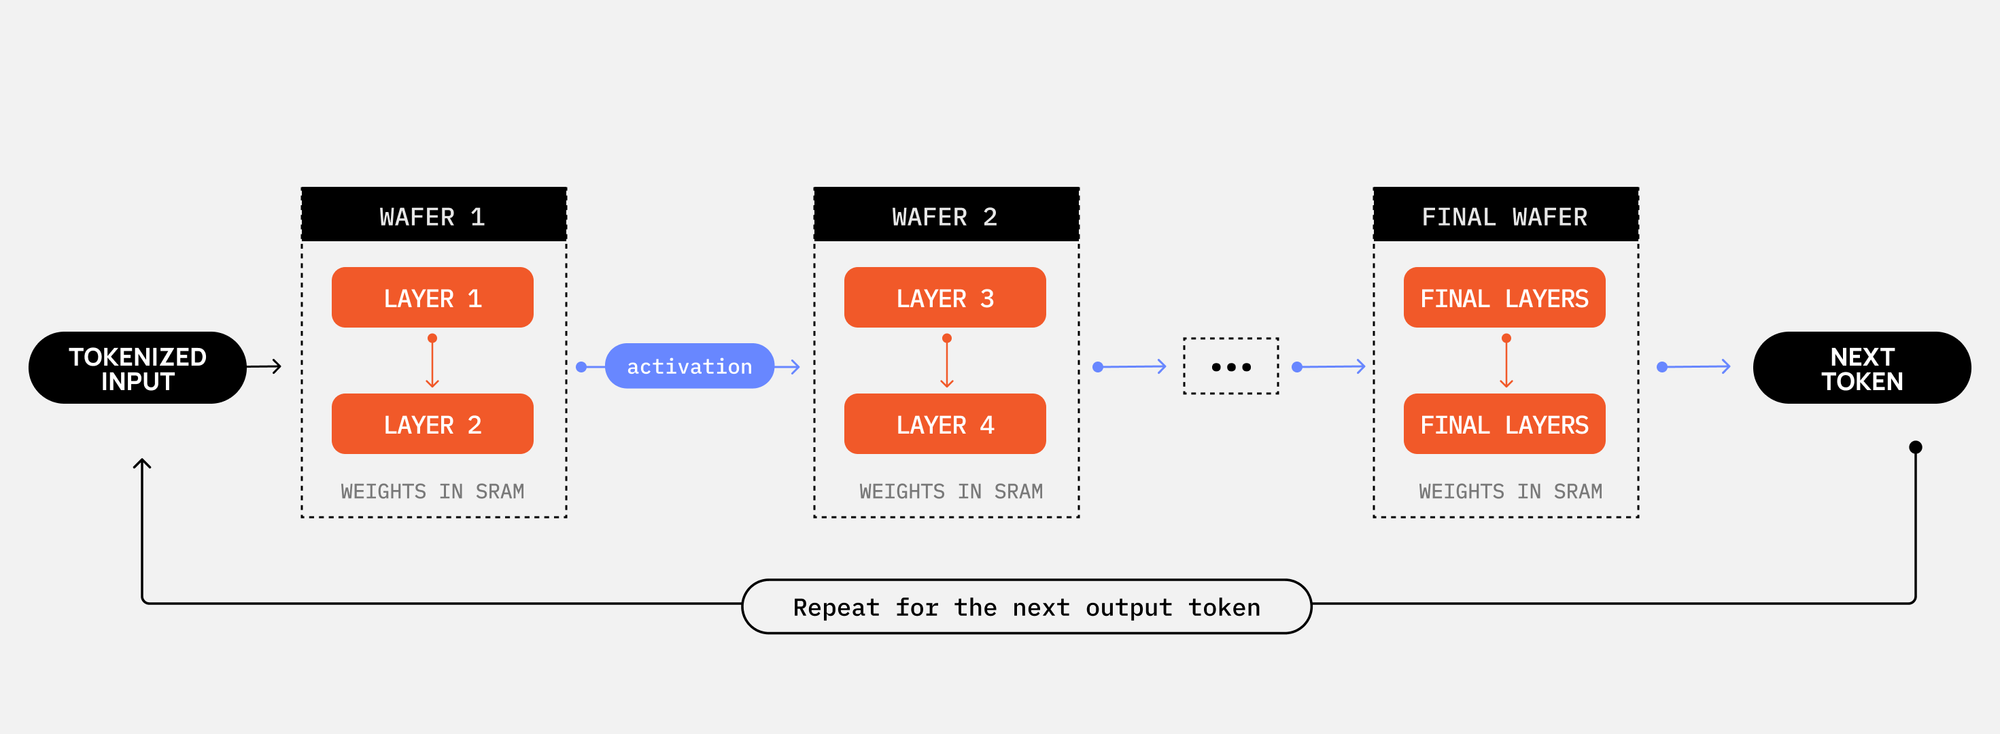 Abbildung: Fertigungslinien-Ansicht einer einzelnen Anfrage beim Durchlaufen der 59 Wafer-Stufen. Quelle: Cerebras Blog
Das Gesamtsystem arbeitet wie eine automatisierte industrielle Montagestraße. Sobald der erste Wafer die Eingabedaten verarbeitet hat, wird die Aktivierung unmittelbar zur nachfolgenden Station weitergeleitet. Der vorgelagerte Wafer wird augenblicklich frei und nimmt die nächste eingehende Anfrage entgegen. Durch das synchrone Zusammenspiel von 59 Wafern sinkt die Inferenzlatenz einer Einzelanfrage an die physikalischen Grenzen der Hardware.
Das Limit hinter 2.000 Token/s: SRAM-Kapazität setzt die Grenze für Parallelität
Die Pipelining-Architektur erlaubt es verschiedenen Stationen, voneinander unabhängige Anfragen simultan zu verarbeiten. Während Stufe 3 die Anfrage von Nutzer A berechnet, kann Stufe 2 parallel einen Micro-Batch für Nutzer B verarbeiten. Die Anzahl gleichzeitig aktiver Anfragen entspricht in etwa der Zahl der Pipeline-Stufen multipliziert mit der Micro-Batch-Größe. Kleinere Batches minimieren die Latenz für den Einzelnutzer, während größere Batches den Gesamtdurchsatz des Systems maximieren.
Doch die extreme Generierungsgeschwindigkeit für Einzelanfragen geht mit einer strikten Kapazitätsgrenze einher. Die maximale Parallelität des Gesamtsystems wird durch den On-Chip-SRAM der 24 Dense-Wafer hart limitiert. Jede aktive Sitzung muss auf jedem der Dense-Wafer einen eigenen KV-Cache-Bereich belegen. Der verfügbare Speicherraum von 28 GB setzt damit eine feste Obergrenze für simultane Anfragen.
On-Chip-SRAM ermöglicht zwar Durchsätze von mehreren tausend Token pro Sekunde, schränkt jedoch die Skalierbarkeit für Massenparallelität ein. Konventionelle GPU-Cluster weisen zwar höhere Latenzen pro Anfrage auf, können dank riesiger externer Speicherpools aber Zehntausende gleichzeitige Verbindungen verwalten. Bei der Wafer-Lösung ist der Puffer erschöpft, sobald der SRAM voll ist. Um die Parallelität zu erweitern, bleibt als einziger Weg der Aufbau einer weiteren vollständigen Pipeline aus 59 Wafern.
Einzelnutzer-Höchstgeschwindigkeit vs. Massen-Parallelität: Zwei getrennte Pfade für KI-Infrastruktur
Kimi K3 erzielte in maßgeblichen Benchmarks herausragende Ergebnisse: Mit 88,3 % im Terminal-Bench 2.1 rückte das Modell dicht an GPT-5.6 Sol (88,8 %) heran; im BrowseComp übertraf es mit 91,2 % den Wert von Sol (90,4 %) sogar leicht. Die Daten belegen, dass quelloffene Frontier-Modelle auch in anspruchsvollen autonomen Agenten-Workflows überzeugende Leistungen erbringen.
Diese Entwicklung führt zu einer Neubewertung von Inferenzmetriken. Historisch orientierte sich die Industrie vor allem an maximalen gleichzeitigen Verbindungen und kumulativen Batch-Durchsätzen. Cerebras schlägt vor, den Fokus stattdessen auf generierte Token pro Megawatt bei garantierter interaktiver Mindestgeschwindigkeit zu legen. Dieser Maßstab spiegelt wider, wie effizient ein Rechensystem elektrische Leistung in latenzfreie, reaktionsschnelle Interaktion verwandelt.
Beide Hardware-Philosophien bedienen grundverschiedene wirtschaftliche Anforderungen. Reflexionsschleifen autonomer KI-Agenten erfordern unmittelbare Rückmeldungen; hier eliminiert die Wafer-Pipeline jegliche Wartezeiten. Für öffentliche APIs mit enormem gleichzeitigem Nutzerandrang bleibt der geteilte GPU-Speicherpool hingegen wirtschaftlich flexibler.
Der erfolgreiche Betrieb eines 3-Billionen-Parameter-Modells auf 59 Wafern zeigt einen greifbaren Weg zur Überwindung der Speicherwand auf. Indem Chips von passiven Datenspeichern zu aktiven Fließbandstationen umdefiniert werden, verschiebt Pipelining die Latenzgrenzen moderner KI-Inferenz neu. Der künftige Wettbewerb um KI-Hardware wird davon abhängen, wie reibungslos Datenströme durch mehrdimensionale physische Topologien geleitet werden können.
Weiterführende Links:
- Offizieller Cerebras-Technologie-Blog: How We Deploy Trillion-Parameter Frontier Models on Cerebras
- Kimi K3 Architektur- und Benchmark-Report
- Hardware-Whitepaper zum Cerebras CS-4 System