2026 年 11 月 4 日到 5 日的 24 小时里,国内 AI 领域发生了一场罕见动作。腾讯与百度在一天内相继宣布开源各自的最新旗舰模型。大厂不再把模型死死封在云端按次收钱。他们选择把价值数千万元的计算成果交出去,直接替全行业结清了最昂贵的那张账单。
两家的进度并不一样。百度那边权重已经能下载,腾讯在声明里写的是「近日放出」。同一天宣布,一个已经交货,一个还在路上。
长期以来,大模型研发最沉重的负担始终压在早期的海量预训练上。为了让模型掌握人类语言与代码规则,工程团队必须调动数万张计算卡连续运转数月。动辄数千万元的电费与设备折旧,让绝大多数中小团队无力承担。很多项目耗尽了早期融资,依然拿不到一个具备通用推理能力的底座。
24小时连放两款模型底座:一个精装交付,一个只卖毛坯
两家大厂在同一个窗口期拿出了截然不同的解题思路。腾讯发布的混元 Hy4 属于成品路线,出厂就配齐了视觉推理与计算机操作功能。百度 ERNIE 5.5 Flash Base 则交出了一张白纸。它只保留预训练完成那一刻的裸模型状态,中后期调优全部留白。
建模型就像盖大楼。预训练是打桩浇筑,后期调优是室内装修。百度在报告中直言,这次发布就是为了帮开发者省去昂贵的预训练开销。大厂管基建,开发者做应用,产业分工更加明晰。
腾讯把工业软件揉进模型:自评3.04分也有水分
腾讯这次交出的 Hy4,核心变化在于跨模态输入与工业操作。模型首次接入了精细化图像处理、复杂图表分析以及数学视觉推理。在软件交互层面,研发团队首次为它注入了命令行与图形界面的直接操控能力。它直接接管了桌面屏幕与键鼠指令,尝试去完成跨软件的连续作业。
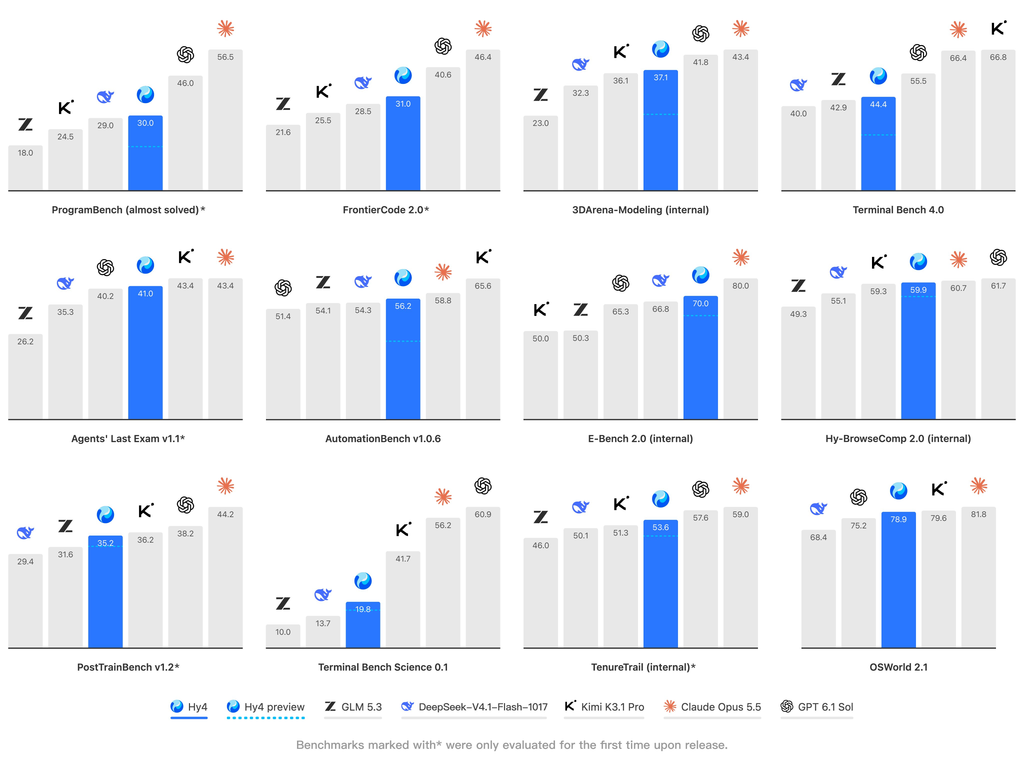 图:腾讯展示 Hy4 在视觉理解与复杂工程软件操作中的执行链路。来源:tencent.com
研发团队针对 Blender 与 CAD 等专业软件进行了深度训练。在办公自动化基准 WorkBuddy 上,Hy4 取得 83.18 的平均分,12 个场景中拿下 9 个第一。专业软件的操作数据,让模型在多步连续交互中稳住了空间推理链条。工业环境中的严苛报错,逼着智能体在长周期任务里降低失误率。
官方公布的金融盲评成绩单同样引人瞩目。测试邀请了 213 位金融从业者参与,面对 579 个真实业务任务,Hy4 获得了 3.04 的总分,微弱领先 DeepSeek-V4.1-Flash-1017 的 2.97 分,同时拉开了与 Kimi K3.1 Pro 及 GLM-5.3 的 2.68 分差距。在投资研究测试 iRaB 上,它的表现比预览版提升了 12.03 个百分点。其无依据假设导致的错误率从 23.1% 降到了 5.6%,总体幻觉率也压到了 7.2%。
这份亮眼的数据需要客观看待。这场包含 153 位外部专家的测评,主办方是腾讯混元与金融科技部门。厂商自己出考卷并自己夺魁,指标的说服力要打一定折扣。模型是否真正耐用,还需要看外部开发者在复杂生产线上的实测反馈。
百度重写43层注意力机制:33.5万亿标记算力花在刀刃上
与腾讯的集成思路不同,百度 ERNIE 5.5 Flash Base 展现出纯粹的底座定位。它没有任何下游微调的痕迹。模型总参数达 2800 亿,单标记仅激活 140 亿。百度耗费 33.5 万亿标记从零完成预训练,替外部团队搭好了起跑线。
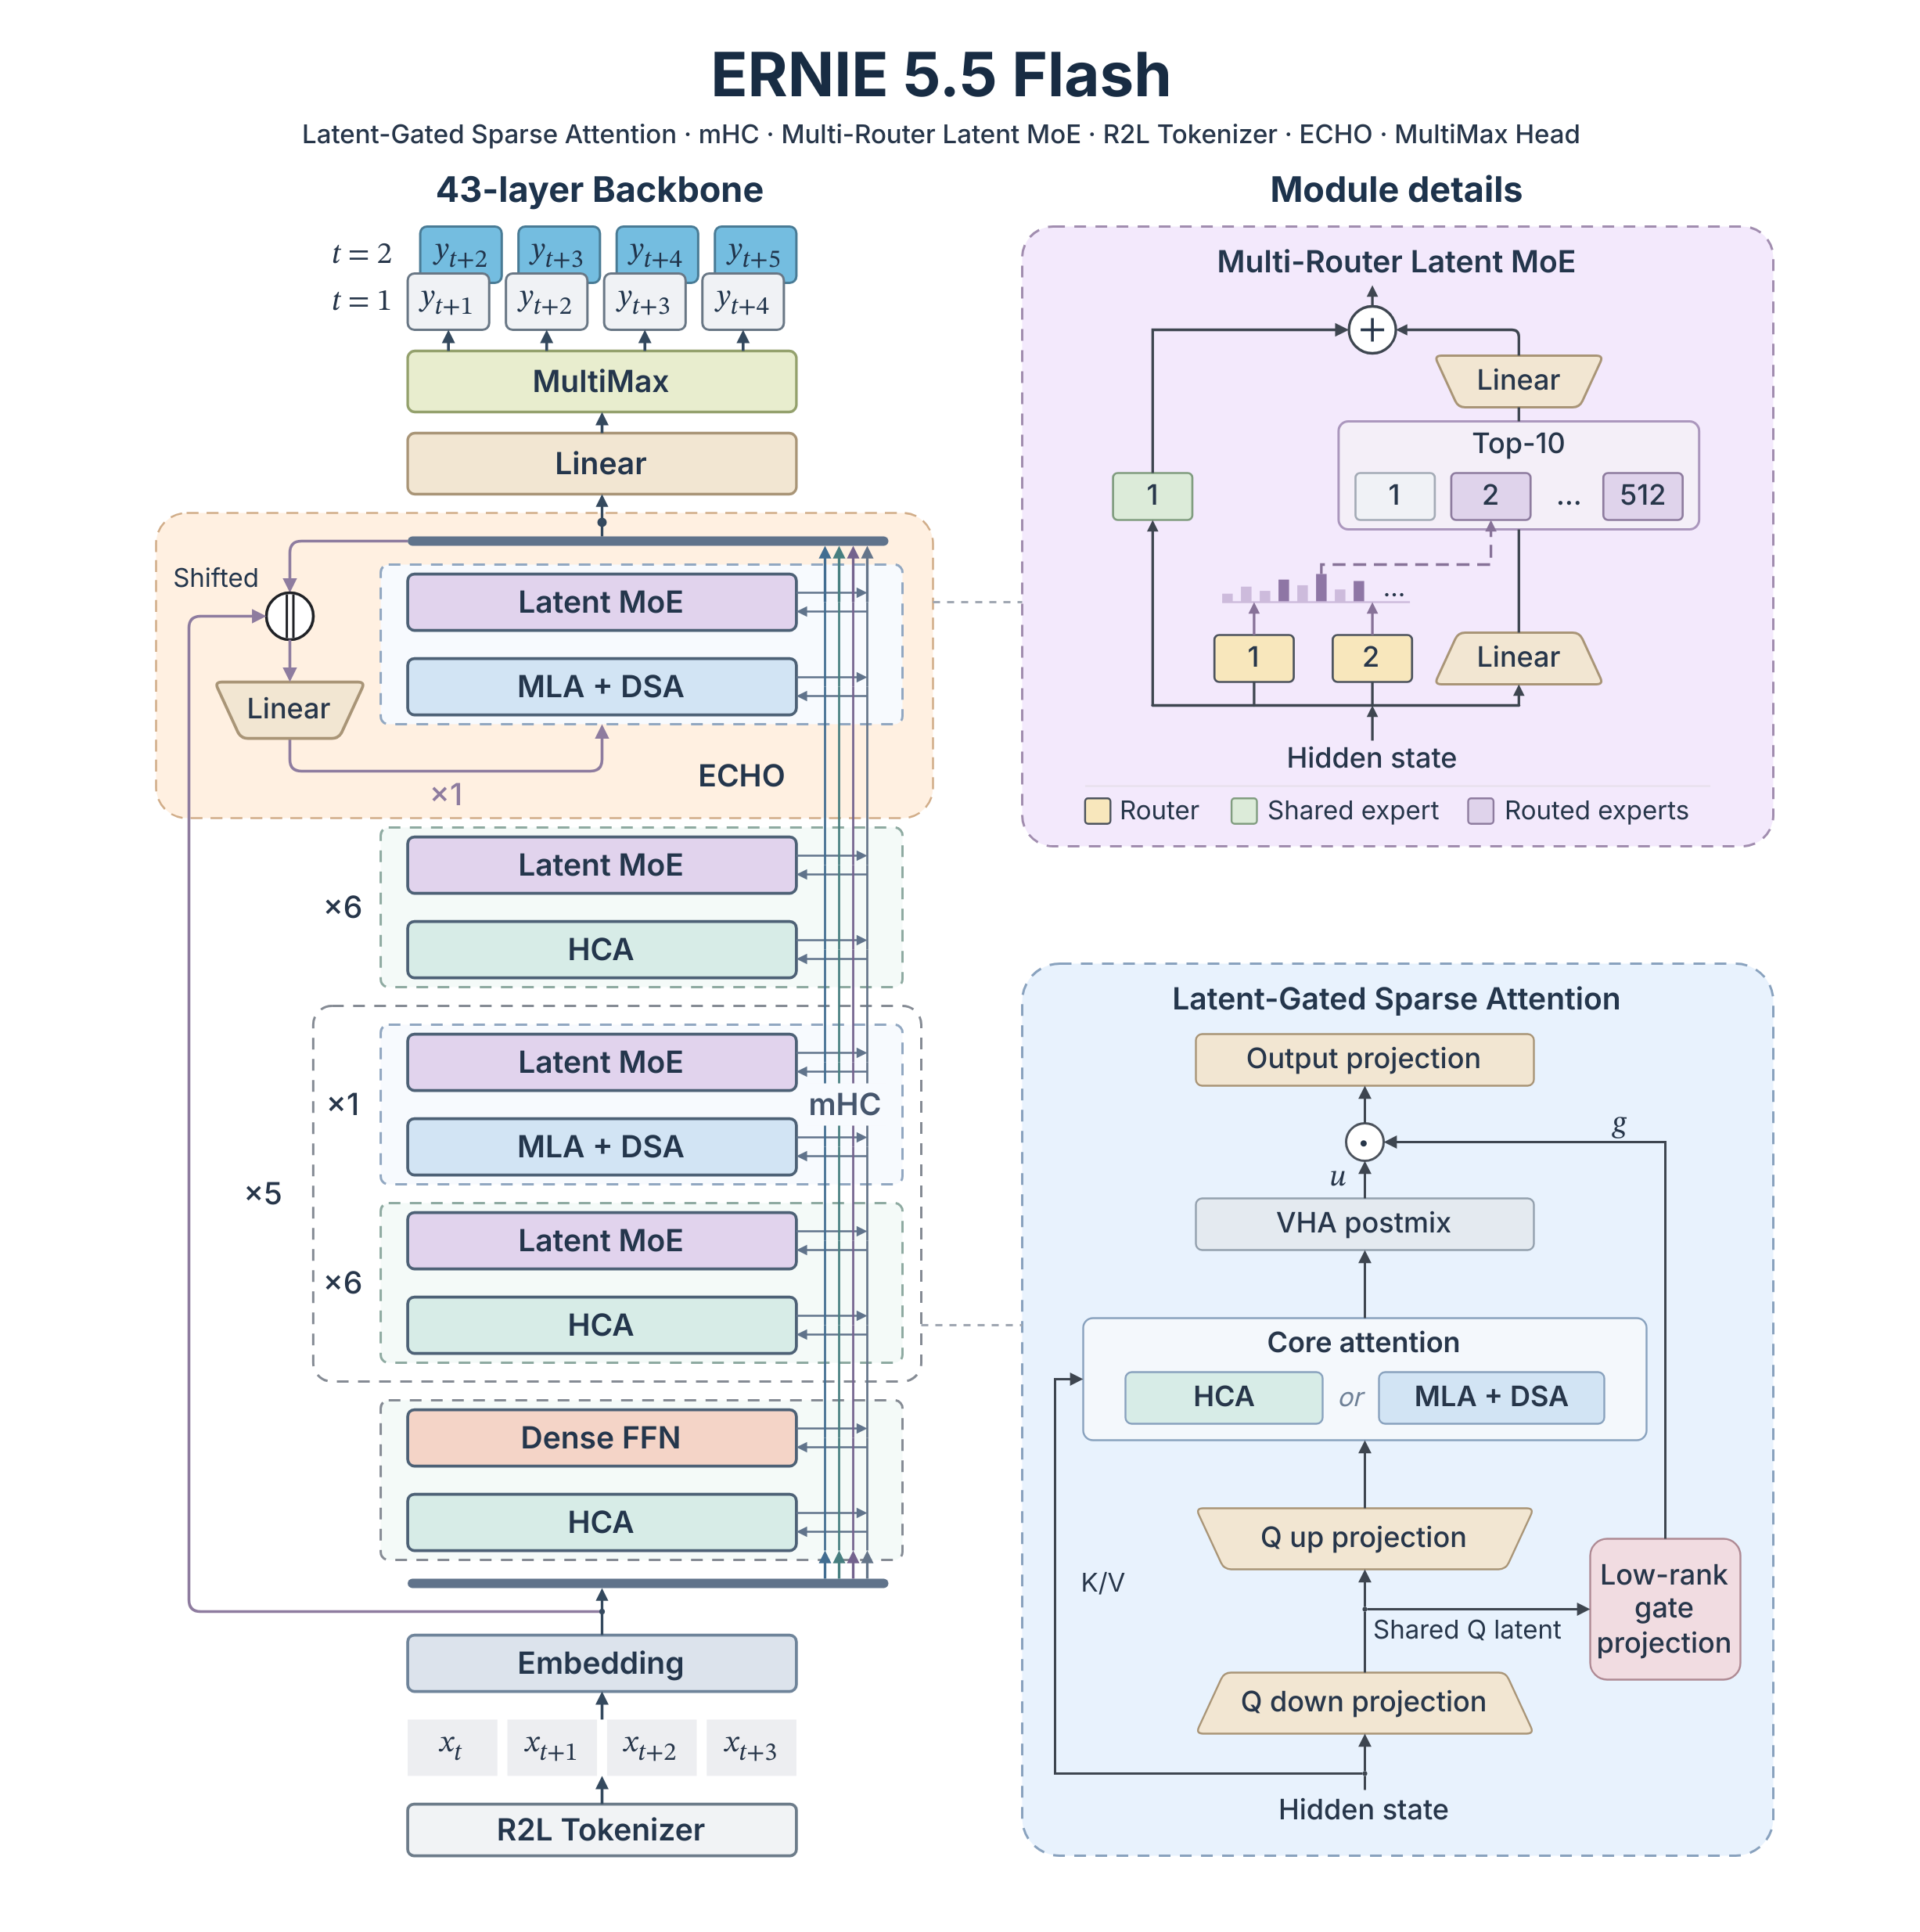 图:ERNIE 5.5 Flash 架构细节展示其 43 层网络与混合稀疏注意力机制。来源:ernie.baidu.com
理解这套架构的精妙,就像给长文本推理的内存做精细节流。在 43 层主干网络中,以往每层都要完整保存所有上下文缓存。百度做出了取舍。每 7 层网络中仅保留 1 层全量注意力,其余 6 层把每 128 个标记大幅压缩为一个特征项。
压缩层省下的显存,被精准补贴给了关键层。便宜的压缩层使用 512 维宽头,昂贵的全量层则采用 256 维窄头。显存缓存预算集中在核心层,整体效率优于同类稀疏设计。这种源头上的结构改良,保证了模型在 100 万标记的长文本交互中依然运转平稳。
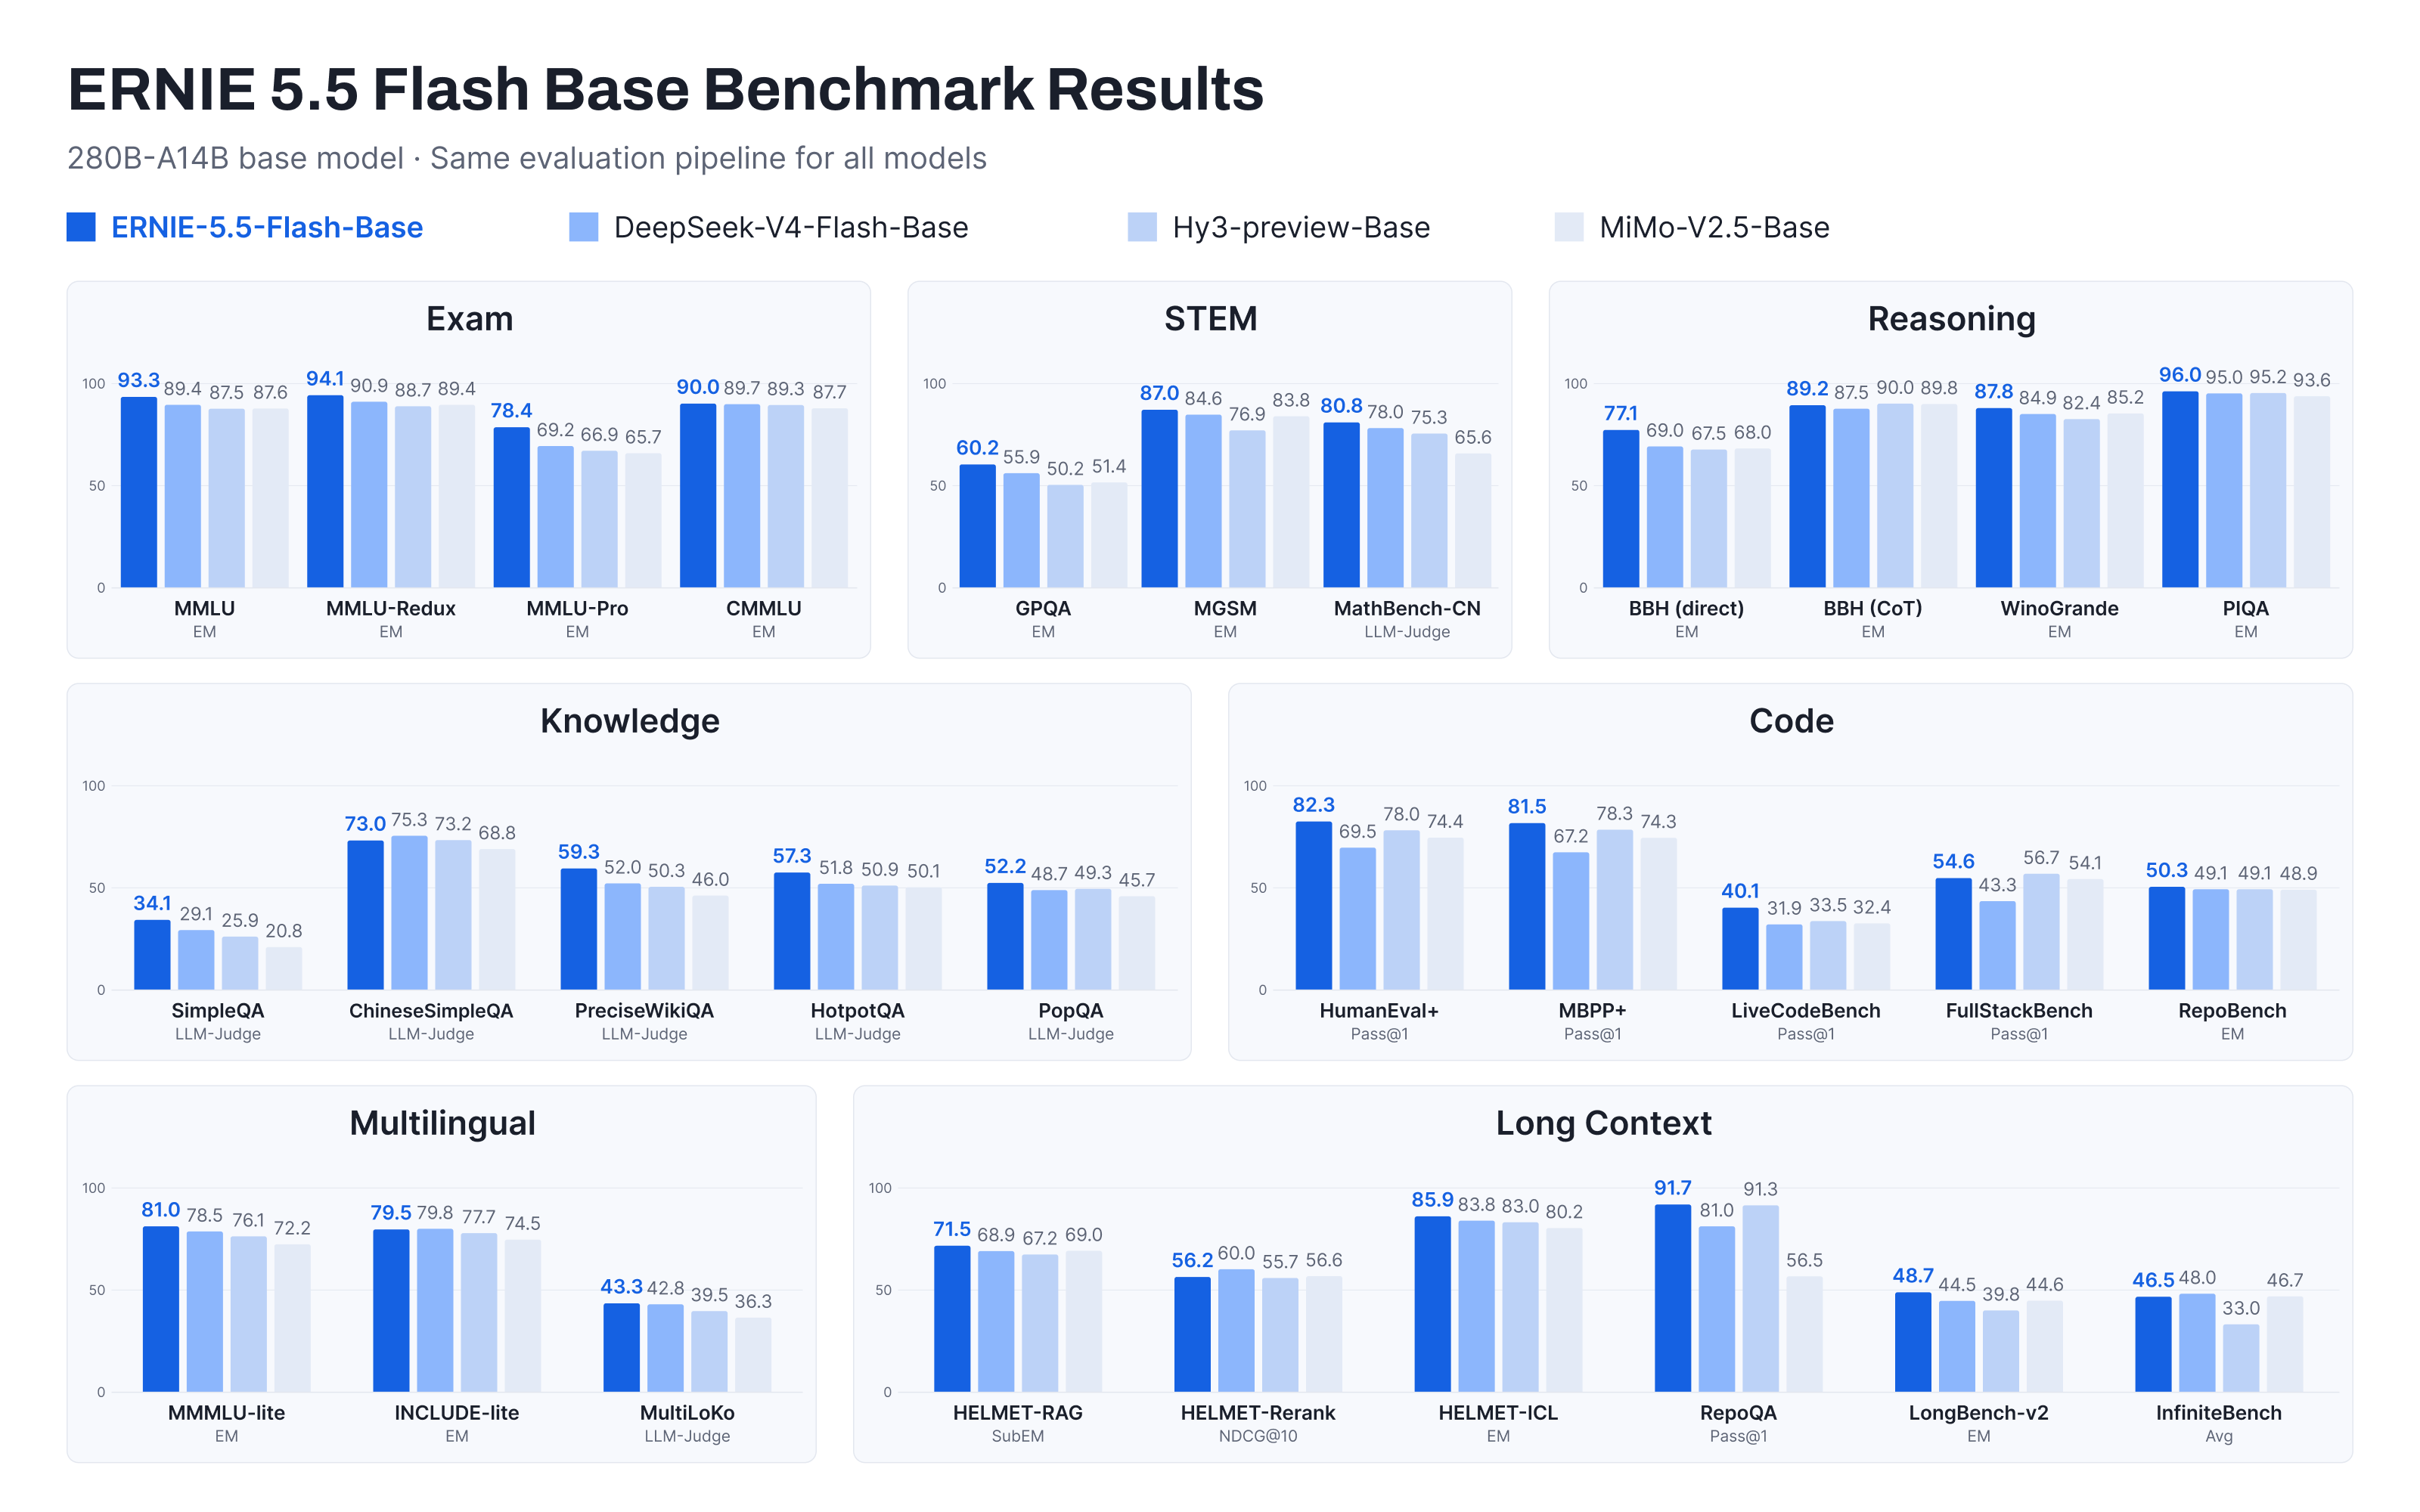 图:ERNIE 5.5 Flash Base 与 DeepSeek V4 Flash 等模型的基准测试分数横向对比。来源:ernie.baidu.com
在语料挑选上,研发团队紧扣不可逆原则。语料重心向仓库级代码与长篇逻辑分析深度倾斜。没有跨文件理解力,后期微调很难弥补这种先天缺陷。把最费算力的重活放在第一道工序,体现了底座的价值。
预训练这笔最重的活收回大厂:中小团队省下千万算力账单
在大模型的整个研发周期中,预训练是最烧钱、也最没法在后期补回来的那一段。它是整条链上资金风险最集中的重工业环节。想要从零洗出 30 万亿标记的参数体系,哪怕算力配置拉满,启动资金也动辄数千万元。一旦遭遇训练发散或坏点事故,巨额电费就会瞬间化作机房废热。
海外开发者社区近期热议的另一个案例,同样突显了账单的沉重。开源图像项目 Pjit-21K 公开了一笔两万美元的极简训练开销。即便只是验证性质的小模型,前期算力消耗也能迅速耗尽独立开发者的预算。大厂主动释放高质量基础权重,让下游团队不必再为重复造底座买单。
算力支出的分流,正在重塑开发者的资源配置方式。省下打地基的天价账单后,团队可以把有限预算集中在业务场景中。无论是深耕特定工业流水线的微调,还是打磨复杂的多步调用逻辑,回报周期都明显缩短。大厂修桥铺路,行业垂直深耕,技术生态的分工边界越发清晰。
烧钱地基铺平以后:真正竞争转移到工业场景深水区
两家大厂在同一时间的动作,反映出模型工业化演进的必然趋势。随着模型规模迈入千亿门槛,通用语言认知已经变成基础设施。由具备算力储备的大厂集中消化前置重活,显著减少了全行业的重复试错。分散重复的底座烧钱战告一段落,算力浪费的无序状态正在结束。
腾讯交出了精装成品,百度放出了毛坯框架。两套打法共同推动了模型研发的大规模分工转移。最昂贵的预训练门槛,被巨头内化成了公共基建。最贵的账单有人结清,决胜点转向了复杂的真实业务。
参考链接:
- 腾讯混元 Hy4 官方发布与系统技术报告
- 百度 ERNIE 5.5 Flash Base 架构技术报告
- Hacker News 社区讨论 (Pjit-21K 训练账单与权重开源)