Innerhalb eines 24-stündigen Zeitfensters zwischen dem 4. und 5. November 2026 erlebte die chinesische KI-Landschaft einen bemerkenswerten Schulterschluss. Tencent und Baidu gaben fast zeitgleich die Open-Source-Freigabe ihrer aktuellen Flaggschiffmodelle bekannt. Anstatt ihre fortschrittlichsten Architekturen hinter kostenpflichtigen Cloud-APIs einzuschließen, stellen beide Konzerne Trainingsergebnisse im Gegenwert von mehreren Millionen Euro der Allgemeinheit zur Verfügung – und begleichen damit eigenhändig die kostspieligste Rechnung der Branche.
Der Veröffentlichungsstatus unterscheidet sich jedoch: Während Baidus Modellgewichte bereits direkt heruntergeladen werden können, sprach Tencent in seiner Ankündigung von einer Bereitstellung „in den kommenden Tagen“. Am selben Tag verkündet, hat der eine bereits geliefert, während der andere kurz vor der Veröffentlichung steht.
In der Entwicklung großer Sprachmodelle lag die größte finanzielle Hürde seit jeher im rechenintensiven Pre-Training. Um einem Modell das Verständnis natürlicher Sprache und Programmierlogik beizubringen, müssen Ingenieurteams Zehntausende von KI-Beschleunigern über Monate hinweg im Dauerbetrieb betreiben. Stromkosten und Hardwareabschreibungen in zweistelliger Millionenhöhe übersteigen das Budget kleinerer Unternehmen bei Weitem. Viele Startups verbrauchten ihr gesamtes Startkapital, ohne je ein Basismodell mit verlässlicher Argumentationsfähigkeit fertigstellen zu können.
Zwei Modellarchitekturen in 24 Stunden: Schlüsselfertiger Agent gegen reines Basismodell
Die beiden Tech-Giganten begegnen dieser Herausforderung mit grundverschiedenen Philosophien. Tencents Hunyuan Hy4 verfolgt einen schlüsselfertigen Ansatz: Es bringt ab Werk Fähigkeiten für visuelle Inferenz und direkte Computerbedienung mit. Baidus ERNIE 5.5 Flash Base hingegen gleicht einem unbeschriebenen Blatt Papier. Es bewahrt exakt den Zustand, in dem sich das Modell unmittelbar nach Abschluss des Pre-Trainings befand – gänzlich ohne nachträgliches Fine-Tuning oder Alignment.
Der Bau eines KI-Modells ähnelt dem Hochhausbau: Das Pre-Training entspricht dem Ausheben der Baugrube und dem Gießen des Betonfundaments, während das Fine-Tuning den Innenausbau darstellt. Baidu betont in seinem technischen Bericht offen, dass dieser Release Entwicklern die astronomischen Kosten des Pre-Trainings ersparen soll. Die Großkonzerne errichten das Fundament, spezialisierte Teams entwickeln darauf maßgeschneiderte Anwendungen – eine Aufgabenteilung, die dem gesamten Markt zugutekommt.
Tencent integriert Desktop-Automatisierung: Die Hintergründe zum Benchmark-Wert von 3,04
Die Kernneuerung von Tencents Hy4 liegt in der multimodalen Signalverarbeitung und der direkten Interaktion mit professioneller Software. Das Modell integriert hochauflösende Bildanalyse, komplexe Diagrammauswertung und visuell-mathematisches Schließen. Auf der Interaktionsebene spendierten die Entwickler dem System die Fähigkeit, Betriebssysteme sowohl über die Kommandozeile als auch direkt über die grafische Benutzeroberfläche (GUI) per Bildschirm- und Mauseingabe zu bedienen.
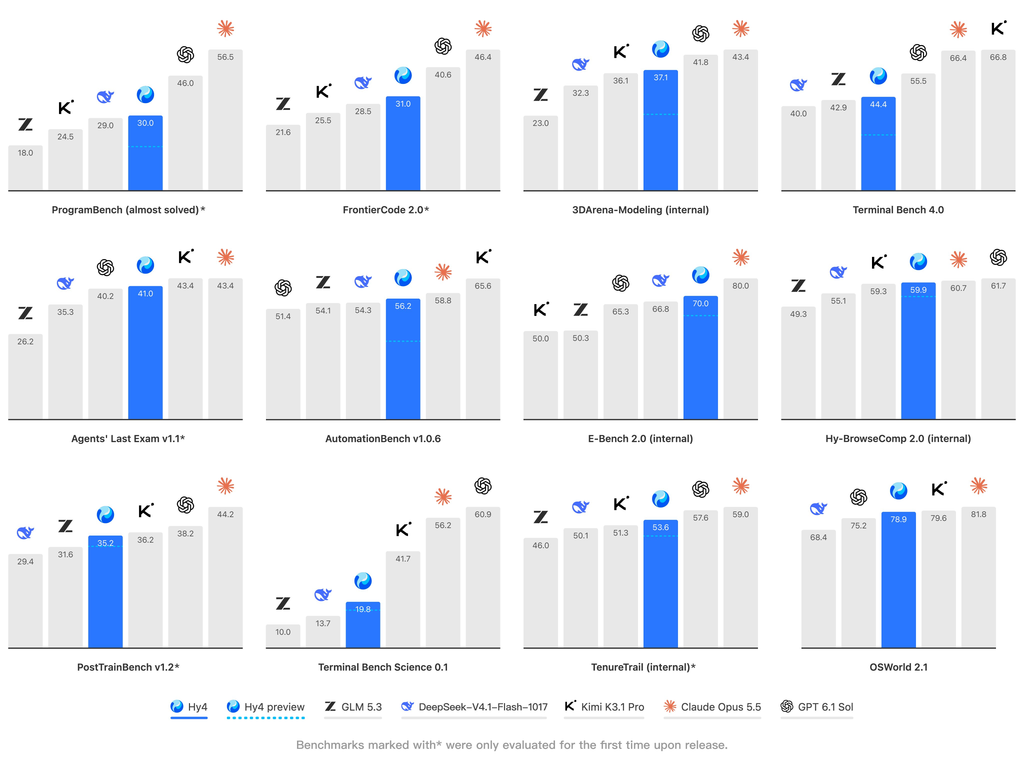 Abbildung: Tencents Ausführungskette für visuelles Verständnis und die Steuerung komplexer CAD- und Engineering-Software. Quelle: tencent.com
Das Entwicklerteam trainierte das Modell gezielt mit Daten professioneller Suiten wie Blender und CAD. Im Automatisierungs-Benchmark WorkBuddy erzielte Hy4 eine Durchschnittswertung von 83,18 und belegte in 9 von 12 Szenarien den ersten Platz. Das Training an realen Softwareinteraktionen stabilisierte die räumliche Argumentationskette bei komplexen mehrstufigen Aufgaben. Die strikte Fehlerbehandlung industrieller Umgebungen zwingt den Agenten dazu, Fehlerraten auch bei langen Arbeitsabläufen gering zu halten.
Auch die veröffentlichten Ergebnisse eines Finanz-Blindtests zogen Aufmerksamkeit auf sich. Anhand von 579 realen Geschäftsaufgaben bewerteten 213 Finanzexperten das Modell: Hy4 erreichte eine Gesamtnote von 3,04 und lag damit knapp vor DeepSeek-V4.1-Flash-1017 (2,97) sowie deutlich vor Kimi K3.1 Pro und GLM-5.3 (jeweils 2,68). Im Investment-Research-Benchmark iRaB verbesserte sich das Modell gegenüber der Vorschauversion um 12,03 Prozentpunkte. Unbegründete Fehlerannahmen sanken von 23,1 % auf 5,6 %, und die Halluzinationsrate wurde auf 7,2 % gedrückt.
Diese Werte müssen jedoch mit Bedacht interpretiert werden. Trotz der Beteiligung von 153 externen Branchenexperten wurde der Test von Tencents Hunyuan-Team und internen Fintech-Abteilungen mitorganisiert. Wenn ein Hersteller seine eigene Prüfung aufsetzt und zugleich gewinnt, ist eine gewisse Skepsis angebracht. Wie robust das Modell im industriellen Dauereinsatz tatsächlich ist, müssen unabhängige Benchmarks und Praxistests der Entwicklergemeinde zeigen.
Baidus optimierte 43-Layer-Attention: Gezielter Einsatz von 33,5 Billionen Tokens
Im Gegensatz zu Tencents anwendungsorientiertem Ansatz positioniert sich Baidus ERNIE 5.5 Flash Base als reines Basismodell ohne nachgelagerte Anpassungen. Bei insgesamt 280 Milliarden Parametern werden pro Token lediglich 14 Milliarden Parameter aktiviert. Baidu investierte ein Pre-Training über 33,5 Billionen Tokens hinweg, um Entwicklern eine saubere Ausgangsbasis bereitzustellen.
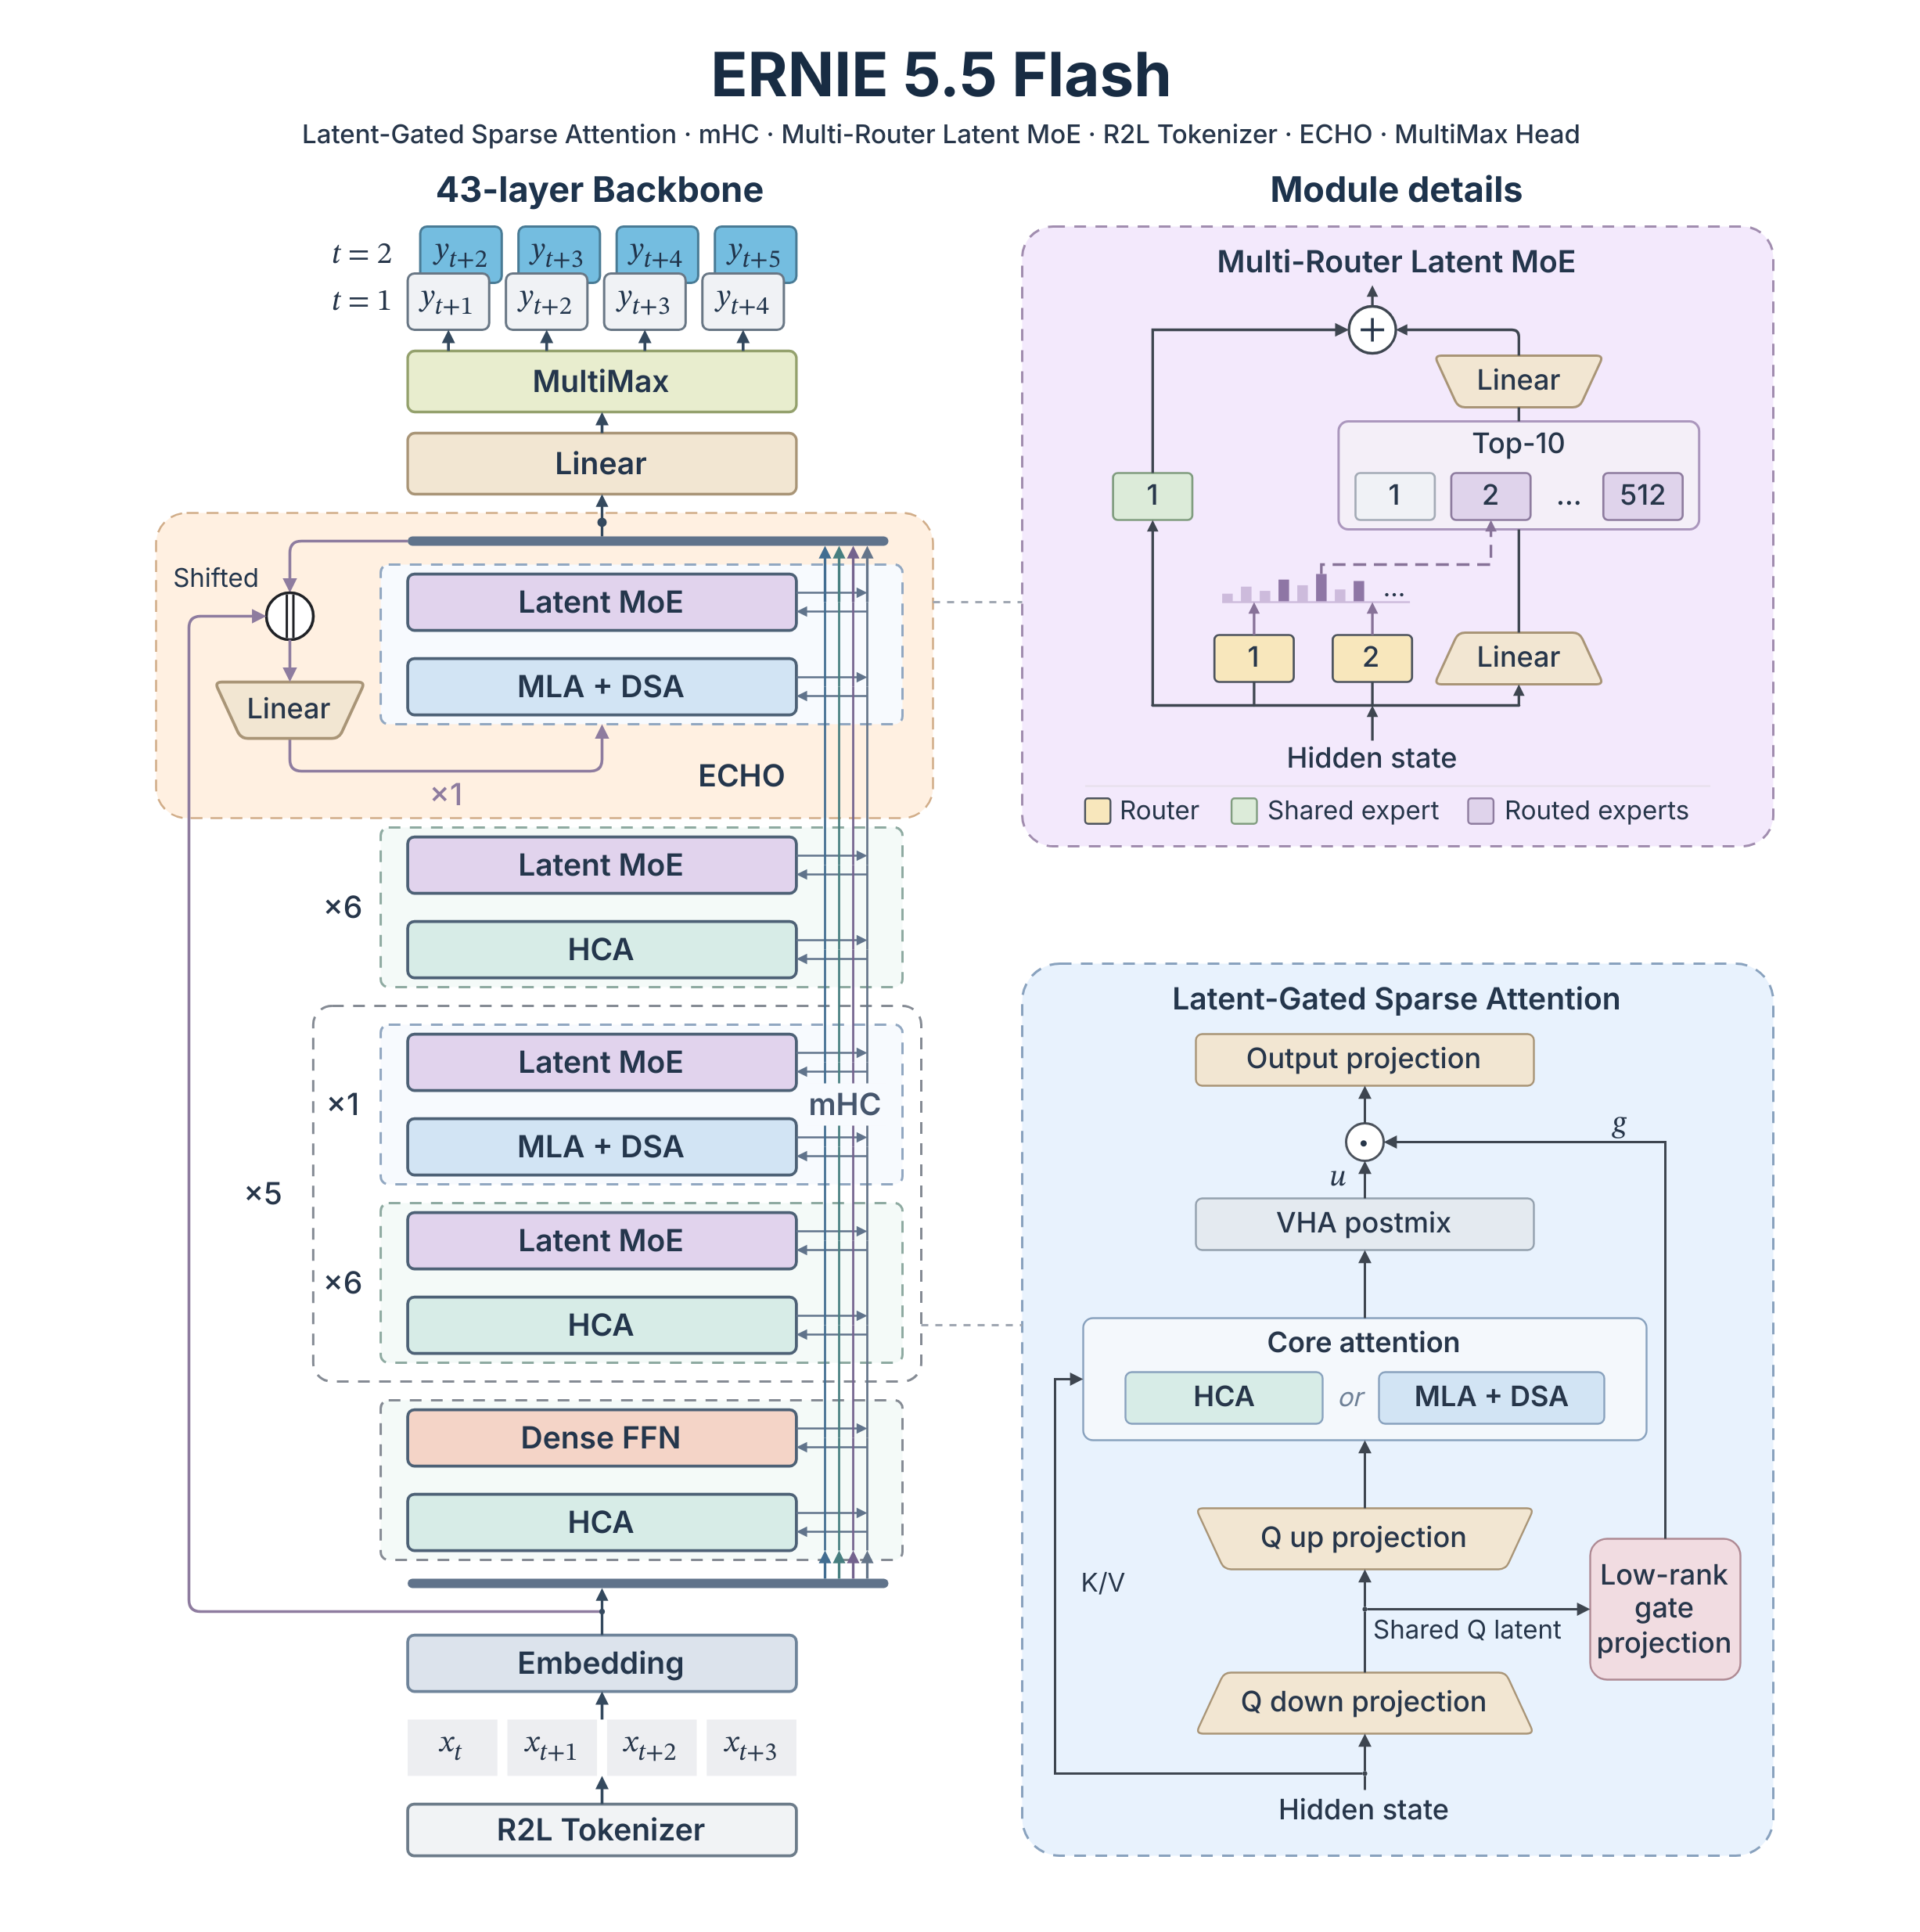 Abbildung: Detailansicht des 43-Layer-Backbones und des hybriden Sparse-Attention-Mechanismus von ERNIE 5.5 Flash. Quelle: ernie.baidu.com
Der architektonische Clou liegt in der konsequenten Reduzierung des VRAM-Bedarfs bei langen Kontextfenstern. In klassischen 43-Schichten-Transformern muss jede Schicht den vollständigen KV-Cache des gesamten Kontexts im Arbeitsspeicher vorhalten. Baidu wählte eine asymmetrische Verteilung: Nur jede siebte Schicht behält die vollständige Dense-Attention bei, während die übrigen sechs Schichten jeweils 128 Tokens zu einem kompakten Merkmalsvektor komprimieren.
Der durch die Komprimierungsschichten eingesparte Videospeicher wird gezielt den rechenintensiven Kernschichten zugewiesen. Die günstigen Komprimierungsschichten nutzen breite 512-Dimensionen-Heads, während die anspruchsvollen Dense-Attention-Schichten auf schlankere 256-Dimensionen-Heads setzen. Diese Bündelung des Cache-Budgets auf die kritischen Ebenen liefert einen spürbaren Effizienzgewinn gegenüber herkömmlichen Sparse-Ansätzen. Dank dieser Eingriffe verarbeitet das Modell Kontextfenster von bis zu einer Million Tokens stabil und ohne Leistungseinbrüche.
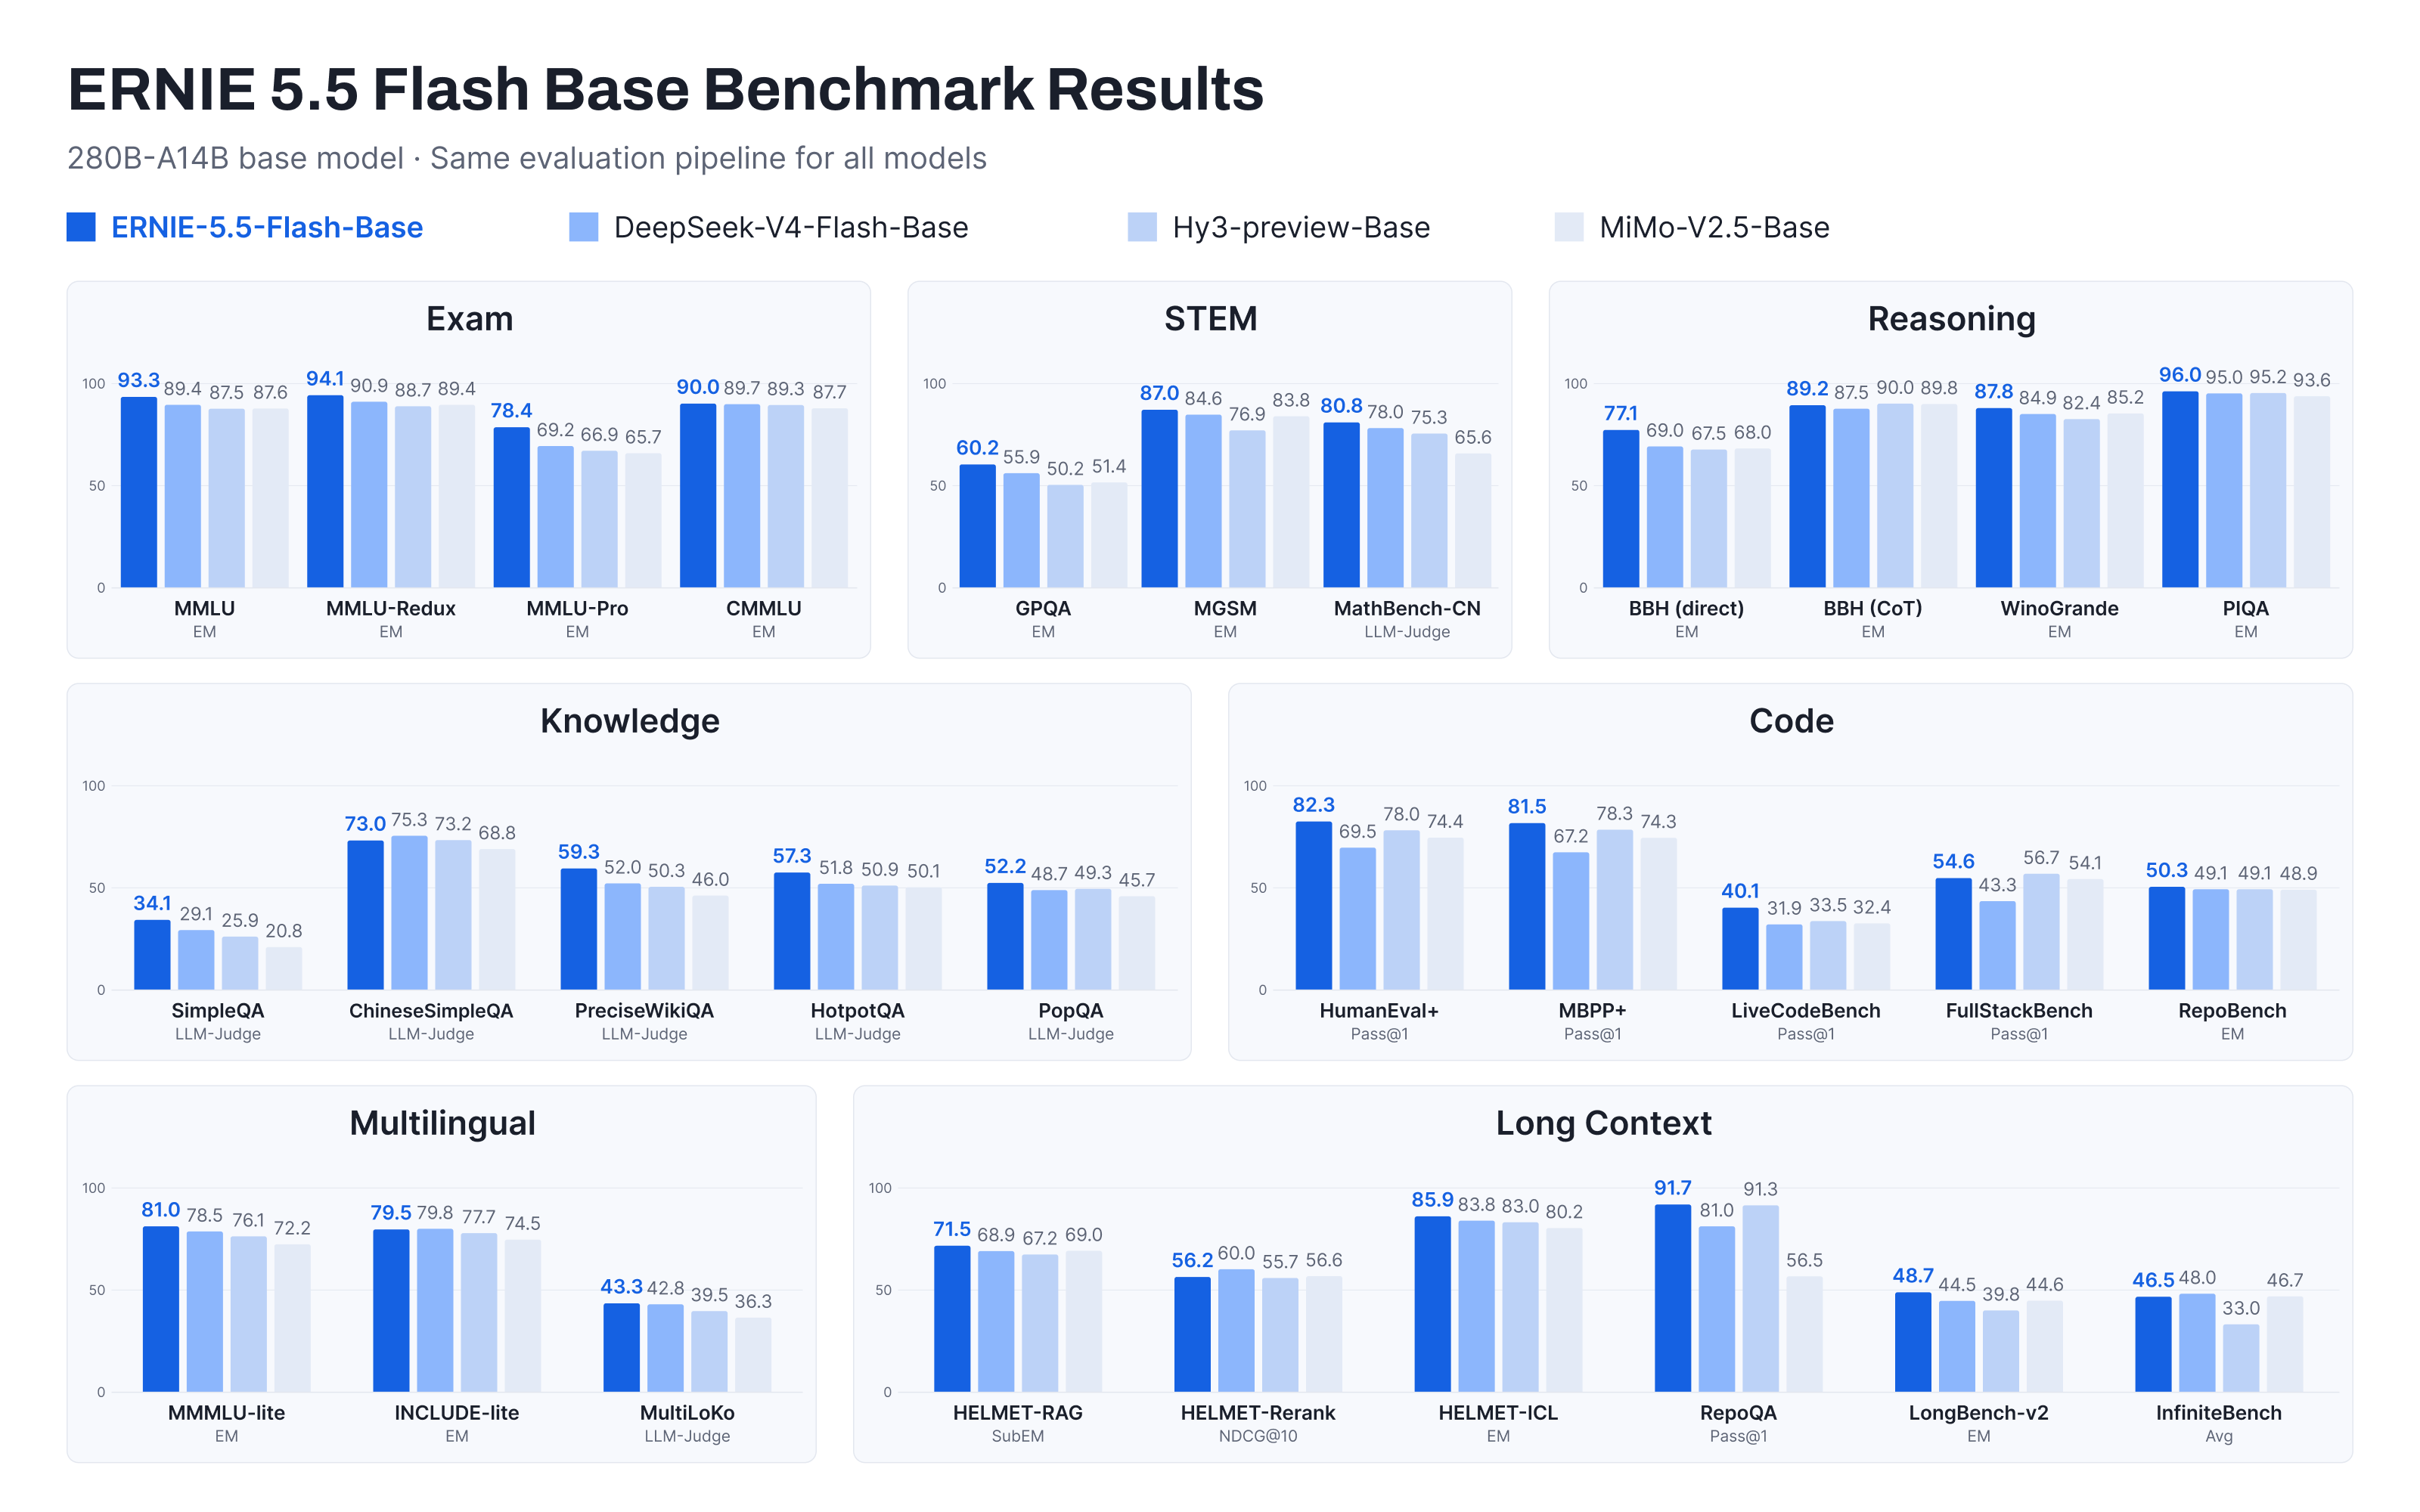 Abbildung: Vergleich der Benchmark-Werte von ERNIE 5.5 Flash Base gegenüber Modellen wie DeepSeek V4 Flash. Quelle: ernie.baidu.com
Bei der Auswahl der Trainingsdaten setzte das Team auf das Prinzip der „irreversiblen Priorität“: Der Schwerpunkt lag massiv auf vollständigen Code-Repositories und tiefgehenden analytischen Fachtexten. Das Verständnis über Dateigrenzen hinweg lässt sich nachträglich kaum durch Fine-Tuning kompensieren. Den rechenintensivsten Schritt an den Anfang der Kette zu stellen, unterstreicht den Wert eines offenen Basismodells.
Pre-Training als öffentliche Infrastruktur: Millionenersparnis für Startups
Innerhalb des Entwicklungszyklus großer Sprachmodelle stellt das Pre-Training den kapitalintensivsten und am wenigsten korrigierbaren Schritt dar. Es ist das Schwerindustriesegment der KI-Forschung mit den höchsten finanziellen Risiken. Ein Parametersystem über 30 Billionen Tokens von Grund auf zu trainieren, erfordert selbst bei optimaler Hardwareallokation zweistellige Millionenbeträge. Kommt es zu Trainingsdivergenzen oder Cluster-Ausfällen, lösen sich erhebliche Summen binnen Stunden in Rechenzentrumswärme auf.
Eine kürzlich in der internationalen Entwickler-Community geführte Debatte verdeutlichte diese Kostenlast: Das Open-Source-Bildgenerierungsprojekt Pjit-21K legte seine minimalistische Trainingsrechnung von 20.000 US-Dollar offen. Selbst bei kleinen Validierungsmodellen zehren die Rechenkosten das Budget unabhängiger Entwickler rasch auf. Wenn Tech-Riesen hochqualitative Basisgewichte freigeben, ersparen sie der nachgelagerten Branche das wiederholte Neuerfinden des Fundaments.
Diese Neuverteilung der Rechenkapazitäten verändert die Budgetplanung vieler Entwicklerteams grundlegend. Wer sich die astronomischen Erschließungskosten des Fundaments spart, kann seine Ressourcen voll auf branchenspezifische Anwendungsfälle konzentrieren. Ob Feinabstimmung auf spezifische Industrieprozesse oder der Aufbau komplexer Agentenlogiken – die Amortisationszeiten verkürzen sich drastisch. Während Großkonzerne die Infrastrukturstraßen asphaltieren, können sich Spezialisten auf die vertikale Tiefe konzentrieren.
Nach der Grundsteinlegung: Der Wettbewerb verlagert sich in reale Industrieanwendungen
Die parallele Freigabe durch Tencent und Baidu markiert einen logischen Schritt in der Industrialisierung von KI-Modellen. Ab Modellen der 100-Milliarden-Parameter-Klasse wandelt sich allgemeines Sprachverständnis in eine öffentlich zugängliche Basisinfrastruktur. Indem finanzstarke Konzerne den teuren Vorlauf bündeln, sinken redundante Fehlversuche in der Branche erheblich. Das unwirtschaftliche Wettrüsten um eigene Basismodelle geht damit schrittweise zu Ende.
Tencent lieferte das voll ausgestattete Produkt, Baidu das fundamentale Rohbaugerüst. Beide Ansätze treiben eine umfassende Arbeitsteilung in der KI-Entwicklung voran. Die teuerste Einstiegshürde – das Pre-Training – wurde von den Konzernen in ein Gemeinschaftsgut überführt. Nun, da die größte Rechnung beglichen ist, beginnt der eigentliche Wettbewerb um den produktiven Nutzen im Praxiseinsatz.
Weiterführende Links:
- Offizielle Veröffentlichung und technischer Systembericht zu Tencent Hunyuan Hy4
- Architekturbericht zu Baidu ERNIE 5.5 Flash Base
- Diskussion auf Hacker News (Trainingsrechnung von Pjit-21K und Open-Source-Gewichte)