2026年11月4日から5日にかけた24時間で、中国のAIエコシステムに大きな地殻変動が起きた。テンセント(Tencent)と百度(Baidu)が、それぞれの最新フラッグシップモデルを同日中に相次いでオープンソース公開したのだ。大手テック企業はもはや最先端モデルをクラウドのAPI課金の壁の奥に閉じ込めない。数千万元(数億円規模)に達する計算リソースの結晶をコミュニティへと開放し、業界全体が背負う最も重い請求書を自ら決済する道を選んだ。
ただし、2社の公開ペースには差異がある。百度の重みファイルはすでにダウンロード可能となっている一方、テンセントの声明では「近日公開」と明記されている。同日の発表でありながら、一方は即日納品、もう一方は間もなく到着という状況だ。
大規模言語モデルの開発において、最大の負担は常に初期の膨大な事前学習フェーズに集中する。モデルに人間言語の文脈とコード規則を学習させるには、数万枚のアクセラレータカードを数カ月にわたりフル稼働させなければならない。数億円に達する電気代とハードウェアの減価償却費は、中小スタートアップにとって到底手の届くものではない。多くの開発チームがシードラウンドの資金を燃やし尽くしながらも、汎用的な推論能力を備えたベースモデルにすら辿り着けずにいた。
24時間で2基のベースモデルが激突:フル装備の完成品か、純粋なスケルトンか
同じタイミングでありながら、2大テック企業が提示したアプローチは好対照だった。テンセントが放った混元(Hunyuan)「Hy4」は、視覚推論とコンピュータ操作(Computer Use)機能を最初から備えたフル装備の完成品路線を歩む。対照的に、百度の「ERNIE 5.5 Flash Base」は白紙のキャンバスだ。事前学習が完了した瞬間の純粋なベース状態のみを抽出し、中盤以降のファインチューニングやアライメントは意図的に余白として残されている。
モデル構築は超高層ビルの建設に似ている。事前学習が基礎杭打ちと鉄骨架構なら、下流のチューニングは内装工事にあたる。百度の技術レポートは、今回の公開が開発者から法外な事前学習コストを取り除くためのものだと率直に述べている。メガテックがインフラを担い、開発者が応用プロダクトを作り込むという業界の役割分担がより明確になった。
テンセントが業務ソフトを直接操作:自社評価スコア3.04の実態
テンセントが投入したHy4の最大の進化は、マルチモーダル入力と実務ソフトウェアの自律操作にある。高解像度画像処理や複雑なグラフ解析、数学的視覚推論のパイプラインを統合。さらにソフトウェアインタラクション面では、コマンドラインとGUIデスクトップを直接制御する機能を組み込んだ。画面ディスプレイのキャプチャとキーボード・マウス入力を直に制御し、複数のソフトウェアをまたいだ連続作業の自動化を狙う。
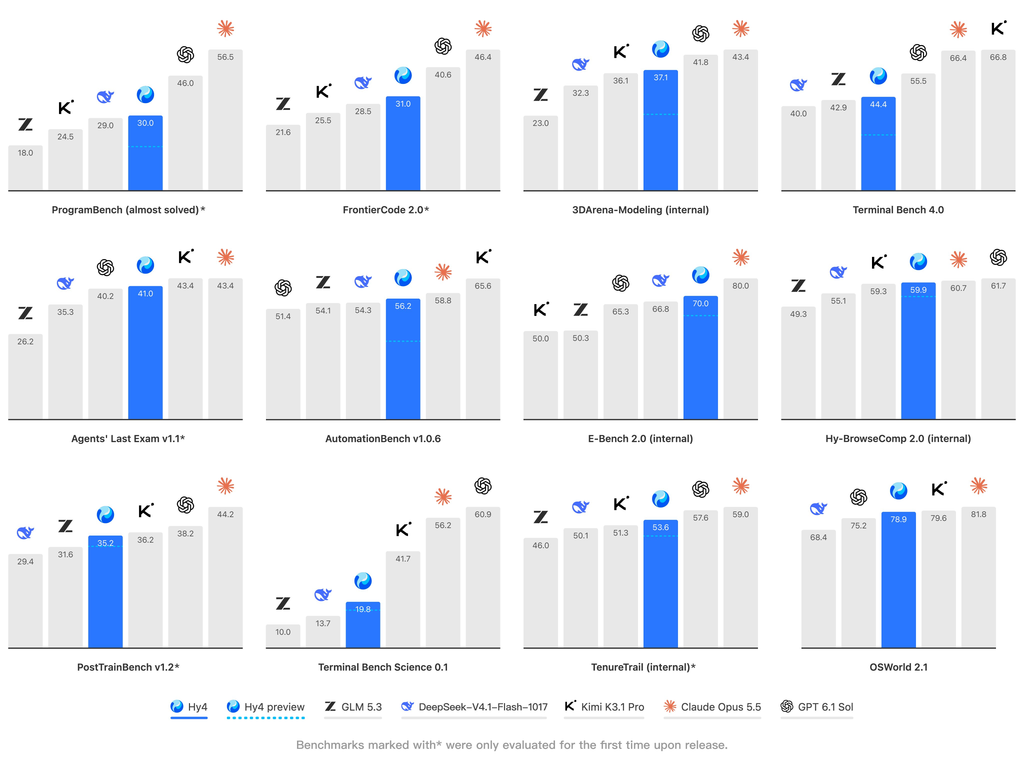 図:視覚理解とエンジニアリングCAD等の複雑なソフトウェア操作におけるHy4の実行パイプライン。出典:tencent.com
開発チームはBlenderやCADといったプロ向けエンジニアリングツールに特化した訓練を実施。デスクトップ自動化ベンチマーク「WorkBuddy」では平均スコア83.18を叩き出し、12シナリオ中9項目でトップを獲得した。専門ツールの操作テレメトリを通じて、マルチステップの複雑な対話における空間推論チェーンの破綻を防いでいる。エラーが許されない実務環境のフィードバックが、長時間のタスクにおける失誤率を強制的に押し下げた。
公式が公表した金融ブラインド評価の結果も目を引く。213名の金融実務者が参加し、579件の実業務タスクを検証した結果、Hy4は総合スコア3.04を記録。DeepSeek-V4.1-Flash-1017の2.97を僅差で上回り、Kimi K3.1 ProおよびGLM-5.3(いずれも2.68)を引き離した。投資調査ベンチマーク「iRaB」ではプレビュー版比で12.03ポイント向上し、根拠のない推測によるエラー率は23.1%から5.6%へ、全体のハルシネーション率も7.2%へと抑制された。
ただし、これらの数値は冷静に受け止める必要がある。153名の外部専門家が参加したとはいえ、評価自体はテンセントの混元チームおよびフィンテック部門が主催したものだ。開発元が設計したテストで自ら首位を取る形であるため、指標の説得力には一定の割り引きが必要となる。真の堅牢性は、独立した外部開発者が実環境のパイプラインで検証したフィードバックを待つ必要がある。
百度が43層のアテンションを再設計:33.5兆トークンの計算量を急所に集中
テンセントの統合型アプローチに対し、百度の「ERNIE 5.5 Flash Base」は下流のチューニング痕跡を一切持たない純粋なベースモデルとして設計された。総パラメータ数2800億に対し、1トークンあたりのアクティブパラメータはわずか140億。百度は33.5兆トークンにおよぶ学習データをゼロから投入し、開発コミュニティのための強固なスタートラインを敷いた。
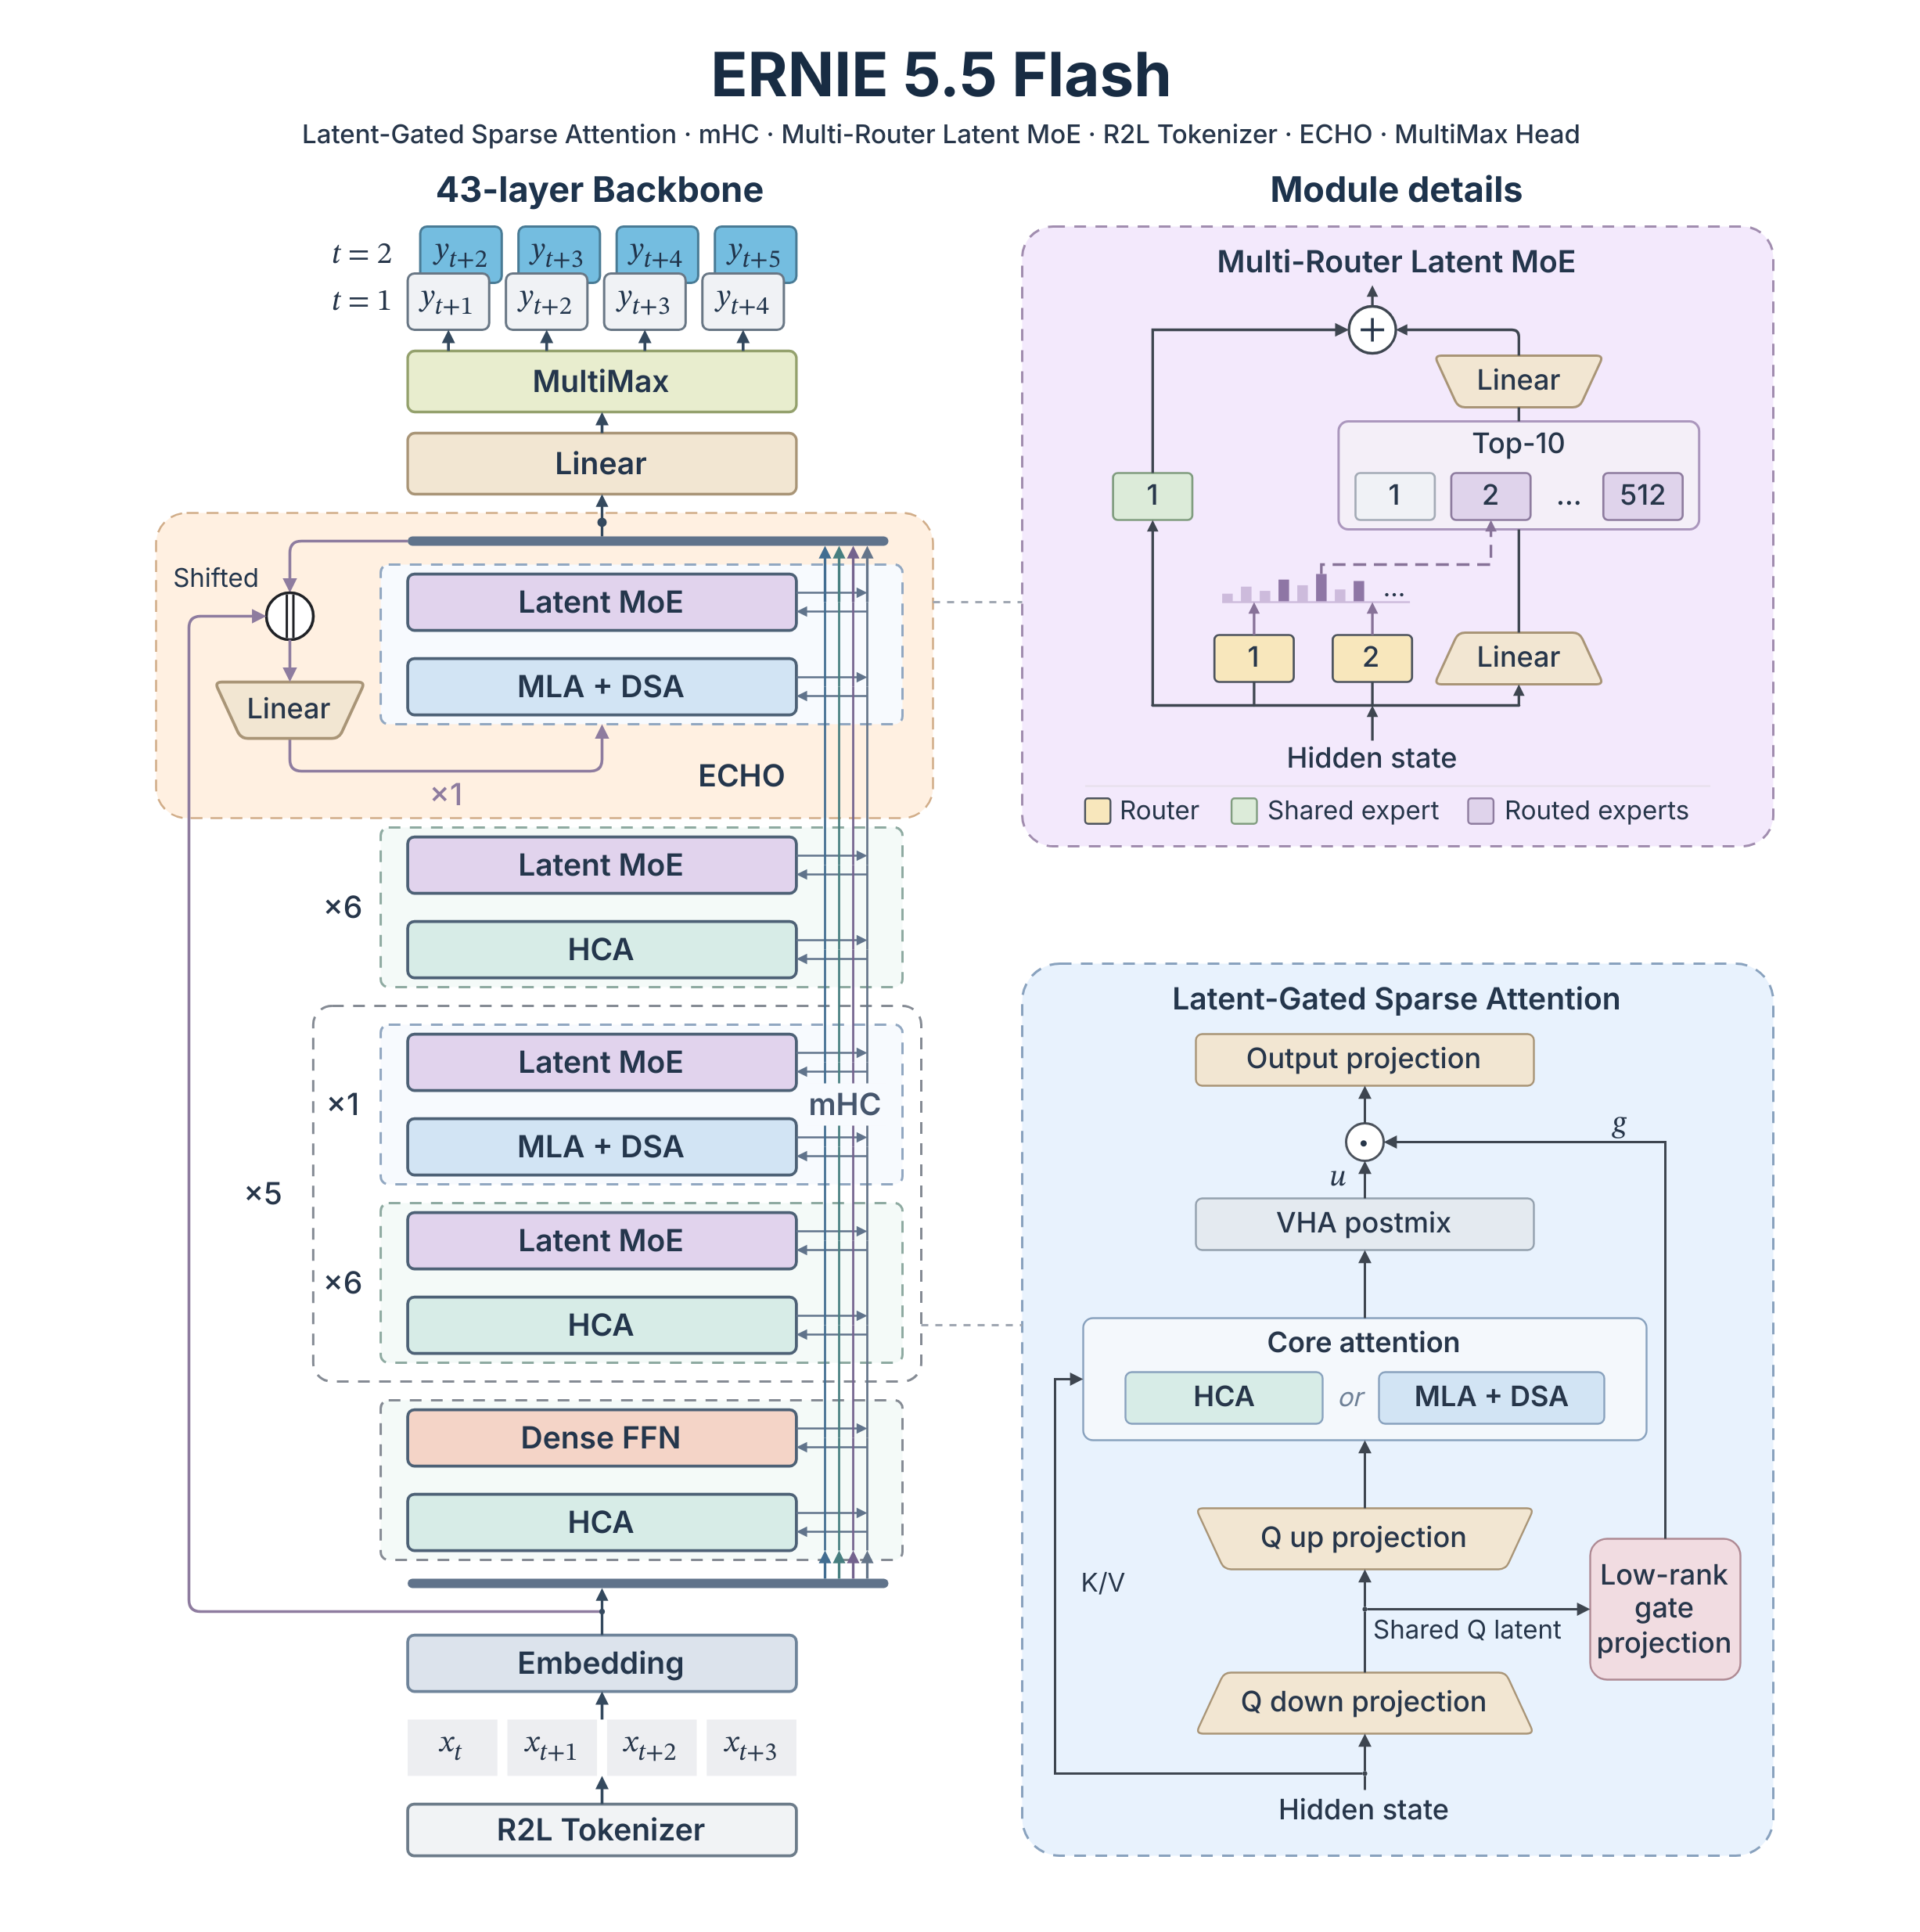 図:43層のバックボーンとハイブリッド・スパース・アテンション機構の詳細。出典:ernie.baidu.com
このアーキテクチャの真骨頂は、長文脈推論における徹底したVRAM削減にある。従来の43層トランスフォーマーでは、すべての層でコンテキスト全体のKVキャッシュを保持する必要があった。百度は思い切った取捨選択を敢行。7層ごとに1層だけ完全な高密度アテンション(Dense Attention)を残し、残る6層では128トークンを一括で1つの特徴ベクトルへと圧縮した。
圧縮層で浮かせたVRAMは、中核となる全量層へと重点配分される。計算コストの低い圧縮層には512次元のワイドヘッドを採用し、負荷の高い全量層には256次元のナローヘッドを配置。メモリキャッシュの予算を急所の層へ集中投下することで、既存のスパース構造を凌駕する実行効率を達成した。この根本的な構造改革により、100万トークンの超長文コンテキストでも安定した動作を維持できる。
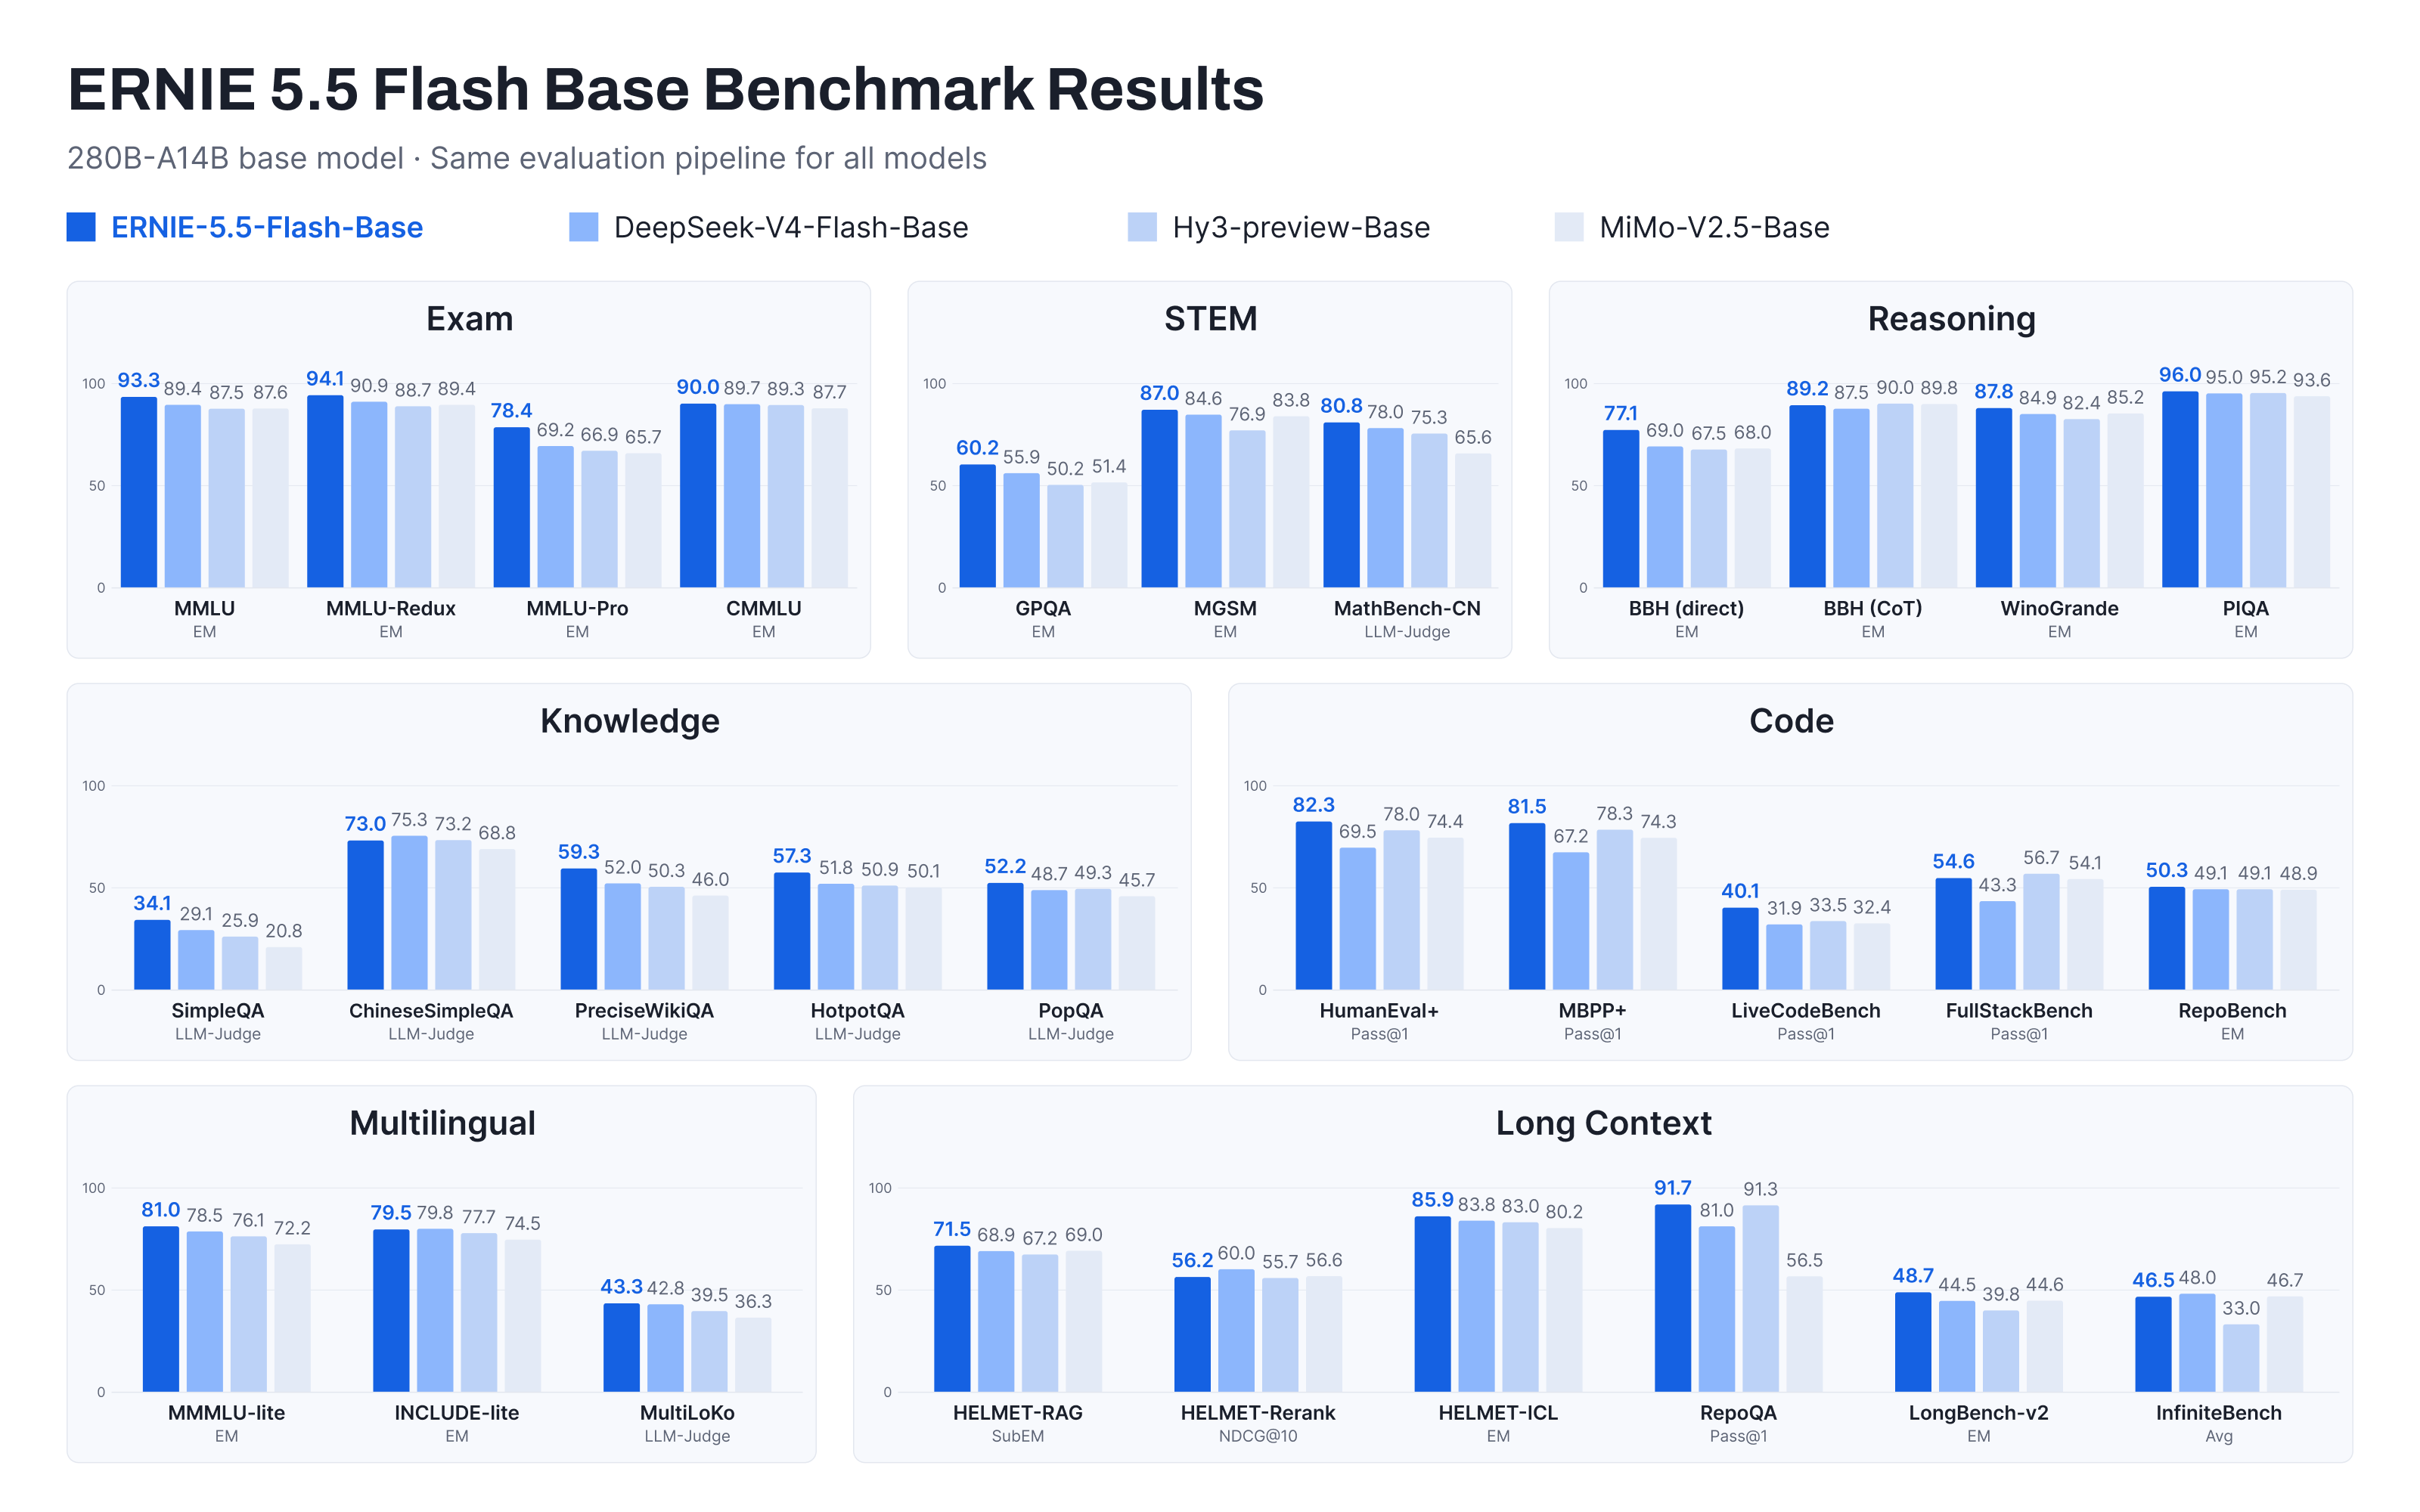 図:ERNIE 5.5 Flash BaseとDeepSeek V4 Flash等によるベンチマークスコアの横断比較。出典:ernie.baidu.com
コーパスの選定において、開発陣は「後戻りできない要素」を最優先した。リポジトリ規模のコードベースや、論理性の高い長文解析テキストへと学習データの比重を大きく傾斜。ファイル横断の構造理解力は、事後のファインチューニングでは補いきれない生来の資質だからだ。最も重労働な工程をファーストステップで完結させる姿勢に、オープンベースモデルとしての覚悟が滲む。
事前学習のインフラ化:中小チームを救う計算コストの肩代わり
大規模言語モデルの開発ライフサイクルにおいて、事前学習は最も資金を消費し、かつ事後修正が効かない工程である。サプライチェーンの中で資本リスクが最も集中する重工業的プロセスだ。30兆トークン規模のパラメータ空間を一から確立するには、最適なハードウェア構成であっても数千万元の初期投資を要する。学習の発散やクラスタ障害に見舞われれば、膨大な電気代は一瞬にしてデータセンターの排熱へと消える。
海外の開発者コミュニティで注目を集めた別の事例も、この費用の重さを物語っている。オープンソース画像生成プロジェクト「Pjit-21K」は、2万ドルという極小予算での学習コストの内訳を公開した。概念実証レベルの小規模モデルであっても、初期の計算消費はインディーズ開発者のランウェイを容易に食いつぶす。大手テック企業が高品質なベース重みを進んで無償公開することは、下流のチームを車輪の再発明から解放する。
計算資源の投資先が変わることで、開発現場の資金配分も再編されつつある。天文学的な基礎インフラ費用から解放されたチームは、限られた予算を自社固有のビジネスロジックや業務特化のファインチューニング、複雑なツールチェーン連携へと集中投下できる。投下資本の回収期間は劇的に短縮され、メガテックがインフラを敷き、バーティカルが深く掘り下げるというエコシステムの分業が確立されつつある。
巨額のインフラ投資の先へ:勝負は実務のディープゾーンへ移行する
テンセントと百度による同日のオープンソース化は、AIモデルが工業化の成熟段階に入ったことを示している。数百億〜千億パラメータの規模において、汎用言語能力はもはや公共インフラと化した。潤沢な計算資源を持つ大手が前段階の重労働を一手に引き受けることで、業界全体の無駄な試行錯誤は大幅に削減される。底なしの基盤モデル開発競争に終止符が打たれ、無秩序な計算リソースの浪費は収束へと向かう。
フル装備の完成品を差し出したテンセントと、極限まで磨かれたスケルトンを提供した百度。両社のアプローチは、AI開発における大規模な分業体制へのシフトを力強く後押しした。最も高額な事前学習のハードルは、大手によって公共インフラへと内包された。最大の請求書が決済されたいま、真の勝負の舞台は複雑なリアルビジネスの現場へと移っている。
参考文献:
- テンセント混元 Hy4 公式発表およびシステム技術レポート
- 百度 ERNIE 5.5 Flash Base アーキテクチャ技術レポート
- Hacker News コミュニティ議論(Pjit-21K 学習コストと重みオープンソース化)