Durante un periodo de 24 horas entre el 4 y el 5 de noviembre de 2026, el ecosistema de IA en China experimentó un movimiento coordinado sin precedentes. Tencent y Baidu anunciaron sucesivamente y el mismo día la liberación en código abierto de sus modelos insignia más avanzados. Las grandes tecnológicas han dejado de encerrar sus checkpoints más potentes tras APIs de nube cerradas y cobros por token. En su lugar, han decidido transferir resultados de cómputo valorados en decenas de millones de yuanes, saldando directamente la factura más abultada de la industria.
El ritmo de publicación, sin embargo, difiere entre ambas compañías. Mientras los pesos de Baidu ya están disponibles para descarga inmediata, Tencent indicó en su comunicado que los suyos se distribuirán “en los próximos días”. Aunque el anuncio coincidió en la misma jornada, uno ya ha entregado el producto y el otro se encuentra en camino.
Durante mucho tiempo, la mayor carga financiera en el desarrollo de grandes modelos de lenguaje ha recaído sobre la fase inicial de preentrenamiento masivo. Para que una arquitectura domine las reglas del lenguaje y el razonamiento lógico del código, los equipos de ingeniería deben coordinar decenas de miles de aceleradores de cómputo durante meses ininterrumpidos. Las facturas multimillonarias de electricidad y amortización de hardware dejan fuera de juego a la gran mayoría de las pequeñas y medianas empresas. Muchas startups agotaban su financiación inicial sin haber logrado un modelo base capaz de razonar de forma general.
Dos modelos base en 24 horas: producto llave en mano frente a lienzo en blanco
En la misma ventana temporal, los dos gigantes optaron por filosofías de resolución radicalmente opuestas. Hunyuan Hy4 de Tencent representa la vía del producto terminado, incorporando de serie razonamiento visual y control directo del ordenador. Por el contrario, ERNIE 5.5 Flash Base de Baidu entrega un lienzo en blanco: preserva únicamente el estado del modelo puro en el instante exacto en que concluyó el preentrenamiento, dejando deliberadamente intactos el posentrenamiento y el ajuste fino posterior.
Construir un modelo de lenguaje es análogo a levantar un rascacielos. El preentrenamiento equivale a hincar los pilotes y verter los cimientos de hormigón; el ajuste posterior es la decoración interior. Baidu admitió con franqueza en su informe que esta publicación busca ahorrar a los desarrolladores los prohibitivos gastos de preentrenamiento. Las grandes tecnológicas se encargan de la infraestructura civil y los desarrolladores construyen las aplicaciones finales, delimitando con mayor claridad la división del trabajo industrial.
Tencent automatiza el software profesional: matices tras su puntuación de 3,04
El núcleo de la evolución de Hy4 radica en la entrada multimodal y la automatización de herramientas profesionales. El modelo incorpora procesamiento de imágenes de alta resolución, análisis de diagramas complejos y razonamiento visual matemático. En el plano de la interacción de software, el equipo de investigación le otorgó capacidad de control directo mediante línea de comandos e interfaz gráfica (GUI), interactuando de forma nativa con pantallas, teclados y ratones para enlazar flujos de trabajo entre múltiples aplicaciones.
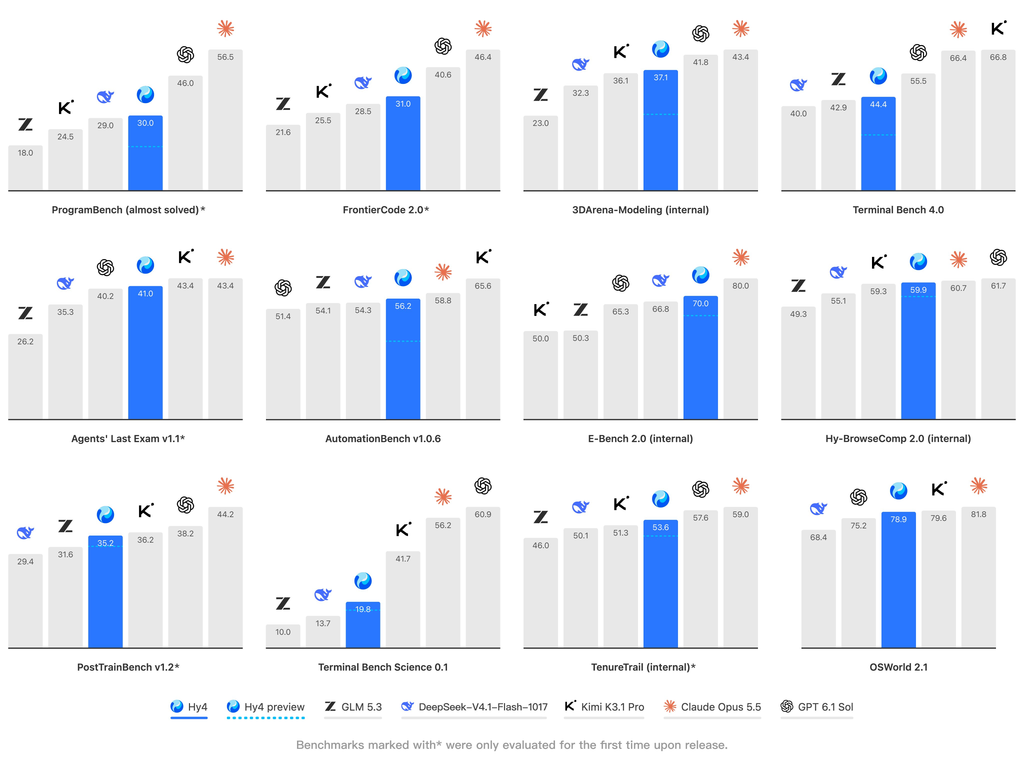 Figura: Tencent ilustra la cadena de ejecución de Hy4 en comprensión visual y control de herramientas complejas de ingeniería CAD. Fuente: tencent.com
El equipo de desarrollo entrenó intensamente el sistema con aplicaciones profesionales como Blender y suites de CAD. En el benchmark de automatización ofimática WorkBuddy, Hy4 alcanzó una media de 83,18 puntos, liderando 9 de los 12 escenarios evaluados. Los datos de interacción con herramientas de ingeniería permitieron consolidar la cadena de razonamiento espacial a lo largo de pasos continuos. La rigurosa tolerancia a fallos de los entornos industriales obliga al agente a minimizar los errores en tareas de ciclo prolongado.
Los resultados oficiales en evaluaciones ciegas del sector financiero también llamaron la atención. Con la participación de 213 profesionales financieros sobre 579 tareas operativas reales, Hy4 obtuvo una puntuación global de 3,04, aventajando ligeramente a DeepSeek-V4.1-Flash-1017 (2,97) y ampliando la distancia frente a Kimi K3.1 Pro y GLM-5.3 (ambos en 2,68). En la prueba de análisis de inversiones iRaB, su rendimiento mejoró un 12,03 % respecto a la versión preliminar, reduciendo los errores por suposiciones infundadas del 23,1 % al 5,6 %, y limitando la tasa de alucinación general al 7,2 %.
Estos datos prometedores deben analizarse con objetividad. A pesar de contar con 153 evaluadores externos, la prueba fue organizada conjuntamente por el equipo de Hunyuan y la división de tecnología financiera de Tencent. Cuando el propio creador diseña el examen y obtiene el primer puesto, las métricas deben interpretarse con cautela. La verdadera solidez del modelo se confirmará cuando los desarrolladores externos lo pongan a prueba en entornos de producción exigentes.
Baidu rediseña 43 capas de atención: optimizando 33,5 billones de tokens de cómputo
A diferencia de la visión integrada de Tencent, ERNIE 5.5 Flash Base de Baidu se posiciona como una base pura sin rastro de ajuste fino posterior. Con un total de 280.000 millones de parámetros, solo activa 14.000 millones por token. Baidu consumió 33,5 billones de tokens para preentrenar el modelo desde cero, entregando una línea de salida sólida para la comunidad técnica.
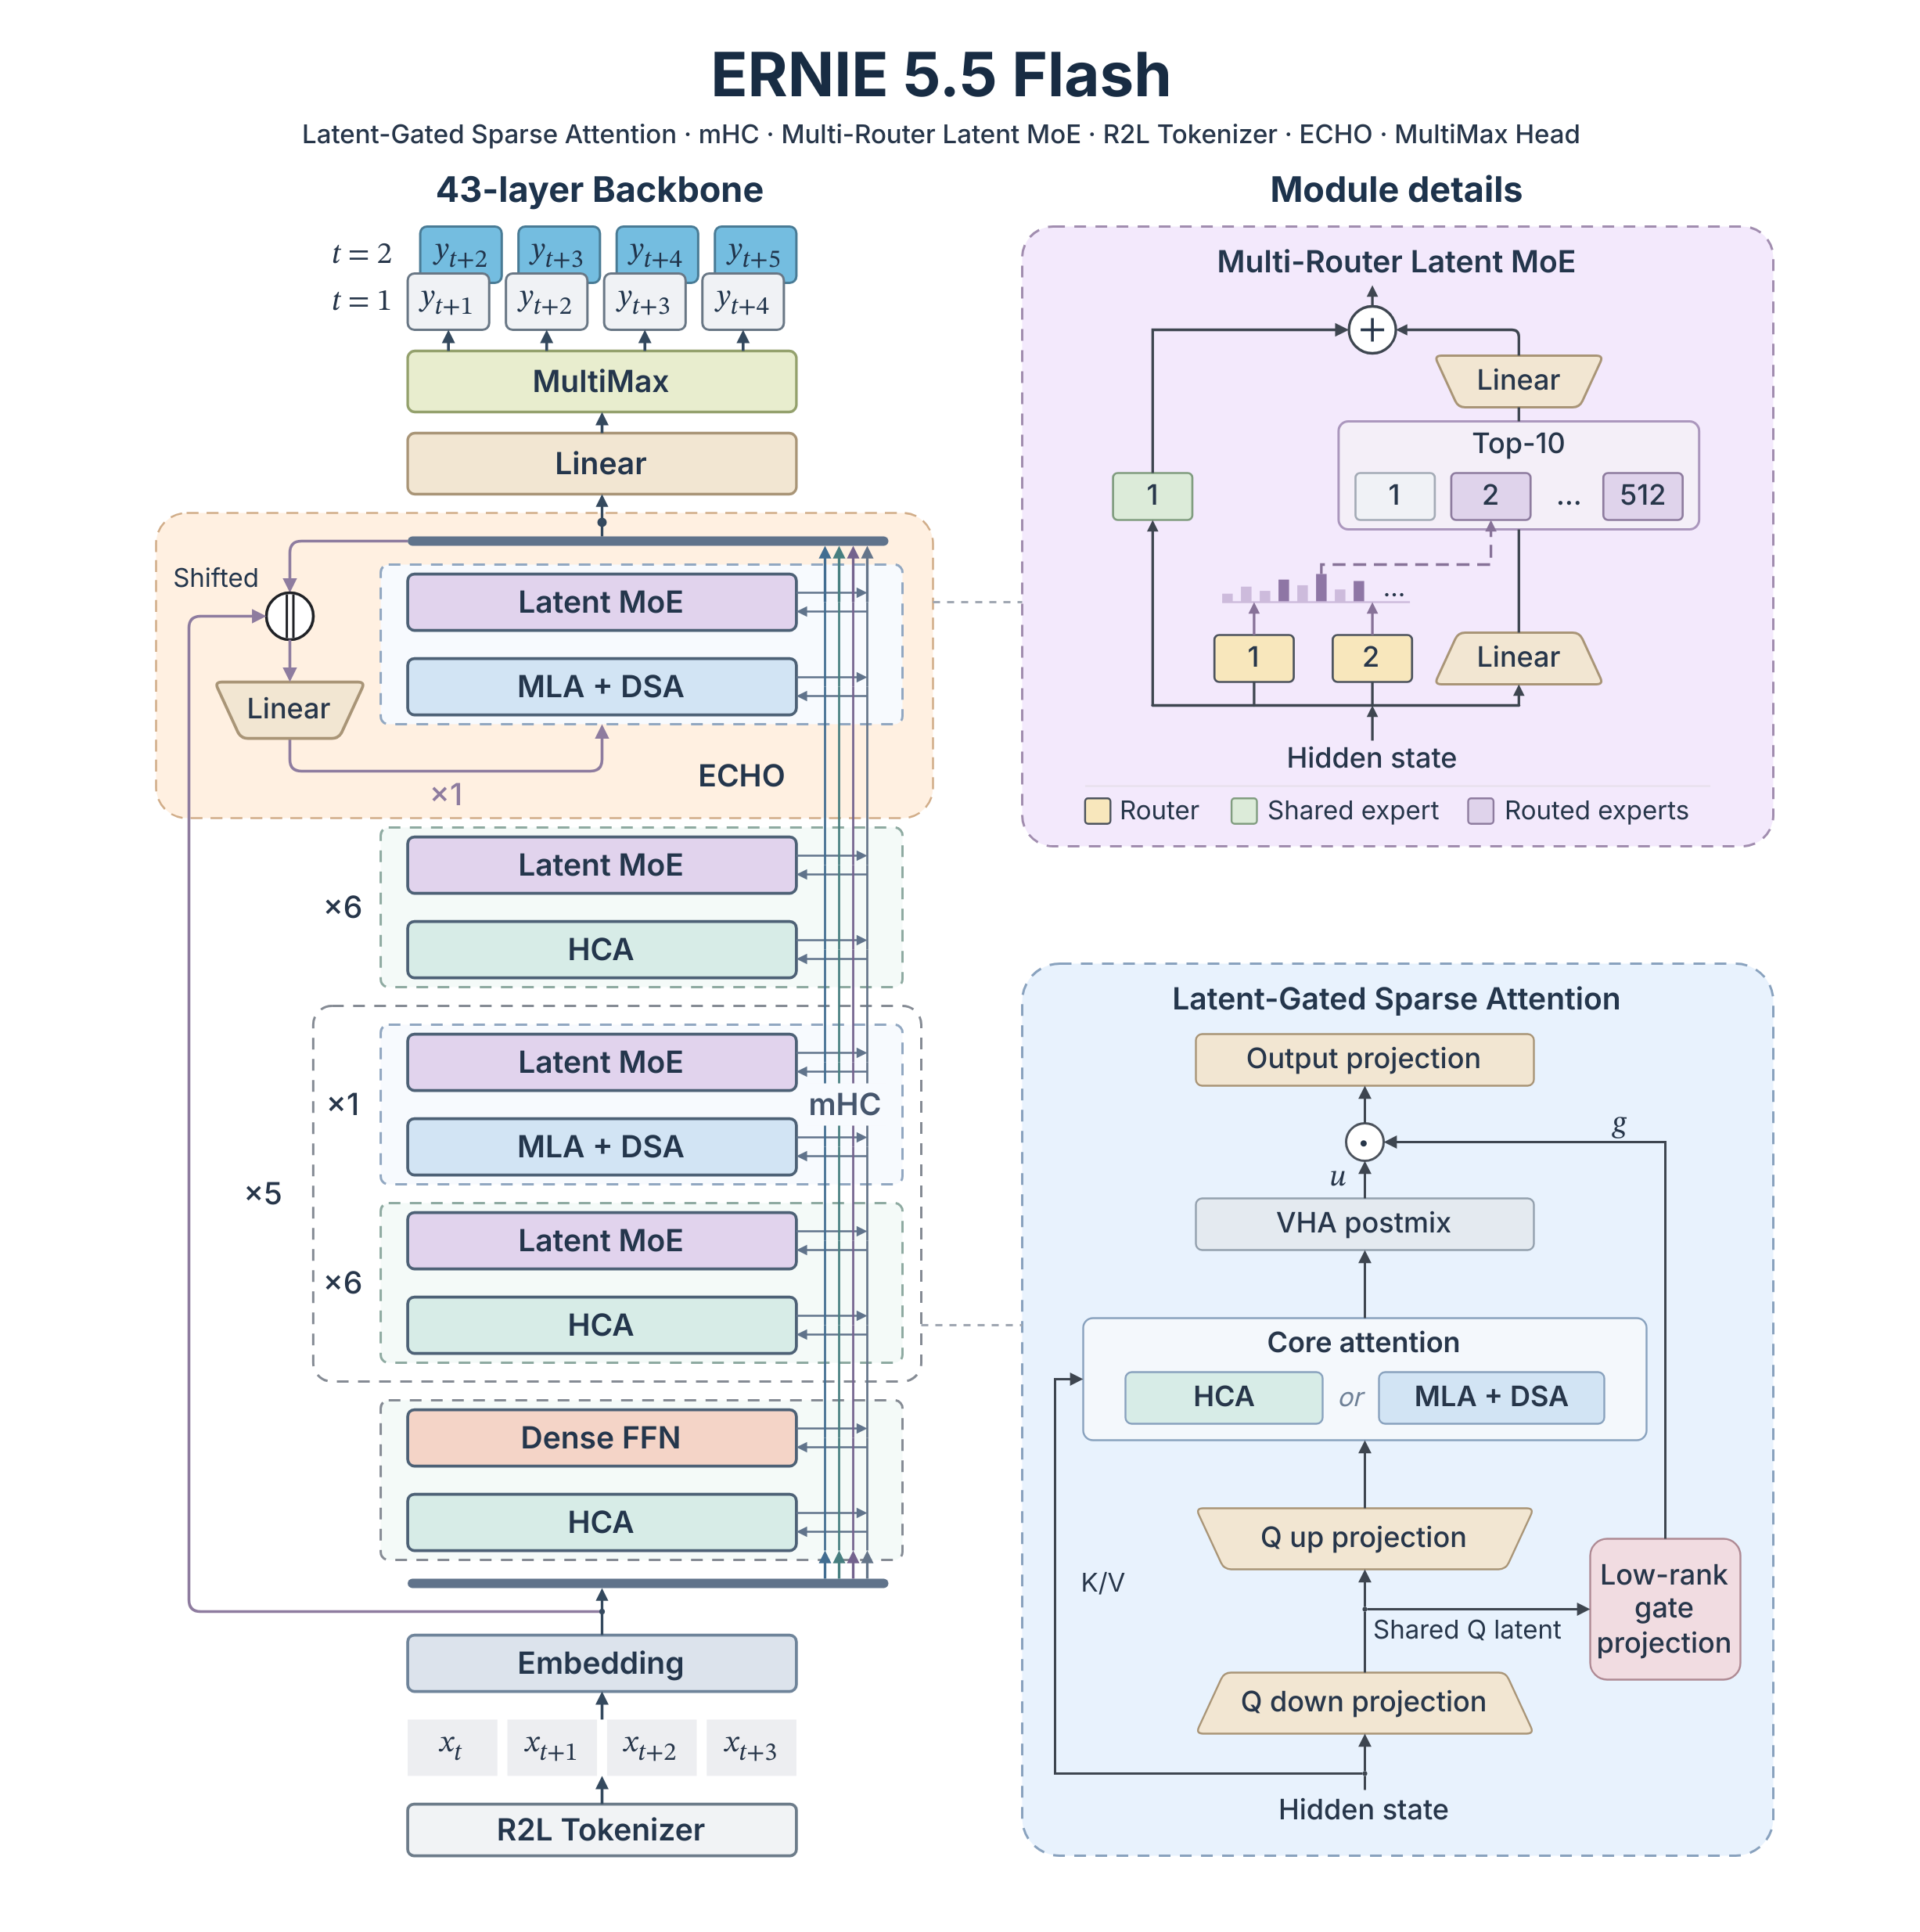 Figura: Detalle estructural de ERNIE 5.5 Flash con sus 43 capas principales y el mecanismo híbrido de atención dispersa. Fuente: ernie.baidu.com
La elegancia de esta arquitectura reside en la gestión exhaustiva de la memoria VRAM durante la inferencia en contextos extensos. En los transformadores convencionales de 43 capas, cada nivel debe retener la caché de claves y valores (KV cache) de todo el contexto. Baidu introdujo una división asimétrica: de cada 7 capas consecutivas, solo 1 mantiene atención densa completa, mientras que las 6 restantes comprimen cada bloque de 128 tokens en un único vector de características.
La memoria de vídeo ahorrada en las capas comprimidas se reasigna a las capas clave de atención total. Las capas comprimidas, más ligeras, emplean cabezales anchos de 512 dimensiones, mientras que las exigentes capas completas utilizan cabezales compactos de 256 dimensiones. Concentrar la memoria de caché exclusivamente en las capas críticas aporta una eficiencia superior a la de los diseños dispersos estándar. Esta optimización arquitectónica garantiza que el modelo mantenga una ejecución fluida incluso en contextos de un millón de tokens.
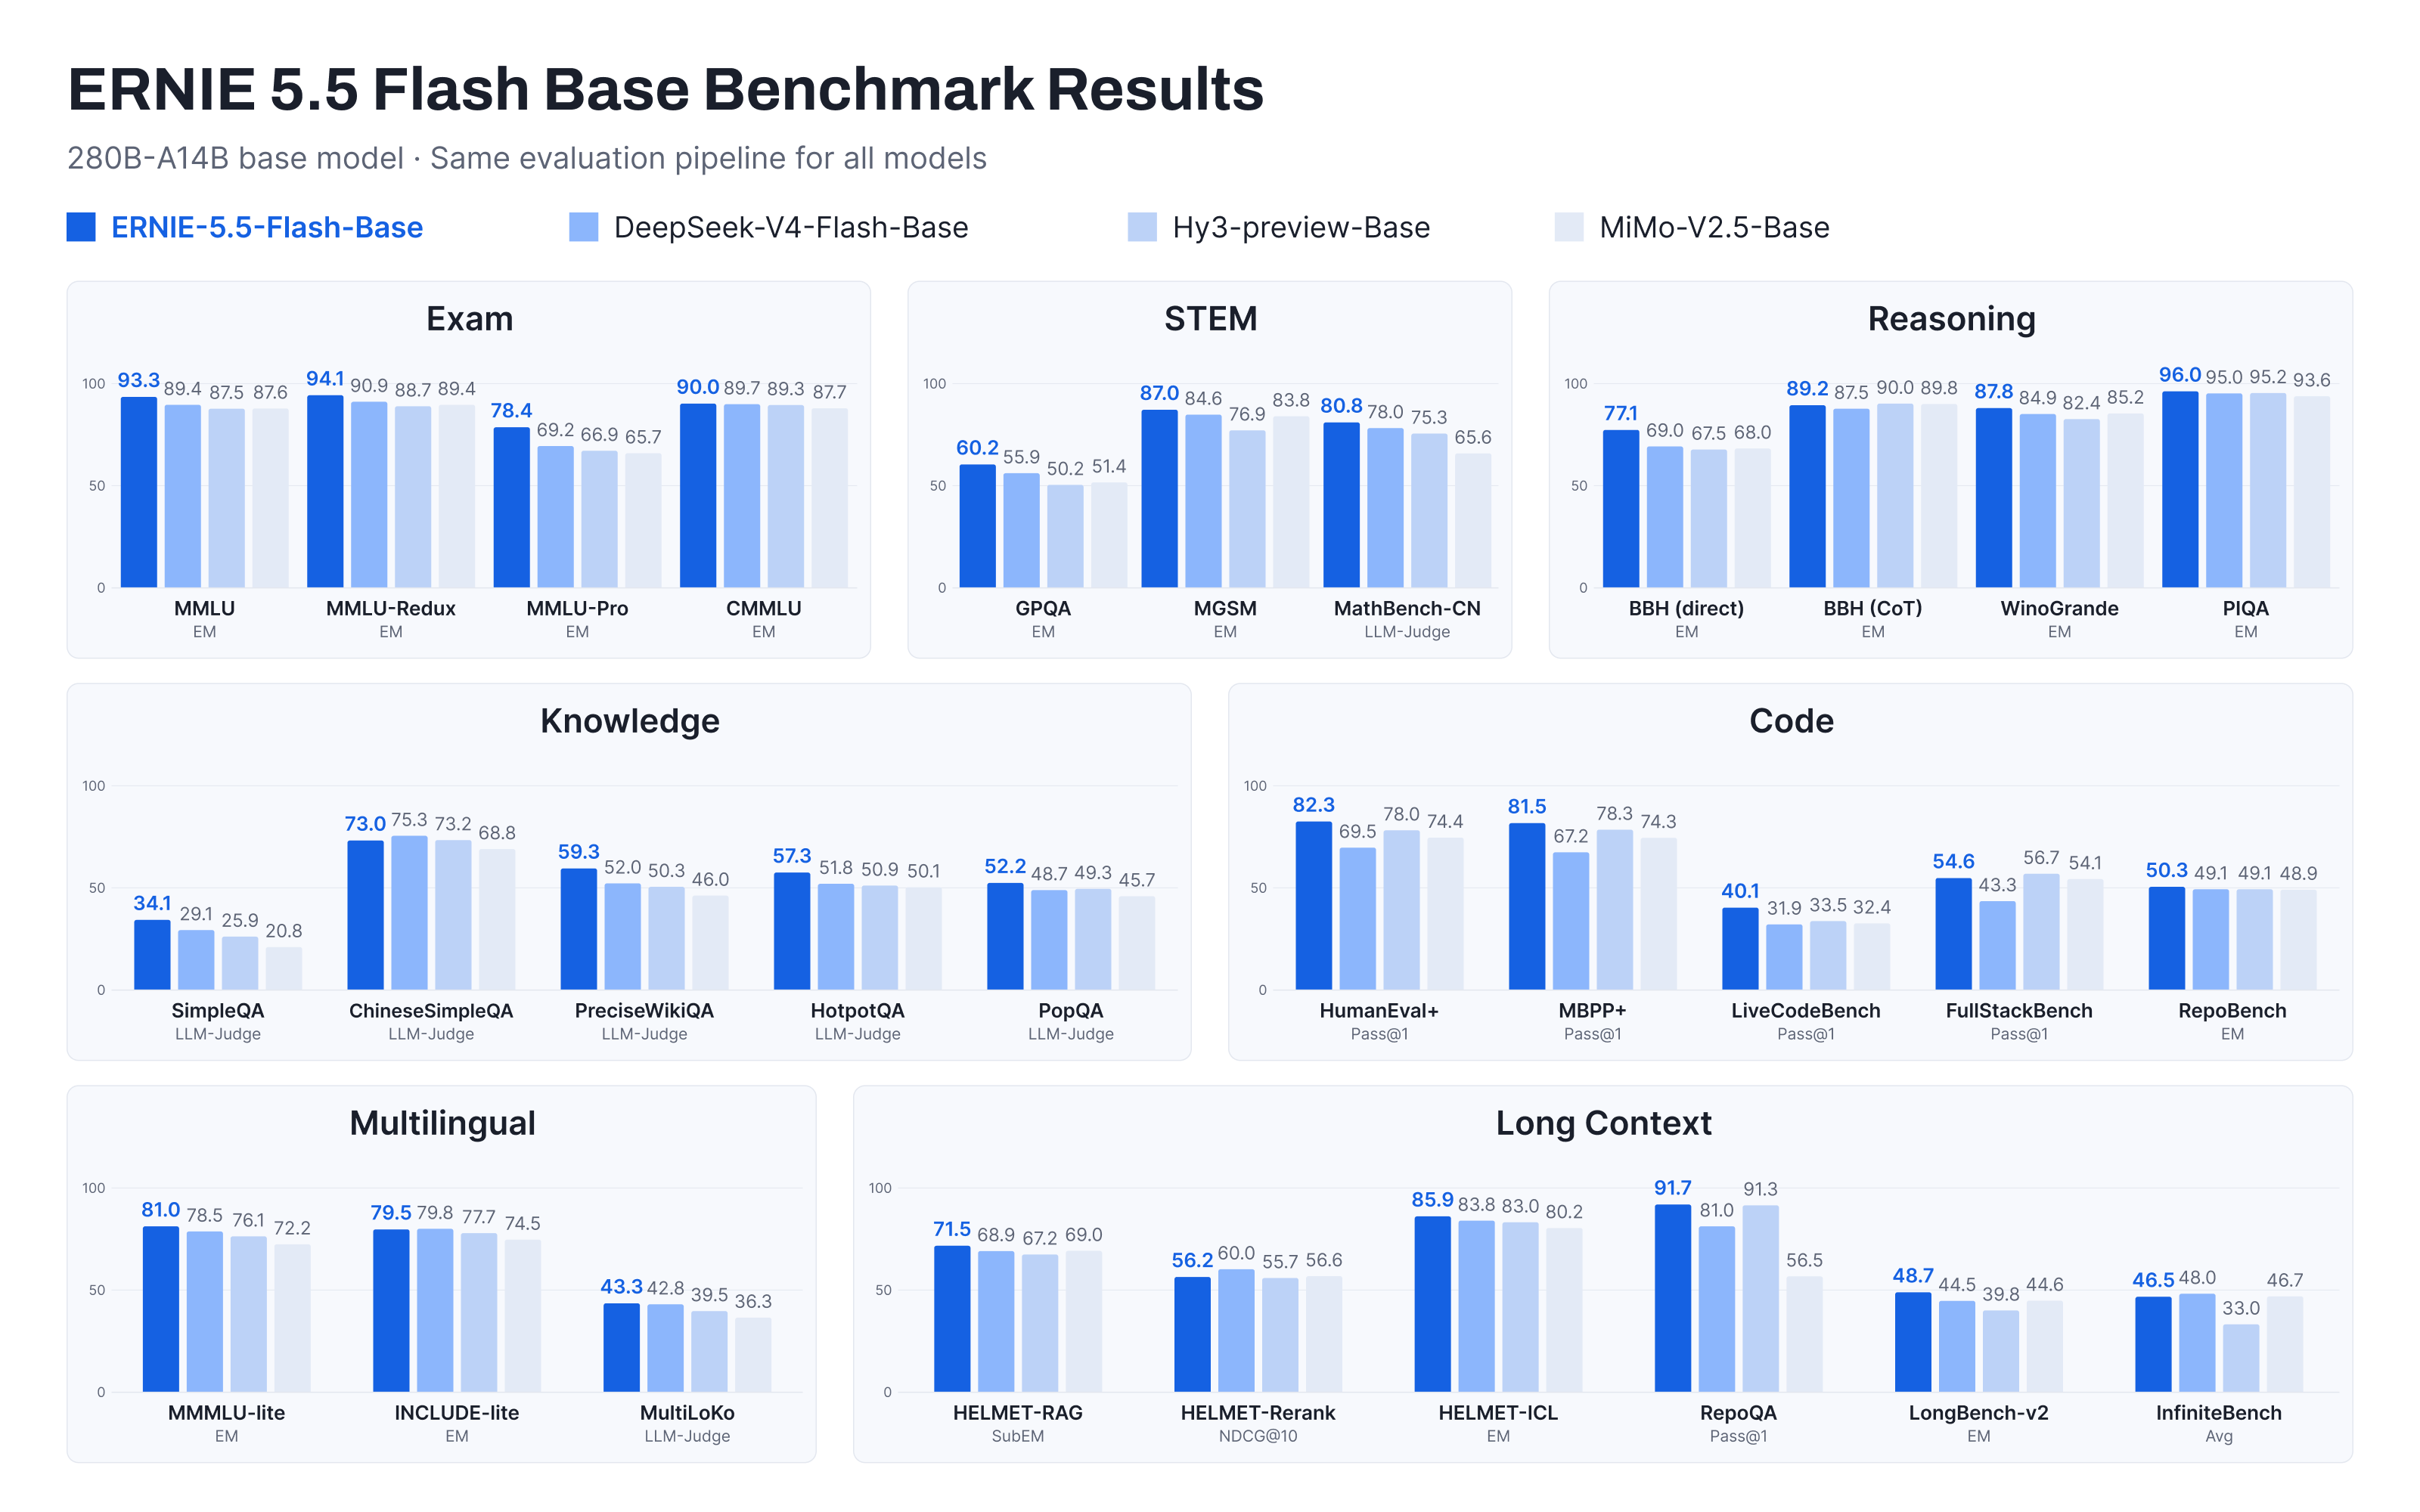 Figura: Puntuaciones en benchmarks de ERNIE 5.5 Flash Base frente a modelos como DeepSeek V4 Flash. Fuente: ernie.baidu.com
En la selección del corpus, los ingenieros aplicaron un estricto criterio de irrevocabilidad: se dio máxima prioridad a repositorios de código completos y razonamientos lógicos extensos. La comprensión estructural entre múltiples archivos es una cualidad innata que difícilmente se subsana con ajustes posteriores. Asumir la labor más costosa en la primera fase del proceso reafirma el auténtico valor de un modelo base.
El preentrenamiento como servicio público: ahorro millonario para startups
En todo el ciclo de vida de los modelos masivos, el preentrenamiento representa la fase con mayor consumo de capital y menor margen de corrección a posteriori. Constituye el sector industrial pesado del aprendizaje automático, donde se concentran los mayores riesgos financieros. Entrenar un sistema de 30 billones de tokens desde cero exige decenas de millones de euros incluso con la mejor infraestructura de hardware. Si el entrenamiento sufre divergencias o fallos de hardware en el clúster, sumas astronómicas se evaporan en calor residual dentro del centro de datos.
Un debate reciente en la comunidad internacional de desarrolladores ilustra este desafío económico: el proyecto de generación de imágenes de código abierto Pjit-21K desglosó un presupuesto de entrenamiento austero de 20.000 dólares. Incluso para modelos de validación preliminar, los costes iniciales de cómputo pueden agotar el presupuesto de un creador independiente. La decisión de las grandes tecnológicas de liberar pesos fundacionales de alta calidad evita que los equipos downstream tengan que reinventar la rueda una y otra vez.
La reorientación del gasto computacional está transformando la gestión de recursos de los desarrolladores. Al liberarse de las facturas desorbitadas de los cimientos, los equipos pueden enfocar su capital en sus propios casos de negocio. Ya sea mediante ajustes finos especializados o la construcción de agentes con flujos de herramientas complejos, los plazos de retorno de inversión se acortan notablemente. Con los gigantes tendiendo las autopistas de infraestructura, los equipos verticales pueden centrarse en la profundidad operativa.
Superada la barrera del cómputo: la verdadera batalla se libra en el terreno de aplicación
La coincidencia temporal en los lanzamientos de Tencent y Baidu refleja una fase de madurez industrial inevitable. Al superar los cientos de miles de millones de parámetros, el conocimiento lingüístico general se transforma en un bien público. Que los gigantes con abundantes reservas de cómputo absorban las tareas pesadas previas reduce drásticamente las duplicidades en todo el ecosistema. La costosa y dispersa guerra de modelos base comienza a cerrarse.
Tencent ha proporcionado un producto totalmente equipado; Baidu ha entregado una estructura estructural pura. Ambas estrategias aceleran una profunda división del trabajo en el sector. La barrera financiera del preentrenamiento ha sido absorbida por las grandes empresas para convertirse en infraestructura abierta. Una vez saldada la factura más pesada, la verdadera contienda se traslada a los retos de la producción real.
Enlaces de referencia:
- Anuncio oficial e informe técnico del sistema Tencent Hunyuan Hy4
- Informe técnico de la arquitectura Baidu ERNIE 5.5 Flash Base
- Debates en la comunidad de Hacker News (costes de entrenamiento de Pjit-21K y pesos abiertos)