Durant les 24 heures comprises entre le 4 et le 5 novembre 2026, l’écosystème chinois de l’IA a connu une synchronisation exceptionnelle. Tencent et Baidu ont annoncé coup sur coup, en une même journée, l’ouverture en open source de leurs modèles phares les plus récents. Les géants technologiques ne cantonnent plus leurs architectures les plus puissantes derrière des accès cloud payants à la consommation de jetons. Ils ont choisi de mettre à disposition des résultats de calcul estimés à plusieurs dizaines de millions de yuans, réglant ainsi directement la note la plus salée de l’ensemble du secteur.
Leur calendrier de déploiement montre néanmoins des disparités. Les poids de Baidu sont d’ores et déjà téléchargeables, tandis que Tencent indique dans son communiqué une publication « dans les jours à venir ». Annoncés le même jour, l’un a déjà livré ses fichiers, l’autre peaufine sa mise à disposition.
Historiquement, le fardeau financier le plus lourd du développement des grands modèles de langage s’est toujours concentré sur la phase initiale de pré-entraînement massif. Pour inculquer à un modèle les subtilités du langage humain et les structures du code informatique, les équipes d’ingénierie doivent mobiliser des dizaines de milliers d’accélérateurs de calcul pendant des mois sans interruption. Des factures d’électricité et d’amortissement de matériel chiffrées en millions d’euros excluent d’emblée la majorité des startups. Nombre de jeunes pousses ont épuisé leur premier tour de table sans même parvenir à finaliser un modèle socle doté d’une capacité de raisonnement généraliste.
Deux modèles fondationnels en 24 heures : l’agent clé en main contre le socle brut
Dans ce même intervalle de temps, les deux entreprises ont adopté des démarches conceptuelles opposées. Le modèle Hunyuan Hy4 présenté par Tencent s’inscrit dans la lignée du produit fini : il intègre nativement le raisonnement visuel et l’interaction directe avec l’ordinateur. À l’inverse, l’ERNIE 5.5 Flash Base de Baidu propose une toile vierge. Il préserve uniquement l’état brut du modèle à la fin exacte de son pré-entraînement, en laissant entièrement de côté le post-entraînement et l’alignement ultérieur.
La conception d’un modèle d’IA s’apparente à l’édification d’un gratte-ciel : le pré-entraînement consiste à forer les pieux et couler les fondations en béton armé, tandis que le fine-tuning correspond aux aménagements intérieurs. Dans son rapport technique, Baidu assume pleinement que cette mise à disposition vise à dispenser les développeurs des coûts exorbitants du pré-entraînement. Les géants du numérique assurent le gros œuvre, les créateurs développent les cas d’usage métiers : la division industrielle du travail s’en trouve clarifiée.
Tencent automatise les suites professionnelles : que vaut son score de 3,04 ?
L’avancée majeure du Hy4 de Tencent porte sur les flux multimodaux et l’automatisation d’outils métiers spécialisés. Le modèle intègre le traitement d’images haute définition, l’analyse de graphiques complexes et le raisonnement mathématique visuel. Sur le plan applicatif, les ingénieurs l’ont doté de la capacité de piloter les systèmes d’exploitation via la ligne de commande ainsi que par l’interface graphique (GUI). Il prend directement le contrôle de l’écran, du clavier et de la souris pour orchestrer des flux continus à travers plusieurs logiciels tiers.
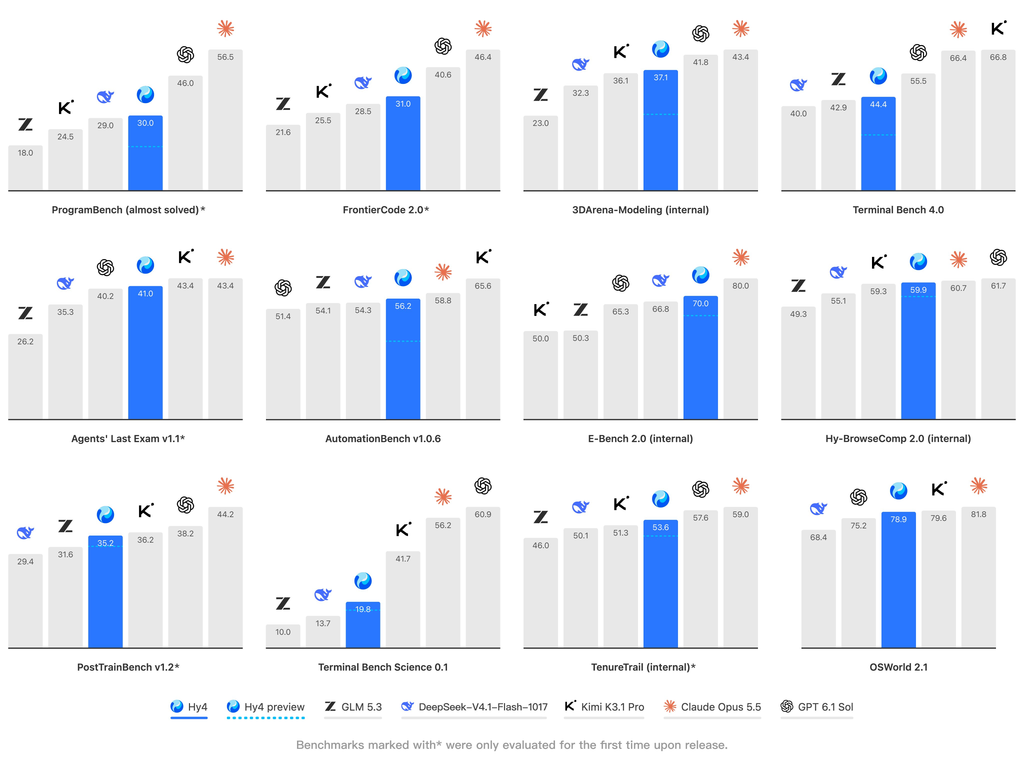 Figure : Pipeline d’exécution de Hy4 dans la compréhension visuelle et la manipulation d’environnements d’ingénierie CAD complexes. Source : tencent.com
Les équipes de recherche ont entraîné le modèle de manière intensive sur des suites professionnelles telles que Blender ou des logiciels de CAO. Sur le benchmark d’automatisation bureautique WorkBuddy, Hy4 a atteint une moyenne de 83,18 points, se classant en tête sur 9 des 12 scénarios testés. Les données d’interaction avec ces outils spécialisés ont permis de stabiliser la chaîne de raisonnement spatial au cours d’exécutions multi-étapes. Les contraintes d’erreur strictes des environnements industriels obligent l’agent à maintenir un taux d’échec minimal sur les tâches longues.
Les résultats publiés sur les tests en aveugle du secteur financier ont également suscité l’intérêt. Soumis à 579 cas pratiques réels évalués par 213 professionnels de la finance, Hy4 a obtenu un score global de 3,04, devançant d’une courte tête DeepSeek-V4.1-Flash-1017 (2,97) et creusant l’écart avec Kimi K3.1 Pro et GLM-5.3 (tous deux à 2,68). Sur le banc d’essai d’analyse d’investissement iRaB, ses performances progressent de 12,03 points par rapport à la version preview. Son taux d’erreurs dues à des hypothèses non fondées a chuté de 23,1 % à 5,6 %, tandis que le taux global d’hallucinations a été comprimé à 7,2 %.
Ces performances prometteuses méritent un regard lucide. Bien que le protocole ait fait appel à 153 évaluateurs externes, le test a été supervisé conjointement par l’équipe Hunyuan et les divisions fintech internes de Tencent. Lorsqu’un constructeur conçoit l’examen dont il sort vainqueur, la valeur des métriques doit être examinée avec recul. La robustesse opérationnelle du système sera jugée sur pièces par les développeurs tiers sur leurs propres chaînes de production.
Baidu réarchitecture 43 couches d’attention : 33,5 billions de tokens ciblés
À rebours de l’approche intégrée de Tencent, l’ERNIE 5.5 Flash Base de Baidu se revendique comme un socle pur, vierge de tout réglage en aval. Avec 280 milliards de paramètres au total, il n’en active que 14 milliards par jeton. Baidu a injecté 33,5 billions de tokens pour pré-entraîner cette architecture depuis zéro, posant ainsi une ligne de départ solide pour l’ensemble des développeurs open source.
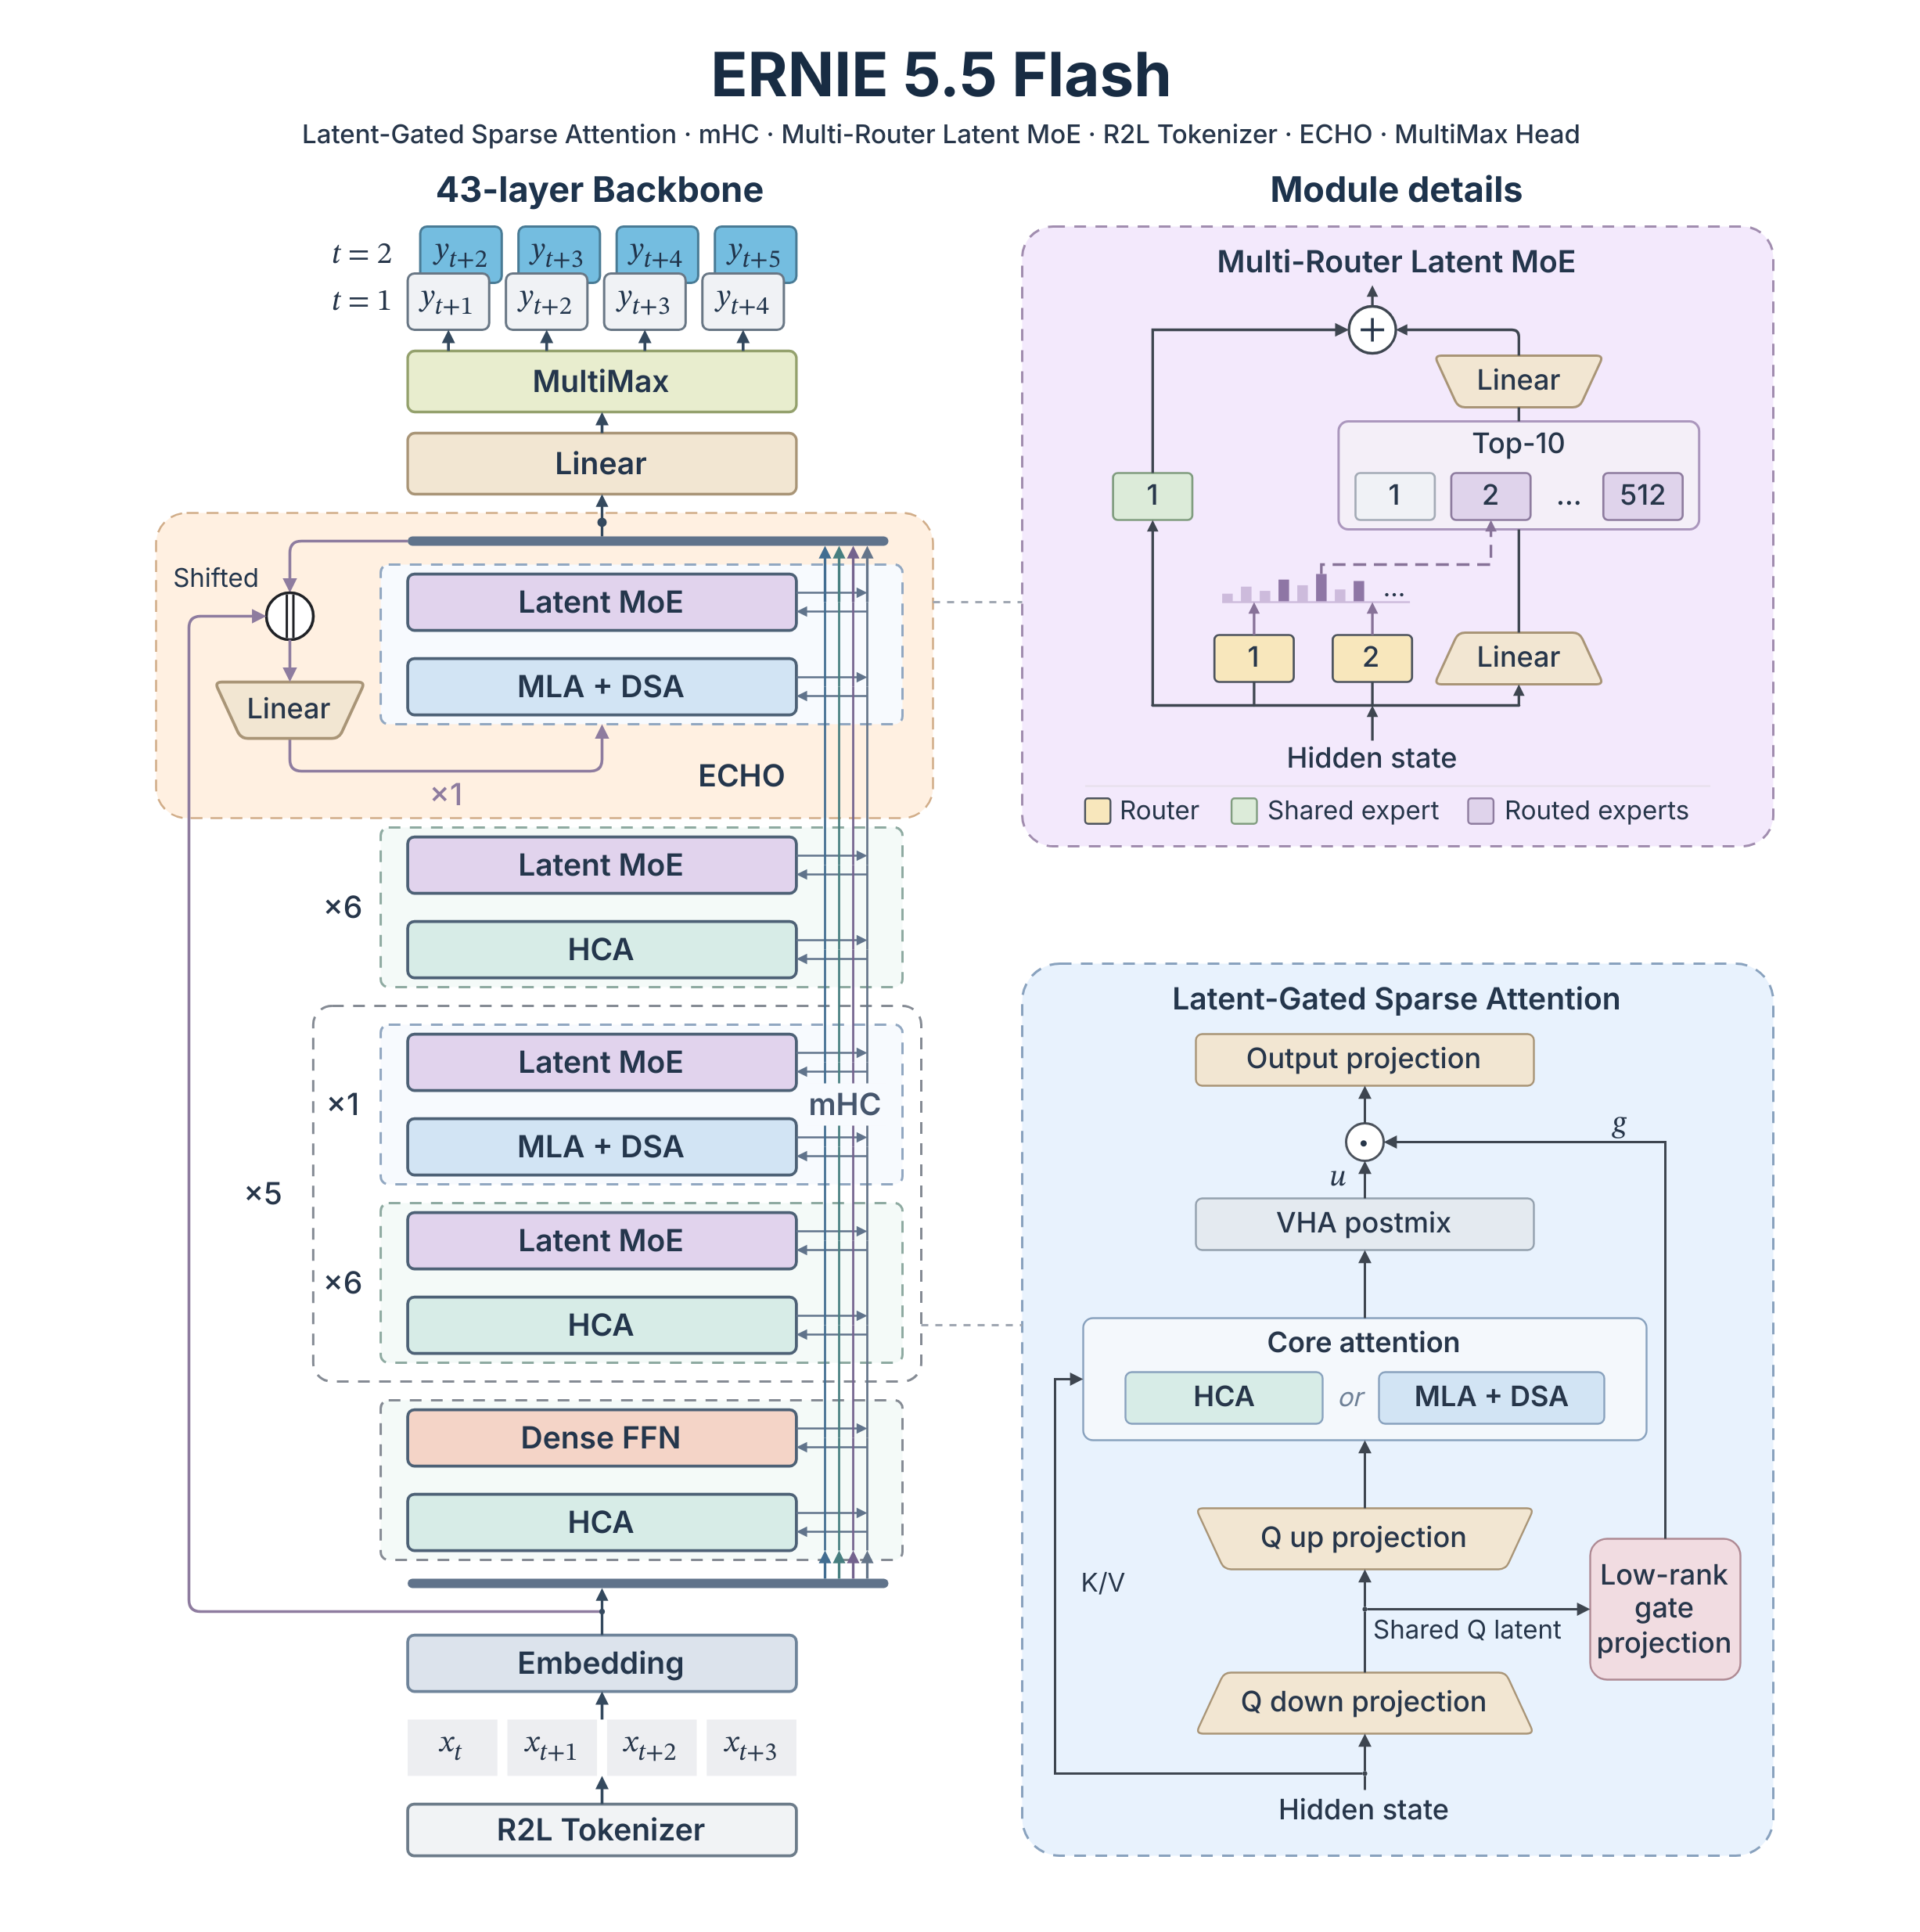 Figure : Détail architectural d’ERNIE 5.5 Flash présentant sa structure à 43 couches et son mécanisme hybride d’attention éparse. Source : ernie.baidu.com
L’élégance de cette architecture réside dans une gestion rigoureuse de la mémoire vidéo lors du traitement de contextes étendus. Dans les transformers classiques à 43 couches, chaque niveau conserve l’intégralité du cache de clés et de valeurs (KV cache) sur toute la longueur du contexte. Baidu a fait un choix radical : sur 7 couches consécutives, seule 1 couche préserve une attention dense complète, tandis que les 6 autres compressent chaque bloc de 128 jetons en un vecteur de caractéristiques unique.
La mémoire VRAM épargnée par les couches de compression est réinjectée vers les couches critiques à pleine attention. Les couches compressées, moins coûteuses, adoptent de larges têtes de 512 dimensions, tandis que les couches denses recourent à des têtes resserrées de 256 dimensions. Cette concentration du budget mémoire sur les niveaux stratégiques procure un rendement supérieur à celui des architectures éparses traditionnelles. Grâce à cette refonte structurelle, le modèle gère sereinement des contextes atteignant un million de jetons.
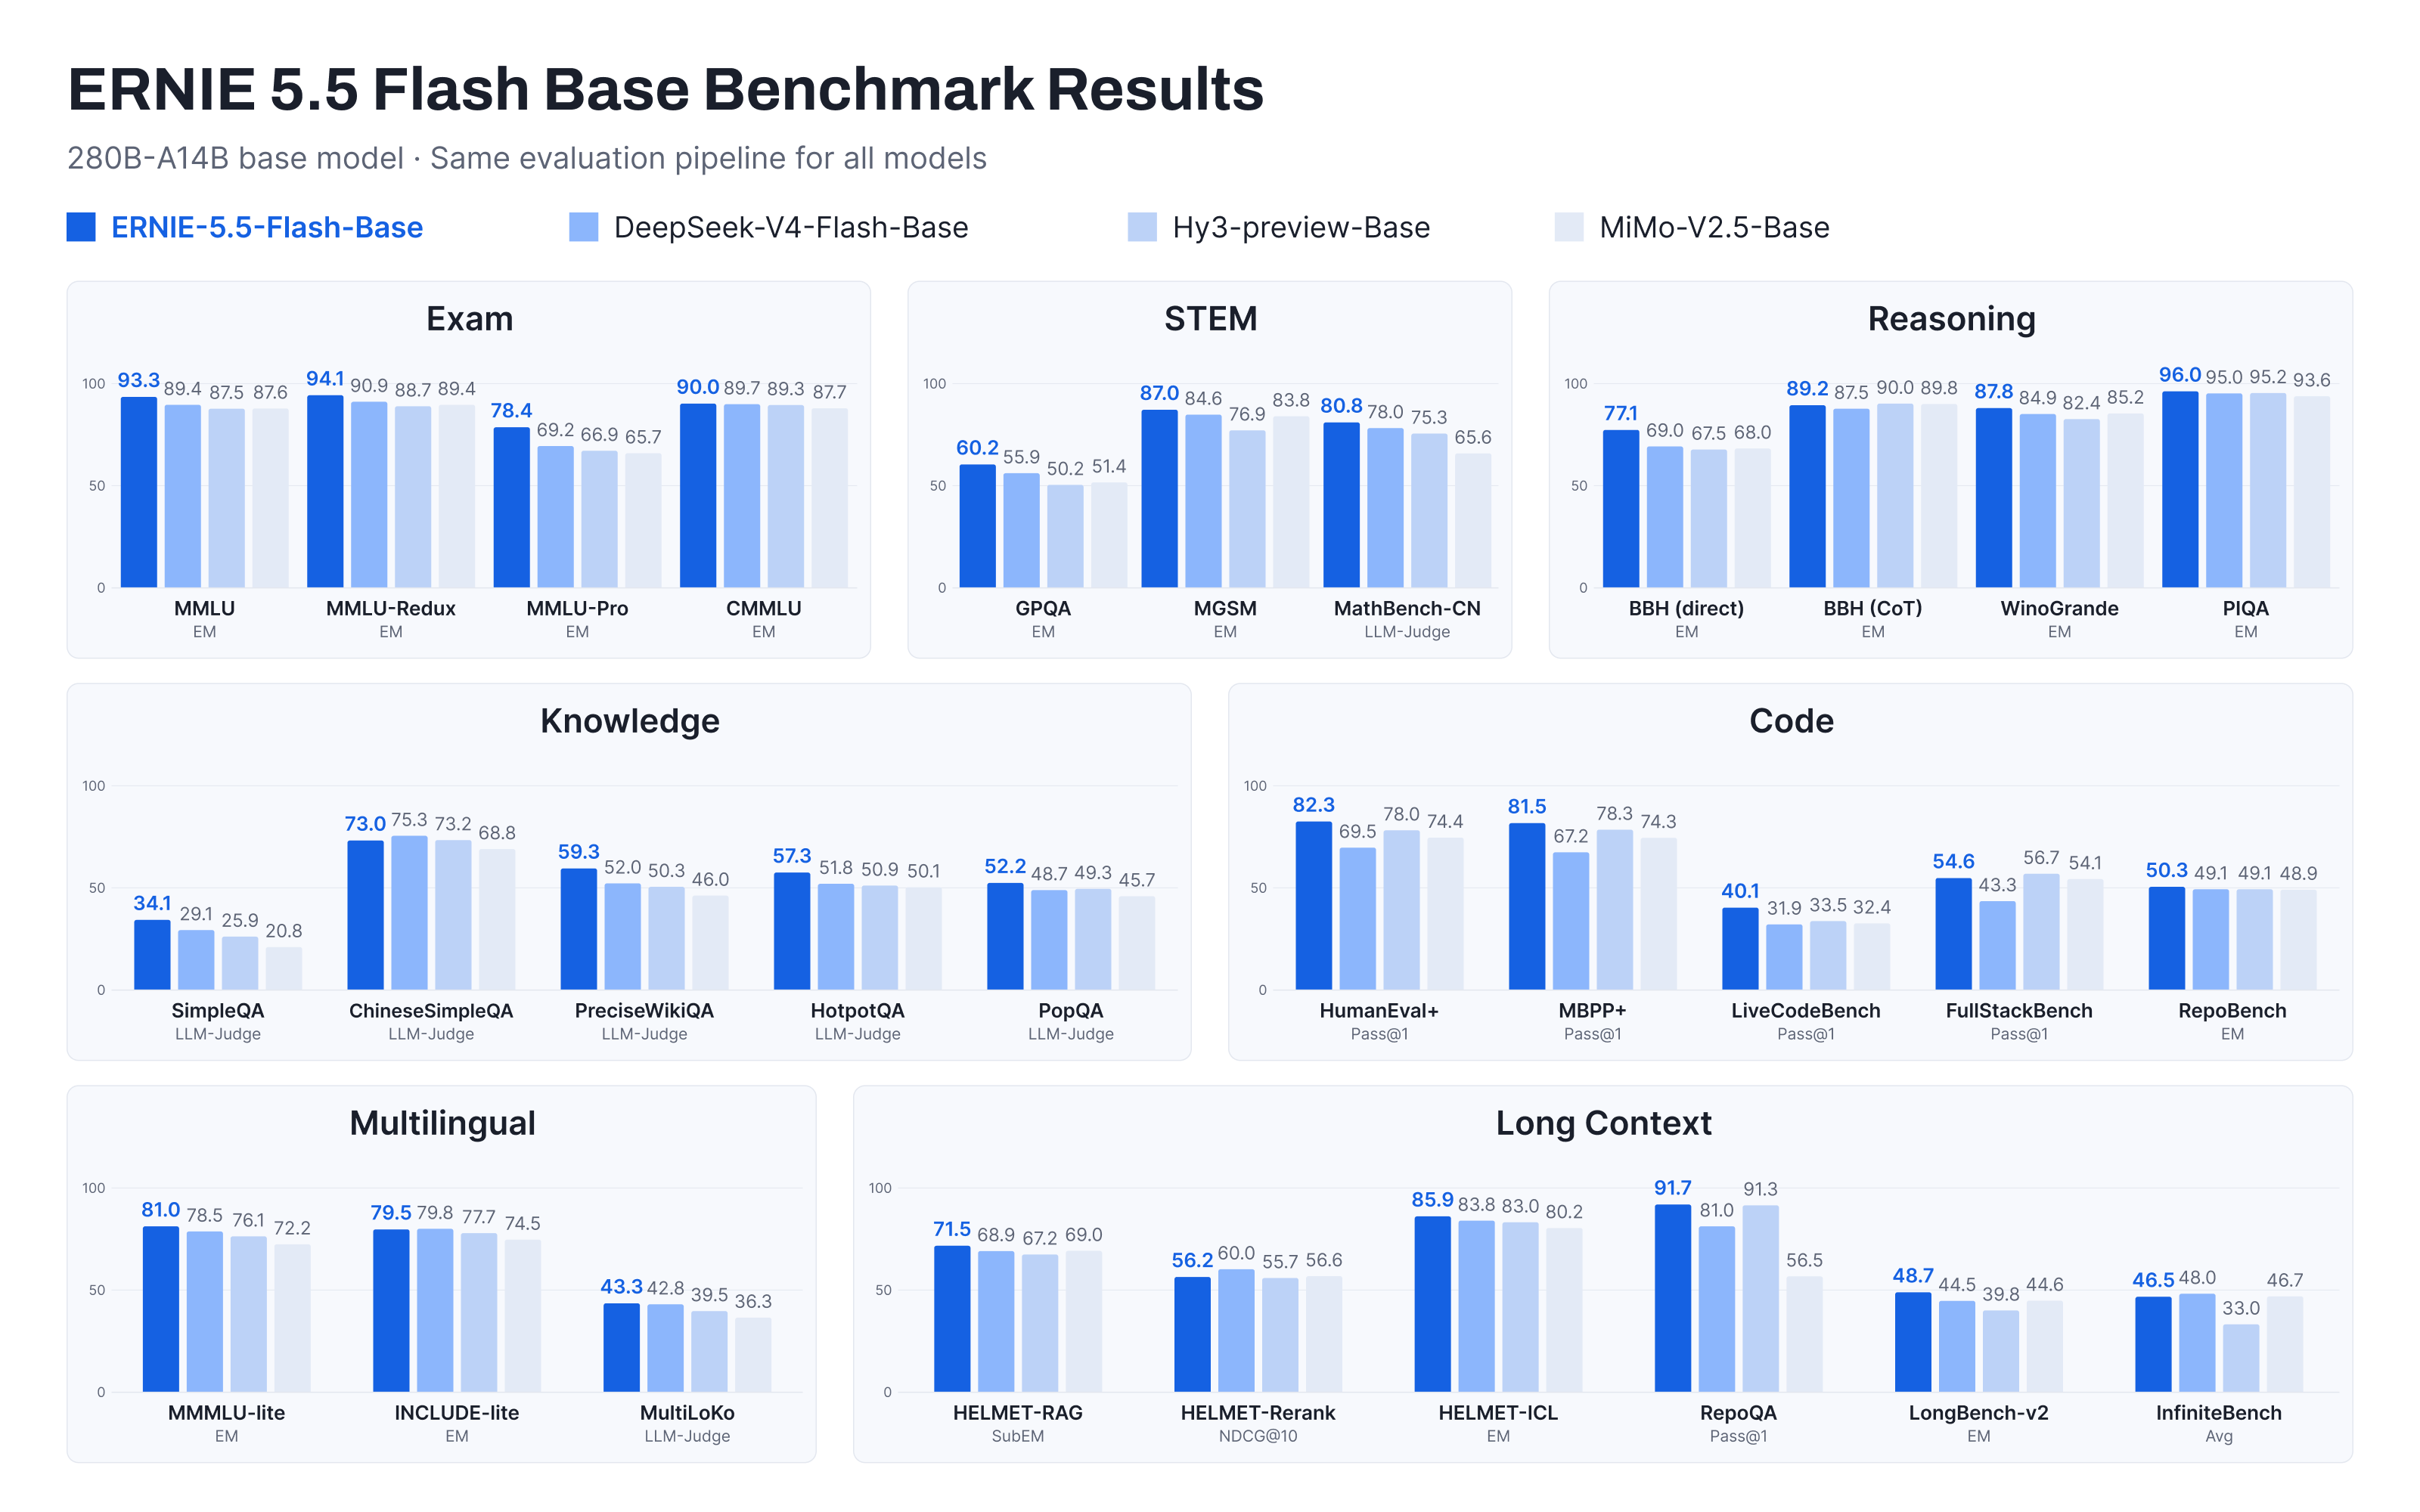 Figure : Comparaison des scores de performance d’ERNIE 5.5 Flash Base face à des modèles tels que DeepSeek V4 Flash. Source : ernie.baidu.com
Dans la composition de son corpus, les ingénieurs ont appliqué un principe de priorité aux compétences irréversibles : les données d’entraînement ont largement privilégié les dépôts de code complets et les analyses logiques denses. La compréhension globale des relations entre plusieurs fichiers constitue une aptitude native qu’un ajustement a posteriori ne peut que difficilement rattraper. En assumant le travail le plus lourd dès la première phase, Baidu confère toute sa pertinence au modèle socle.
Le pré-entraînement érigé en service public : des millions d’économies pour les startups
Sur l’ensemble du cycle de vie des modèles géants, le pré-entraînement demeure l’étape la plus dispendieuse en capital et la plus définitive. C’est le segment d’industrie lourde de l’IA, où se concentrent les risques financiers les plus élevés. Construire un modèle de 30 billions de jetons à partir de zéro réclame des dizaines de millions d’euros d’investissement initial, même avec un parc matériel optimal. Si l’entraînement diverge ou qu’une panne majeure survient, des sommes colossales partent en fumée sous forme de chaleur résiduelle dans les datacenters.
Une discussion récente au sein de la communauté internationale illustre la réalité de ces contraintes budgétaires : le projet open source de génération d’images Pjit-21K a rendu public son coût d’entraînement minimaliste de 20 000 dollars. Même pour un galop d’essai d’échelle modeste, le calcul préliminaire entame à vive allure la trésorerie d’un développeur indépendant. En choisissant de libérer des poids de base de haut niveau, les mastodontes de la tech évitent aux équipes applicatives de reconstruire inutilement les mêmes socles.
Cette répartition des efforts transforme en profondeur la stratégie d’investissement des créateurs de logiciels. Débarrassées des dépenses vertigineuses liées au gros œuvre, les équipes peuvent mobiliser leurs capitaux sur leurs propres métiers. Qu’il s’agisse de spécialiser un modèle sur un pipeline industriel précis ou de concevoir des agents capables d’appels d’outils sophistiqués, le retour sur investissement devient nettement plus rapide. Les géants construisent l’infrastructure ferroviaire, les spécialistes développent les services verticaux.
Au-delà du socle subventionné : la véritable compétition se joue sur le terrain opérationnel
L’initiative conjointe de Tencent et Baidu témoigne d’une étape de maturation industrielle incontournable. À l’échelle de centaines de milliards de paramètres, les capacités linguistiques générales deviennent un bien d’infrastructure publique. Confier aux groupes disposant d’importantes réserves de calcul la prise en charge des phases les plus ardues réduit considérablement les doublons et les tâtonnements superflus à l’échelle du secteur. L’ère des dépenses inconsidérées pour fabriquer des bases génériques redondantes touche à sa fin.
Tencent a livré une solution opérationnelle clé en main, tandis que Baidu a mis à disposition une structure brute d’une grande rigueur. Ces deux postures accélèrent une spécialisation indispensable de la recherche en IA. Le cap le plus onéreux — celui du pré-entraînement — a été intégré par les grands acteurs sous forme de commodité partagée. La plus grosse facture étant désormais réglée, la véritable confrontation peut commencer sur le terrain des cas d’usage réels.
Références :
- Annonce officielle et rapport technique du système Tencent Hunyuan Hy4
- Rapport technique d’architecture de Baidu ERNIE 5.5 Flash Base
- Échanges sur Hacker News (coûts d’entraînement de Pjit-21K et poids en open source)