Dieselbe Datenbank mit 3,3 Milliarden Datensätzen, dieselbe Flut an hochgradig nebenläufigen, zufälligen Schreibzugriffen: Tauscht man den darunterliegenden netzwerkgebundenen Cloud-Speicher gegen lokale NVMe-Festplatten im Servergehäuse aus, steigt die Verarbeitungsgeschwindigkeit schlagartig um das 9,24-Fache.
Sobald eine Produktivdatenbank träge wird, suchen Engineering-Teams reflexartig nach langsamen Abfragen, legen neue Indizes an oder stocken den Arbeitsspeicher auf. Auf der Postgres-Community-Konferenz POSETTE 2026 zerlegten Ingenieure die Laufzeit einer einzelnen Transaktion in ihre Einzelteile. Von 36,9 Millisekunden Gesamtlatenz entfielen gerade einmal 2 Millisekunden auf tatsächliche Rechenoperationen der CPU. Die restlichen 35 Millisekunden verbrachte der Prozess mit reinem Warten darauf, dass der entfernte Speicher die Daten über das Netzwerk lieferte.
Der Flaschenhals des Systems lag keineswegs in mangelnder Rechenleistung. Die Ursache war die Cloud-Festplatte, die über Netzwerkkabel in einem entfernten Rack angebunden war.
37 Millisekunden Latenz analysiert: Reine Rechenzeit nur 2 Millisekunden
Wachsen Datenbestände massiv an, entwickeln Produktivdatenbanken typische Nebenläufigkeitssymptome: Schreibvorgänge dauern statt Sekunden plötzlich Minuten, Leselatenzen springen von Millisekunden in den Sekundenbereich, der Autovacuum-Prozess kommt dem Tabellen-Bloat nicht mehr hinterher, Checkpoint-Schreibvorgänge konkurrieren mit Produktivtransaktionen, und in den Replikations-Pipelines stauen sich die Änderungen an.
Um der Ursache auf den Grund zu gehen, setzte das Team von ClickHouse acht identisch konfigurierte Datenbank-Cluster auf AWS m6id.4xlarge-Instanzen auf. Die Maschinen verfügten über 16 vCPUs, 64 GB RAM und 16 GB shared_buffers. Die einzige Variable war die Speicherschicht: Vier Cluster nutzten standardmäßige gp3-EBS-Volumes mit vorkonfigurierten 3.000 IOPS, während die anderen vier Cluster direkt auf den hosteigenen, lokalen NVMe-SSDs betrieben wurden.
Der Test-Workload basierte auf einer gewaltigen Tabelle mit 3,3 Milliarden Zeilen und einem Datenvolumen von 482 GB. 64 Client-Verbindungen und 16 Worker-Threads führten über fünf Minuten hinweg intensive zufällige UPDATE-Operationen aus. Die Cluster mit lokalen SSDs erzielten 16.030 Transaktionen pro Sekunde (TPS), während die EBS-Cluster lediglich 1,734 TPS erreichten. Die mediane Latenz sank von 36,9 ms auf 4,0 ms – ein Durchsatzunterschied um das 9,24-Fache.
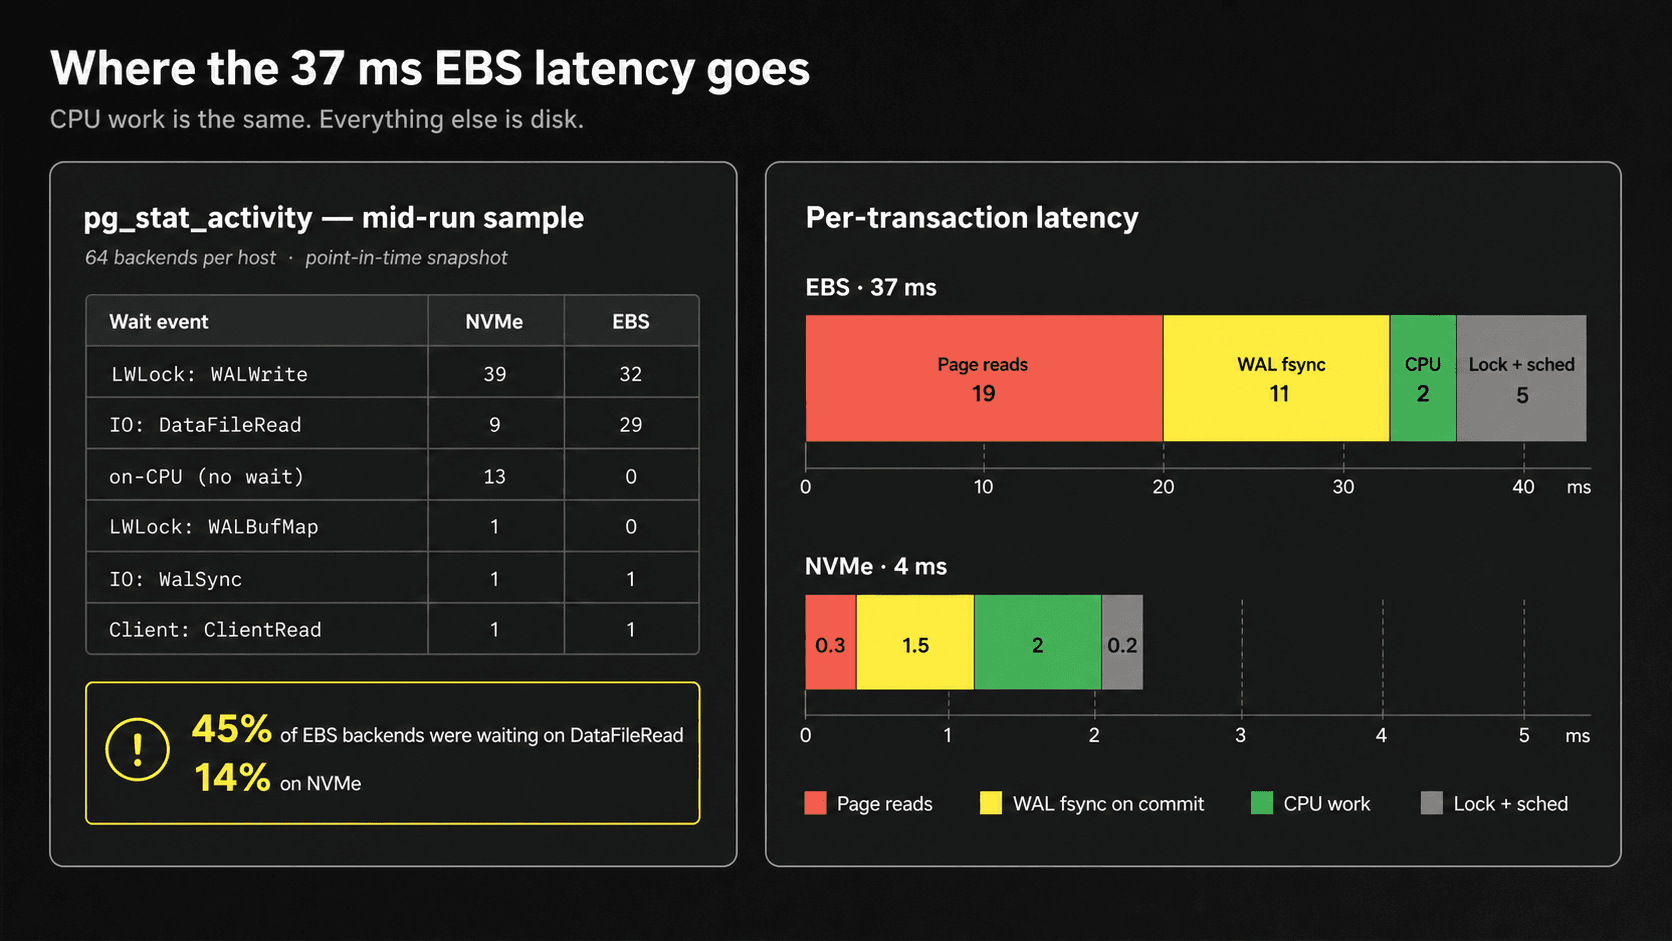 Abbildung: Latenzaufschlüsselung einer Transaktion für EBS und NVMe. Entscheidend ist der gewaltige Unterschied bei Page Read und WAL fsync, während die reine CPU-Rechenzeit auf beiden Systemen nahezu identisch ist. Quelle: ClickHouse (Rückblick auf den POSETTE-2026-Vortrag)
Die Latenzaufschlüsselung verdeutlicht die physikalischen Unterschiede. Bei EBS dauerte das Lesen einer einzelnen Datenseite etwa 19 Millisekunden, auf der lokalen NVMe-SSD hingegen nur 0,3 Millisekunden. Das Schreiben des Transaktionsprotokolls (WAL fsync) schlug mit 11 Millisekunden gegenüber 1,5 Millisekunden zu Buche. Lock-Konflikte und Scheduling-Overhead machten 5 ms gegenüber 0,2 ms aus. Die reine Rechenzeit war jedoch auf beiden Systemen mit rund 2 Millisekunden deckungsgleich. Die zusätzlichen 35 Millisekunden Verzögerung hatten nichts mit komplexer Abfragelogik zu tun – der Prozess verbrachte seine gesamte Zeit mit dem Warten auf Bestätigungen des entfernten Speichers.
Netzwerkgebundener Cloud-Speicher: Durchsatzeinbruch um den Faktor 9
Viele Entwickler betrachten Cloud-Volumes gewohnheitsmäßig als gewöhnliche lokale Laufwerke. In modernen Cloud-Architekturen ist ein Elastic Block Store jedoch ein eigenständiger, verteilter Speicher-Cluster in entfernten Server-Racks. Bei jedem Lese- oder Schreibvorgang müssen die Datenpakete virtuelle Switches, Glasfaserleitungen und Speicher-Controller passieren.
Lokale NVMe-SSDs hingegen sind direkt an den PCIe-Bus des Mainboards angebunden – nur wenige Zentimeter von der CPU entfernt. Sobald parallele Schreibvorgänge die Puffer im Arbeitsspeicher überfordern, entscheidet jede Festplattenadressierung über die Reaktionszeit. Netzwerkbedingte Millisekunden-Latenzen vervielfachen sich bei dichten, zufälligen Lese- und Schreiboperationen zu massiven Verzögerungen.
Dieser Unterschied zeigt sich ebenso drastisch bei Hintergrund-Wartungsarbeiten. Das Bereinigen von 10 GB Tabellen-Bloat per VACUUM dauerte auf der lokalen NVMe 366 Sekunden, auf EBS hingegen 964 Sekunden. Das Abarbeiten eines 10 GB großen Rückstands bei der logischen Replikation benötigte auf der lokalen Disk 139 Sekunden, auf EBS 238 Sekunden. Wenn die Aufräumarbeiten langsamer sind als die Entstehung neuer Datenreste, gerät das Tabellenwachstum außer Kontrolle und beansprucht immer mehr Ressourcen.
Dieser Benchmark beschränkte sich auf die Basiskonfiguration eines gp3-Volumes mit 3.000 IOPS. Zwar lässt sich die Leistung durch teurere, vorkonfigurierte IOPS und höheren Durchsatz verbessern, doch selbst mit unbegrenztem Budget lässt sich die physikalische Netzwerklaufzeit niemals auf das Niveau einer direkten PCIe-Busverbindung drücken.
Wartende Prozesse blockieren das System: 90 Prozent der Rechenleistung verpuffen
Die Prozess-Stichproben während des Benchmarks zeigten einen markanten Kontrast. Auf der EBS-Instanz steckten 29 von 64 Worker-Prozessen im Status I/O-Wait beim Datenlesen fest – fast 45 Prozent aller aktiven Worker. Auf der lokalen SSD warteten hingegen nur 9 Prozesse auf Leseoperationen, was einem Anteil von rund 14 Prozent entspricht.
Das CPU-Profil beider Systeme offenbart das strukturelle Ausmaß der Ressourcenverschwendung. Innerhalb eines 240-Sekunden-Überwachungsfensters verbrauchte der NVMe-Host insgesamt 2.253 CPU-Sekunden – etwa 9,4 Kerne liefen unter Volllast. Der EBS-Host verzeichnete dagegen lediglich 251 CPU-Sekunden, was umgerechnet der Auslastung von gerade einmal einem einzigen Prozessorkern entspricht.
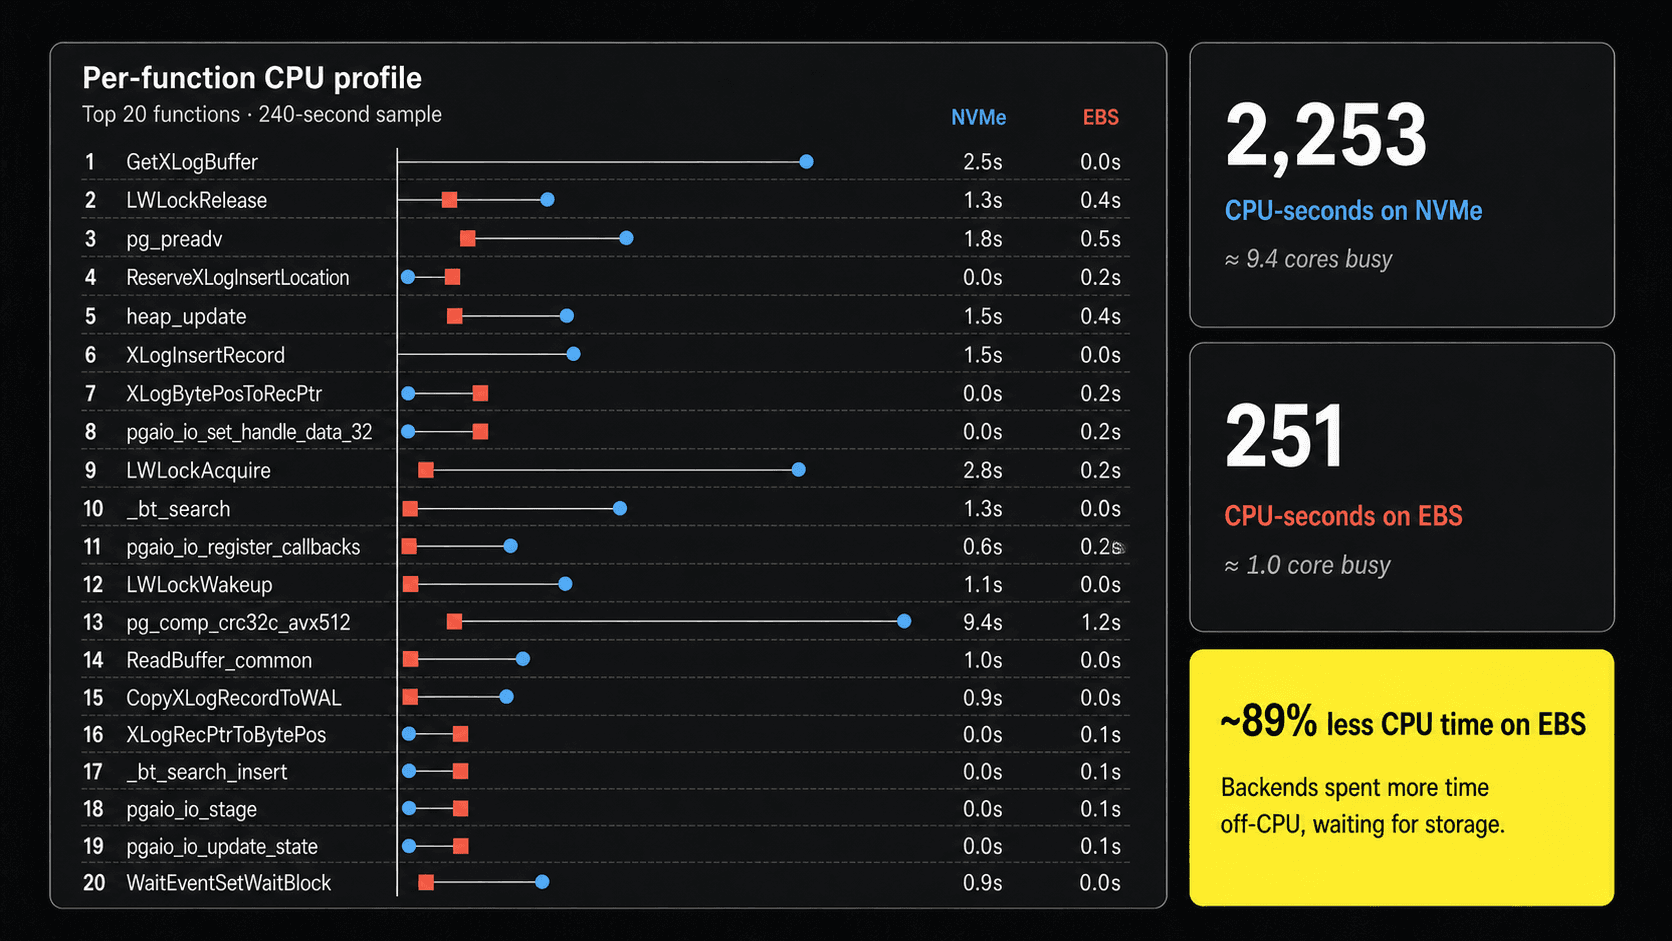 Abbildung: CPU-Ressourcenverbrauch im Vergleich. Der NVMe-Host erreichte kumulierte 2.253 CPU-Sekunden, während der EBS-Host lediglich auf 251 CPU-Sekunden kam – fast die gesamte Zeit verstrich beim Warten auf Speicherantworten. Quelle: ClickHouse (Rückblick auf den POSETTE-2026-Vortrag)
Die Prozesse auf dem EBS-Host verharrten überwiegend im Ruhezustand und warteten schlicht auf die Datenübertragung über das Netzwerk. Neunzig Prozent der Rechenkapazität des Systems liefen völlig leer. Das Team zahlte den vollen Preis für einen 16-Kern-Prozessor, nutzte in der Praxis jedoch nur einen einzigen Kern effektiv aus.
Dies verdeutlicht eine verbreitete Fehlinterpretation im Systembetrieb: Eine niedrige CPU-Auslastung wirkt auf den ersten Blick beruhigend und suggeriert Reserven. In Wahrheit wird das Gesamtsystem jedoch längst durch die entfernten Speicherleitungen erdrosselt.
Umstieg auf lokale Laufwerke: Disaster Recovery in eigener Regie
So verlockend der Geschwindigkeitsgewinn auch ist: Der Einsatz lokaler Laufwerke in Produktivumgebungen birgt erhebliche Risiken. Die Lebensdauer flüchtiger Instanz-Speicher ist strikt an den physischen Host gekoppelt. Wird der zugrundeliegende Server stromlos geschaltet oder heruntergefahren, sind die Daten auf der lokalen SSD unwiederbringlich verloren.
Cloud-Volumes reagieren zwar langsamer, dafür bieten Cloud-Anbieter integrierte Multi-Replika-Redundanz und automatisierte Snapshots. Fällt eine virtuelle Maschine aus, kann das EBS-Volume innerhalb von Minuten an einen neuen Knoten gehängt werden. Der Wechsel zu lokalen NVMe-Laufwerken bedeutet, dass das Betriebsteam Hochverfügbarkeit (HA) und Notfallwiederherstellung (Disaster Recovery) komplett selbst stemmen muss. Der Leistungsgewinn ist real – die operative Verantwortung jedoch ebenso.
Für den produktiven Einsatz lokaler NVMe-Laufwerke sind drei robuste Verteidigungslinien unerlässlich:
- Synchrone zonenübergreifende Replikation: Einrichtung von zwei Standby-Knoten mit einem Quorum-Mechanismus wie
ANY 1 (standby1, standby2). Sobald einer der Standby-Knoten den Schreibvorgang im WAL bestätigt hat, gilt die Transaktion als übermittelt – das balanciert geringe Latenz und Ausfallsicherheit optimal aus. - Kontinuierliche Backups und Point-in-Time-Recovery (PITR): Einsatz von Werkzeugen wie WAL-G, um Basis-Backups und WAL-Segmente kontinuierlich in einen Objektspeicher zu archivieren. Dies drückt das Recovery Point Objective (RPO) in den Sekundenbereich und ermöglicht die Wiederherstellung zu beliebigen Zeitpunkten.
- Vorausschauende Kapazitätsplanung: Die Kapazität lokaler NVMe-Laufwerke ist durch die Hardware-Spezifikation der gewählten Instanzgröße festgelegt und lässt sich nicht per Schieberegler im laufenden Betrieb vergrößern. Ausreichende Reserven müssen von vornherein einkalkuliert werden.
Maximale Performance verlangt, dass Daten so nah wie möglich an der CPU liegen; maximale Zuverlässigkeit erfordert, dass Sicherungen so weit wie möglich von der eigentlichen Maschine isoliert aufbewahrt werden. Diese scheinbar widersprüchlichen Anforderungen müssen von der Systemarchitektur selbst gelöst werden.
Die Netzwerkschicht eliminieren: Neubewertung von Performance und Betrieb
Die Ergebnisse von ClickHouse lösten in der Entwickler-Community rege Diskussionen aus. Einige Ingenieure äußerten Skepsis und wandten ein, dass ClickHouse als analytische Datenbank ein Eigeninteresse daran haben könnte, Latenzprobleme auf die Speicherschicht abzuwälzen.
Zahlreiche Datenbank-Praktiker stützten die Erkenntnisse jedoch mit eigenen Messergebnissen. Teams, die ihre Postgres-Instanzen auf Instanzen mit lokalen NVMe-SSDs umgestellt hatten, berichteten von einem Rückgang der durchschnittlichen I/O-Latenz von 1,0 ms auf 0,1 ms, was insbesondere Reporting-Abfragen dramatisch beschleunigte. Andere betonten, dass netzwerkgebundener Blockspeicher im Zeitalter rotierender Magnetspeicher wirtschaftlich sinnvoll war – in der Ära moderner Flash-Speicher jedoch die Netzwerk-Abstraktionsschicht fast das Zehnfache des potenziellen Durchsatzes vernichtet.
Hinzu kommt, dass Cloud-Snapshots in der Praxis häufig an den Lebenszyklus der jeweiligen Instanz gekoppelt sind: Wird eine Instanz versehentlich gelöscht, können auch ungesicherte Snapshots verloren gehen. Viele Organisationen betreiben ohnehin separate Backup-Pipelines. Die angenommene Auslagerung der Ausfallsicherheit an den Cloud-Anbieter entpuppt sich oft als unvollständige Scheinlösung.
Wenn ein Datenbanksystem stockt, ist die Ursache häufig das Netzwerkkabel zwischen den Serverschränken. Der Umstieg auf lokale NVMe-Laufwerke holt das Vielfache an Durchsatz zurück, das moderne Hardware physikalisch leisten kann. Doch umsonst gibt es nichts: Wer die volle Performance will, muss die Bürde der Notfallwiederherstellung selbst tragen.
Weiterführende Links:
- Offizieller ClickHouse-Technikblog (Zusammenfassung des POSETTE-2026-Vortrags)
- POSETTE-2026-Vortrag „Postgres Isn’t Slow. Your Storage Is.“
- Diskussionsthread auf Hacker News