Prenez une même base de données de 3,3 milliards de lignes soumise à une charge intense d’écritures aléatoires concurrentes : remplacez le disque cloud réseau sous-jacent par un disque NVMe local directement intégré au châssis, et la vitesse de traitement s’envole instantanément d’un facteur 9,24.
Lorsqu’une base de données de production ralentit, le réflexe des équipes d’ingénierie consiste généralement à traquer les requêtes lentes, ajouter des index ou augmenter la mémoire vive. Lors de la conférence communautaire Postgres POSETTE 2026, des ingénieurs ont disséqué le temps passé sur une transaction unique. Sur 36,9 millisecondes de latence totale, le processeur n’a passé que 2 millisecondes à effectuer de véritables calculs. Pendant les 35 millisecondes restantes, le système est resté totalement immobile à attendre que les données arrivent à travers le câble réseau.
Le goulet d’étranglement qui paralysait le système ne venait absolument pas de la puissance de calcul. Le véritable coupable était ce disque cloud distant, raccordé par des liaisons réseau dans une baie de serveurs éloignée.
Autopsie de 37 ms de latence : le calcul pur n’occupe que 2 ms
Dès que les volumes de données explosent, les bases de données en production développent un syndrome bien connu de complications liées à la concurrence : les écritures glissent de la seconde à la minute, les temps de lecture sautent de quelques millisecondes à plusieurs secondes, le nettoyage en arrière-plan (autovacuum) ne parvient plus à endiguer le gonflement des tables (bloat), les écritures de checkpoints entrent en concurrence frontale avec les transactions applicatives et les flux de réplication accumulent un retard critique.
Afin d’en isoler la cause première, l’équipe de ClickHouse a monté huit clusters de bases de données rigoureusement identiques sur des instances AWS m6id.4xlarge. Chaque machine disposait de 16 vCPU, de 64 Go de RAM et de 16 Go de shared_buffers. La seule et unique variable résidait dans la couche de stockage : quatre clusters utilisaient des volumes EBS gp3 standards provisionnés à 3 000 IOPS, tandis que les quatre autres s’exécutaient directement sur les SSD NVMe locaux intégrés à l’hôte physique.
Le jeu d’essai reposait sur une table massive de 3,3 milliards de lignes pesant 482 Go. 64 clients concurrents et 16 threads de travail ont soumis le système à des vagues continues de requêtes UPDATE aléatoires pendant 5 minutes. Les clusters sur disques locaux ont atteint 16 030 transactions par seconde (TPS), contre seulement 1 734 TPS pour les clusters sur volumes EBS. La latence médiane a chuté de 36,9 millisecondes à 4,0 millisecondes, creusant un écart de débit de 9,24 fois.
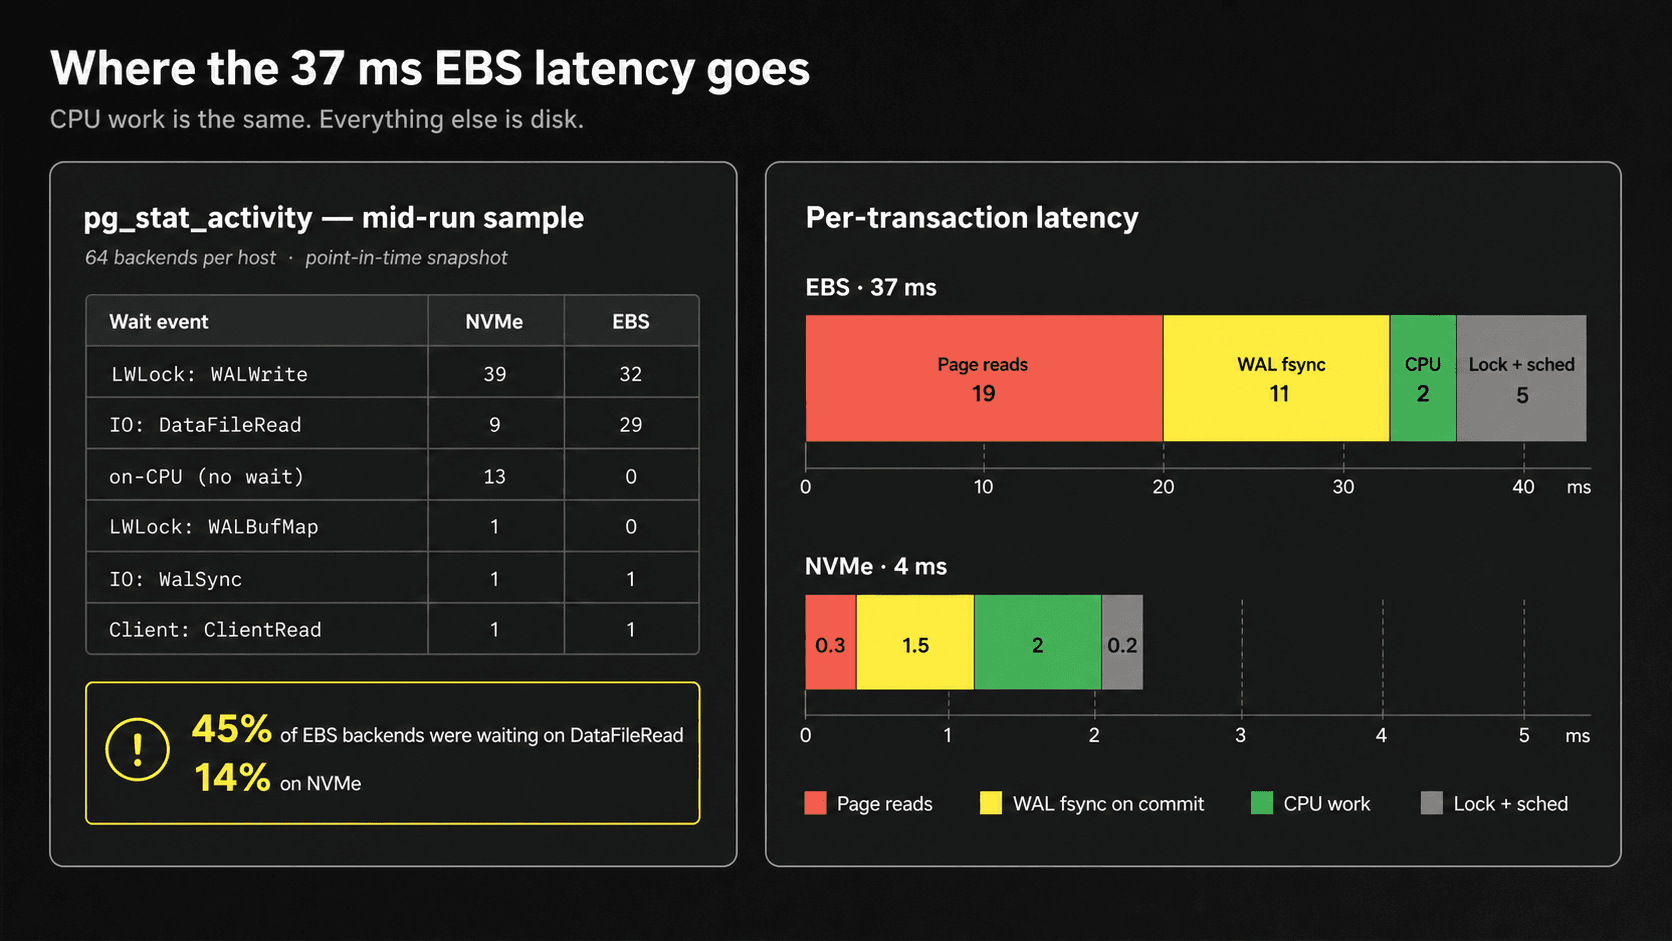 Figure : Décomposition de la latence par transaction entre EBS et NVMe. Remarquez l’écart spectaculaire sur la lecture de pages (page read) et la persistance du journal (WAL fsync), tandis que le temps de calcul CPU demeure quasiment identique. Source : ClickHouse (bilan de la conférence POSETTE 2026)
Ce graphique de latence met à nu la distance physique séparant les deux approches. Sur EBS, la lecture d’une seule page de données a requis environ 19 millisecondes, contre à peine 0,3 milliseconde sur NVMe local. La validation de l’écriture du journal (WAL fsync) a demandé 11 millisecondes contre 1,5 milliseconde. Les conflits de verrous et la planification ont pesé 5 ms contre 0,2 ms. En revanche, le temps de calcul CPU effectif était strictement identique sur les deux environnements, aux alentours de 2 millisecondes. Les 35 millisecondes de délai supplémentaire n’avaient aucun lien avec la complexité des requêtes ; le processus a passé la quasi-totalité de son existence à attendre les accusés de réception du stockage distant.
Disques cloud à travers le réseau : le débit s’effondre de 90 %
Nombre d’ingénieurs considèrent encore machinalement les disques cloud comme de simples périphériques locaux. Pourtant, dans les architectures cloud actuelles, un stockage par blocs comme EBS constitue un cluster de stockage distribué autonome, situé dans des baies réseau distantes. À chaque lecture ou écriture, les paquets doivent transiter par des commutateurs virtuels, des fibres optiques et des contrôleurs de stockage distants.
À l’inverse, un SSD NVMe local est directement branché sur le bus PCIe de la carte mère, à quelques centimètres seulement du processeur. Dès que les écritures massives saturent la mémoire tampon, chaque accès disque met à l’épreuve le temps de réponse brut des entrées/sorties. Les millisecondes introduites par les sauts réseau se retrouvent démultipliées des milliers de fois lors d’accès aléatoires intensifs.
Ce fossé est tout aussi criant pour les tâches de maintenance en arrière-plan. Nettoyer 10 Go de résidus de tables (bloat) via vacuum a pris 366 secondes sur le disque local, contre 964 secondes sur EBS. Évacuer un retard de 10 Go dans la réplication logique a nécessité 139 secondes sur SSD local contre 238 secondes sur le volume distant. Dès lors que le rythme de nettoyage ne parvient plus à devancer la création de déchets, la taille des tables enfle de manière incontrôlée et confisque toujours plus de ressources.
Ce test comparatif s’est limité à la configuration de base gp3 à 3 000 IOPS. Payer un supplément pour obtenir des IOPS et un débit pré-provisionnés améliore certes les résultats, mais aucune facture ne permettra jamais de ramener le temps d’aller-retour réseau à la vitesse de transfert d’un bus PCIe sur carte mère.
Des processus figés dans l’attente : 90 % de la puissance CPU tourne à vide
L’échantillonnage de l’état des processus pendant l’épreuve a mis en lumière un contraste saisissant. Sur l’instance EBS, 29 des 64 processus de travail étaient bloqués en attente d’I/O lors de la lecture de données, soit près de 45 % des workers actifs. Sur le disque SSD local, seuls 9 processus attendaient des lectures, représentant environ 14 %.
Le profilage des deux processeurs révèle l’ampleur du gaspillage structurel. Sur une fenêtre d’observation de 240 secondes, l’hôte en NVMe local a cumulé 2 253 secondes de CPU, maintenant environ 9,4 cœurs à plein régime. À l’opposé, l’hôte sur EBS n’a totalisé que 251 secondes de CPU, ce qui équivaut en pratique à l’activité d’un seul cœur sur l’ensemble du test.
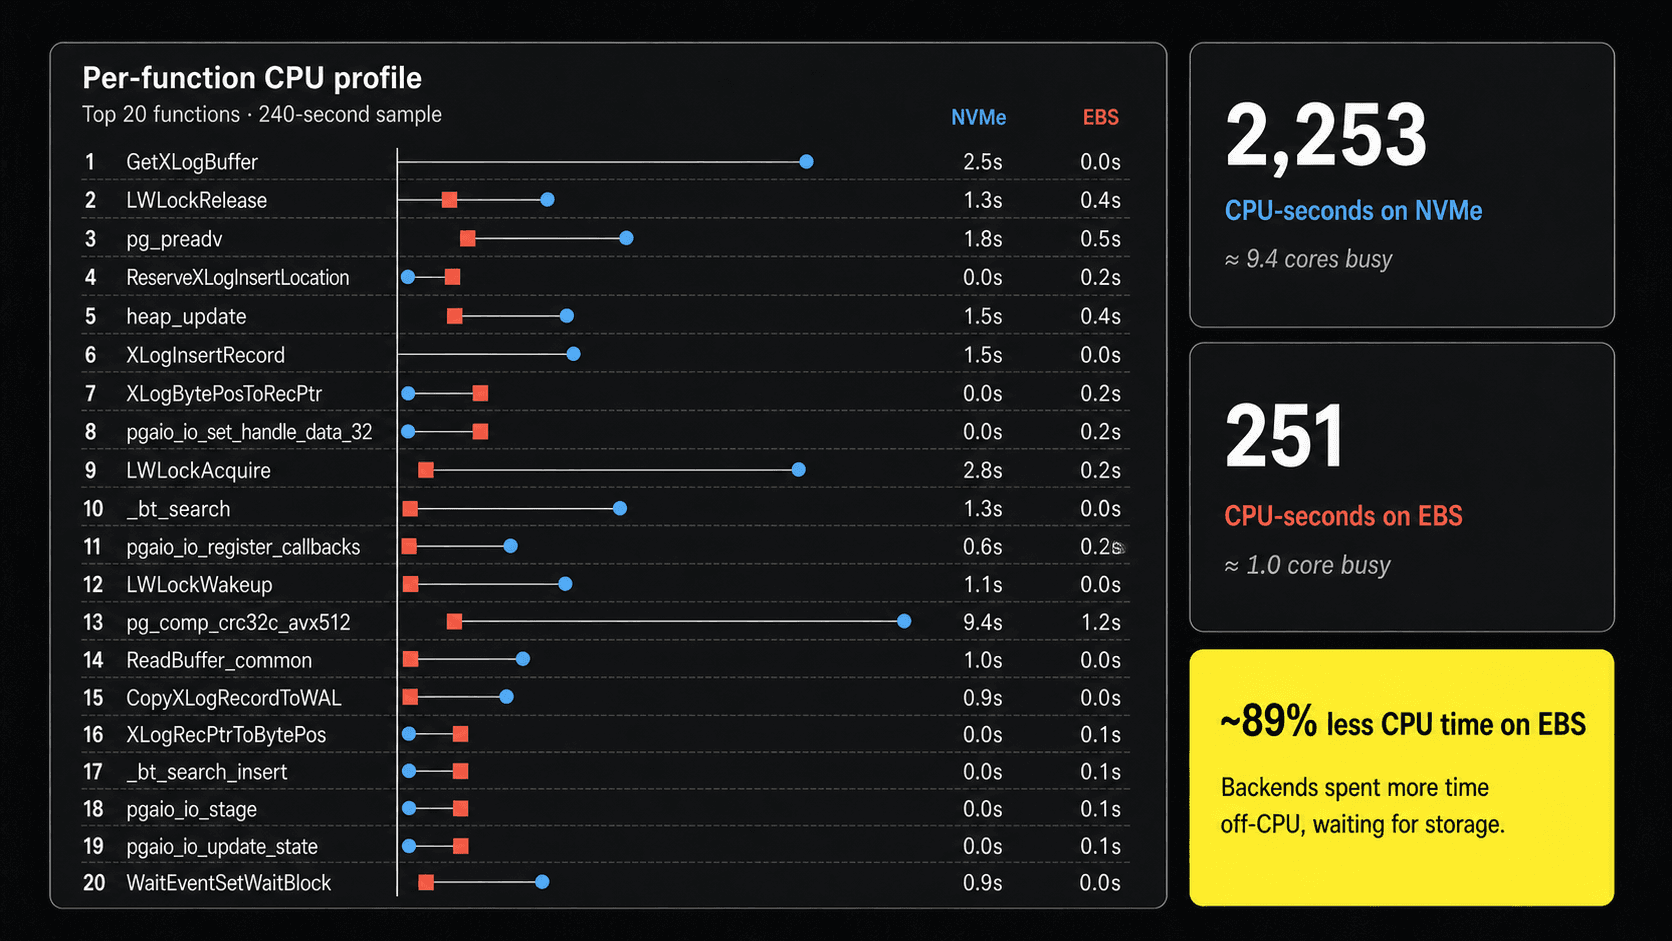 Figure : Comparatif de la consommation de ressources CPU. L’hôte NVMe a enregistré 2 253 secondes de CPU, contre seulement 251 secondes pour l’hôte EBS, le temps étant massivement englouti par l’attente des réponses de stockage. Source : ClickHouse (bilan de la conférence POSETTE 2026)
Les processus sur la machine EBS ont passé le plus clair de leur temps suspendus, à attendre que les paquets de données franchissent le réseau. Neuf dixièmes de la puissance de calcul du système ont tourné totalement à vide. L’équipe a payé le prix fort pour un processeur à 16 cœurs, mais n’en a véritablement exploité qu’un seul.
Cela met en évidence un piège classique de l’exploitation système : une faible charge CPU est souvent interprétée à tort comme le signe d’un serveur serein et sous-utilisé. En réalité, le système est simplement asphyxié par les lignes de transmission du stockage distant.
Passer au disque local : assumer soi-même la reprise après sinistre
Si le gain de vitesse est spectaculaire, adopter des disques locaux en production comporte une part de risque non négligeable. La durée de vie d’un stockage d’instance éphémère est strictement inféodée à celle du serveur physique sous-jacent. En cas de coupure de courant ou d’arrêt de la machine matérielle, les données stockées sur le disque local disparaissent purement et simplement.
Les volumes cloud sont certes plus lents, mais les fournisseurs intègrent d’emblée la redondance multiréplicas et les sauvegardes par snapshots. En cas de défaillance d’une VM, le volume EBS peut être détaché et rattaché à un nouveau nœud sain en quelques minutes. Basculer vers des SSD NVMe locaux oblige l’équipe d’exploitation à porter intégralement la haute disponibilité (HA) et la reprise après sinistre (DR). Le bond en avant des performances est bien réel, mais la responsabilité opérationnelle l’est tout autant.
Pour pérenniser l’usage de disques locaux en environnement de production, trois lignes de défense doivent être érigées :
- Réplication synchrone multi-zones de disponibilité (AZ) : Déployer deux réplicas secondaires avec un mécanisme de quorum de type
ANY 1 (standby1, standby2). Dès que l’un des deux réplicas confirme l’écriture du journal WAL, la transaction est validée, garantissant un équilibre idéal entre latence minimale et tolérance aux pannes. - Sauvegardes continues et restauration à un instant précis (PITR) : Utiliser des outils comme WAL-G pour archiver en continu les sauvegardes de base et les journaux WAL vers un stockage objet (comme S3). Cela réduit l’objectif de point de reprise (RPO) à quelques secondes et autorise la restauration à n’importe quel point dans le temps.
- Planification rigoureuse de la capacité : Le volume d’un disque local dépend des spécifications matérielles de l’instance retenue et ne peut pas être augmenté à chaud d’un simple clic. Il est indispensable d’anticiper la croissance des données et de prévoir une marge de manœuvre substantielle dès le départ.
La performance exige de placer les données au plus près du processeur ; la fiabilité impose d’isoler les sauvegardes le plus loin possible de la machine physique. Cette apparente contradiction d’ingénierie doit être résolue par la conception architecturale elle-même.
Supprimer la couche réseau : recalculer performance et exploitation
Ces bancs d’essai ont déclenché un débat passionné au sein de la communauté des développeurs. Certains ingénieurs sont restés prudents, rappelant que ClickHouse étant un produit d’analyse décisionnelle, l’entreprise pouvait avoir intérêt à détourner l’attention vers les goulets d’étranglement de stockage.
Néanmoins, les ingénieurs de bases de données de terrain ont apporté de nombreux témoignages concordants. Des équipes ayant migré leurs instances Postgres vers des machines équipées de SSD NVMe locaux ont rapporté une chute de leur latence d’I/O moyenne de 1,0 ms à 0,1 ms, accélérant spectaculairement leurs requêtes de reporting. D’autres ont souligné que si le stockage bloc en réseau était très avantageux à l’époque des disques magnétiques rotatifs, à l’ère de la mémoire flash moderne, la couche d’abstraction réseau ampute gratuitement près de dix fois le débit potentiel.
En outre, dans l’exploitation quotidienne, les snapshots de volumes cloud sont souvent tributaires du cycle de vie de l’instance : la suppression accidentelle d’une machine peut entraîner la perte des instantanés non dissociés. La plupart des organisations doivent de toute façon maintenir leur propre chaîne de sauvegarde indépendante. Croire que l’on délègue entièrement la fiabilité au fournisseur de cloud n’est souvent, dans les faits, qu’une délégation en demi-teinte.
Quand un système de base de données s’essouffle, le responsable est très souvent ce câble réseau qui serpente entre les baies de serveurs. Passer au NVMe local permet de reconquérir le débit décuplé dont le matériel actuel est capable. Mais il n’y a pas de repas gratuit : si vous empochez les gains de vitesse, le fardeau de la reprise après sinistre revient intégralement sur vos propres épaules.
Liens de référence :
- Blog technique officiel de ClickHouse (bilan de la conférence POSETTE 2026)
- Conférence POSETTE 2026 : « Postgres Isn’t Slow. Your Storage Is. »
- Fil de discussion communautaire sur Hacker News