La misma base de datos con 3.300 millones de filas, sometida a una carga idéntica de escrituras aleatorias concurrentes: cambiar el disco en la nube por unidades de estado sólido locales en el chasis dispara la velocidad de procesamiento 9,24 veces al instante.
Cuando una base de datos en producción pierde agilidad, la reacción instintiva de los equipos de ingeniería consiste en auditar consultas lentas, añadir índices o ampliar la memoria RAM. En la conferencia de la comunidad Postgres POSETTE 2026, varios ingenieros desglosaron el tiempo invertido en una única transacción. De una latencia total de 36,9 milisegundos, la CPU dedicó apenas 2 milisegundos al cálculo real. Durante los 35 milisegundos restantes, el proceso estuvo completamente parado esperando a que el disco enviara los datos a través del cable de red.
El cuello de botella no radicaba en la capacidad de cómputo. El culpable residía en el volumen de almacenamiento conectado en red en una sala de servidores lejana.
37 milisegundos de latencia bajo la lupa: el cómputo solo requiere 2 ms
A medida que el volumen de datos se multiplica, las bases de datos en producción suelen presentar una serie de dolencias de concurrencia bien conocidas: los tiempos de escritura pasan de segundos a minutos, las lecturas saltan de milisegundos a segundos enteros, el autovacuum no consigue contener la hinchazón (bloat) de las tablas, las escrituras de checkpoints compiten con las transacciones de negocio y las colas de replicación acumulan retrasos masivos.
Para aislar el origen del problema, el equipo de ClickHouse desplegó ocho clústeres de bases de datos idénticos sobre instancias AWS m6id.4xlarge. Las máquinas disponían de 16 vCPU, 64 GB de memoria y 16 GB de shared_buffers. La única variable fue la capa de almacenamiento: cuatro clústeres montaban volúmenes gp3 (EBS) estándar con 3.000 IOPS aprovisionadas, mientras que los otros cuatro operaban directamente sobre unidades SSD NVMe locales integradas en el propio host físico.
El banco de pruebas utilizó una tabla colosal de 3.300 millones de filas y 482 GB de volumen. 64 clientes concurrentes y 16 hilos de trabajo ejecutaron actualizaciones aleatorias continuas durante 5 minutos. El clúster con discos locales alcanzó 16.030 transacciones por segundo (TPS), frente a solo 1.734 TPS del clúster con EBS. La latencia mediana se redujo de 36,9 milisegundos a 4,0 milisegundos: una brecha de rendimiento de 9,24 veces.
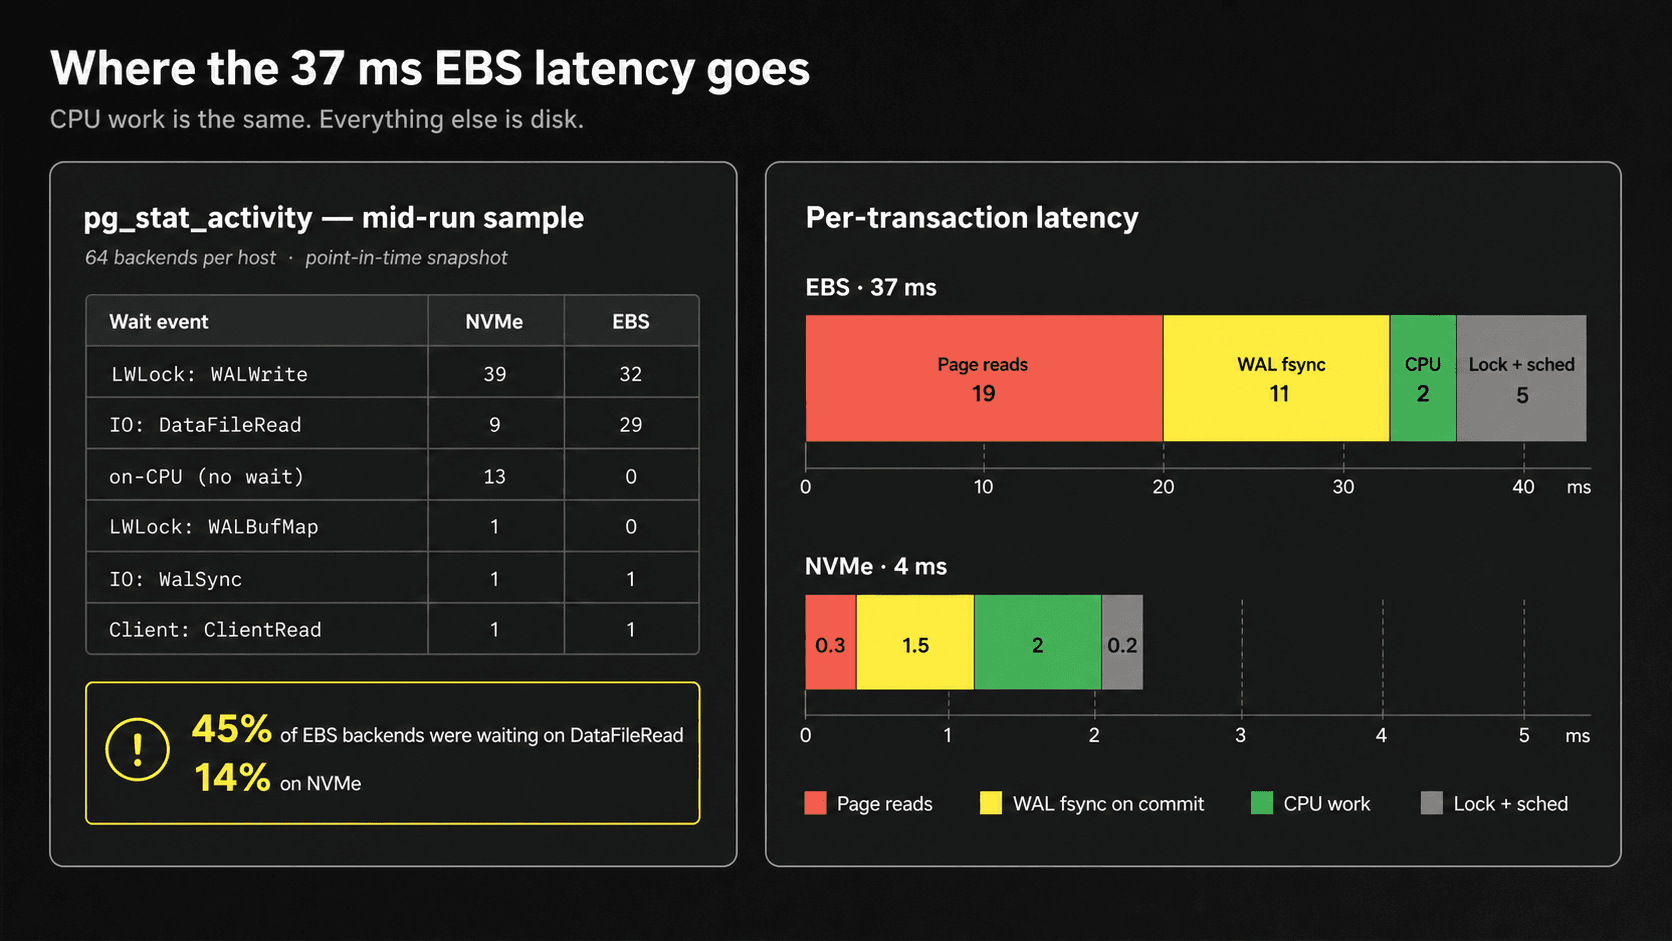 Figura: Desglose de la latencia por transacción entre EBS y NVMe. Destaca la enorme disparidad en lectura de páginas (page read) y persistencia del WAL (WAL fsync), mientras que el tiempo de cálculo de la CPU resulta prácticamente idéntico. Fuente: ClickHouse (resumen de la ponencia en POSETTE 2026)
El desglose de la latencia saca a la luz la distancia física entre ambas soluciones. En EBS, una sola lectura de página requirió unos 19 milisegundos, frente a apenas 0,3 milisegundos en el NVMe local. La confirmación de escritura del log (WAL fsync) tomó 11 milisegundos frente a 1,5 milisegundos. La contención de bloqueos y la sobrecarga del planificador consumieron 5 ms frente a 0,2 ms. En cambio, el tiempo de procesamiento real fue calcado en ambos casos: en torno a 2 milisegundos. Los 35 milisegundos adicionales de retraso no tuvieron relación alguna con la lógica de las consultas; el proceso se pasó el ciclo entero esperando confirmaciones del almacenamiento remoto.
Discos en la nube a través de la red: el rendimiento se desploma un 90%
Muchos desarrolladores tratan los volúmenes en la nube como si fuesen discos locales corrientes. Sin embargo, en las arquitecturas cloud modernas, el almacenamiento en bloques elástico (como EBS) constituye un clúster de almacenamiento distribuido e independiente, alojado en bastidores distantes. Cada lectura o escritura obliga a los paquetes de datos a cruzar switches virtuales, enlaces de fibra óptica y controladores de almacenamiento remotos.
En cambio, las unidades SSD NVMe locales van conectadas de forma directa al bus PCIe de la placa base, a escasos centímetros del procesador. Cuando las escrituras masivas saturan la caché de memoria, cada acceso a disco pone a prueba la latencia de entrada y salida. El retardo de milisegundos derivado de la red se multiplica de forma exponencial en entornos de lectura y escritura aleatoria intensiva.
Este abismo resulta igualmente evidente en las tareas de mantenimiento en segundo plano. Limpiar 10 GB de datos muertos (bloat) mediante vacuum requirió 366 segundos en el disco local frente a 964 segundos en EBS. Vaciar un retraso de 10 GB en la replicación lógica tomó 139 segundos en NVMe local comparado con 238 segundos en el volumen remoto. Si las tareas de limpieza no logran superar el ritmo al que se genera la basura, el tamaño de las tablas se desborda y monopoliza aún más recursos.
Esta prueba comparativa evaluó volúmenes gp3 estándar con 3.000 IOPS. Aunque contratar mayor rendimiento y pagar extras mitiga parte de la lentitud, ninguna inversión económica permite acortar la ida y vuelta a través de la red hasta equipararla al bus PCIe integrado en la placa madre.
Procesadores ociosos por la espera: el 90% del cómputo gira en vacío
El muestreo del estado de los procesos durante la prueba mostró un contraste rotundo. En la instancia con EBS, 29 de los 64 procesos de trabajo se encontraban bloqueados en espera de I/O al leer datos: casi un 45% del total. En el host con NVMe local, tan solo 9 procesos permanecían a la espera de lectura, representando cerca del 14%.
El perfil de uso de CPU en ambas máquinas refleja la magnitud del desperdicio estructural. En una ventana de monitorización de 240 segundos, el host con NVMe local consumió un acumulado de 2.253 segundos de CPU, manteniendo unos 9,4 núcleos trabajando al máximo. Por contra, el host con EBS registró solo 251 segundos de CPU, lo que equivale en la práctica a un único núcleo en actividad constante.
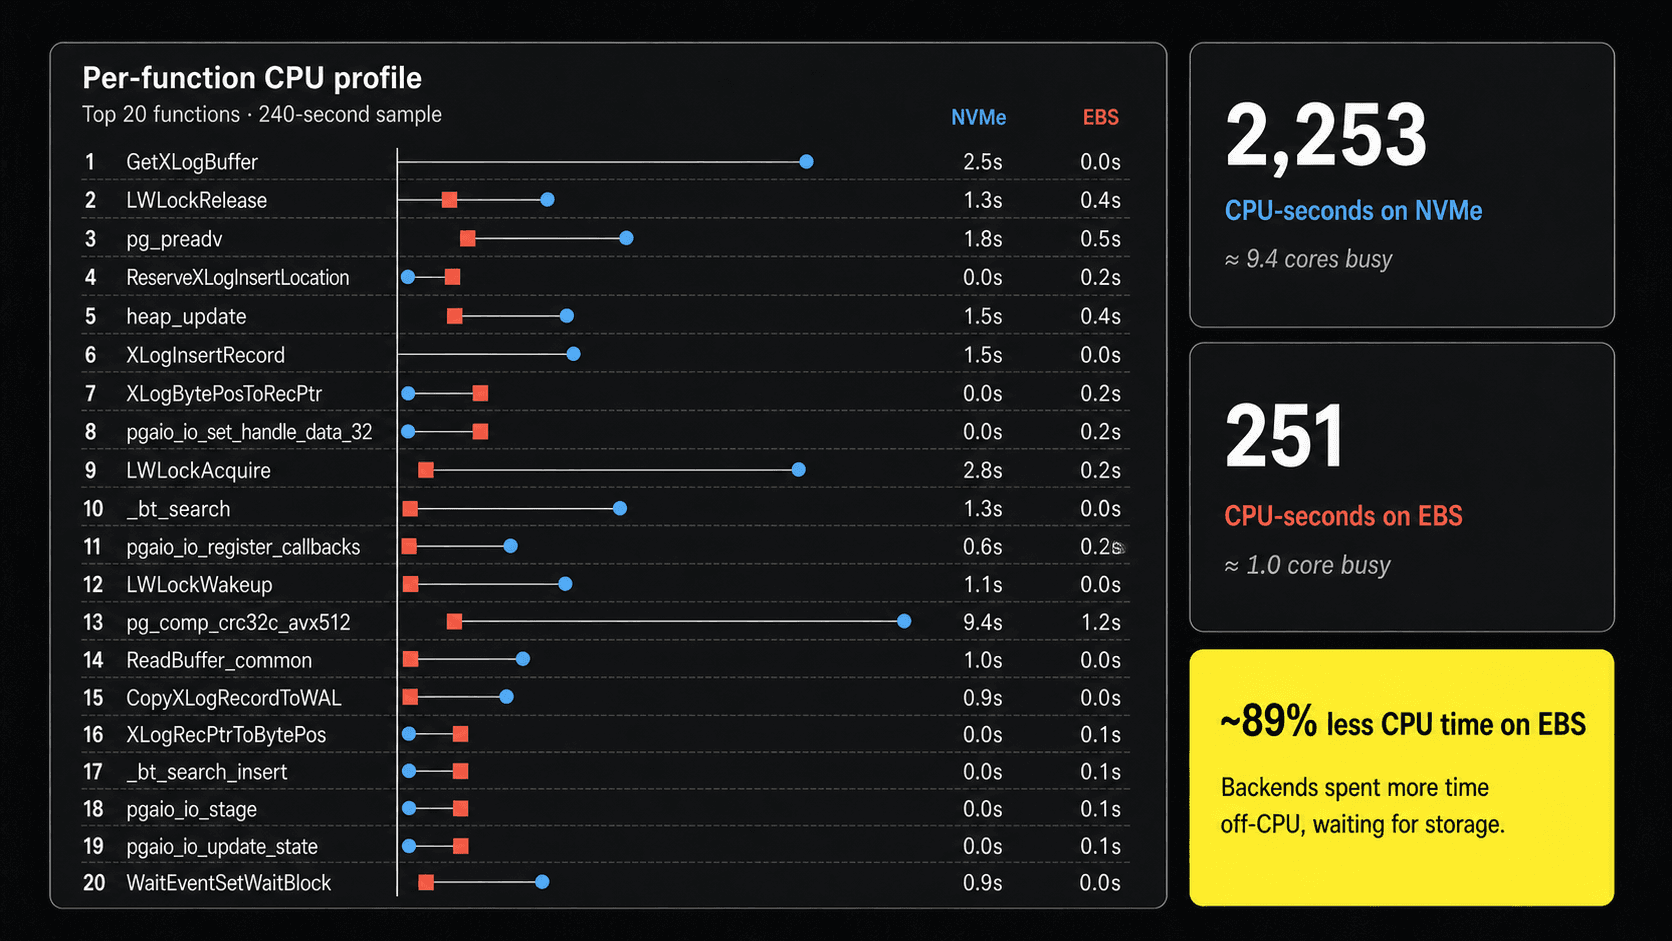 Figura: Comparativa de consumo de recursos de CPU. El host NVMe sumó 2.253 segundos de CPU frente a solo 251 segundos en el host EBS, consumiéndose casi todo el tiempo en esperar respuestas del almacenamiento. Fuente: ClickHouse (resumen de la ponencia en POSETTE 2026)
Los procesos del servidor con EBS pasaron la mayor parte de su ciclo suspendidos, aguardando la llegada de paquetes de datos a través del cable. El 90% de la capacidad de cálculo del sistema se consumió en un estado de inactividad improductiva. El equipo pagó la tarifa completa por un procesador de 16 núcleos, pero en realidad solo aprovechó uno.
Esto pone de manifiesto un error de apreciación frecuente en las operaciones de sistemas: una baja utilización de la CPU suele interpretarse como síntoma de un sistema desahogado. En realidad, el cuello de botella ya ha asfixiado el sistema desde las líneas de transmisión del almacenamiento remoto.
Migrar a discos locales: la recuperación ante desastres queda en tus manos
Aunque la ganancia en velocidad es espectacular, desplegar discos locales en producción no está exento de riesgos considerables. El ciclo de vida de los discos locales temporales (instance store) queda ligado de forma estricta al del servidor físico. Si el hardware subyacente sufre un corte eléctrico o se apaga, los datos alojados en el almacenamiento local se pierden definitivamente.
Los volúmenes EBS responden con mayor lentitud, pero los proveedores de la nube incluyen redundancia multirréplica y copias instantáneas (snapshots) automáticas de serie. Si una máquina virtual falla, el volumen EBS puede desacoplarse y reengancharse a un nodo sano en cuestión de minutos. Adoptar NVMe locales exige que el equipo de operaciones asuma directamente la responsabilidad de la alta disponibilidad y la recuperación ante desastres. La ganancia de rendimiento es indiscutible, pero la carga operativa también lo es.
Llevar discos locales a entornos de producción requiere consolidar tres líneas de defensa:
- Replicación síncrona entre zonas de disponibilidad (AZ): Configurar dos réplicas en espera mediante mecanismos de cuórum como
ANY 1 (standby1, standby2). Basta con que cualquiera de las réplicas confirme la persistencia del WAL para dar por confirmada la transacción, conciliando baja latencia y tolerancia a fallos. - Copias de seguridad continuas y recuperación puntual (PITR): Emplear herramientas como WAL-G para archivar copias base y registros del WAL en almacenamiento de objetos (como S3). Esto reduce el Objetivo de Punto de Recuperación (RPO) a segundos y permite restaurar la base de datos a cualquier instante específico.
- Planificación rigurosa de la capacidad: El espacio de los discos locales depende de las especificaciones de la instancia contratada y no puede ampliarse en caliente con un clic. Es imprescindible proyectar el crecimiento y reservar margen suficiente desde el principio.
La velocidad exige acercar los datos lo máximo posible a la CPU; la fiabilidad exige aislar las copias de seguridad lo más lejos posible de la máquina física. Estas dos exigencias aparentemente contradictorias deben conciliarse dentro del propio diseño arquitectónico.
Eliminar la capa de red: reconsiderar rendimiento frente a mantenimiento
Las conclusiones presentadas por ClickHouse suscitaron un debate intenso en la comunidad de desarrollo. Algunos ingenieros mostraron reservas, señalando que al tratarse ClickHouse de un motor analítico, podría tener interés en desviar la atención hacia los cuellos de botella del almacenamiento.
No obstante, ingenieros de bases de datos en primera línea aportaron abundantes mediciones que respaldan el estudio. Varios equipos que migraron instancias Postgres en la nube a máquinas con NVMe locales informaron de caídas en la latencia media de I/O de 1,0 ms a 0,1 ms, agilizando de manera drástica las consultas analíticas y de informes. Otros recalcaron que, si bien el almacenamiento en bloque en red tenía sentido en la época de los discos magnéticos, en la era de las memorias flash la capa de abstracción de red arrebata gratuitamente casi diez veces el rendimiento potencial.
Además, en la práctica operativa real, los snapshots de los volúmenes cloud suelen quedar enlazados al ciclo de vida de la instancia: si se elimina una máquina por error, los snapshots no desvinculados también pueden perderse. Muchas organizaciones ya se ven obligadas a mantener sus propios sistemas de copia de seguridad independientes. Confiar a ciegas la fiabilidad al proveedor de la nube acaba siendo, la mayoría de las veces, una externalización a medias.
Cuando una base de datos se ralentiza, el culpable suele ser el cable de red tendido entre racks. Adoptar NVMe locales permite liberar la potencia real del hardware actual. Pero no hay atajos: si te quedas con el rendimiento, te toca cargar con la responsabilidad de la recuperación ante desastres.
Enlaces de referencia:
- Blog técnico oficial de ClickHouse (resumen de la conferencia POSETTE 2026)
- Ponencia de POSETTE 2026: «Postgres Isn’t Slow. Your Storage Is.»
- Hilo de debate en Hacker News