同样一份 33 亿行数据的数据库,同样跑满高并发随机写入。把底层的云硬盘换成机箱本地硬盘,处理速度瞬间提升 9.24 倍。
线上数据库一旦变慢,团队习惯先查慢查询、加索引或扩充内存。在 2026 年的 Postgres 社区会议 POSETTE 上,工程师拆解了单笔事务耗时。在 36.9 毫秒的总延迟中,处理器真正执行计算的时间只有 2 毫秒。其余整整 35 毫秒,全都在干等硬盘把数据送过来。
拖慢系统的瓶颈不在算力。问题出在远端机房那块隔着网线连接的云硬盘上。
37 毫秒延迟拆开看,计算只占 2 毫秒
数据规模一旦膨胀,线上数据库往往会出现一系列并发综合征。写入耗时从秒级拖到分钟级。读延迟从毫秒跳到秒级。后台清理赶不上表膨胀速度。检查点写入与业务争抢资源。复制管道也越积越厚。
为了找出根源,ClickHouse 团队搭建了 8 个配置一致的数据库集群。测试机型选用亚马逊云 m6id.4xlarge。整机配备 16 个核心、64 GB 内存与 16 GB 共享缓冲区。唯一的变量在存储层。4 个集群挂载预置 3000 IOPS 的基准 gp3 云硬盘。另外 4 个集群直接使用宿主机内置的本地固态硬盘。
压测数据集是一张包含 33 亿行数据、体积达 482 GB 的巨型数据表。测试由 64 个客户端与 16 个工作线程发起。系统持续 5 分钟执行密集随机更新。本地硬盘集群跑出每秒 16,030 笔事务,云硬盘集群只有 1,734 笔。中位延迟从 36.9 毫秒压缩到 4.0 毫秒。两者吞吐相差 9.24 倍。
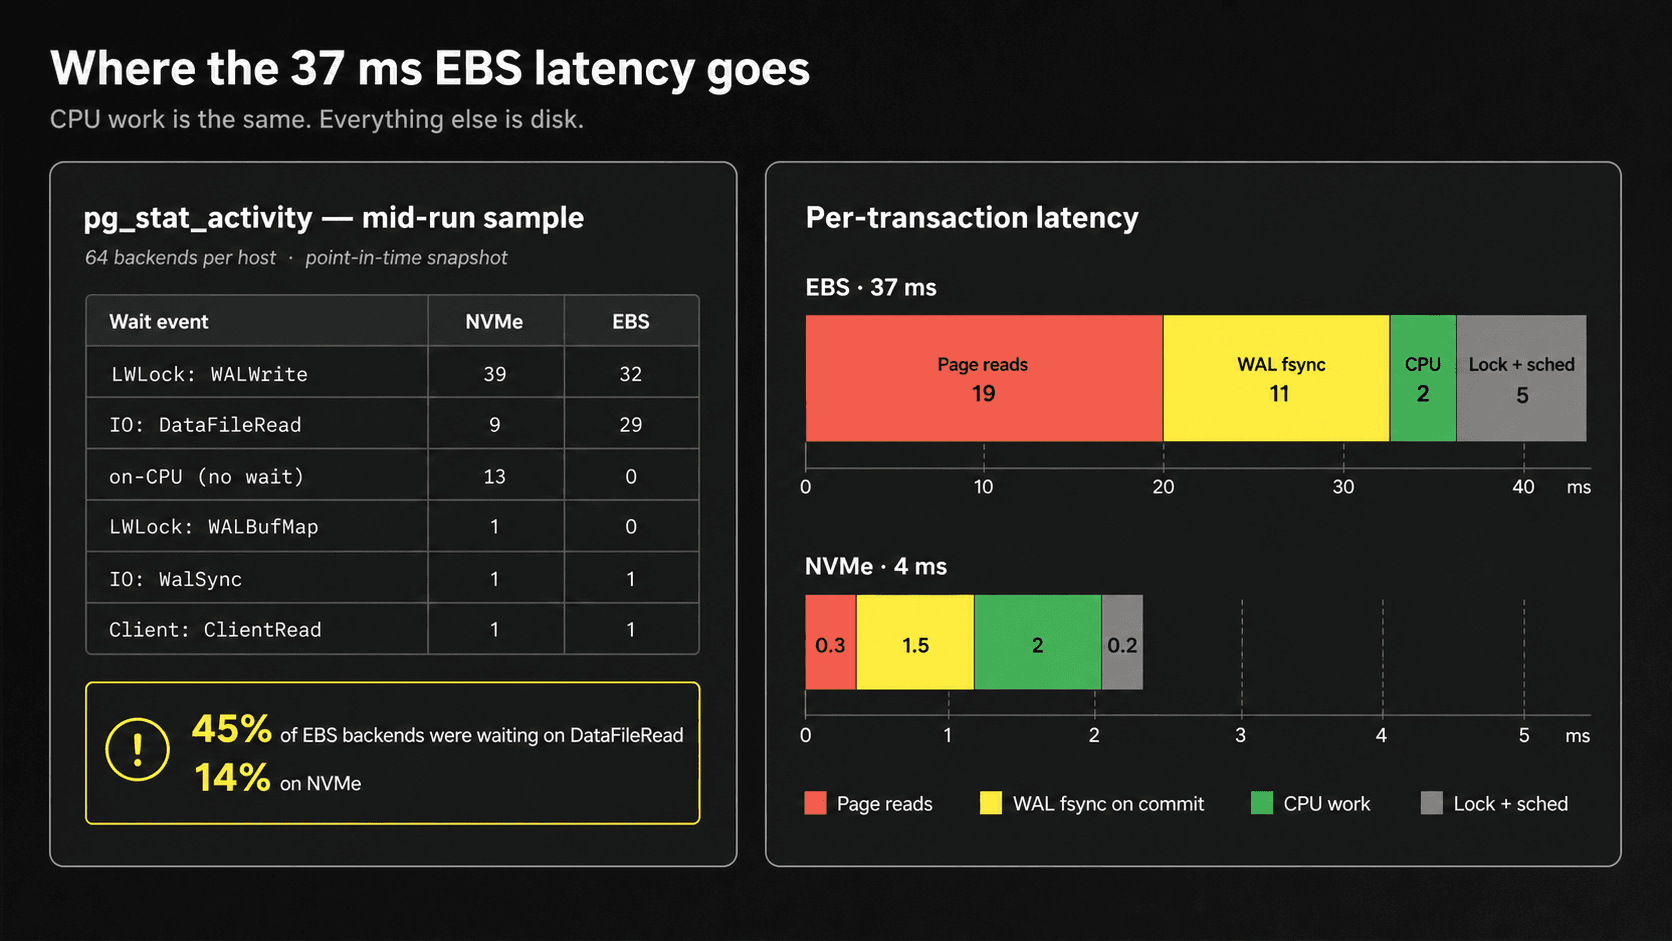 图:EBS 与 NVMe 的事务延迟拆解。重点看 page read 与 WAL fsync 两项差距,CPU 计算耗时两边接近。来源:ClickHouse(POSETTE 2026 演讲复盘)
延迟拆解图揭开了两者的物理差距。在云硬盘上,单次数据页读取耗时约 19 毫秒,本地盘仅需 0.3 毫秒。提交写入日志(WAL fsync)耗时 11 毫秒对比 1.5 毫秒。锁竞争与调度开销为 5 毫秒对比 0.2 毫秒。两边的计算耗时高度一致,都只花了约 2 毫秒。多出来的 35 毫秒延迟与计算逻辑毫无关系,进程全程都在等待远端存储确认。
云端硬盘隔着网线,吞吐量跌落 9 倍
许多人习惯把云硬盘当成本地配件。但在现代云架构中,弹性块存储本质上是远端机柜里的独立存储集群。每次读写数据,数据包都要穿过虚拟交换机、光纤链路与存储控制器。
本地固态硬盘直接插在主板总线上,离处理器只有几厘米。当并发写入打穿内存缓存,每次磁盘寻址都在考验响应速度。网络传输带来的毫秒级延迟,在密集的随机读写中被成倍放大。
这种差异在后台维护任务中同样明显。清理 10 GB 的表膨胀碎片,本地盘耗时 366 秒,云硬盘需要 964 秒。排空 10 GB 的逻辑复制积压,本地盘耗时 139 秒,云硬盘耗时 238 秒。维护速度跟不上产生垃圾的速度,表体积就会失控膨胀,挤占更多资源。
这项基准测试限定在 3000 IOPS 的基准 gp3 配置。若额外付费预置更高性能,云硬盘的表现会有所改善。但无论账单怎么涨,跨网络的往返时间依然无法缩短到主板直连的水平。
后台进程忙着等响应,算力空转 90%
压测期间的进程采样呈现出鲜明反差。在云硬盘上,64 个工作进程有 29 个卡在数据读取等待状态,占比近 45%。而在本地硬盘上,等待状态的进程只有 9 个,占比约 14%。
两台主机的处理器画像展示出结构差异。在 240 秒监控窗口内,本地盘主机累计消耗 2,253 个 CPU 秒,约 9.4 个核心全速运转。云硬盘主机仅记录到 251 个 CPU 秒,折合只有 1 个核心在忙碌。
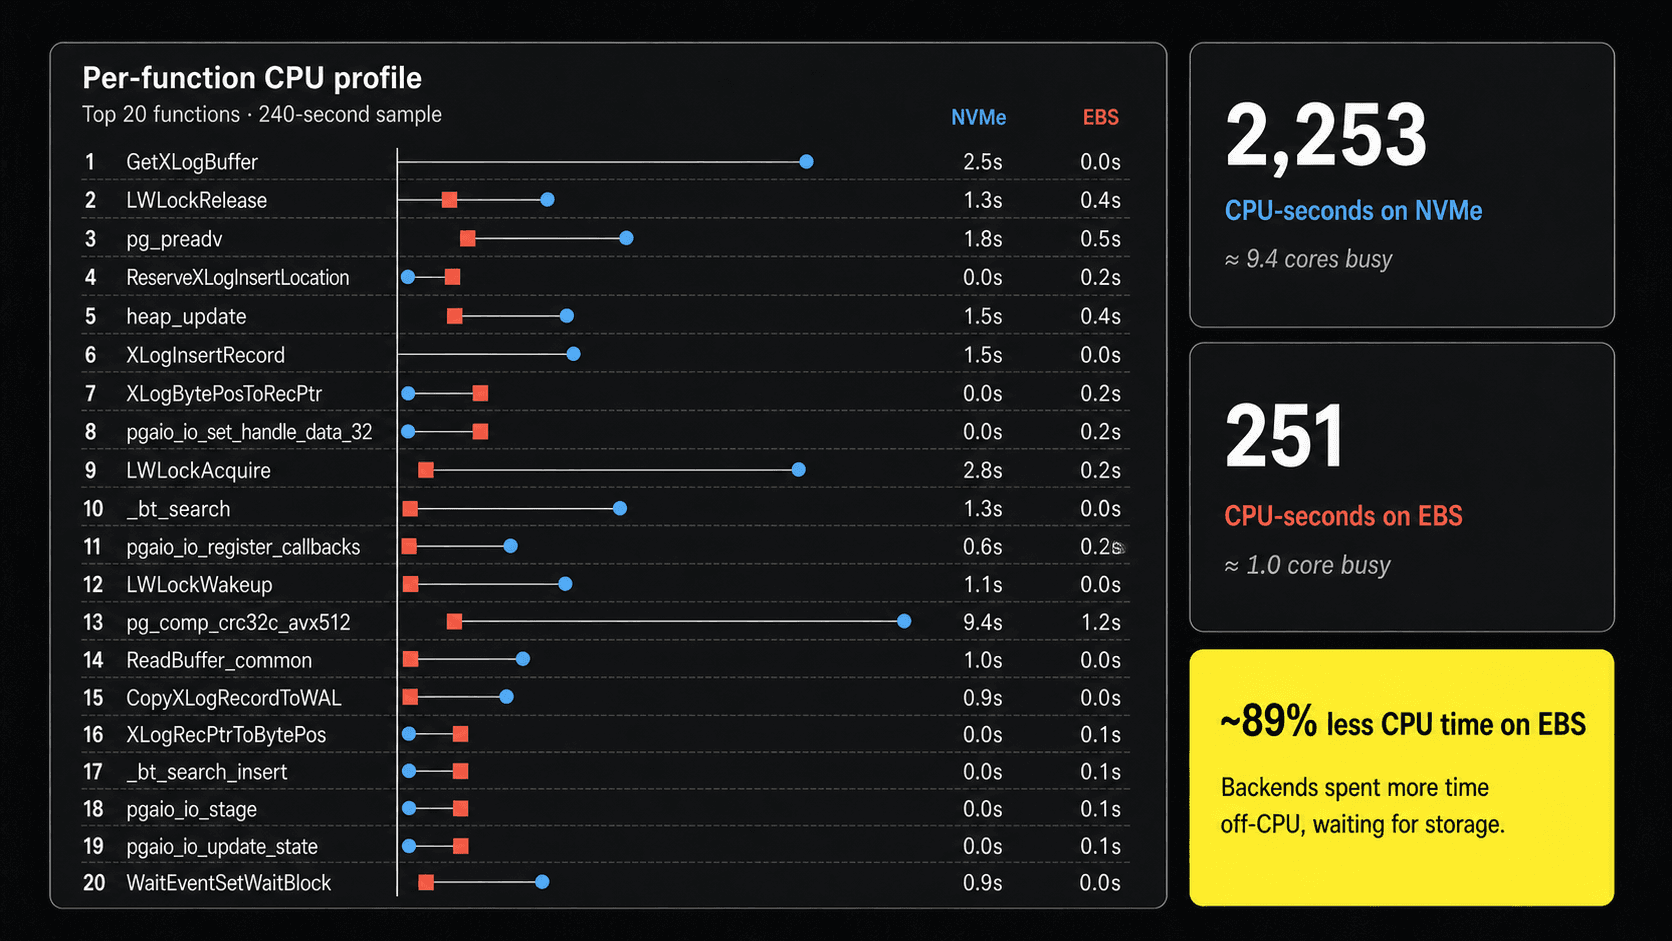 图:两台主机的 CPU 开销对比。NVMe 主机累计 2,253 个 CPU 秒,而 EBS 主机仅 251 个 CPU 秒,时间大量消耗在等待存储响应。来源:ClickHouse(POSETTE 2026 演讲复盘)
云硬盘主机的进程大多处于挂起状态,在干等远端数据传输。系统有九成算力处在无事可做的空转状态。工程师为 16 核处理器付了全款,实际只利用上一个核心。
这暴露出系统运维的一大误区。很多时候 CPU 占用率偏低,看似毫无负载压力。实际上,系统瓶颈早已卡在远端存储线路上。
换成本地盘提速,必须自己接管容灾
速度收益虽然诱人,在生产环境直接使用本地盘却是一场冒险。临时本地盘的生命周期严格依附于宿主机。底层物理机一旦断电或关机,本地盘里的数据便直接消失。
云硬盘虽然响应偏慢,但云厂商封装了多副本冗余与快照功能。主机损毁后,云硬盘能随时挂载到新节点。改用本地盘,相当于团队必须自己扛起高可用保障。性能收益是真的,运维责任也是真的。
生产环境落地本地盘,需要筑牢三道防线。第一道防线是跨机房同步复制。设置两个候选从节点,采用类似 ANY 1 (standby1, standby2) 的法定人数机制。任意一个从节点确认写入日志即可提交,兼顾性能与容灾。
第二道防线是持续备份。利用 WAL-G 等工具将数据底座与写入日志归档到对象存储。这能把恢复点目标(RPO)压缩到秒级,并支持任意时间点恢复。第三道防线是容量规划。本地盘容量受限于机型规格,无法随时点击扩容,必须提前留足空间。
性能需要把数据放在离 CPU 最近的地方。可靠性需要把备份放在离机器最远的地方。这组看似矛盾的工程目标,必须由架构自身消化。
拆掉网络中间层,性能与运维重新算账
这组测试在技术社区引发了公开讨论。部分工程师提出质疑。他们指出 ClickHouse 本身属于分析型产品,发布该结论有转移视线的嫌疑。
一线工程师给出了不少实测佐证。有团队把云数据库换到带本地固态硬盘的实例上。平均 I/O 延迟从 1.0 毫秒降到 0.1 毫秒,报表查询明显提速。也有人指出,网络块存储在机械硬盘时代非常划算。但在固态硬盘时代,网络抽象层让吞吐量平白损失了接近十倍。
在实际运维中,云硬盘快照常常与实例生命周期绑定。一旦误删实例,快照也可能随之丢失。很多团队本就需要自建备份系统。所谓把可靠性外包给云厂商,实际往往只是半外包。
数据库系统变慢,很多时候是那根跨机房的网络线缆拖了后腿。换用本地盘能取回属于硬件的数倍吞吐。但世上没有免费午餐,性能收益拿到手,容灾的担子就得自己挑起来。
参考链接:
- ClickHouse 官方技术博客(POSETTE 2026 演讲复盘)
- POSETTE 2026 演讲《Postgres Isn’t Slow. Your Storage Is.》
- Hacker News 社区讨论帖