まったく同じ33億行のデータを持つデータベースで、まったく同じ高並発のランダム書き込みを実行する。基盤のストレージをネットワーク接続型のクラウドディスクから筐体内蔵のローカルディスクに載せ替えた瞬間、処理速度は一気に9.24倍へ跳ね上がった。
本番データベースのレスポンスが悪化すると、開発チームはまずスロークエリの特定、インデックス追加、あるいはメモリの増設に走りがちだ。しかし2026年のPostgresコミュニティカンファレンス「POSETTE」において、あるエンジニアが1トランザクションあたりの内訳時間を徹底的に解剖した。合計36.9ミリ秒のレイテンシのうち、CPUが実際に計算処理を行っていた時間はわずか2ミリ秒。残る35ミリ秒もの間、プロセスはリモートディスクからデータが届くのをひたすら待っていたのだ。
システムを失速させていたボトルネックは、コンピューティング性能ではない。問題の本質は、ネットワークケーブルの先にある遠隔ラックのクラウドストレージにあった。
37ミリ秒の遅延を分解:実質的な計算処理はわずか2ミリ秒
データ規模が膨張すると、本番環境のデータベースは特有の並発合併症を起こし始める。書き込み時間は秒単位から分単位へと悪化し、読み取りレイテンシはミリ秒から秒単位へと跳ね上がる。バックグラウンドのVACUUMはテーブル肥大化(bloat)の速度に追いつかず、チェックポイント書き込みが業務トランザクションと競合し、レプリケーションパイプラインには遅延が蓄積していく。
その根本原因を突き止めるため、ClickHouseチームはまったく同一スペックのデータベースクラスタを8基構築した。テスト機にはAWSの m6id.4xlarge を採用。16 vCPU、64 GBメモリ、16 GBの shared_buffers を備えている。唯一の変数はストレージ層だ。4つのクラスタには3,000 IOPSが事前プロビジョニングされた標準的なgp3(EBS)をマウントし、残り4つのクラスタにはホスト内蔵のローカルNVMe SSDを割り当てた。
ベンチマークに用いたのは、33億行・容量482 GBに達する巨大テーブルだ。64クライアント・16ワーカースレッドから5分間にわたり集中的なランダムUPDATEを発行した。結果、ローカルSSDクラスタは毎秒16,030トランザクション(TPS)を記録したのに対し、EBSクラスタはわずか1,734 TPSにとどまった。中央値レイテンシは36.9ミリ秒から4.0ミリ秒へと劇的に短縮され、スループットの差は9.24倍に達した。
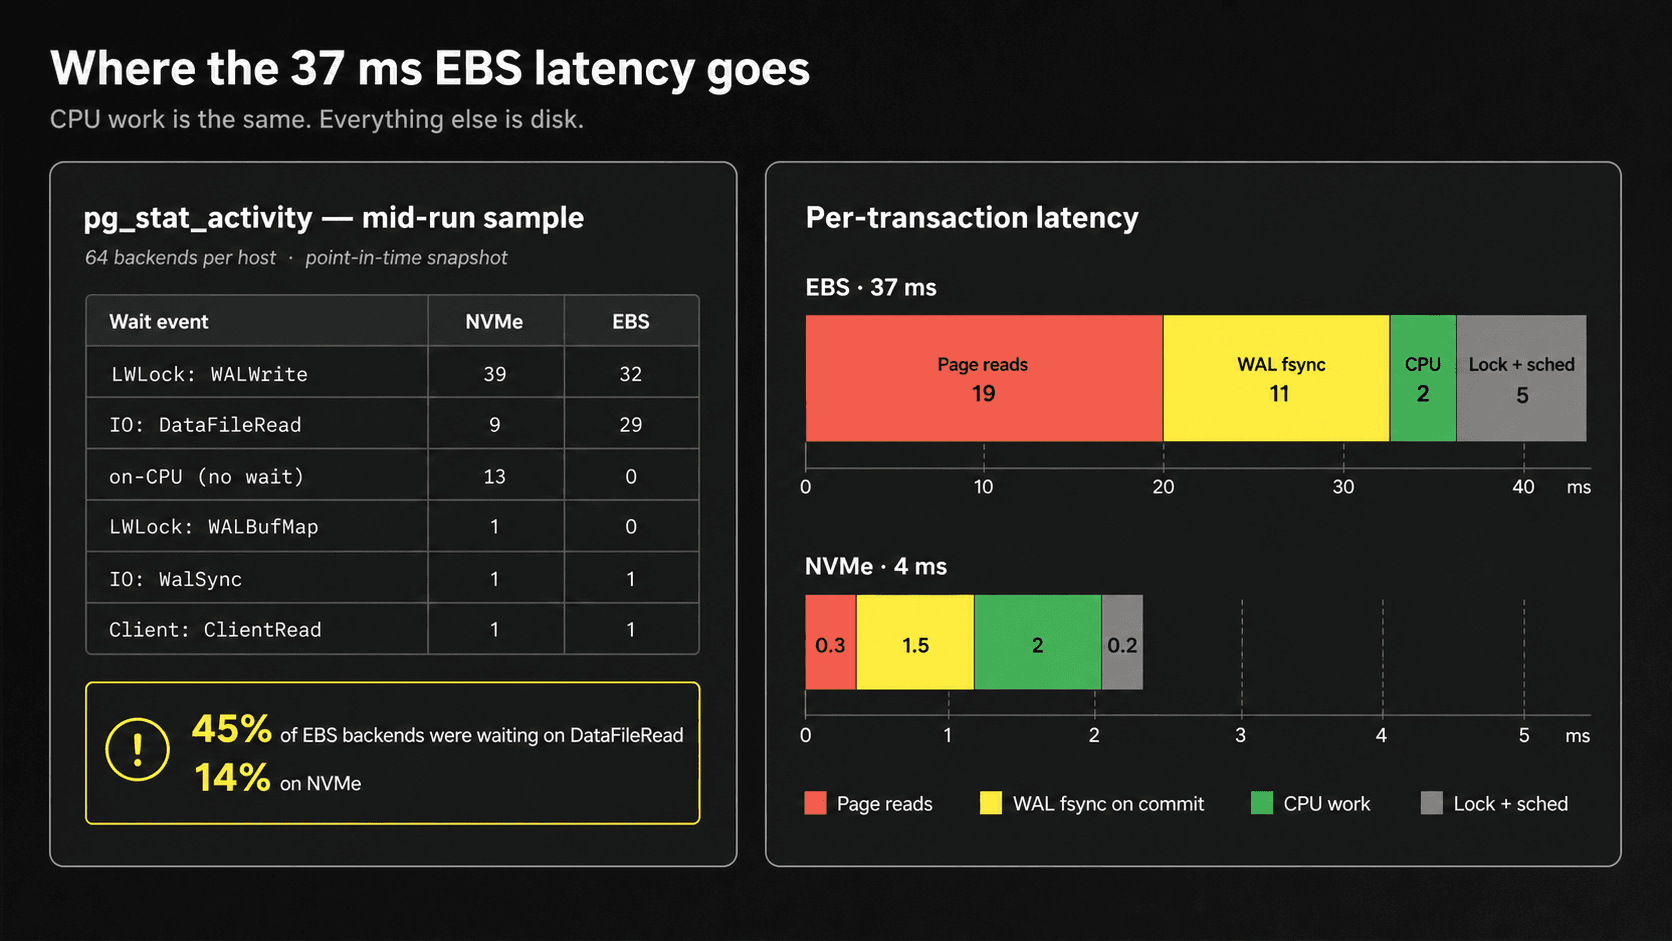 図:EBSとNVMeのトランザクションレイテンシ分解。page readとWAL fsyncの差が極めて大きく、CPUの計算時間は双方ほぼ同じであることがわかる。出典:ClickHouse(POSETTE 2026登壇振り返り)
レイテンシの内訳グラフは、両者の物理的な懸隔を鮮明に映し出す。EBS環境では1回のデータページ読み取りに約19ミリ秒を要していたのに対し、ローカルSSDではわずか0.3ミリ秒。先行書き込みログの同期コミット(WAL fsync)は11ミリ秒対1.5ミリ秒。ロック競合とスケジューリングのオーバーヘッドは5ミリ秒対0.2ミリ秒だった。一方、肝心の計算処理時間はいずれも約2ミリ秒と完全に一致している。余分な35ミリ秒の遅延はクエリのロジックとは何の関係もなく、プロセスが遠隔ストレージの応答確認を待つ時間だけに費やされていた。
ネットワークを挟むクラウドディスク:スループットが9割消失する理由
クラウドストレージをあたかも「ローカルドライブの延長」のように認識しているエンジニアは多い。しかし現代のクラウドインフラにおいて、EBSのようなブロックストレージの実体は、データセンターの別ラックに存在する独立した分散ストレージクラスタである。データを読み書きするたび、パケットは仮想スイッチ、光ファイバーケーブル、そしてストレージコントローラを経由しなければならない。
これに対し、ローカルNVMe SSDはマザーボードのPCIeバスに直結されており、CPUからの物理的距離はわずか数センチメートルだ。並発書き込みによってメモリキャッシュが溢れた瞬間、すべてのディスクシークがI/O応答性の限界を試すことになる。ネットワーク伝送によるミリ秒単位のオーバーヘッドが、高頻度のランダムアクセスによって何千倍にも増幅されるのだ。
この格差はバックグラウンドのメンテナンスタスクにも如実に現れる。10 GBのテーブル肥大化(bloat)をVACUUMでクリーンアップするのに、ローカル盤は366秒、EBSは964秒を要した。10 GB分のロジカルレプリケーションの滞留を処理する時間も、ローカル盤が139秒だったのに対し、EBSは238秒かかった。不要領域の回収速度がゴミの発生速度に追いつかなければ、テーブルの肥大化は歯止めが利かなくなり、さらに多くのリソースを侵食していく。
なお、今回のベンチマークはベースラインである3,000 IOPSのgp3設定に基づいている。追加コストを払ってIOPSやスループットを引き上げればある程度の改善は見込めるが、どれほど費用を投じても、物理的なネットワーク往復遅延をマザーボード直結のバス速度に縮めることは原理的に不可能だ。
応答待ちでスタックするプロセス群:CPUの90%がアイドル状態に
ベンチマーク中のプロセス状態サンプリングは、決定的な対比を記録した。EBSホストでは、64のワーカープロセスのうち29個(約45%)がデータ読み取りの待機(I/O wait)で完全に停止していた。一方、ローカルSSDホストで待機状態にあったプロセスはわずか9個(約14%)にすぎない。
両ホストのCPUプロファイルは、構造的なリソース浪費を浮き彫りにしている。240秒間のモニタリング期間中、ローカルSSDホストは累計2,253 CPU秒を消費し、約9.4コアがフル稼働していた。対してEBSホストが記録したのはわずか251 CPU秒で、実質的に1コア分しか稼働していなかった。
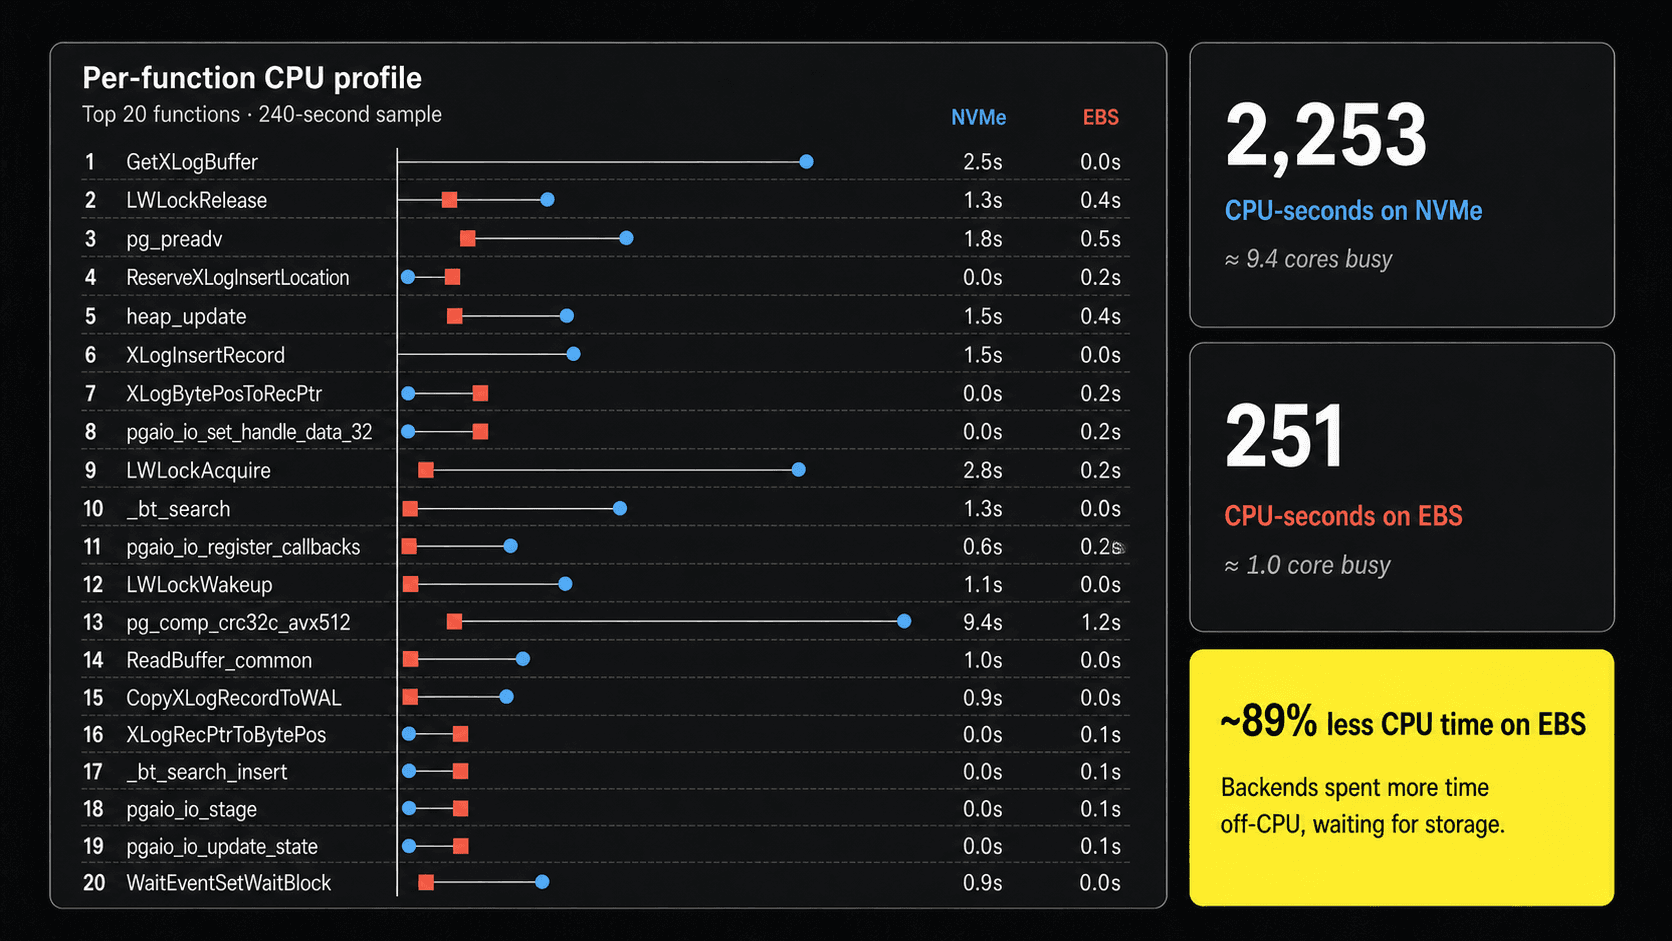 図:2台のホストにおけるCPUリソース消費の比較。NVMeホストが累計2,253 CPU秒を記録したのに対し、EBSホストはわずか251 CPU秒。大半の時間がストレージの応答待ちに消費されている。出典:ClickHouse(POSETTE 2026登壇振り返り)
EBSホスト上のプロセスは大半がサスペンド状態で放置され、遠隔地からのデータ転送をただ待っていた。システムの計算リソースの9割が、何もしない「空転状態」に陥っていたのだ。16コア分のマシン費用を満額支払っていながら、実質的には1コア分しか活用できていないことになる。
ここにはシステム運用における大きな盲点がある。CPU使用率が低いと、一見システムには十分な余裕があるように誤認されやすい。だが実際には、ボトルネックははるか手前の遠隔ストレージ伝送路で発生しているのだ。
ローカルディスクで加速するなら、災害対策(DR)は自前で引き受ける覚悟が必要
圧倒的な速度向上は極めて魅力的だが、本番環境でローカルディスクを採用することには相応のリスクが伴う。インスタンスストア(一時ローカルディスク)のライフサイクルはホスト物理マシンに完全に依存しており、物理ハードウェアの故障や停止が発生した場合、ローカルディスク内のデータは完全に消失する。
EBSは応答こそ遅いものの、クラウドベンダーがマルチレプリカの冗長性と自動スナップショットを標準で提供してくれる。万一仮想マシンが破損しても、EBSボリュームを別の健全なノードに付け替えれば数分で復旧できる。ローカルSSDへ切り替えるということは、チーム自身が高可用性(HA)と障害復旧(DR)の全責任を背負い直すことを意味する。手に入る性能は本物だが、運用責任もまた本物なのだ。
本番環境でローカルSSDを安全に運用するには、3重の防壁を構築しなければならない。
- アベイラビリティゾーン(AZ)を跨ぐ同期レプリケーション:スタンバイノードを2台用意し、
ANY 1 (standby1, standby2)のようなクォーラム同期を設定する。いずれか1台のスタンバイがWAL書き込みを確認した時点でコミットを完了させることで、レイテンシと耐障害性のバランスを両立する。 - 継続的バックアップとPITR(ポイントインタイムリカバリ):WAL-Gなどのツールを活用し、ベースバックアップとWALログをオブジェクトストレージ(S3等)へ継続的にアーカイブする。これにより目標復旧時点(RPO)を秒単位に抑え、任意の時点への復元を可能にする。
- 厳格な容量プランニング:ローカルディスクの容量はインスタンスの仕様に固定されており、スライダー1つで即座に拡張することはできない。将来のデータ増加を見越して十分なバッファを確保しておく必要がある。
性能を極めるにはデータをCPUの最も近くに置く必要があり、信頼性を極めるにはバックアップを物理マシンから最も遠い場所に逃がす必要がある。この一見矛盾する工学的要請を、アーキテクチャ設計自身によって調和させなければならない。
ネットワークの中間層を排除:性能と運用コストを再計算する
今回のClickHouseによる検証結果は、技術コミュニティで大きな議論を巻き起こした。ClickHouseが分析型データベース(OLAP)製品であることから、「ポジショントークではないか」と懐疑的な見方を示すエンジニアも一部存在した。
しかし、現場でPostgreSQLを運用する第一線のエンジニアたちからは数多くの賛同と実測データが寄せられた。あるチームはクラウドDBをローカルSSD搭載インスタンスへ移行した結果、平均I/Oレイテンシが1.0ミリ秒から0.1ミリ秒へと劇的に縮小し、集計レポートのクエリが目に見えて高速化したと報告した。また、ネットワーク接続型ストレージは低速な回転式HDDの時代には優れた抽象化だったが、超高速なSSD時代においては、ネットワーク層のオーバーヘッドがスループットの9割を無為に奪い去っているという指摘もなされた。
さらに実際の運用現場では、クラウドのスナップショット機能がインスタンスのライフサイクルと紐付いており、誤削除によってスナップショットごと失われる危険もある。結局のところ、多くのチームは自前のバックアップシステムを別途構築せざるを得ない。クラウドベンダーに信頼性を「丸投げ」していたつもりでも、実際には「半丸投げ」にすぎないのが現実だ。
データベースが遅いとき、真の元凶はマシン間を這うネットワークケーブルであることが少なくない。ローカルNVMeを採用すれば、現代のハードウェアが本来持っている圧倒的なスループットを取り戻すことができる。だが「タダ飯」は存在しない。その圧倒的なスピードを手にするなら、災害対策という重い荷物を自らの肩で担ぎ上げる覚悟が必要だ。
参考リンク:
- ClickHouse 公式技術ブログ(POSETTE 2026 講演振り返り)
- POSETTE 2026 講演『Postgres Isn’t Slow. Your Storage Is.』
- Hacker News コミュニティディスカッション