동일하게 33억 건의 데이터를 적재한 데이터베이스에서 동일하게 높은 동시성 무작위 쓰기를 수행했다. 밑단의 스토리지를 네트워크 연결형 클라우드 디스크에서 본체 내장 로컬 디스크로 교체하자마자 처리 속도가 순식간에 9.24배 치솟았다.
운영 데이터베이스가 느려지면 개발팀은 관행적으로 슬로우 쿼리를 추적하거나 인덱스를 추가하고 메모리를 증설하곤 한다. 2026년 Postgres 커뮤니티 콘퍼런스인 POSETTE에서 엔지니어들은 단일 트랜잭션의 소요 시간을 단계별로 해체 분석했다. 총 36.9밀리초의 지연 시간 중 프로세서가 실제 연산을 수행한 시간은 고작 2밀리초에 불과했다. 나머지 35밀리초 내내 시스템은 원격 디스크가 네트워크를 통해 데이터를 보내오기만을 멍하니 기다리고 있었다.
시스템의 발목을 잡은 병목은 결코 연산 능력이 아니었다. 원격 서버실에서 네트워크 케이블 너머로 연결된 클라우드 디스크가 근본적인 문제였다.
37밀리초 지연 시간 분해: 실제 연산은 단 2밀리초
데이터 규모가 급격히 불어나면 운영 데이터베이스에는 여러 동시성 합병증이 동시에 나타난다. 쓰기 지연 시간이 초 단위에서 분 단위로 늘어나고, 읽기 지연 시간은 밀리초 단위에서 초 단위로 튀어 오른다. 백그라운드 VACUUM은 테이블 비대화 속도를 따라잡지 못하고, 체크포인트 쓰기가 비즈니스 트랜잭션과 자원을 다투며, 복제 파이프라인에는 지연이 눈덩이처럼 쌓여 간다.
근본 원인을 밝혀내기 위해 ClickHouse 팀은 완전히 동일한 사양의 데이터베이스 클러스터 8개를 구축했다. 테스트 인스턴스로는 AWS m6id.4xlarge를 선정했다. 16개 vCPU, 64GB 메모리, 16GB shared_buffers를 탑재한 장비다. 유일한 변수는 스토리지 계층이었다. 4개 클러스터에는 3,000 IOPS로 사전 프로비저닝된 표준 gp3 EBS 볼륨을 연결했고, 나머지 4개 클러스터에는 호스트 내장 로컬 NVMe SSD를 직접 마운트했다.
벤치마크 대상은 33억 개 행과 482GB 용량에 달하는 거대한 데이터 테이블이었다. 64개 클라이언트와 16개 워커 스레드가 5분 동안 쉼 없이 무작위 UPDATE 쿼리를 쏟아부었다. 그 결과 로컬 SSD 클러스터는 초당 16,030건의 트랜잭션(TPS)을 처리한 반면, EBS 클러스터는 1,734건에 그쳤다. 중간값 지연 시간은 36.9밀리초에서 4.0밀리초로 단축되었으며, 처리량 격차는 9.24배에 달했다.
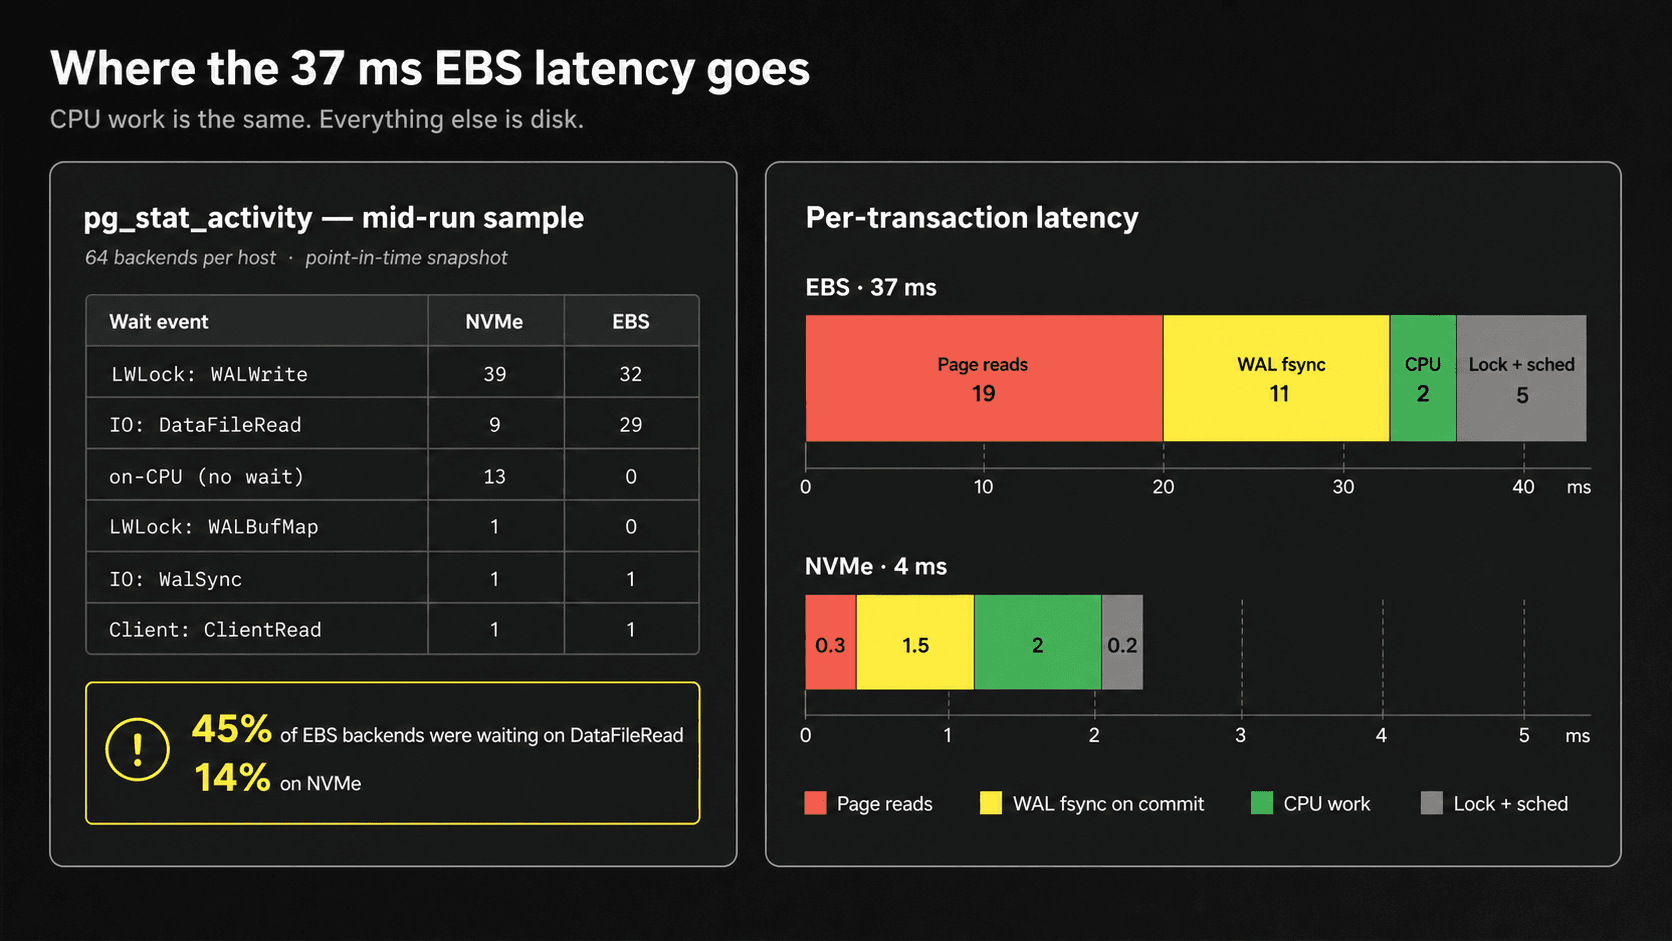 그림: EBS와 NVMe의 트랜잭션 지연 시간 분해. page read와 WAL fsync 항목의 격차가 두드러지며, CPU 연산 시간은 양쪽이 거의 동일하다. 출처: ClickHouse (POSETTE 2026 발표 회고)
지연 시간 분석 차트는 두 스토리지의 물리적 격차를 적나라하게 드러낸다. EBS 환경에서는 단일 데이터 페이지 읽기에 약 19밀리초가 걸렸지만 로컬 SSD는 0.3밀리초면 충분했다. 쓰기 로그 커밋(WAL fsync) 시간은 11밀리초 대 1.5밀리초였다. 락 경합과 스케줄링 오버헤드는 5밀리초 대 0.2밀리초였다. 반면 핵심 연산 시간은 두 환경 모두 약 2밀리초로 완벽하게 일치했다. 35밀리초에 달하는 추가 지연 시간은 쿼리 로직과는 아무런 상관이 없었으며, 프로세스가 전체 과정 동안 원격 스토리지의 확인 응답을 기다리는 데 쓰였다.
네트워크 케이블을 거치는 클라우드 디스크: 처리량 9배 급감
많은 이들이 클라우드 디스크를 일반 로컬 드라이브처럼 다루는 데 익숙해져 있다. 하지만 현대 클라우드 인프라에서 EBS 같은 블록 스토리지는 본질적으로 원격 랙에 위치한 독립된 분산 스토리지 클러스터다. 데이터를 읽고 쓸 때마다 패킷은 가상 스위치와 광케이블, 원격 스토리지 컨트롤러를 거쳐야만 한다.
반면 로컬 NVMe SSD는 메인보드의 PCIe 버스에 직결되어 있어 CPU와의 물리적 거리가 몇 센티미터에 불과하다. 대규모 동시성 쓰기가 메모리 버퍼를 뚫고 내려오는 순간, 모든 디스크 탐색은 I/O 응답 속도의 한계를 시험받게 된다. 네트워크 전송이 유발하는 밀리초 단위의 지연은 빽빽한 무작위 읽기/쓰기 작업 속에서 수천 배로 증폭된다.
이러한 격차는 백그라운드 유지보수 작업에서도 고스란히 드러난다. 10GB의 테이블 비대화 파편을 VACUUM으로 정리하는 데 로컬 디스크는 366초가 걸린 반면 EBS는 964초가 소요되었다. 10GB 규모의 논리적 복제 지연을 해소하는 시간 역시 로컬 디스크는 139초, EBS는 238초였다. 유지보수 속도가 쓰레기 생성 속도를 따라가지 못하면 테이블 크기는 걷잡을 수 없이 팽창하여 시스템 자원을 더욱 옥죄게 된다.
이번 벤치마크는 기본 3,000 IOPS 사양의 gp3 환경을 기준으로 진행되었다. 추가 비용을 지불하고 프로비저닝된 성능을 끌어올리면 EBS의 수치도 일부 개선될 수 있다. 하지만 아무리 요금을 쏟아붓더라도 네트워크 왕복 지연 시간 자체를 메인보드 직결 수준으로 단축하는 것은 물리적으로 불가능하다.
응답 대기로 발 묶인 프로세스들: 연산력의 90%가 공회전
벤치마크 진행 중 프로세스 상태를 샘플링한 결과는 극명한 대비를 보여 주었다. EBS 호스트에서는 64개 워커 프로세스 중 29개가 데이터 읽기 대기(I/O wait) 상태에 갇혀 있었으며, 이는 전체의 45%에 달했다. 반면 로컬 SSD 호스트에서 읽기 대기 상태에 머문 프로세스는 9개로 약 14%에 불과했다.
두 호스트의 CPU 프로파일은 구조적인 자원 낭비를 여실히 드러냈다. 240초의 모니터링 구간 동안 로컬 SSD 호스트는 총 2,253 CPU초를 소모하며 약 9.4개 코어를 최대치로 가동했다. 반면 EBS 호스트는 고작 251 CPU초만 기록하여, 전체 테스트 동안 실질적으로 코어 1개 분량만 일한 셈이었다.
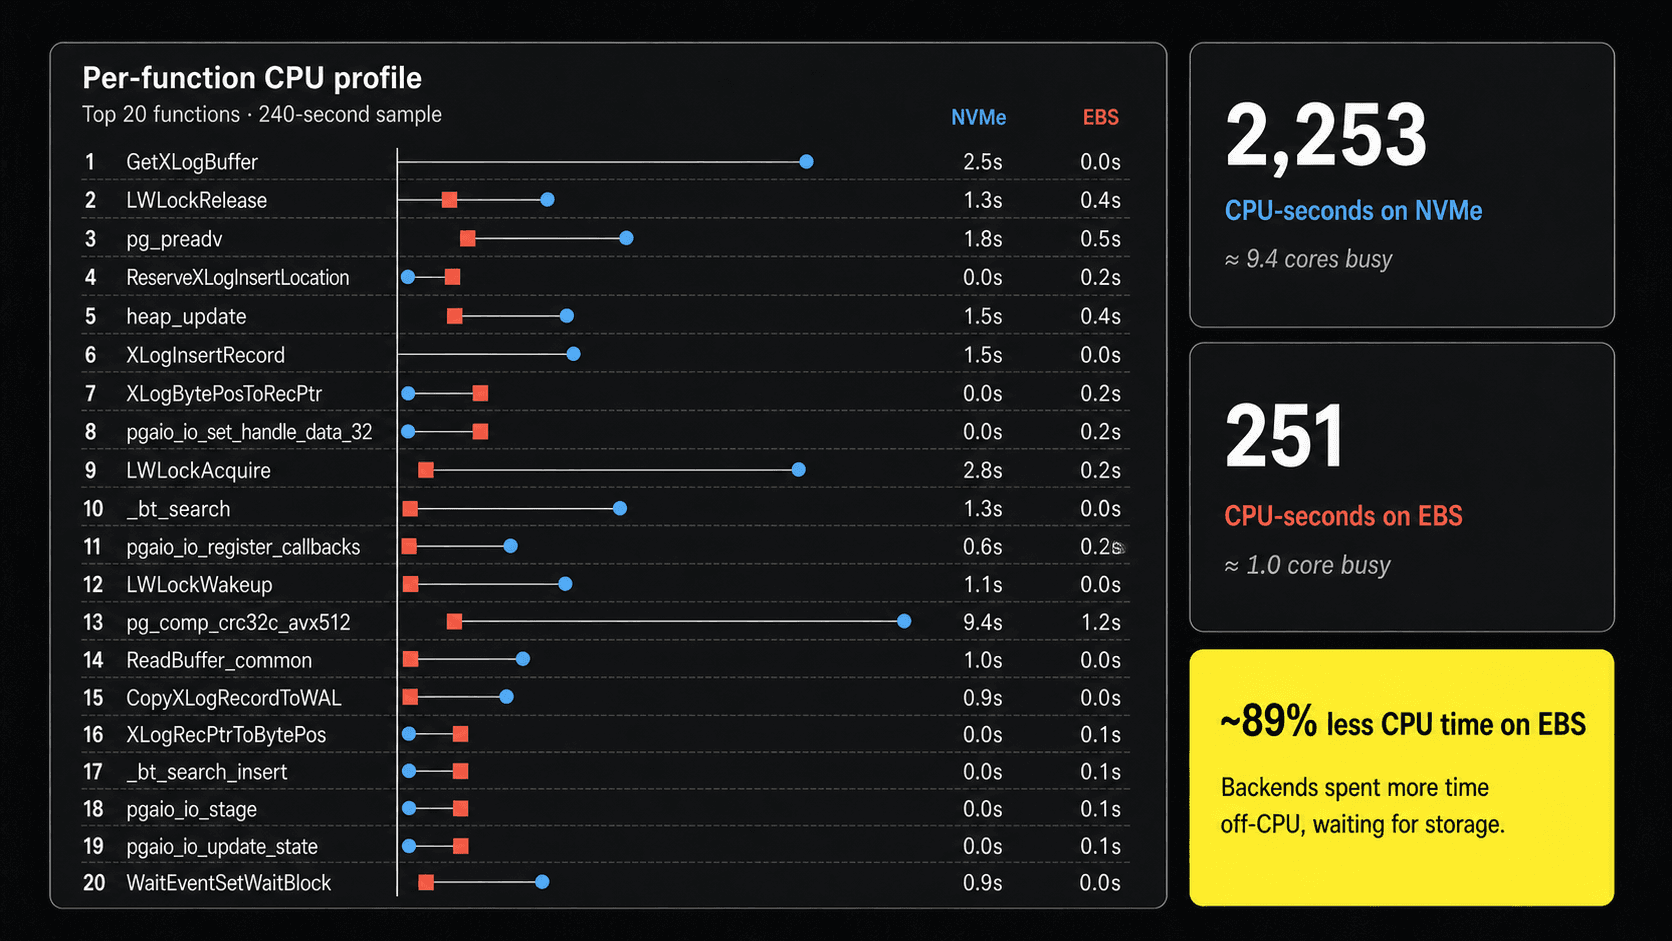 그림: 두 호스트 간 CPU 자원 소모 비교. NVMe 호스트는 총 2,253 CPU초를 기록한 반면 EBS 호스트는 251 CPU초에 그쳤으며, 대부분의 시간이 스토리지 응답 대기로 소모되었다. 출처: ClickHouse (POSETTE 2026 발표 회고)
EBS 호스트의 프로세스 대부분은 일시 정지 상태로 대기하며 원격 데이터 패킷이 네트워크를 타고 오기만을 기다렸다. 시스템 연산 능력의 90%가 아무런 일도 하지 못하는 공회전 상태에 머문 것이다. 엔지니어링팀은 16코어 인스턴스의 비용을 전부 지불하고도 실질적으로는 1개 코어만 사용한 꼴이다.
이는 시스템 운영 관리의 대표적인 함정을 시사한다. CPU 사용률이 낮으면 겉보기에는 부하가 전혀 없어 평온해 보인다. 하지만 실제로는 원격 스토리지 전송 선로에서 시스템 전체가 심각한 병목에 가로막혀 있을 수 있다.
로컬 디스크 도입의 대가: 재해 복구 체계는 직접 구축해야
압도적인 속도 향상은 매력적이지만, 상용 프로덕션 환경에서 로컬 디스크를 도입하는 것은 상당한 리스크를 동반한다. 임시 인스턴스 스토어 디스크의 수명주기는 호스트 물리 서버에 종속되어 있다. 밑단의 물리 서버 전원이 꺼지거나 장애가 발생하면 로컬 디스크에 저장된 데이터는 즉시 소멸한다.
EBS는 응답 속도가 상대적으로 느리지만, 클라우드 제공업체가 다중 복제본 이중화와 스냅샷 백업 기능을 기본 제공한다. 가상 머신이 손상되더라도 EBS 볼륨을 분리하여 다른 정상 노드에 언제든 다시 마운트할 수 있다. 로컬 디스크로 전환한다는 것은 운영팀이 고가용성(HA)과 재해 복구(DR) 책임을 직접 짊어져야 함을 뜻한다. 성능 향상도 진짜이지만, 운영 책임 역시 엄연한 현실이다.
프로덕션 환경에 로컬 디스크를 안정적으로 안착시키려면 세 가지 견고한 방어선을 구축해야 한다.
- 가용 영역(AZ) 간 동기 복제: 대기 복제본 노드 2개를 구성하고
ANY 1 (standby1, standby2)같은 쿼럼 메커니즘을 적용한다. 복제본 중 어느 하나라도 WAL 쓰기 로그를 확인하면 커밋을 완료하여 낮은 지연 시간과 내결함성을 동시에 확보한다. - 지속적 백업 및 시점 복구(PITR): WAL-G 같은 도구를 활용해 베이스 백업과 WAL 로그를 오브젝트 스토리지(S3 등)로 지속해서 아카이빙한다. 이를 통해 복구 시점 목표(RPO)를 초 단위로 단축하고 원하는 임의의 시점으로 복구할 수 있다.
- 철저한 용량 계획: 로컬 디스크 용량은 인스턴스 하드웨어 스펙에 고정되어 있으므로 클릭 한 번으로 즉시 늘릴 수 없다. 향후 데이터 증가량을 정밀하게 예측하고 충분한 여유 공간을 미리 마련해 두어야 한다.
최고의 성능을 내려면 데이터를 CPU에 가장 가까운 곳에 두어야 하고, 최고의 신뢰성을 확보하려면 백업을 물리 장비에서 가장 먼 곳에 격리해야 한다. 이처럼 상충하는 공학적 목표를 시스템 아키텍처 설계를 통해 조화롭게 풀어내야 한다.
네트워크 계층 제거: 성능과 운영 비용의 새로운 손익 계산
이번 벤치마크 결과는 기술 커뮤니티에서 활발한 토론을 촉발했다. 일부 엔지니어들은 ClickHouse가 분석형 데이터베이스 제품이라는 점을 들어, 병목의 시선을 스토리지 쪽으로 돌리려는 의도가 아니냐는 의문을 제기하기도 했다.
그러나 실제 현장에서 Postgres를 운영하는 일선 엔지니어들은 실측 사례를 통해 이를 뒷받침했다. 클라우드 DB를 로컬 NVMe 기반 인스턴스로 이전한 한 팀은 평균 I/O 지연 시간이 1.0밀리초에서 0.1밀리초로 단축되어 리포트 집계 쿼리가 눈에 띄게 빨라졌다고 밝혔다. 또 다른 엔지니어는 회전식 하드디스크 시절에는 네트워크 블록 스토리지가 비용 효율적이었지만, 초고속 SSD 시대에는 네트워크 추상화 계층이 처리량의 거의 열 배를 허공으로 날려 버리고 있다고 지적했다.
실제 운영 환경에서 클라우드 디스크 스냅샷은 인스턴스 수명주기와 연동되어 있는 경우가 많아 인스턴스 오삭제 시 스냅샷까지 함께 날아갈 위험이 있다. 결국 대다수 조직은 별도의 자체 백업 파이프라인을 구축해야 한다. 클라우드 제공사에 안정성을 완전히 위탁했다고 믿었지만, 실상은 절반만 외주를 준 셈이다.
데이터베이스 시스템이 느려질 때, 진짜 원인은 서버실을 가로지르는 네트워크 케이블일 가능성이 높다. 로컬 NVMe로 교체하면 하드웨어가 지닌 본래의 폭발적인 처리량을 되찾을 수 있다. 하지만 세상에 공짜는 없다. 압도적인 성능을 손에 쥐는 순간, 재해 복구라는 무거운 책임은 개발팀 스스로의 어깨에 짊어져야 한다.
참고 링크:
- ClickHouse 공식 기술 블로그 (POSETTE 2026 발표 회고)
- POSETTE 2026 발표 《Postgres Isn’t Slow. Your Storage Is.》
- Hacker News 커뮤니티 토론 스레드