Der Austausch eines etablierten Frontier-Modells gegen ein leichtgewichtiges Modell in Produktivumgebungen erfordert meist spürbare Kompromisse bei der Leistungsfähigkeit. Doch im zentralen internen Ticketsystem von Amazon gelang den Ingenieuren eine bemerkenswerte architektonische Wende: Claude Sonnet 4.6, das bislang für Klassifizierungs- und Routingaufgaben zuständig war, wurde aus dem kritischen Pfad entfernt. An seine Stelle tritt Strands Decider, ein hochspezialisiertes Entscheidungsmodell mit lediglich 4 Milliarden Parametern. Die Bearbeitungszeit pro Ticket sank von 4.215 ms auf 897 ms, während die Inferenzkosten pro Million Tickets von 22.200 auf rund 500 US-Dollar einbrachen – eine Reduktion um 98 %.
Dieser drastische Kostenvorteil beruht auf einem grundlegenden Überdenken dessen, was eine Klassifizierungsaufgabe tatsächlich verlangt. In herkömmlichen Agenten-Architekturen ist es üblich, universelle LLMs mit Klassifizierungen zu betrauen: Man füttert sie mit Tausenden von Tokens an Regelwerken und wartet, während das Modell Wort für Wort autoregressiv dekodiert. Bei einer geschlossenen Single-Choice-Aufgabe benötigt das System jedoch lediglich die Wahrscheinlichkeiten für vordefinierte Labels, keinen neu generierten Text. Durch den Verzicht auf die autoregressive Generierung entfällt der Netzwerk-Overhead für komplexe Formatierungs-Prompts vollständig, und die nachgelagerte syntaktische JSON-Validierung wird überflüssig.
Interne Ticket-Klassifizierung: Sechstausend Tokens pro Aufruf verbrannt
Amazon betreibt ein gigantisches internes Ticketsystem. Täglich strömen unzählige Tickets herein, die von System-Upgrades und Kapazitätserweiterungen bis hin zu Überwachungsalarmen und Compliance-Audits reichen – alle müssen einer von 20 festgelegten Kategorien zugeordnet werden. Zuvor wurde diese Aufgabe von Claude Sonnet 4.6 auf Amazon Bedrock übernommen, das lange Zeit als solider Standard für das Gleichgewicht zwischen Intelligenz und Kosten galt.
Das tokenbasierte Abrechnungsmodell universeller LLMs entwickelte sich in dieser hochfrequenten Pipeline jedoch zu einer enormen Kostenfalle. Um das Modell streng auf die Klassifizierungsregeln einzuschwören, musste bei jedem Aufruf ein ausführlicher System-Prompt mitgeliefert werden, der die genauen Abgrenzungskriterien aller 20 Kategorien sowie strenge JSON-Formatvorgaben definierte. Telemetriedaten aus der Produktion zeigten, dass pro Ticket durchschnittlich 6.554 Eingabe-Tokens und 170 Ausgabe-Tokens anfielen – insgesamt 6.724 Tokens pro Vorgang. Der überwiegende Teil der Rechenressourcen wurde damit verschwendet, statische Formatregeln immer wieder neu zu übertragen.
Die autoregressive Generierung über Tausende von Tokens bremste zudem die Antwortzeiten massiv aus: Claude benötigte pro Ticket durchschnittlich 4.215 ms. Latenzen von über vier Sekunden führten zu bedenklichen Verarbeitungsstaus auf den vorgelagerten SQS-Consumer-Knoten. Nach offiziellen Bedrock-Listenpreisen beliefen sich die reinen Modellkosten auf 0,0222 US-Dollar pro Ticket – eine Rechnung von 22.200 US-Dollar pro Million Tickets. Dieser hohe finanzielle Druck zwang das Team zu einem radikalen Kurswechsel.
Generierungs-Pipeline eliminiert: Wahrscheinlichkeitsverteilung senkt Latenz um 78 %
Für die geschlossene Klassifizierungsaufgabe setzte das Team auf Strands Decider, ein quelloffenes Entscheidungsmodell. Im Unterschied zu autoregressiven Sprachmodellen verzichtet diese Architektur auf den Language-Modeling-Kopf und verwendet stattdessen einen Pointer Head zur direkten Bewertung der Kandidatenoptionen. Der Input umfasst ausschließlich den aktuellen Zustand, die Fragestellung und die Liste der Auswahlmöglichkeiten. In einem einzigen Vorwärtsdurchlauf (Forward Pass) berechnet das Modell per Softmax die Wahrscheinlichkeitsverteilung und die Konfidenzwerte der Optionen.
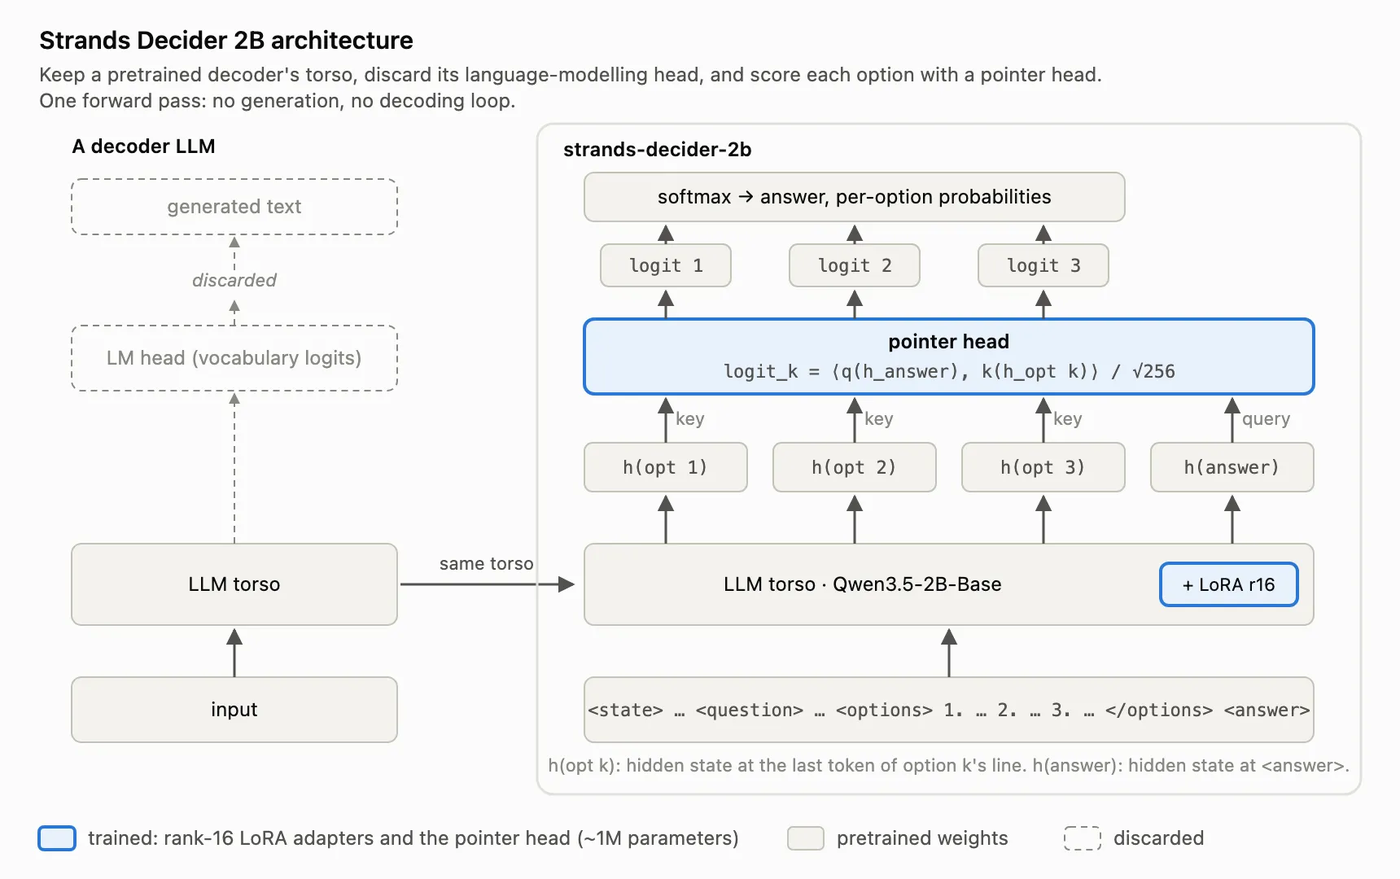 Abbildung: Strands Decider ersetzt den autoregressiven Generierungskopf durch einen Pointer Head zur Bewertung von Optionen. Quelle: Strands Agents
Dieser strukturelle Umbau eliminiert die iterative Sampling-Schleife der Textgenerierung vollständig. Da die Inferenz in einem einzigen Vorwärtsschritt erfolgt, entfällt die sequenzielle Dekodierverzögerung, und das Risiko ungültiger JSON-Ausgaben ist gebannt. Nachfolgende Benchmarks zeigten zudem, dass die auf Gemma 4 basierende E4B-Variante bei der Klassifizierungsgenauigkeit sogar das produktive Claude Sonnet 4.6 übertraf. Das Team entschied sich daher für den sofortigen Produktionseinsatz von E4B.
Die Verschlankung von Ein- und Ausgabe führte zu einem gewaltigen Leistungssprung: Auf demselben Testdatensatz sank die durchschnittliche Latenz von 4.215 ms auf 897 ms – ein Rückgang um 78 %. Die Eingabetokens sanken von 6.554 auf 2.009 pro Ticket, während die Ausgabe von 170 Tokens auf ein einziges Options-Token reduziert wurde, was den gesamten Token-Verbrauch um 70 % verringerte. Am Tag der Abschaltung von Sonnet 4.6 brach die durchschnittliche Ausführungsdauer der vorgeschalteten AWS Lambda-Funktionen um 74 % ein.
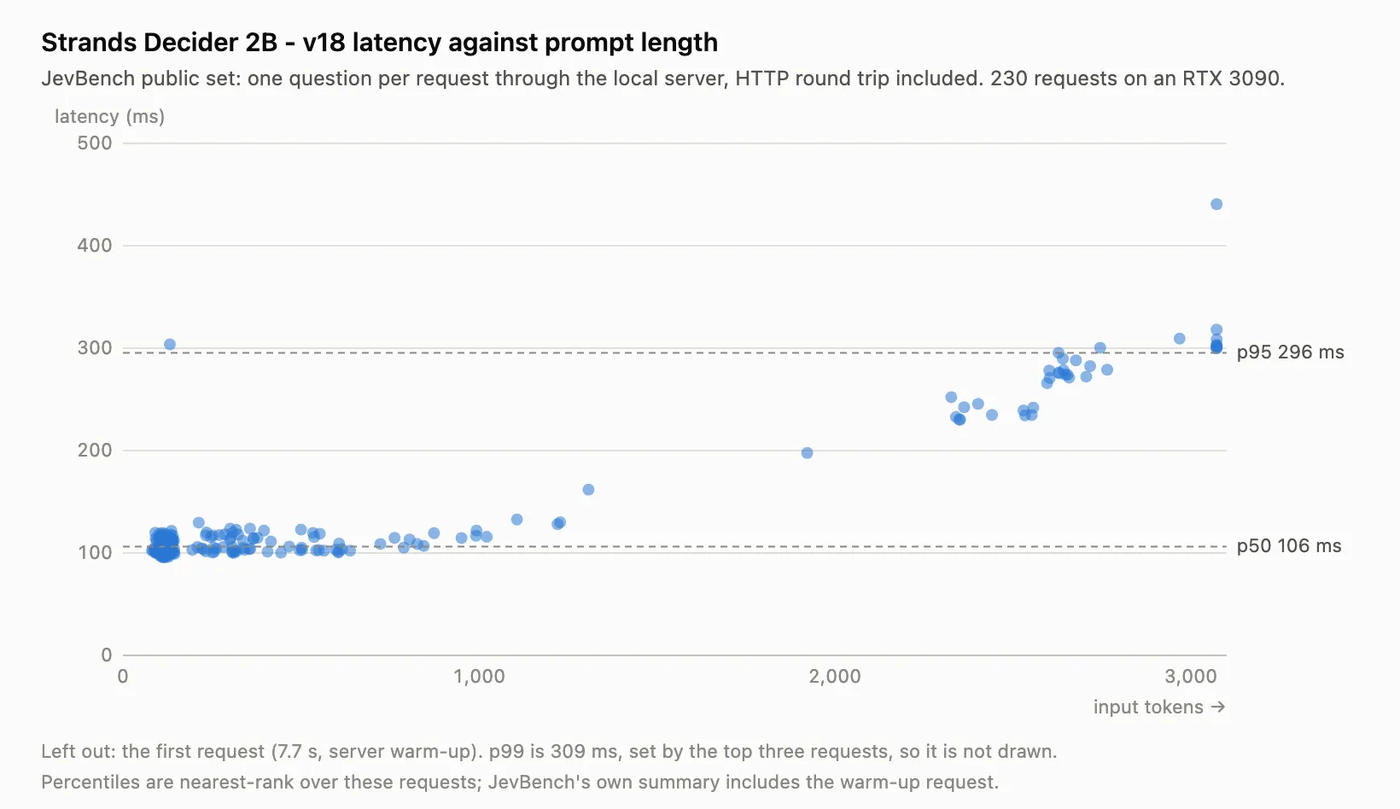 Abbildung: Latenzverteilung von Strands Decider im Evaluierungsdatensatz; Netzwerk-Roundtrips und Rechenzeiten bleiben auf konstant niedrigem Niveau. Quelle: Strands Agents
Die Latenzsenkung verbesserte die Ressourceneffizienz der Serverless-Infrastruktur erheblich. Da die Abrechnung von Lambda direkt an die Ausführungsdauer gekoppelt ist, bedeutete die Reduzierung der Laufzeit auf ein Viertel, dass auch die benötigten Concurrency-Kontingente für denselben Durchsatz drastisch sanken. Warteschlangenstaus schrumpften in den Subsekundenbereich, was die Reaktionsfähigkeit auf kritische Alarme spürbar beschleunigte.
Das 4.096-Token-Fenster erzwingt Engineering-Präzision: Regelkürzung und feste JSON-Schlüsselreihenfolge
Die Umstellung auf ein spezialisiertes Entscheidungsmodell war kein einfacher Drop-in-Ersatz; das begrenzte Kontextfenster stellte die Ingenieure vor die erste Hürde. Strands Decider besitzt ein maximales Kontextfenster von 4.096 Tokens. In der ursprünglichen Produktionsfassung belegten die ausführlichen Definitionen und Few-Shot-Beispiele für 20 Kategorien allein bereits über 4.000 Tokens – bei einer 1:1-Übernahme wäre kein Platz mehr für den eigentlichen Tickettext geblieben.
Die Ingenieure mussten ihr Prompt-Engineering von Grund auf neu strukturieren. Das Team destillierte jede Kategorie in ein bis zwei prägnante Entscheidungsregeln, überführte diese in ein Multiple-Choice-Format und fügte am Ende die Ausschlussoption none hinzu. Bei besonders langen Tickets verwarf das System bewusst ältere Kommentarverläufe, um sicherzustellen, dass der aktuelle Systemstatus und die entscheidenden Fehlerprotokolle vollständig im Kontext blieben.
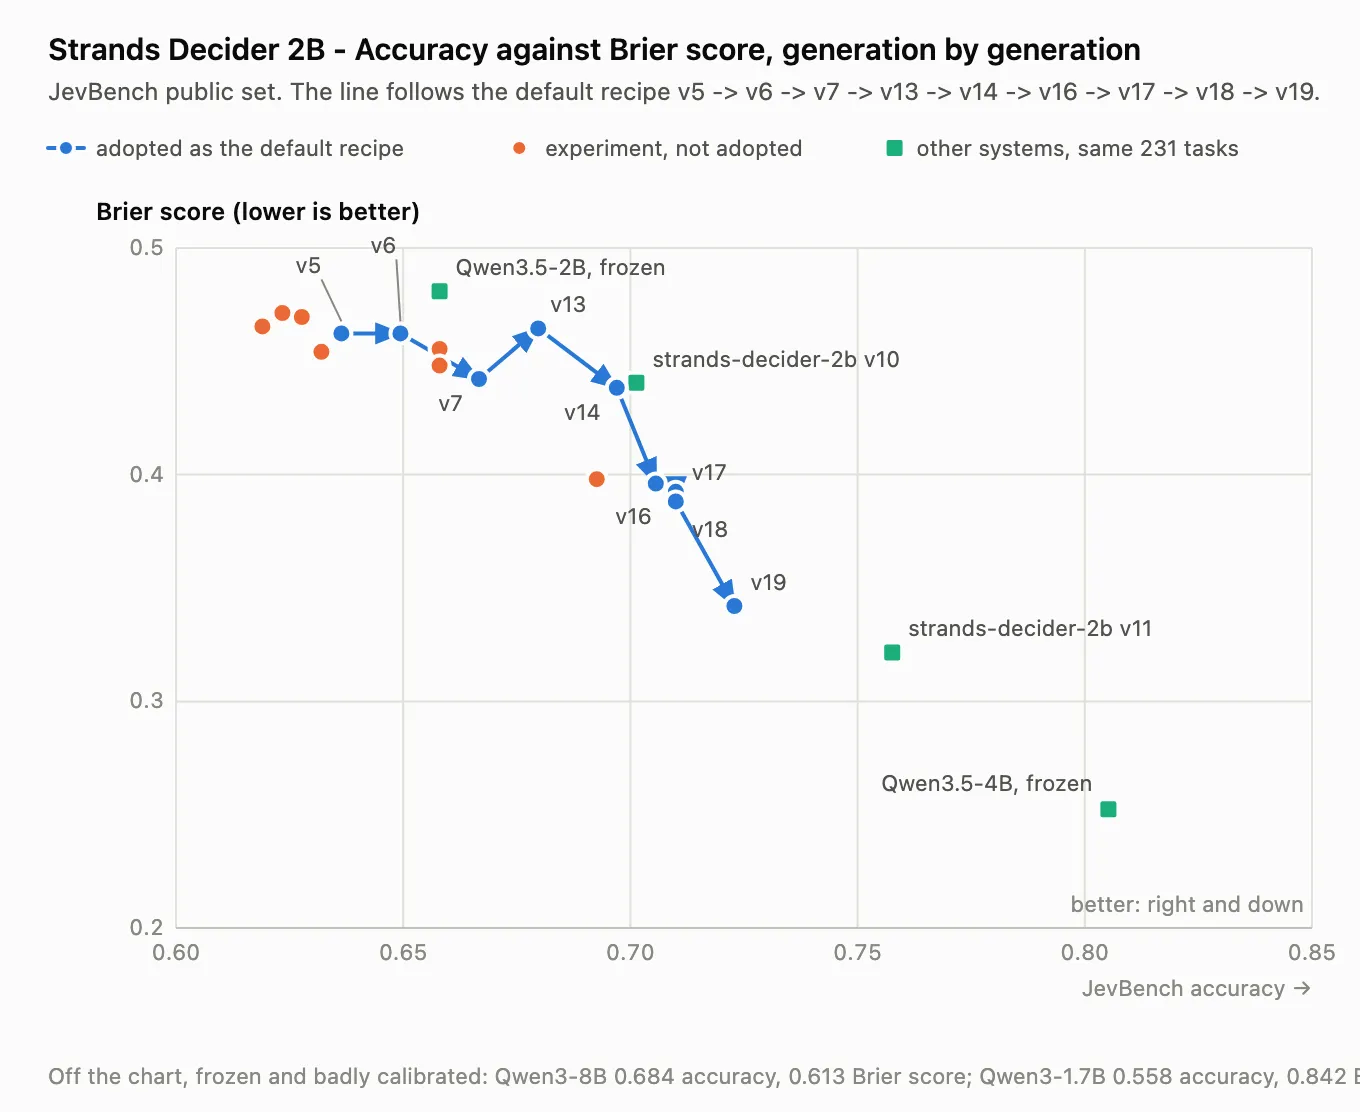 Abbildung: Entwicklung von Entscheidungskalibrierung und Genauigkeit im Modellverlauf; ein niedrigerer Brier-Score signalisiert verlässlichere Wahrscheinlichkeiten. Quelle: Strands Agents
Um eine hohe Klassifizierungsqualität zu garantieren, wurde ein Konfidenz-Schwellenwert etabliert. Das Team kalibrierte die Wahrscheinlichkeitskurven kontinuierlich, um den Brier-Score im Entscheidungsprozess zu minimieren. Nur wenn die Konfidenz der besten Option den Schwellenwert überschreitet, wird das Ticket automatisch klassifiziert. Liegt die Konfidenz darunter oder lautet das Ergebnis none, wird das Ticket automatisch zur manuellen Prüfung an menschliche Ingenieure weitergeleitet.
In der Integrationsphase stieß das Team auf ein überraschendes Low-Level-Phänomen: Die Serialisierungsreihenfolge von JSON-Schlüsseln beeinflusste das Entscheidungsverhalten. Obwohl die Inhalte identisch blieben, führte das bloße Vertauschen der Schlüssel zu einer Verschiebung der Ausgabewahrscheinlichkeiten von bis zu 0,19. Bei Grenzfällen reichte dies aus, um die Einstufung kippen zu lassen. Das Team führte daraufhin eine strikte alphabetische Sortierung aller JSON-Schlüssel ein und schloss diese Schwankungsquelle vollständig aus.
AppConfig-Dreistufen-Umschaltung: 5.600 Tickets pro Stunde auf einer Instanz
Die neue Architektur basiert vollständig auf Standarddiensten von AWS. Eingehende Tickets landen zunächst in einer SQS-Queue, die eine Lambda-Funktion auslöst. Diese extrahiert die Nutzlast und ruft einen SageMaker-Endpunkt auf. Als Endpunkt dient eine Instanz des Typs ml.g5.xlarge, ausgestattet mit einer einzelnen NVIDIA A10G GPU mit 24 GB VRAM. Das Modell belegt rund 19 GiB Grafikspeicher und läuft in einem isolierten VPC-Subnetz ohne ausgehende Internetverbindung.
Die einzelne A10G-Grafikkarte bewies eine beachtliche Durchsatzstärke. Der Endpunkt bearbeitete einzelne Anfragen in durchschnittlich 640 ms, sodass eine einzige Recheninstanz stündlich etwa 5.600 Tickets abwickeln konnte. Der Cluster skaliert automatisch anhand der SQS-Warteschlangentiefe; Logs und Metriken fließen in Amazon CloudWatch. Die gesamte Infrastruktur ist über das AWS CDK definiert und in drei Veröffentlichungsphasen unterteilt: Beta, Gamma und Prod.
Um Risiken bei der Migration zu vermeiden, wurde ein dynamisches Feature-Flag über AWS AppConfig integriert, das von Lambda bei jeder Nachricht live abgefragt wird. Der Schalter unterstützt drei Betriebsmodi: BEDROCK leitet den gesamten Datenverkehr über Sonnet 4.6; im DUAL-Modus werden beide Modelle parallel aufgerufen und ihre Ergebnisse verglichen; im DECIDER-Modus übernimmt das spezialisierte Entscheidungsmodell vollständig die Produktion.
Diese Steuerung ermöglichte einen reibungslosen Übergang. Während der Dual-Phase wurden Tickets weiterhin nach den Ergebnissen von Sonnet verarbeitet, während im Hintergrund Abweichungen protokolliert und analysiert wurden. So konnte die Generalisierungsleistung unter realen Lastbedingungen verifiziert werden. Im Falle unerwarteter Fehler ließ sich die Pipeline über eine AppConfig-Aktualisierung innerhalb von 45 Sekunden auf das Altsystem zurücksetzen.
20.000 Dollar Ersparnis pro Million Tickets: Klare Grenzen für geschlossene Auswahlen
In der wirtschaftlichen Gegenüberstellung zeigte sich eine dramatische Diskrepanz. Beim alten Bedrock-Modell schlugen pro Million Tickets rund 22.200 US-Dollar zu Buche. Mit dem Wechsel zu festen SageMaker-Instanzen änderten sich die Kostenstrukturen grundlegend. Bei einem On-Demand-Preis von 1,408 US-Dollar pro Stunde in us-east-1 kostet die Verarbeitung von einer Million Tickets bei Vollauslastung lediglich 250 US-Dollar. Selbst mit einem zweifachen Puffer für Lastspitzen belaufen sich die Kosten auf etwa 500 US-Dollar pro Million Tickets – was rechnerisch 0,0005 US-Dollar pro Ticket entspricht.
Der Rückgang von 22.200 auf 500 US-Dollar entspricht einer Ersparnis von 98 % bzw. dem 44-fachen an Kosteneffizienz. Diese Zahlen basieren auf den vom Team veröffentlichten Benchmarks und offiziellen On-Demand-Preisen; die Einsparungen durch die um 74 % verkürzten Lambda-Laufzeiten sind darin noch nicht einmal eingerechnet. Für Plattformen mit jährlichen Ticketvolumina im dreistelligen Millionenbereich setzt eine solche Optimierung enorme Budgets frei.
Der Erfolg dieser Architektur hängt jedoch eng an ihren Rahmenbedingungen. Die Autoren betonen drei unverzichtbare Voraussetzungen: Es muss sich um eine geschlossene Auswahl aus einem festen Katalog handeln; das Ticketvolumen muss hoch genug sein, um die Fixkosten der Instanzen zu amortisieren; und die Latenz des bisherigen LLMs muss nachgelagerte Prozesse nachweislich behindert haben. Nur wenn diese drei Kriterien erfüllt sind, kann ein Entscheidungsmodell seine Stärken voll ausspielen.
Fehlen diese Voraussetzungen, stößt das Konzept an seine Grenzen. Wenn nachgelagerte Prozesse erklärende Texte verlangen, sich der Kategorienkatalog wöchentlich ändert oder der notwendige Kontext nicht in wenige tausend Tokens passt, bleibt das universelle LLM unverzichtbar. Die hohen Kosten universeller Sprachmodelle resultieren aus den immensen Freiheitsgraden für offene Textgenerierung. Wenn sich eine Aufgabe jedoch auf eine geschlossene Auswahl reduzieren lässt, ist die Abkehr von der autoregressiven Generierung zugunsten direkter Wahrscheinlichkeitswerte der pragmatischste Weg, um KI-Agenten wirtschaftlich zu skalieren.
Weiterführende Links:
- Strands Agents Blog: Amazon saves millions by replacing Sonnet 4.6 with Strands Decider
- Hacker News Diskussion: Amazon engineers swap Claude for decision model