Remplacer un grand modèle de pointe en production par un modèle compact s’accompagne d’ordinaire de compromis sévères sur les performances. Pourtant, au cœur du système de ticketing interne d’Amazon, les ingénieurs ont mené à bien une transition contre-intuitive. Claude Sonnet 4.6, jusque-là chargé du routage et de la classification, a été retiré du chemin critique. Pour lui succéder, ils ont déployé Strands Decider, un modèle de décision spécialisé ne comptant que 4 milliards de paramètres (4B). Le temps de traitement par ticket est tombé de 4 215 ms à 897 ms, tandis que le coût d’inférence pour un million de tickets s’est effondré de 22 200 $ à 500 $, soit une réduction spectaculaire de 98 %.
Cette baisse vertigineuse découle d’une remise en question fondamentale de la nature même des tâches de classification. Dans les architectures d’agents conventionnelles, le réflexe consiste à déléguer le tri à un LLM généraliste, en lui injectant des milliers de tokens de règles et en attendant qu’il décode la réponse mot à mot. Or, dans un problème de choix fermé à sélection unique, le système n’a besoin que de la probabilité associée à chaque étiquette, et nullement de texte conversationnel. En abandonnant le décodage autorégressif, la chaîne s’est affranchie du coût de transfert des consignes de formatage et a rendu obsolète toute étape d’analyse syntaxique du JSON de sortie.
Classification interne des tickets : 6 000 tokens consumés à chaque appel
Amazon exploite une infrastructure de ticketing monumentale. Le flux quotidien de requêtes couvre les montées de version, les extensions de capacité, les alertes d’incidents et les audits de conformité, pour finalement converger vers 20 catégories bien définies. Auparavant, cette charge incombait à Claude Sonnet 4.6 via Amazon Bedrock, retenu comme la référence assurant le juste équilibre entre capacités d’analyse et budget opérationnel.
Cependant, le modèle de facturation au token des LLMs généralistes pèse lourdement sur les pipelines à très haut débit. Pour contraindre le modèle à respecter scrupuleusement la taxonomie, chaque appel nécessitait l’injection d’un prompt système exhaustif détaillant les critères de démarcation des 20 catégories, assorti d’exigences strictes sur le format JSON de sortie. Les relevés de télémétrie ont montré qu’un ticket moyen mobilisait 6 554 tokens en entrée et 170 tokens en sortie, soit 6 724 tokens par exécution. L’immense majorité des ressources de calcul partait ainsi en pure perte dans la retransmission cyclique de contraintes de formatage identiques.
Le décodage autorégressif de ces volumes massifs bridait considérablement la réactivité : le traitement moyen d’un ticket par Claude oscillait autour de 4 215 ms. Une latence supérieure à 4 secondes entraînait un engorgement des nœuds consommateurs SQS en amont. Sur la base de la grille tarifaire publique de Bedrock, le coût de calcul brut s’élevait à 0,0222 $ par ticket, se traduisant par une facture exorbitante de 22 200 $ par million de tickets traités. Un fardeau financier qui a poussé l’équipe d’ingénierie à repenser l’architecture en profondeur.
Supprimer le pipeline de génération : distribuer les probabilités pour réduire la latence de 78 %
Face à une tâche de classification en univers clos, l’équipe s’est tournée vers le modèle de décision open source Strands Decider. À la différence des modèles autorégressifs classiques, cette architecture supprime la tête de modélisation linguistique pour la remplacer par une tête de pointage (Pointer Head) chargée d’attribuer un score aux options candidates. L’entrée se résume à l’état courant, à la question posée et à l’ensemble des options. Le modèle exécute une unique passe avant (forward pass) et délivre directement, via une fonction Softmax, la distribution de probabilité et le niveau de confiance de chaque choix.
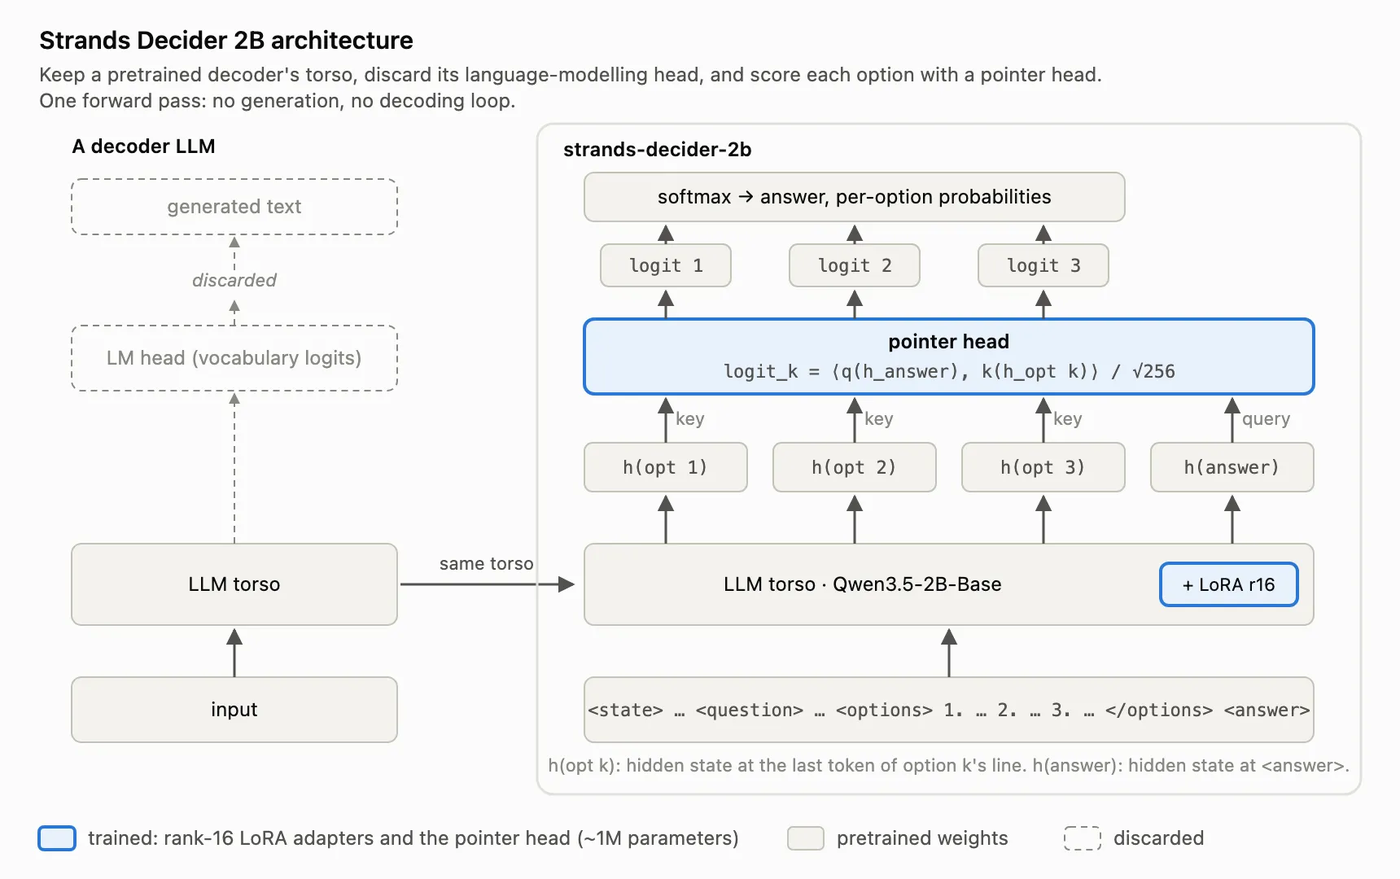 Figure : Strands Decider abandonne la tête générative autorégressive au profit d’une Pointer Head calculant le score des options candidates. Source : Strands Agents
Cette modification structurelle élimine la boucle d’échantillonnage de génération textuelle. L’inférence se limite à une passe avant unique, sans la latence inhérente au décodage token par token, et sans le risque qu’un JSON mal formé ne vienne bloquer l’analyse aval. Les bancs d’essai ultérieurs ont révélé que la version E4B, construite sur le socle Gemma 4, surpassait en précision de classification le Claude Sonnet 4.6 en production. L’équipe a donc validé l’entrée en production de la variante E4B.
L’épuration des entrées et des sorties s’est traduite par un bond de performance immédiat. Sur le même jeu de tests de tickets, la latence moyenne d’appel de Strands Decider E4B est tombée de 4 215 ms à 897 ms, marquant une baisse de 78 %. Le volume de tokens d’entrée par ticket est passé de 6 554 à 2 009, tandis que les tokens de sortie ont été réduits de 170 à un seul token représentant l’option retenue, soit une contraction globale de 70 % des tokens. Le jour de la bascule depuis Sonnet 4.6, la durée moyenne d’exécution des fonctions Lambda frontales a chuté de 74 %.
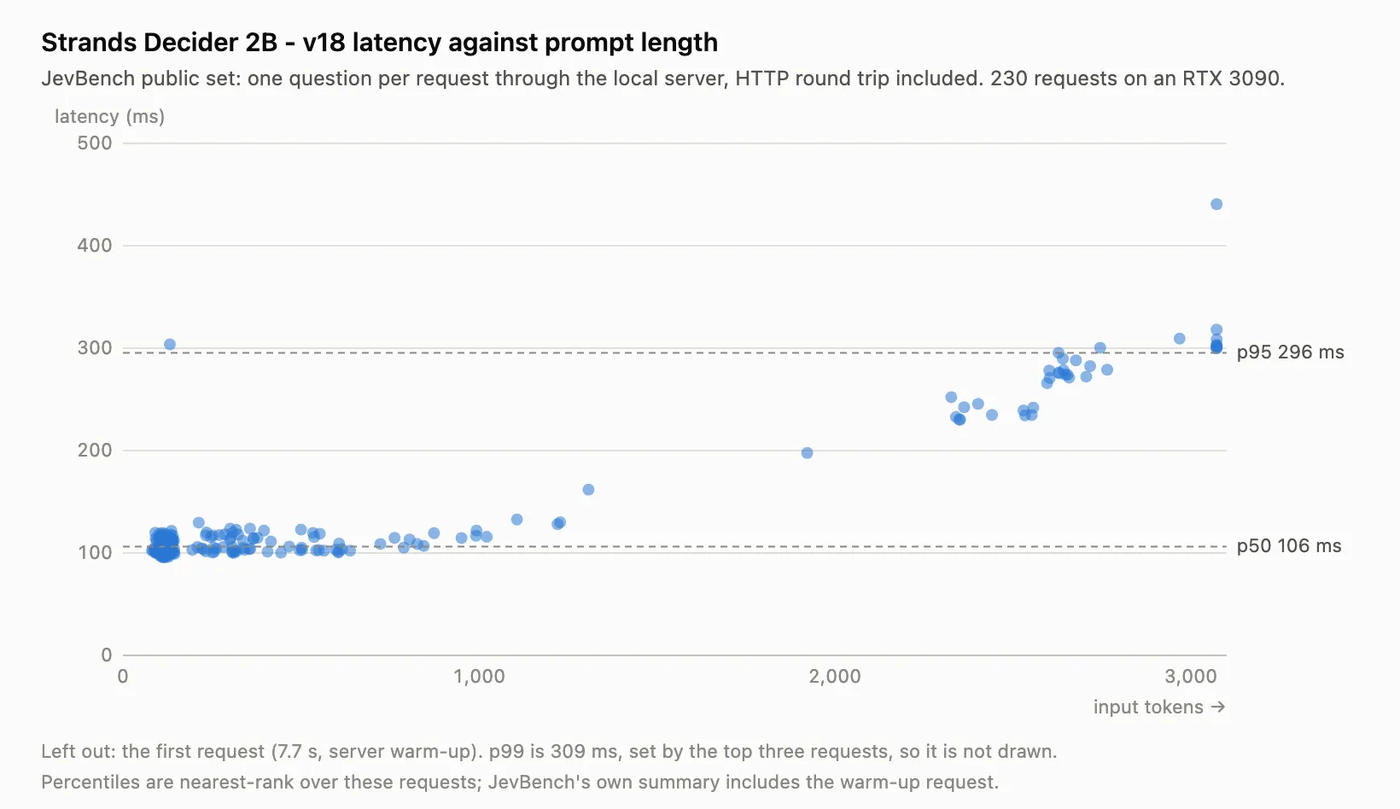 Figure : Profil de latence d’inférence de Strands Decider sur le banc de test, maintenant les allers-retours réseau et le calcul à un niveau minimal. Source : Strands Agents
Cette réduction de latence a immédiatement assaini l’utilisation des ressources du cluster serverless. La facturation des architectures de calcul sans serveur étant directement indexée sur le temps d’exécution, réduire le temps unitaire des trois quarts implique une diminution équivalente des quotas de concurrence Lambda nécessaires pour soutenir le même débit. Parallèlement, le temps de séjour dans les files d’attente est passé sous la seconde, dopant la réactivité globale du système face aux alertes de priorité critique.
Une fenêtre de 4 096 tokens impose des arbitrages : réécriture des critères et gel de l’ordre des clés
L’intégration d’un modèle de décision compact n’a pas été sans contraintes : la taille restreinte de la fenêtre de contexte constituait le premier obstacle technique. Strands Decider plafonne à 4 096 tokens de contexte. Or, en environnement réel, la description détaillée des 20 catégories accompagnée d’exemples dépassait à elle seule 4 000 tokens. Réutiliser le prompt d’origine aurait saturé l’espace disponible, ne laissant plus aucune marge pour injecter le contenu des tickets.
Les ingénieurs ont donc refondu l’ingénierie de prompt. Chaque catégorie a été condensée en une ou deux phrases de critères décisifs, structurées sous la forme d’un QCM à choix unique, complété en fin de liste par l’option d’exclusion « none ». Pour les tickets volumineux, le système élimine systématiquement les commentaires historiques les plus anciens, garantissant ainsi la préservation intégrale des statuts récents et des diagnostics d’incident cruciaux.
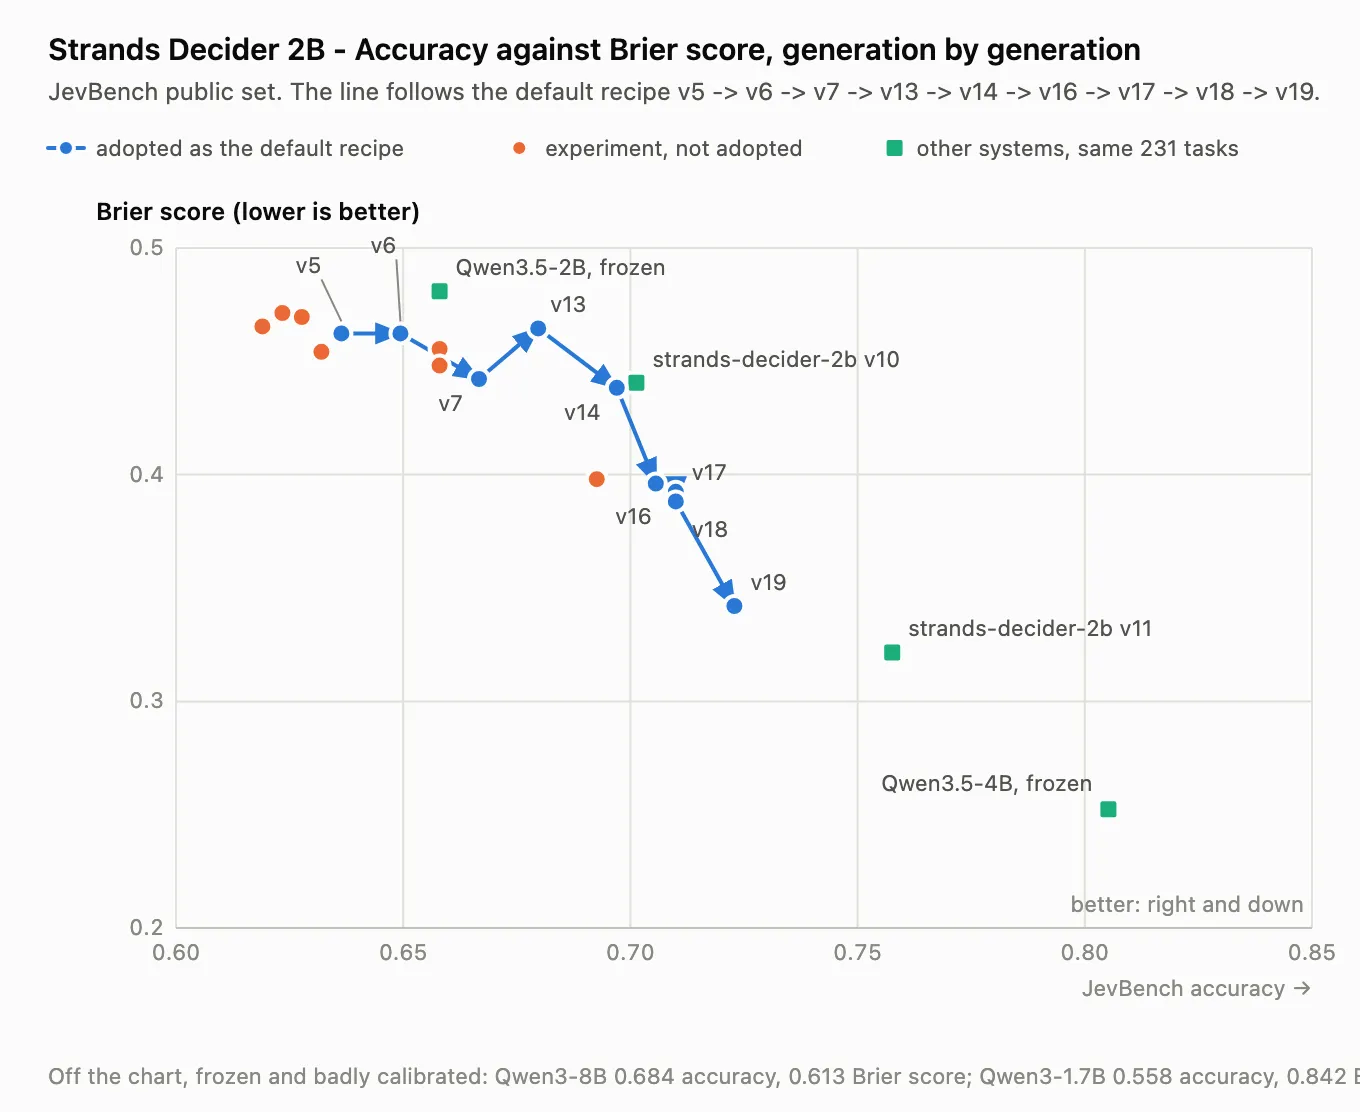 Figure : Évolution de la calibration des décisions et de la précision au fil des itérations, un score de Brier plus faible traduisant des probabilités plus fiables. Source : Strands Agents
Afin de garantir la fiabilité de l’étiquetage, le système a intégré un mécanisme de seuil de confiance. L’équipe a calibré en continu les courbes de probabilité pour réduire le score de Brier sur les trajectoires de décision. L’attribution automatique d’un label n’intervient que si l’option retenue dépasse ce seuil de confiance. Si la certitude est jugée insuffisante ou si le choix aboutit à « none », le ticket est immédiatement réorienté vers une revue humaine manuelle.
Lors de la phase de validation technique, les développeurs ont découvert une particularité sous-jacente tout à fait inattendue : l’ordre de sérialisation des clés JSON influençait les probabilités de décision. À valeurs strictement identiques, le simple fait de réordonner les clés provoquait une variation de la probabilité de sortie allant jusqu’à 0,19. Sur les cas limites, un tel écart suffisait à faire basculer le résultat de la classification. L’équipe a donc imposé un tri alphabétique strict des clés JSON sur toutes les entrées, neutralisant ainsi toute instabilité induite par l’ordre de sérialisation.
Bascule à trois états via AppConfig : 5 600 tickets traités par heure et par instance
Cette nouvelle architecture s’appuie intégralement sur les services cloud managés d’AWS. Les tickets arrivent d’abord dans une file Amazon SQS, déclenchant des fonctions Lambda qui extraient les métadonnées et interrogent un endpoint Amazon SageMaker. Cet endpoint s’exécute sur des instances ml.g5.xlarge, équipées d’un GPU NVIDIA A10G doté de 24 Go de VRAM. L’empreinte mémoire du modèle occupe environ 19 Gio de VRAM, le tout opérant au sein d’un réseau VPC isolé, privé de tout accès sortant vers Internet.
Une unique carte A10G a démontré un débit remarquable. L’endpoint traite chaque requête en approximativement 640 ms, permettant à une seule instance de calcul de traiter près de 5 600 tickets par heure. Le cluster adapte dynamiquement sa capacité selon la profondeur de la file SQS, tandis que journaux et métriques convergent vers CloudWatch. L’ensemble de l’infrastructure est géré par AWS CDK, articulé en trois étapes de déploiement : Beta, Gamma et Production.
Afin d’éviter tout basculement brutal risqué, le flux s’appuie sur des indicateurs dynamiques pilotés par AWS AppConfig, interrogés par les fonctions Lambda à chaque message. Ce commutateur autorise trois modes de fonctionnement : « BEDROCK », qui route l’intégralité du trafic vers Sonnet 4.6 ; « DUAL », mode miroir où les requêtes sont envoyées en parallèle aux deux modèles pour comparer les écarts en temps réel ; et « DECIDER », qui confie la totalité du flux de production au modèle spécialisé.
Ce déploiement progressif a offert un garde-fou opérationnel indispensable. En phase d’exécution parallèle, les tickets continuaient d’être routés d’après les décisions de Sonnet, pendant que les services d’arrière-plan analysaient les divergences. Cette comparaison en conditions réelles a permis de valider la robustesse et la généralisation du modèle face aux cas atypiques. En cas de comportement inattendu, une simple mise à jour dans AppConfig permettait de revenir à l’ancien pipeline en moins de 45 secondes.
20 000 $ d’économies par million de tickets : délimiter le périmètre des choix fermés
Sur le plan comptable, le rapprochement financier révèle un écart abyssal entre les deux approches. L’ancienne solution facturée à l’usage sur Bedrock coûtait 0,0222 $ par ticket, soit 22 200 $ par million d’unités. Le passage à des instances SageMaker dédiées a transformé cette dépense en coût machine fixe : au tarif à la demande de 1,408 $ l’heure sur us-east-1, traiter un million de tickets à pleine charge ne revient qu’à 250 $. Même en prévoyant une marge de sécurité de 100 % pour absorber les pics d’activité, la facture globale plafonne à environ 500 $ par million de tickets, soit à peine 0,0005 $ l’unité.
Passer de 22 200 $ à 500 $ par million de tickets représente une économie de 98 %, rendant l’opération 44 fois moins onéreuse. Ces données, issues des retours d’expérience partagés par l’équipe d’Amazon aux tarifs publics à la demande, ne comptabilisent même pas les économies serverless découlant de la baisse de 74 % du temps de calcul Lambda. Pour une organisation traitant des dizaines ou centaines de millions de requêtes par an, ce gain débloque des marges budgétaires majeures.
Cependant, la viabilité d’une telle transformation repose sur des conditions limites très précises. Dans son bilan, l’équipe d’ingénierie fixe des prérequis incontournables : la tâche doit être une sélection fermée parmi un catalogue préétabli, le volume de tickets doit être suffisant pour amortir le coût horaire des instances, et la latence de l’ancien modèle génératif devait constituer un véritable frein opérationnel. C’est uniquement lorsque ces trois critères sont réunis qu’un modèle de décision donne toute sa mesure.
Dès que l’on s’écarte de ce cadre, l’architecture perd sa pertinence. Si les processus aval exigent des synthèses argumentées, si les taxonomies évoluent chaque semaine ou si le contexte utile ne tient pas dans quelques milliers de tokens, les modèles de décision ne peuvent se substituer aux LLMs généralistes. Le coût élevé des grands modèles découle directement des degrés de liberté superflus conservés pour la génération de texte libre. Dès lors qu’une tâche métier se fige sous la forme d’un choix fermé, démanteler la machinerie autorégressive pour laisser un modèle dédié renvoyer directement des probabilités demeure le choix d’ingénierie le plus pragmatique pour déployer des agents à grande échelle.
Liens de référence :
- Blog officiel Strands Agents : Amazon saves millions by replacing Sonnet 4.6 with Strands Decider
- Discussion sur Hacker News : Amazon engineers swap Claude for decision model