本番稼働中のフロンティア大規模言語モデル(LLM)を軽量な小型モデルに置き換える作業には、通常トレードオフとしての性能劣化がつきまとう。しかしAmazon社内の基幹チケット処理システムにおいて、エンジニアチームは常識を覆す刷新を成し遂げた。これまで分類タスクを担っていたClaude Sonnet 4.6をメインパイプラインから外し、パラメータ規模わずか4B級の専用意思決定モデル「Strands Decider」へと切り替えたのである。1チケットあたりの処理時間は4,215ミリ秒から897ミリ秒へと短縮され、100万件処理ごとの推論コストは22,200ドルから500ドルへと約98%も激減した。
この劇的なコスト削減の鍵となったのは、分類タスクの本質に対する再検討である。一般的なAIエージェントアーキテクチャでは、何千トークンにも及ぶルール定義プロンプトを汎用LLMに入力し、1トークンずつ順次生成されるテキスト出力を待つ設計が定石と化していた。しかし閉じた選択肢から正解を選ぶ単一選択タスクにおいて、システムが求めているのは各ラベルの確率分布だけであり、テキストを逐次生成する必要は本来まったくない。自己回帰型のデコードを破棄したことで、プロンプト転送に伴うオーバーヘッドが消滅し、出力テキストに対する構文解析も不要となった。
1回の分類呼び出しに6,000トークンを消費していた社内チケットシステム
Amazonは日々膨大な社内運用チケットを処理している。次々と起票されるチケットは、システムのアップグレード、キャパシティ増強、障害アラート、監査対応など多岐にわたり、最終的に20種類の既定カテゴリへと振り分けられる。従来はこの処理をAWS Bedrock上のClaude Sonnet 4.6が担っており、知的能力とコストのバランスに優れた標準的な構成として運用されていた。
だが、汎用LLMの従量課金体系は高頻度の処理パイプラインにとって重い負担となっていた。モデルにルール通りの分類を徹底させるため、呼び出しごとに20カテゴリの厳密な判定基準を網羅したシステムプロンプトを注入し、厳格なJSON出力フォーマット制約を課す必要があったからだ。実測データによると、チケット1件あたり平均6,554入力トークン、170出力トークンを消費し、合計で6,724トークンに達していた。計算リソースの大半が、定型的なフォーマット制約を反復送信するためだけに消費されていたのである。
大量のトークンを1文字ずつ自己回帰的にデコードする処理はレスポンス速度を悪化させ、Claudeのチケット処理時間は平均4,215ミリ秒に達していた。4秒を超えるレイテンシは前段のSQSコンシューマーにおける並行処理の滞留を引き起こした。Bedrockの定価で試算すると、チケット1枚あたりの純粋なモデル推論コストは0.0222ドルとなり、100万枚処理するごとに22,200ドルの請求が発生する。この巨額のランニングコストが、チームをアーキテクチャ刷新へと踏み切らせた。
テキスト生成パイプラインの撤廃:確率分布の直接出力でレイテンシを78%圧縮
閉じた分類タスクの解決策として、チームはオープンソースの意思決定モデル「Strands Decider」に着目した。自己回帰型LLMとは異なり、このモデルは言語生成ヘッド(LM Head)を撤廃し、候補となる選択肢のスコアを計算する「ポインターヘッド(Pointer Head)」を採用している。モデルへの入力は現在の状態、質問、そして選択肢一覧のみで構成される。1回の順伝播(Forward Pass)でSoftmaxを計算し、各選択肢の確率分布と信頼度スコアを直接出力する仕組みだ。
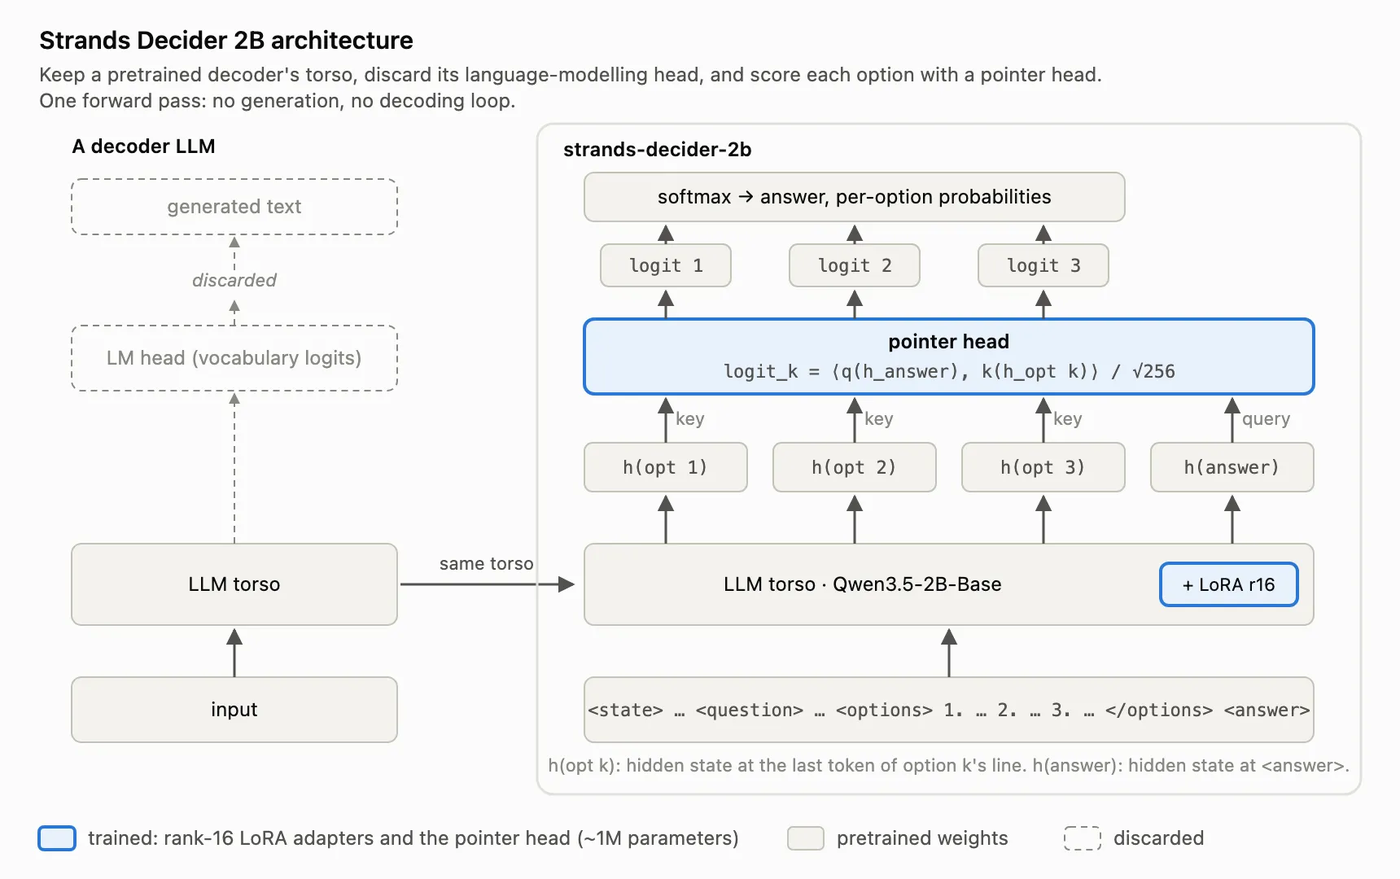 図:Strands Deciderは自己回帰型の言語生成ヘッドを廃止し、Pointer Headによって候補選択肢のスコアを算出する。出典:Strands Agents
この構造変更によって、テキスト生成時のサンプリングループが根底から解消された。推論全体が単一の順伝播で完了するため、逐次トークンを生成するデコード遅延が存在せず、不正なJSONフォーマットによるパースエラーの懸念も払拭された。その後の検証において、Gemma 4をベースに構築されたE4Bモデルの分類精度は、本番環境のClaude Sonnet 4.6を上回ることが確認された。チームは直ちにE4Bを本番環境へ投入することを決定した。
入出力の徹底的なスリム化は即座に性能向上をもたらした。同一の検証データセットにおいて、Strands Decider E4Bの平均処理時間は4,215ミリ秒から897ミリ秒へと78%短縮された。入力トークン数は6,554から2,009へと削減され、出力トークンは170から単一の選択肢を表す1トークンへと圧縮され、全体で70%のトークン削減を達成した。Sonnet 4.6の稼働を停止した当日、前段に位置するAWS Lambdaの平均実行時間は74%短縮された。
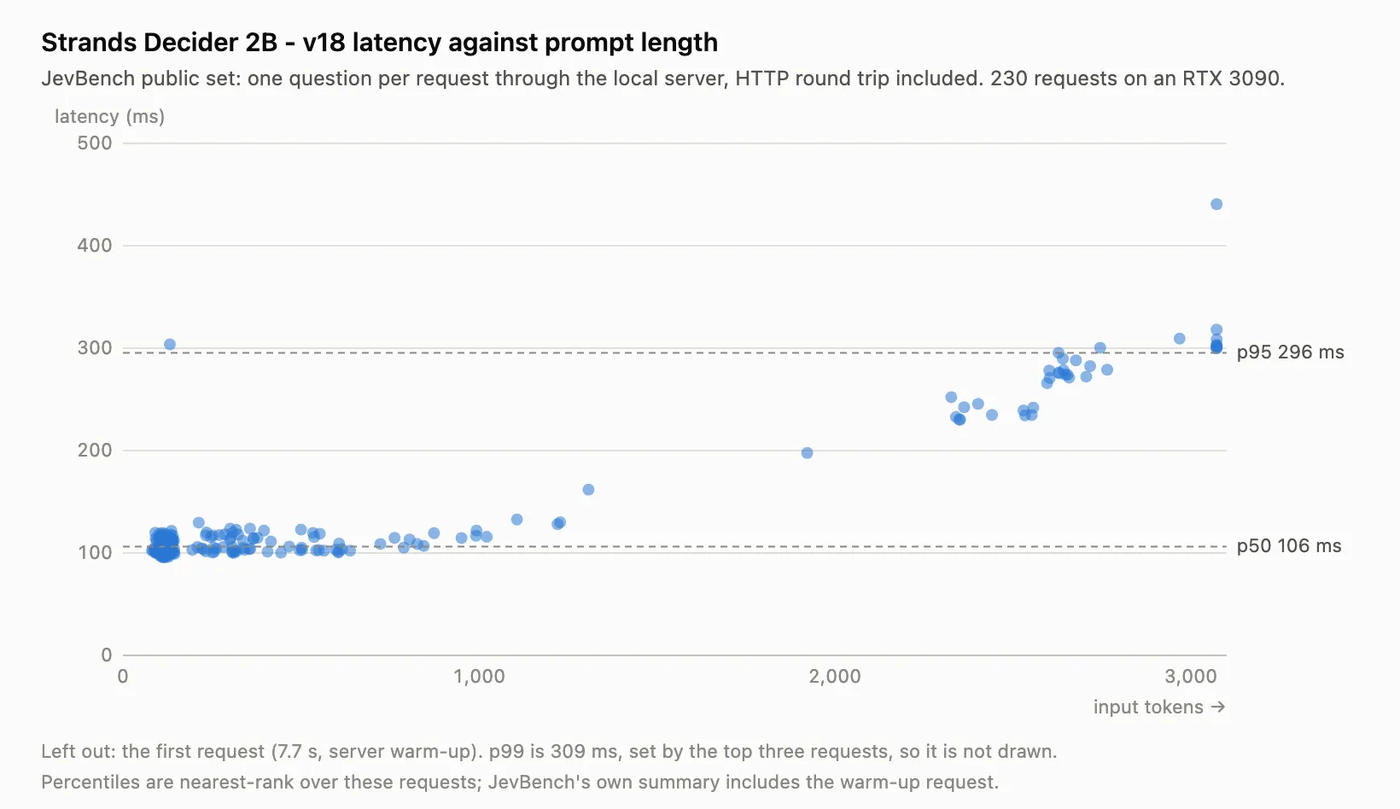 図:評価データセットにおけるStrands Deciderの推論レイテンシ分布。リクエストあたりのネットワーク往復と計算時間が低水準に維持されている。出典:Strands Agents
遅延の縮小はサーバーレスクラスタのリソース効率を劇的に改善した。LambdaなどのFaaS課金は実行時間に直結するため、処理時間を4分の1近くまで圧縮できたことは、同一のスループットを維持するために必要な同時実行クォータの削減を意味する。キューの滞留時間もサブ秒単位まで短縮され、緊急度の高い障害アラートに対する初動レスポンスが大幅に向上した。
4,096トークンの制約とエンジニアリングの工夫:プロンプト圧縮とキー順序の固定
小型の意思決定モデルの導入は、単なる差し替えだけで完了するほど単純ではなかった。限られたコンテキストウィンドウが最初の壁となったからである。Strands Deciderのコンテキスト長の上限は4,096トークンに設定されている。本番環境において、20カテゴリの詳細定義とfew-shot例示を並べるだけで4,000トークンを超えてしまい、従来のプロンプトをそのまま移植するとチケット本文を読み込む領域が残らない。
エンジニア陣はプロンプトエンジニアリングの再構築に着手した。各カテゴリの判定基準を1〜2文の簡潔なヒューリスティックへ凝縮し、多肢選択式の選択肢として再構成したうえで、末尾に除外用の選択肢「none」を追加した。また長文チケットに対しては、最も古い過去のコメント履歴を積極的にトリミングし、最新のステータスと障害の核心情報が確実に収まるよう制御した。
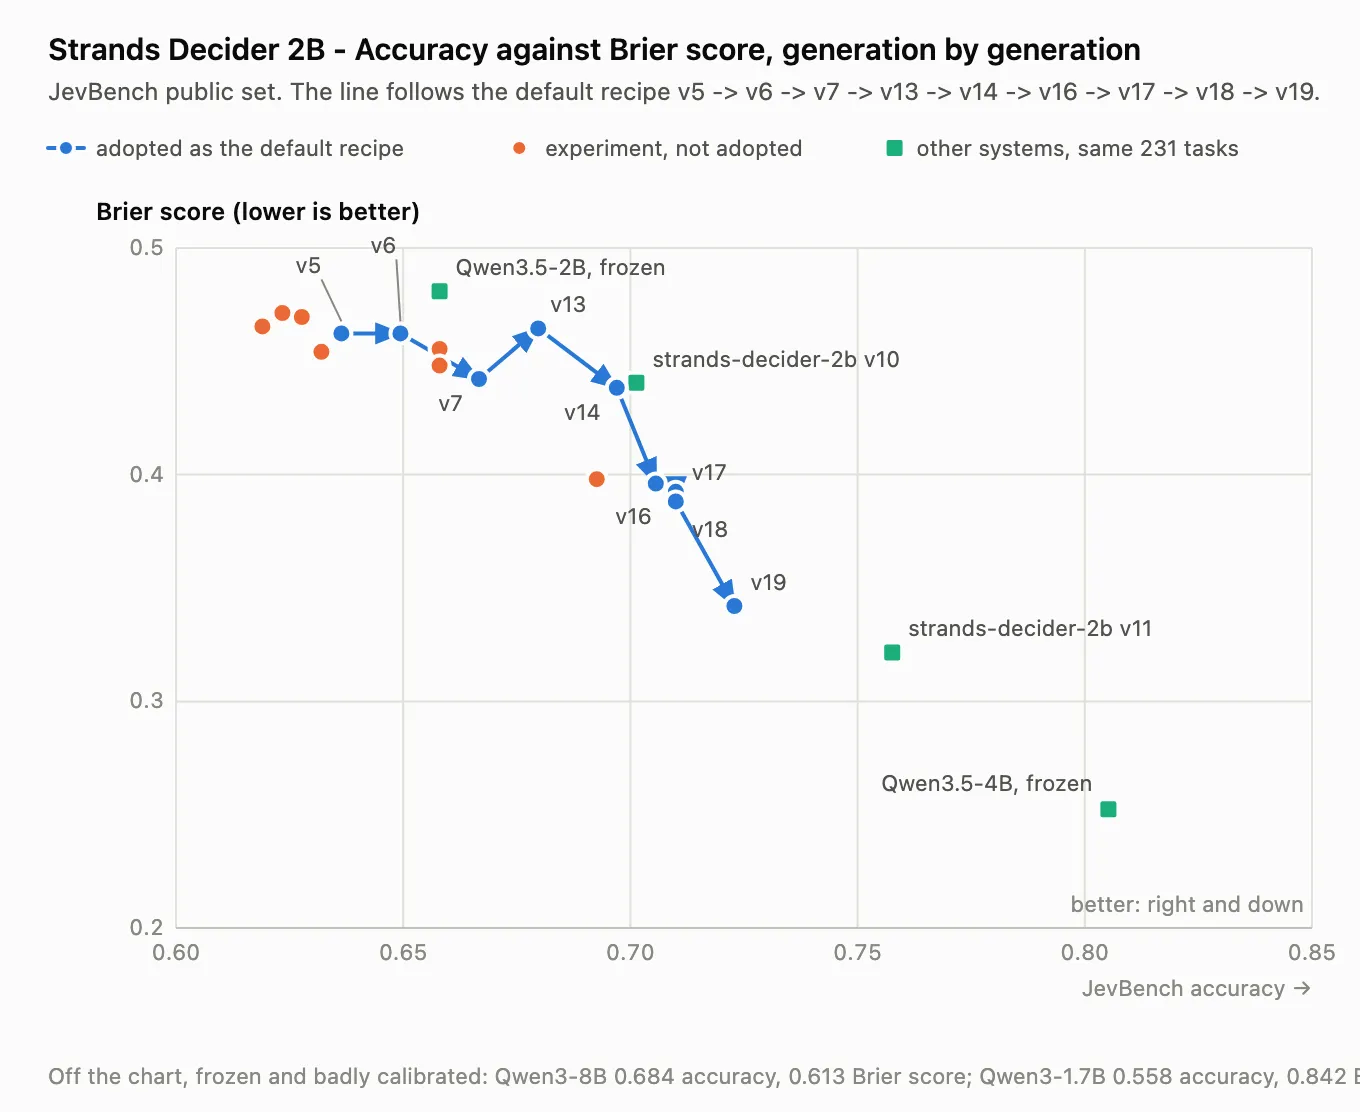 図:モデル反復に伴う決定キャリブレーションと精度の推移。Brierスコアが低いほど、確率推定の信頼性が高いことを示す。出典:Strands Agents
分類精度の安全性を担保するため、信頼度スコアの閾値制御も導入された。チームは確率曲線のキャリブレーションを継続して行い、意思決定軌跡におけるブライアスコア(Brier Score)を引き下げた。最有力候補の信頼度が閾値を超えた場合にのみ自動分類を実行し、信頼度が不足している場合や「none」と判定された場合は、チケットを人間のエンジニアによる確認フローへ自動ルーティングする設計とした。
結合テストの段階で、チームは直感に反する低レベルの挙動に直面した。JSONキーのシリアライズ順序によってモデルの判定結果が変化したのである。キーと値の内容が全く同一であっても、キーの並び順を変えるだけで出力確率が最大0.19もシフトした。境界線上にあるチケットでは、このズレが分類結果を反転させるのに十分な影響を及ぼした。チームはJSONキーをアルファベット昇順で厳密にソートする規約を設け、入力順序に起因する判断のブレを完全に排除した。
AppConfigによる3段階トラフィック制御:単一インスタンスで毎時5,600件を処理
新アーキテクチャはすべて標準的なAWSクラウドサービス上で構築されている。チケットはまずAmazon SQSキューへ入り、それをトリガーに起動したLambda関数がペイロードを抽出してAmazon SageMakerのエンドポイントを呼び出す。エンドポイントは単一の24GB GPU(NVIDIA A10G)を搭載した「ml.g5.xlarge」インスタンスを採用。モデルのVRAM専有量は約19 GiBで、外部インターネットへのアウトバウンド通信を持たない隔離されたVPCネットワーク内で動作する。
1枚のA10G GPUは十分なスループットを発揮した。エンドポイントにおける1リクエストあたりの処理時間は約640ミリ秒で、1台の計算インスタンスで1時間あたり約5,600件のチケットを処理できる。クラスタはSQSのキュー深度に応じて自動スケールし、ログとメトリクスはCloudWatchへ集約される。インフラ全体はAWS CDKを通じてコード化され、Beta、Gamma、Prodの3段階で安全にデプロイされる。
一括切り替えに伴う本番リスクを回避するため、AWS AppConfigによる動的機能フラグが組み込まれた。Lambdaはメッセージを処理するたびにこの設定値を参照する。フラグには3つの動作モードが定義された。全量をSonnet 4.6へ流す「BEDROCK」、両方のモデルを並行呼び出しして判定結果の差異を検証する「DUAL」、そして特化型モデルへ完全にトラフィックを委譲する「DECIDER」である。
このカナリア制御が安全な移行を支えた。DUALモード運用中、実際の処理はSonnetの結果に基づいて実行されつつ、裏で両モデルの判定差分が記録・分析された。本番トラフィックを用いたオンライン比較により、実環境におけるモデルの汎化性能が立証された。万一異常が検知された場合でも、AppConfigの設定を更新すれば45秒以内に旧パイプラインへロールバックできる体制が整えられた。
100万件で2万ドルのコスト差:閉じた選択タスクが示す適用境界
財務的なコスト比較において、新旧アーキテクチャの差は圧倒的だった。従前のBedrock構成ではチケット1件あたり0.0222ドル、100万件で約22,200ドルを要していた。特化型モデルへ移行してSageMakerインスタンス課金となった結果、us-east-1のオンデマンド単価(時間あたり1.408ドル)換算で、フル稼働時の100万件あたりコストはわずか250ドルとなった。トラフィック急増に備えて2倍のバッファを見積もったとしても、100万件あたり約500ドル、チケット1件あたり約0.0005ドルに収まる計算だ。
推論コストが2.2万ドルから500ドルへと縮小したことは、98%の削減、すなわち約44倍のコスト効率化を意味する。この試算はチームが公表した検証データと公開オンデマンド価格に基づくものであり、Lambdaの実行時間74%短縮によるサーバーレス課金の削減分はここに含まれていない。年間数億件のチケットを処理する巨大プラットフォームにとって、この改善がもたらすコスト削減効果は計り知れない。
ただし、このアーキテクチャの成功はタスク自体の前提条件に強く依存している。エンジニア陣は適用にあたって明確な境界条件を挙げている。すなわち「既知のカタログから選ぶ閉じた選択問題であること」「インスタンスの固定稼働コストを十分に希薄化できる大規模な処理量があること」「従来のLLMの遅延が下流の業務処理を実際にボトルネック化させていたこと」の3点である。これらの条件が揃って初めて、特化型モデルはその真価を発揮する。
逆にこれらの前提から外れた場合、この手法は適用できない。下流工程で説明文の生成が必要な場合、分類カタログが毎週のように変動する場合、あるいはコンテキストが数千トークンに収まりきらない場合には、汎用LLMの柔軟性が必要不可欠となる。汎用LLMが高コストなのは、本質的にオープンエンドなテキスト生成に対応するための広範な表現力を保持しているからだ。タスクが確定的な選択問題へと絞り込めるのであれば、自己回帰生成のパイプラインを切り落とし、特化型モデルから直接確率を出力させることこそが、AIエージェントを大規模にスケールさせる最も現実的な解法と言える。
参考リンク:
- Strands Agents 公式ブログ:Amazon saves millions by replacing Sonnet 4.6 with Strands Decider
- Hacker News コミュニティ議論:Amazon engineers swap Claude for decision model