把生产环境里的前沿大模型换成轻量小模型,通常伴随着性能妥协。但在 Amazon 内部的核心工单系统里,工程师完成了一次反直觉的替换。承接分类任务的 Claude Sonnet 4.6 被移出主链路,接替它的是参数规模仅有 4B 级别的专用决策模型 Strands Decider。单次工单处理耗时从 4,215 毫秒降至 897 毫秒,每百万张工单的调用开销从 22,200 美元降到 500 美元,降幅达到 98%。
这一断崖式降本的核心,来自对分类任务本质的重新审视。在常规的 Agent 架构中,系统习惯让大模型做分类,被迫输入数千 token 的规则提示词并等待模型逐字解码。在封闭单选任务中,系统只需要标签概率,无需多余的文本生成。抛弃自回归解码后,链路直接甩掉了提示词的传输开销,输出结果也不再需要额外的语法解析。
内部工单打标签,每次调用要烧掉六千 Token
Amazon 运维着庞大的工单系统。每天涌入的工单涵盖升级、扩容、告警与审计,最终归入 20 个既定类别。此前这项工作由 Bedrock 上的 Claude Sonnet 4.6 负责,充当着平衡智力与成本的基准选型。
通用大模型的计费机制给高频流水线带来了沉重负担。为了让模型严格按规则分类,每次调用都要注入一套详尽列出 20 个类别边界准则的系统提示词,并附带严苛的 JSON 输出格式约束。实测数据显示,平均每张工单消耗 6,554 个输入 token 和 170 个输出 token,合计达到 6,724 个 token。绝大多数计算资源,都被浪费在重复传输格式约束上。
海量 token 的自回归解码拖慢了响应速度,Claude 处理单张工单的平均耗时高达 4,215 毫秒。4 秒以上的延迟显著增加了 SQS 消费节点的并发堆积。按照 Bedrock 刊例价核算,处理单张工单的纯模型成本为 0.0222 美元,每百万张工单就要支付 22,200 美元账单。高昂的开销迫使团队寻求架构改变。
砍掉生成管道:输出概率分布把单次延迟压降 78%
面对封闭分类任务,团队转向了开源的决策模型 Strands Decider。区别于自回归大模型,该模型移除了语言建模头,改用指针头(Pointer Head)计算候选选项得分。输入仅包含当前状态、问题和一组选项。模型只做单次前向传播,通过 Softmax 直接输出每个选项的概率分布与置信度。
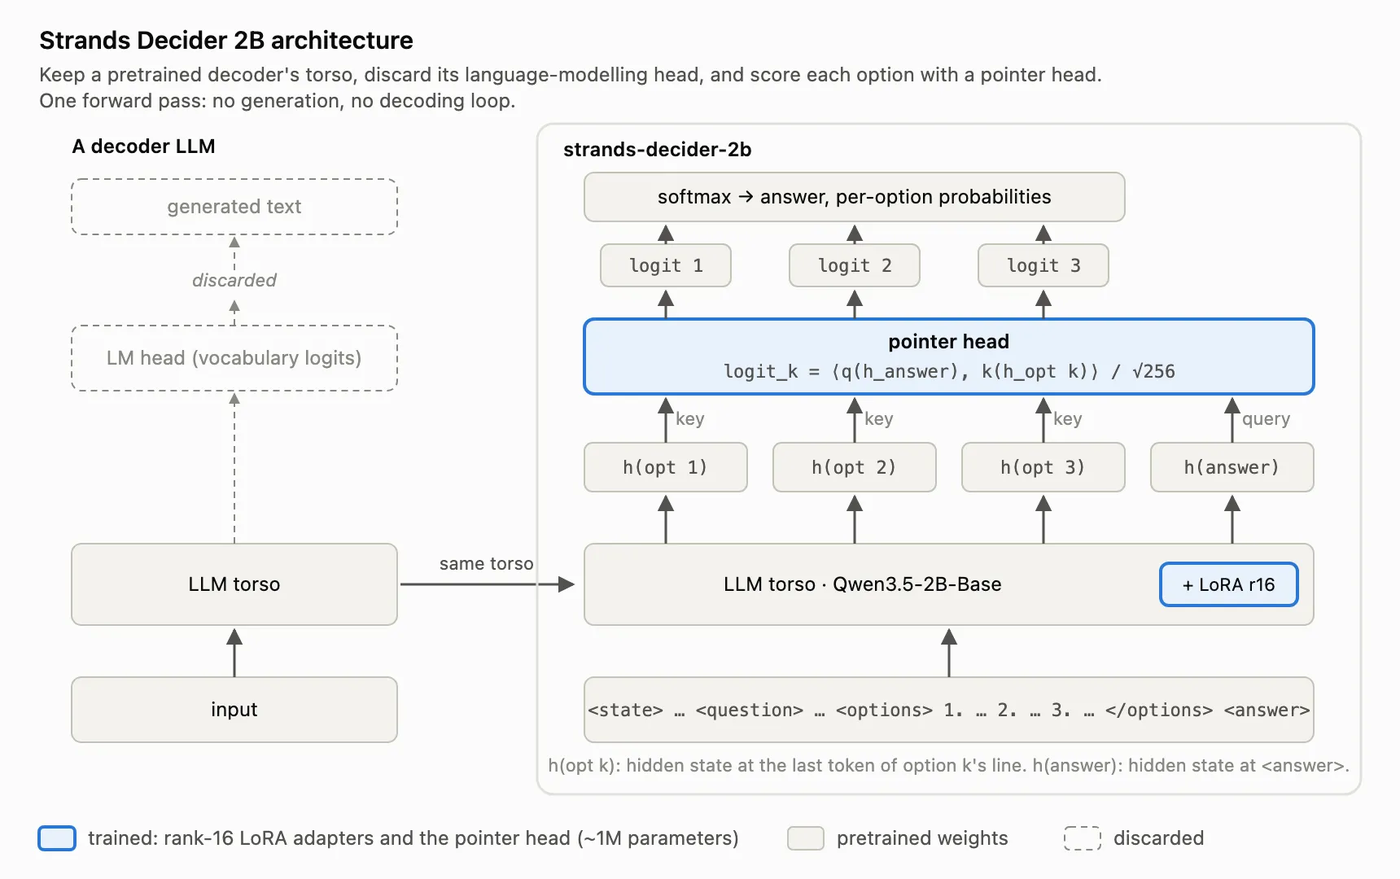 图:Strands Decider 抛弃自回归语言生成头,改用 Pointer Head 对候选选项计算得分。来源:Strands Agents
这一结构调整消除了文本生成的采样循环。推理全程只有单次前向计算,没有逐字吐出 token 的解码延迟,系统也无需担心非法 JSON 破坏解析。随后的评估表明,基于 Gemma 4 构建的 E4B 版本分类精度超过了线上的 Claude Sonnet 4.6。团队最终选定 E4B 进入生产环境。
精简输入与输出带来了直接的性能跨越。在相同工单测试集上,Strands Decider E4B 的平均调用耗时从 4,215 毫秒降至 897 毫秒,缩减了 78%。每张工单的输入 token 从 6,554 降至 2,009,输出 token 从 170 减为单一选项的 1 个 token,整体 token 下降 70%。关停 Sonnet 4.6 当天,前端 Lambda 平均执行时长下降了 74%。
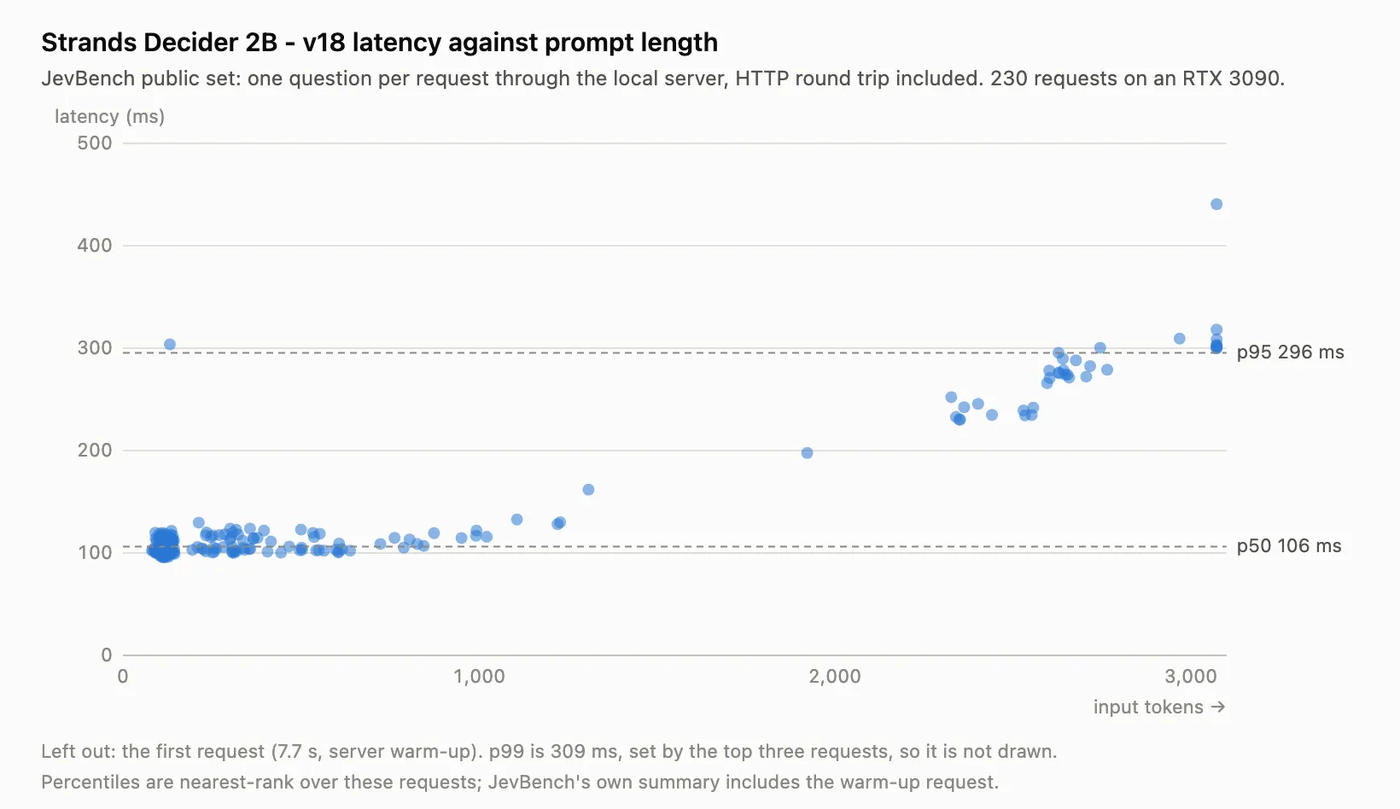 图:Strands Decider 在测试集中的推理延迟表现,单次请求网络往返与计算耗时保持在低水平。来源:Strands Agents
延迟削减改善了无服务器集群的资源利用率。函数计算的计费与运行时长直接挂钩,单次耗时压缩四分之三,意味着支撑相同吞吐所需的 Lambda 并发配额同步降低。同时,队列积压周期降至亚秒级。系统对高优先级告警的响应速度获得了直接提升。
4096 窗口逼出工程取舍:重写准则并锁死键序
引入小型决策模型并非开箱即用,有限的上下文窗口构成了第一道约束。Strands Decider 的上下文长度上限为 4,096 token。在生产环境中,20 个类别的详细定义与样例加起来就超过了 4,000 token,直接照搬原有提示词将挤占工单的读取空间。
工程师为此重构了提示词工程。团队将每个类别压缩成一到两句判定准则,整理为单选题选项,末尾附加一个排除选项「none」。针对长工单,系统主动丢弃最老的历史评论。这样能确保最新状态与核心故障信息完整留存。
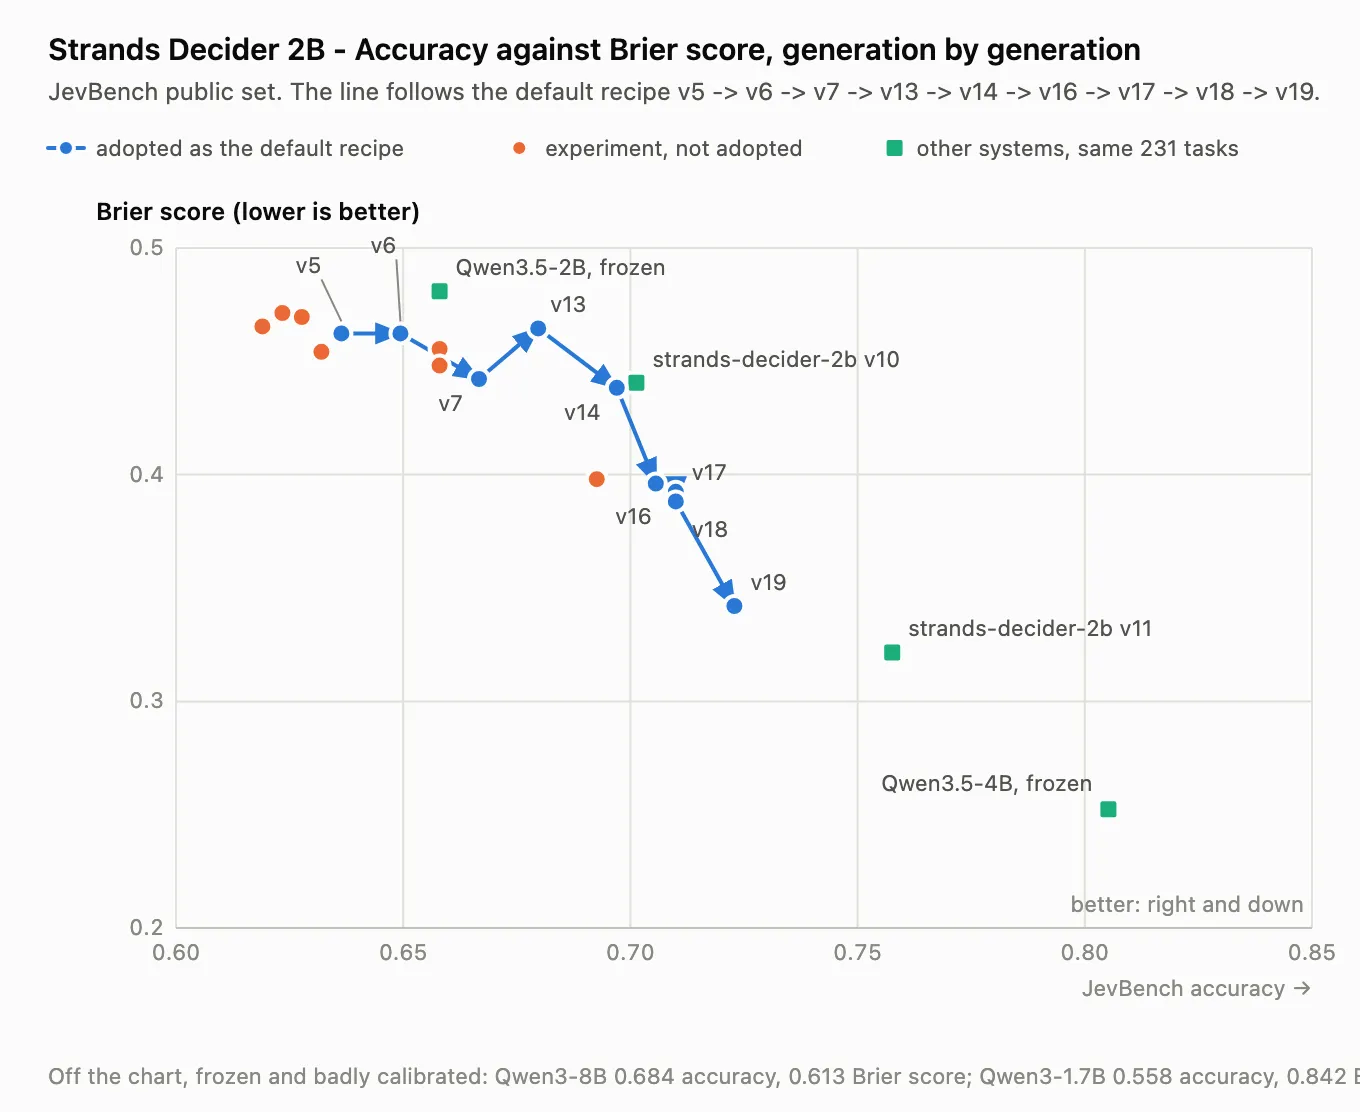 图:模型迭代过程中决策校准度与准确率的演进,Brier 分数越低代表概率越可信。来源:Strands Agents
为了保证标注质量,系统引入了置信度阈值机制。团队持续校准概率曲线,压低决策轨迹中的 Brier 分数。只有当最优选项的置信度超过阈值,系统才会自动打标。如果置信度不足或判定为「none」,工单便会自动流转至人工排查。
在联调阶段,团队遇到了一个反直觉的底层特性。JSON 键的序列化顺序会改变判定结果,在键值内容相同的情况下,调整键的先后顺序导致输出概率最大偏移达到了 0.19。对于临界工单,这一偏移足以改写分类结果。团队随后强制按字母正序排列 JSON 键,排除了输入顺序引起的决策抖动。
AppConfig 切换三态:单实例每小时吞吐 5600 张工单
这套新架构全部基于 AWS 标准云服务搭建。工单首先进入 SQS 队列,随后触发 Lambda 函数提取内容并调用 SageMaker 模型端点。端点采用 ml.g5.xlarge 规格,搭载单张 24GB 显存的 A10G 显卡。模型占用约 19 GiB 显存,实例运行在无外网出站权限的隔离网络中。
单张 A10G 显卡展现出了可观的吞吐能力。端点处理单个请求约耗时 640 毫秒,一台计算实例每小时可处理约 5,600 张工单。集群根据 SQS 队列深度自动扩缩容,日志与指标接入 CloudWatch。整套基础设施通过 AWS CDK 部署,划分为 Beta、Gamma 与 Prod 三个发布阶段。
为了避免直接切流引入风险,系统接入了 AppConfig 动态开关,Lambda 处理每条消息时都会读取这一配置。开关支持三种运行模式:「BEDROCK」仅走 Sonnet 4.6;「DUAL」双跑模式下两端并行调用并比对差异;「DECIDER」模式则全量交由决策模型接管。
灰度开关为平稳过渡提供了可靠机制。在双跑阶段,工单仍按 Sonnet 结果落地,系统后台记录两者的差异并深入比对。这种在线对照让开发人员在真实流量下验证了模型的泛化表现。一旦出现异常,更新 AppConfig 配置即可在 45 秒内切回旧链路。
百万工单省下两万美元,封闭选择划出适用边界
在财务账本上,新旧方案形成了悬殊的成本对比。原方案按 Bedrock 计费,单张工单调用成本为 0.0222 美元,百万工单耗资约 22,200 美元。换用决策模型后转为按 SageMaker 实例计费,以 us-east-1 每小时 1.408 美元的按需单价计算,满载处理百万工单仅需 250 美元。即便为突发流量预留一倍冗余,每百万张工单也仅支出约 500 美元,单工单成本折合约 0.0005 美元。
百万工单成本从 2.2 万美元降到 500 美元,降幅达到 98%,便宜了约 44 倍。这是基于团队博客公布的自测数据,按照公开按需单价核算,尚未计入 Lambda 运行时长缩短 74% 带来的额外无服务器节省。对于年处理量上亿的平台,这一改动释放了可观的预算空间。
但这项改造能够成功,取决于任务本身的边界条件。作者在总结中给出了清晰的适用前提:任务必须是从已知目录里做封闭选择,工单规模要足够大以摊薄实例的固定机时成本,且旧链路的高延迟切实拖慢了下游业务。具备这三项条件,决策模型才能平稳发挥效用。
脱离了这些前提,方案便不再适用。如果下游流程需要解释性文字,目录每周都在变动,或者有效上下文无法塞进数千 token,决策模型就无法替代通用 LLM。通用大模型的昂贵,本质上来自开放生成所保留的多余自由度。当任务已经固化为封闭选择,剥离自回归生成管道,让专用模型直接输出选项概率,才是 Agent 规模化落地中最务实的解法。
参考链接:
- Strands Agents 官方博客:Amazon saves millions by replacing Sonnet 4.6 with Strands Decider
- Hacker News 社区讨论:Amazon engineers swap Claude for decision model