Sustituir un modelo fundacional de vanguardia por un modelo ligero en entornos de producción suele conllevar pérdidas de rendimiento considerables. Sin embargo, en el núcleo del sistema interno de gestión de incidencias de Amazon, los ingenieros completaron una migración contraria a la intuición: Claude Sonnet 4.6, encargado de las tareas de clasificación y enrutamiento, fue retirado de la ruta crítica. En su lugar entró Strands Decider, un modelo de decisión especializado de apenas 4.000 millones de parámetros (4B). El tiempo de procesamiento por ticket se desplomó de 4.215 ms a 897 ms, mientras que el coste de inferencia por cada millón de tickets cayó de 22.200 dólares a unos 500 dólares, lo que supone un recorte del 98%.
Este descenso radical del coste se originó en un replanteamiento profundo sobre la naturaleza de la tarea de clasificación. En las arquitecturas convencionales de agentes, es habitual delegar la clasificación en modelos de lenguaje de propósito general, forzándolos a ingerir miles de tokens de directrices normativas y esperando una decodificación autorregresiva palabra por palabra. No obstante, en una tarea cerrada de selección única, el sistema solo necesita la distribución de probabilidades de las etiquetas, no una generación de texto innecesaria. Al descartar la decodificación autorregresiva, se eliminó de golpe la sobrecarga de transmitir extensos prompts de formato, prescindiendo por completo del análisis sintáctico de JSON posterior.
Etiquetado interno de tickets: seis mil tokens consumidos en cada llamada
Amazon opera una infraestructura masiva de tickets de soporte técnico. El caudal diario incluye solicitudes de actualización, ampliación de capacidad, alarmas de monitorización y auditorías de cumplimiento, que deben clasificarse en 20 categorías predeterminadas. Hasta ahora, este trabajo recaía en Claude Sonnet 4.6 alojado en Amazon Bedrock, considerado la opción de referencia para equilibrar inteligencia y coste operativo.
Sin embargo, el modelo de tarificación por token de los LLM generalistas impuso un lastre asfixiante sobre los flujos de alta frecuencia. Para forzar al modelo a cumplir con las normas de categorización, cada invocación requería inyectar un prompt de sistema minucioso que detallaba las fronteras de las 20 categorías, acompañado de estrictas restricciones de formato JSON. Los datos de telemetría en producción revelaron que cada ticket consumía una media de 6.554 tokens de entrada y 170 tokens de salida, sumando un total de 6.724 tokens. La gran mayoría de los recursos de cómputo se desperdiciaba en retransmitir una y otra vez esquemas estáticos de formato.
La decodificación autorregresiva sobre miles de tokens ralentizaba los tiempos de respuesta: el tiempo medio que Claude tardaba en procesar un ticket alcanzaba los 4.215 ms. Una latencia superior a los cuatro segundos provocaba atascos de concurrencia en los nodos consumidores de SQS. Según las tarifas oficiales de Bedrock, el coste de inferencia pura por ticket era de 0,0222 dólares, lo que generaba una factura de 22.200 dólares por cada millón de tickets procesados. Este elevado gasto forzó al equipo a buscar una transformación radical de su arquitectura.
Supresión del flujo de generación: la distribución de probabilidades reduce la latencia un 78%
Ante una tarea de clasificación puramente cerrada, el equipo apostó por Strands Decider, un modelo de decisión de código abierto. A diferencia de los LLM autorregresivos, este modelo prescinde del cabezal de modelado de lenguaje causal (LM Head) e incorpora un Pointer Head para calcular las puntuaciones de las opciones candidatas. La entrada contiene únicamente el estado actual, la pregunta y la lista de opciones. En una única propagación hacia adelante (Forward Pass), el modelo calcula una función Softmax y emite directamente la distribución de probabilidades y la confianza de cada opción.
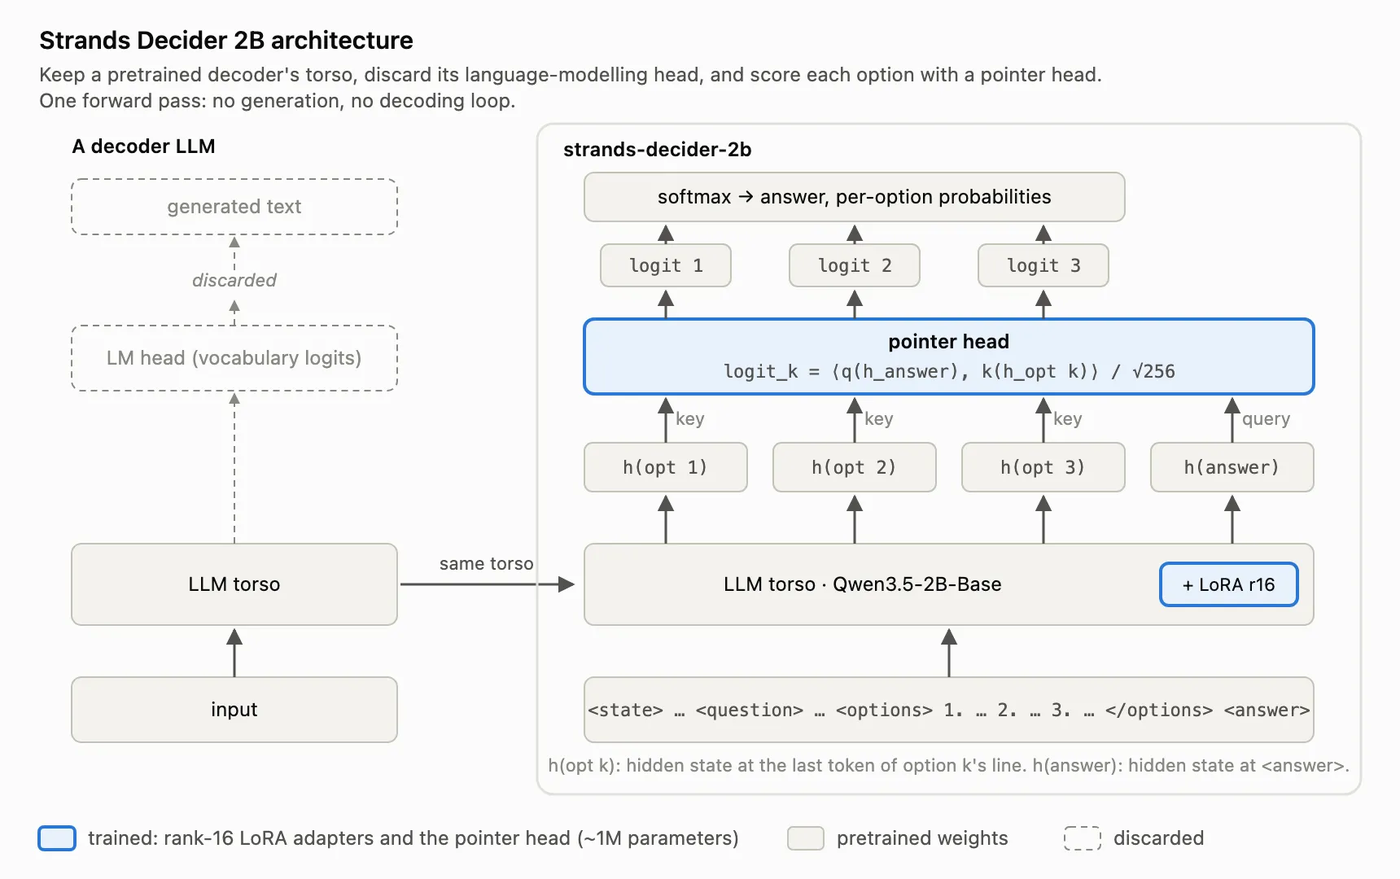 Figura: Strands Decider elimina el cabezal de generación autorregresiva y utiliza un Pointer Head para puntuar las opciones candidatas. Fuente: Strands Agents
Este cambio estructural suprimió por completo el bucle de muestreo propio de la generación de texto. Al ejecutarse toda la inferencia en un único paso hacia adelante, desaparece el retardo de decodificación secuencial, eliminando al mismo tiempo el riesgo de errores de análisis debidos a formatos JSON mal formados. Las evaluaciones posteriores demostraron que la variante E4B, construida sobre Gemma 4, superaba en precisión de clasificación al Claude Sonnet 4.6 en producción. El equipo aprobó de inmediato el despliegue del modelo E4B.
La depuración de entradas y salidas impulsó el rendimiento de inmediato. Sobre el mismo conjunto de datos de prueba, la latencia media de Strands Decider E4B pasó de 4.215 ms a 897 ms, reduciéndose un 78%. El volumen de entrada cayó de 6.554 a 2.009 tokens por ticket, mientras que la salida se comprimió de 170 tokens a un único token correspondiente a la opción elegida, lo que representó un descenso global del 70% en el consumo de tokens. El mismo día en que se desactivó Sonnet 4.6, el tiempo medio de ejecución de las funciones AWS Lambda de entrada se redujo un 74%.
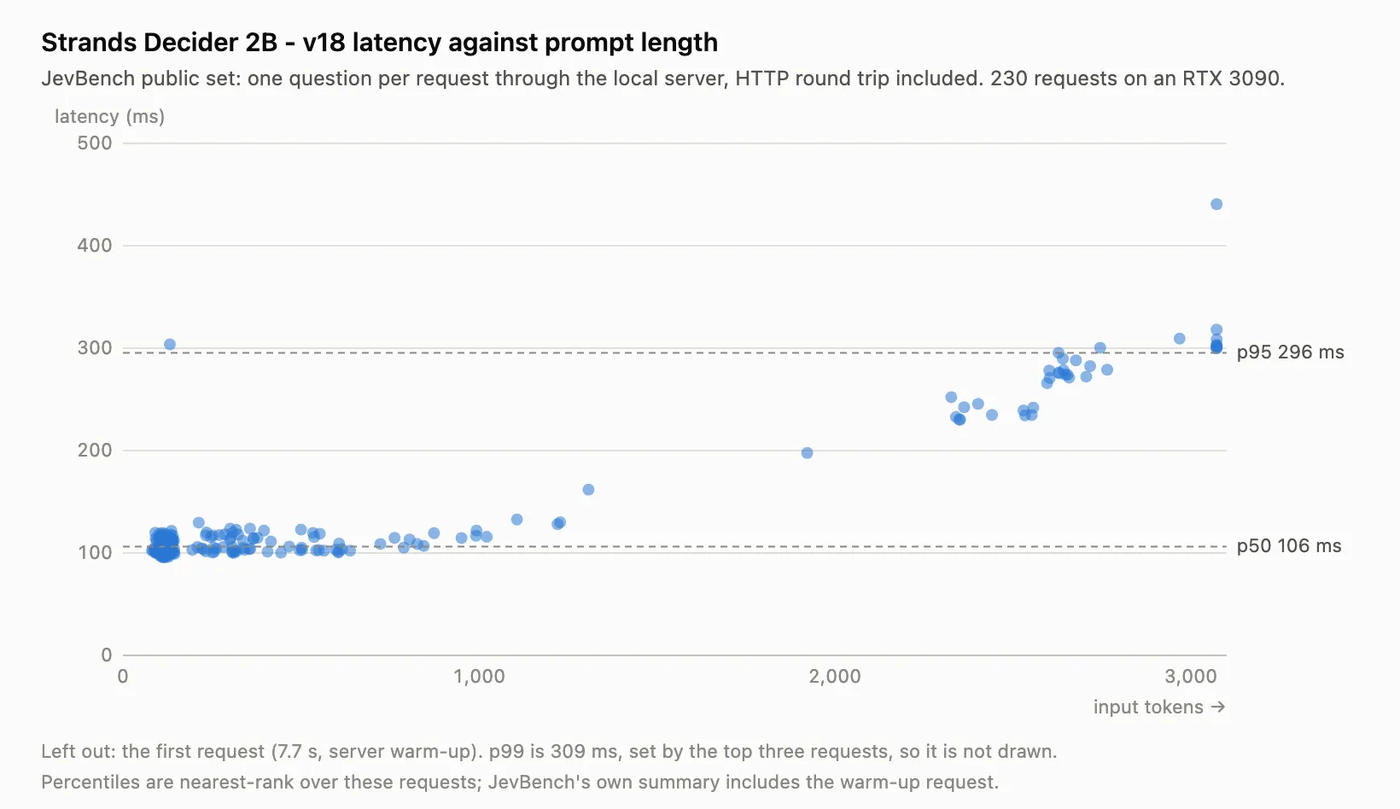 Figura: Distribución de latencia de inferencia de Strands Decider en el conjunto de evaluación, demostrando tiempos de cálculo y de red extraordinariamente bajos. Fuente: Strands Agents
El recorte en la latencia optimizó notablemente la eficiencia del clúster sin servidor. La facturación de los servicios FaaS como Lambda depende directamente del tiempo de cómputo; recortar la duración a una cuarta parte implicó que la cuota de concurrencia necesaria para sostener el mismo rendimiento se redujera en idéntica proporción. Los tiempos de espera en las colas cayeron por debajo del segundo, acelerando sensiblemente la respuesta ante alarmas operativas prioritarias.
El límite de 4.096 tokens exige precisión: síntesis de reglas y orden fijo en claves JSON
La adopción de un modelo de decisión compacto no fue una simple sustitución directa; la reducida ventana de contexto impuso el primer gran desafío técnico. Strands Decider tiene un límite superior de contexto de 4.096 tokens. En el entorno original, las descripciones minuciosas y los ejemplos para las 20 categorías superaban por sí solos los 4.000 tokens, de modo que trasladar el prompt original no dejaba espacio alguno para el texto del ticket.
Los ingenieros tuvieron que reescribir por completo la ingeniería de prompts. El equipo sintetizó cada categoría en una o dos reglas heurísticas concisas, las organizó como opciones de respuesta múltiple y añadió al final una alternativa de exclusión denominada none. En el caso de tickets extensos, el sistema descartó sistemáticamente los comentarios más antiguos, asegurando que el estado operativo más reciente y la información crítica del fallo permanecieran intactos.
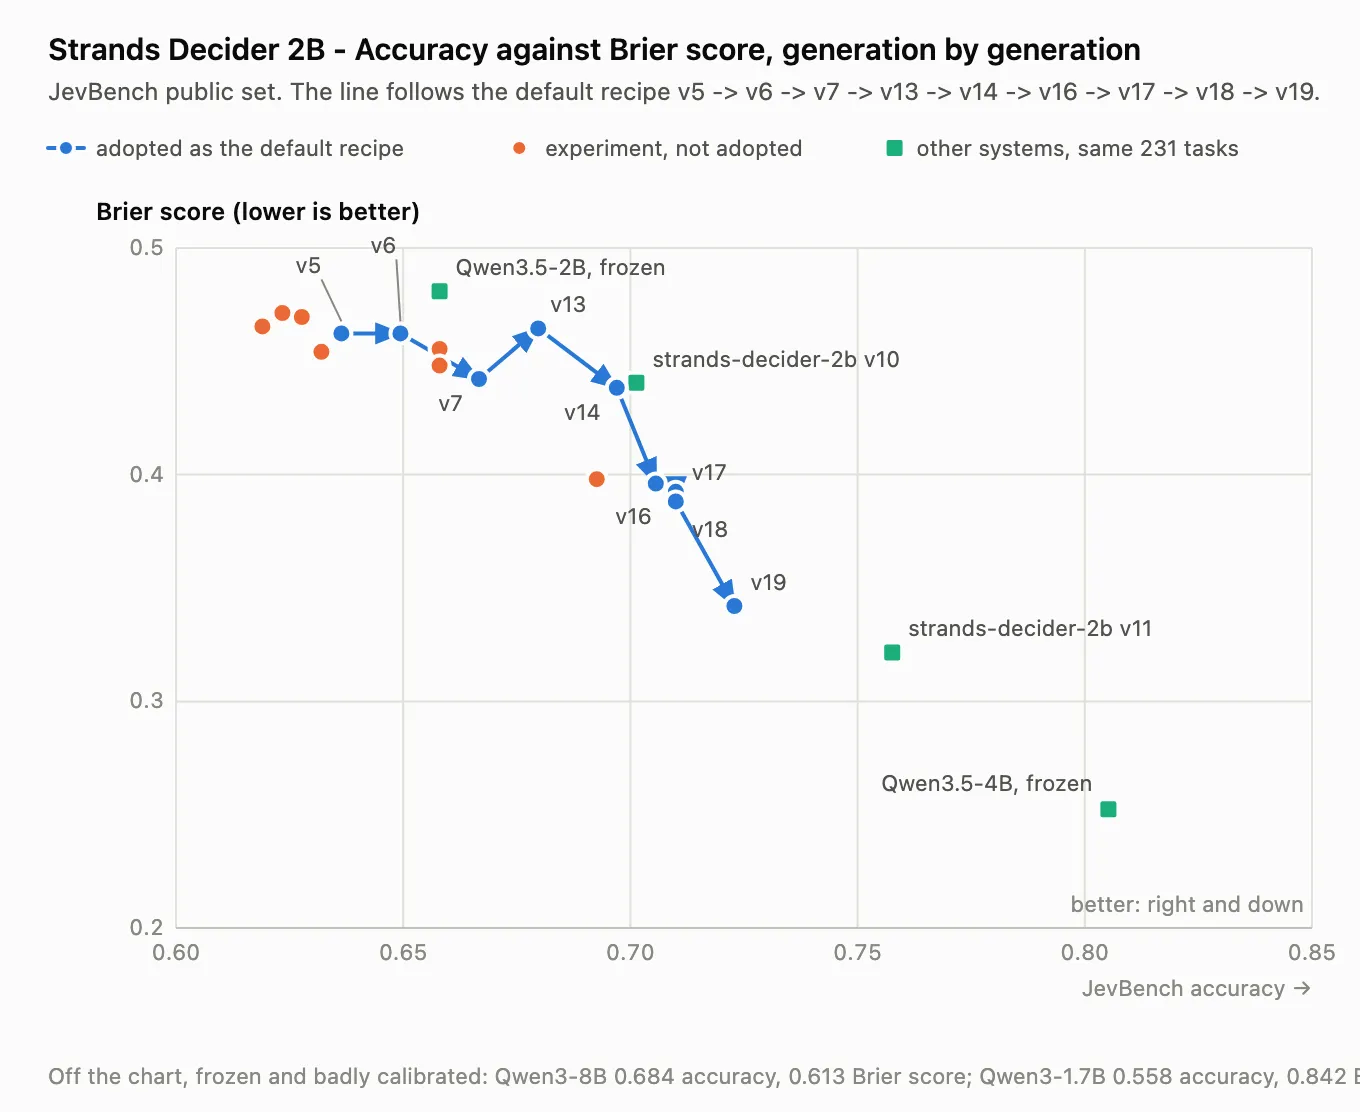 Figura: Evolución de la calibración de decisiones y la precisión en las distintas iteraciones del modelo; una puntuación de Brier más baja indica probabilidades más fiables. Fuente: Strands Agents
Para asegurar la calidad del etiquetado, se implementó un mecanismo de umbral de confianza. El equipo calibró continuamente las curvas de probabilidad, rebajando el Brier Score en el proceso decisorio. El sistema solo aplica la etiqueta automática si la confianza de la mejor opción supera el umbral fijado. Si la confianza es insuficiente o se determina como none, el ticket se desvía de forma automática para su revisión manual por ingenieros de soporte.
Durante la fase de integración, el equipo descubrió un comportamiento inesperado a bajo nivel: el orden de serialización de las claves en el JSON modificaba el resultado de la clasificación. Con exactamente los mismos pares clave-valor, limitarse a alternar el orden de las claves provocaba un desplazamiento de la probabilidad de salida de hasta 0,19. En incidencias situadas en el umbral de decisión, este desfase bastaba para invertir el diagnóstico. A raíz de esto, el equipo impuso una ordenación alfabética estricta para todas las claves JSON de entrada, eliminando cualquier fluctuación originada por el orden de los datos.
Transición en tres fases con AppConfig: 5.600 tickets por hora en una sola instancia
La nueva arquitectura se apoya íntegramente en servicios nativos de AWS. Los tickets entran en una cola SQS, activando funciones Lambda que extraen el contenido y llaman al punto de conexión del modelo en Amazon SageMaker. El endpoint utiliza una instancia ml.g5.xlarge, dotada de una única GPU NVIDIA A10G de 24 GB de VRAM. El modelo consume aproximadamente 19 GiB de memoria de vídeo y opera dentro de una subred de VPC aislada sin acceso a internet hacia el exterior.
Una sola tarjeta A10G demostró una notable capacidad de rendimiento. El endpoint resolvió cada solicitud en unos 640 ms, lo que permitió que una única instancia procesara alrededor de 5.600 tickets por hora. El clúster escala automáticamente según la profundidad de la cola SQS, centralizando registros y métricas en CloudWatch. Toda la infraestructura se gestiona como código mediante AWS CDK, dividida en tres etapas de despliegue: Beta, Gamma y Producción.
Para mitigar riesgos operativos, se incorporó un interruptor de funciones dinámico con AWS AppConfig, que Lambda consulta en tiempo real con cada mensaje entrante. El control admitía tres modos de operación: BEDROCK, que enrutaba todo el tráfico a Sonnet 4.6; DUAL, que llamaba a ambos modelos en paralelo y comparaba las discrepancias; y DECIDER, que transfería el volumen completo al modelo especializado.
Este mecanismo de despliegue gradual garantizó una migración sin sobresaltos. Durante la fase dual, las decisiones operativas seguían aplicándose según los resultados de Sonnet, mientras el sistema registraba y comparaba las discrepancias en segundo plano. Esta prueba con tráfico real validó la capacidad de generalización del modelo ante casuísticas complejas. En caso de detectarse cualquier anomalía, modificar la configuración en AppConfig permitía revertir el tráfico a la infraestructura heredada en menos de 45 segundos.
Ahorro de 20.000 dólares por millón de tickets: el perímetro del entorno cerrado
En el balance económico, la comparativa entre ambos enfoques arrojó una diferencia aplastante. Con la facturación basada en tokens de Bedrock, cada millón de tickets ascendía a unos 22.200 dólares. Al pasar a instancias dedicadas en SageMaker, la estructura de costes cambió a horas fijas de cómputo. Con la tarifa bajo demanda de us-east-1 (1,408 dólares por hora), procesar un millón de tickets a pleno rendimiento cuesta solo 250 dólares. Incluso manteniendo un margen del 100% de capacidad para amortiguar picos repentinos de tráfico, el gasto se sitúa en torno a 500 dólares por millón de tickets, lo que equivale a unos 0,0005 dólares por ticket.
Reducir el coste de 22.200 a 500 dólares representa un ahorro del 98%, multiplicando la rentabilidad por 44 veces. Estas cifras se basan en los resultados empíricos publicados por el equipo y en las tarifas oficiales bajo demanda, sin incluir los ahorros adicionales derivados de recortar un 74% el tiempo de ejecución en Lambda. En plataformas que gestionan decenas o cientos de millones de tickets al año, este cambio libera un presupuesto operativo sustancial.
No obstante, el éxito de esta transformación técnica está estrictamente condicionado por la naturaleza del problema. Los autores destacaron tres requisitos esenciales para su aplicación: la tarea debe consistir en una selección cerrada dentro de un catálogo predeterminado, el volumen de tickets debe ser lo bastante alto como para amortizar el coste fijo de las instancias, y la latencia del LLM original debe haber supuesto un cuello de botella real en las operaciones posteriores. Cuando se cumplen estas tres condiciones, el modelo de decisión despliega todo su potencial.
Fuera de estos supuestos, el enfoque deja de ser viable. Si el flujo descendente necesita explicaciones discursivas, si el catálogo de categorías cambia cada semana o si el contexto indispensable no cabe en unos pocos miles de tokens, los modelos de decisión no pueden sustituir a un LLM generalista de última generación. El alto coste de los modelos fundacionales reside en los amplios grados de libertad que mantienen para la generación abierta. Cuando el problema de ingeniería converge en una elección cerrada, suprimir el pipeline de generación autorregresiva y permitir que un modelo especializado emita directamente las probabilidades de las opciones constituye la respuesta más pragmática para escalar agentes de IA.
Enlaces de referencia:
- Blog oficial de Strands Agents: Amazon saves millions by replacing Sonnet 4.6 with Strands Decider
- Debate en Hacker News: Amazon engineers swap Claude for decision model