운영 환경에서 검증된 프론티어 거대언어모델(LLM)을 경량 소형 모델로 교체하는 작업에는 대개 성능 저하라는 타협이 뒤따른다. 하지만 아마존 내부의 핵심 티켓팅 시스템에서 엔지니어들은 상식을 깨는 교체 작업을 성공적으로 마무리했다. 분류 작업을 전담하던 Claude Sonnet 4.6을 메인 파이프라인에서 제외하고, 매개변수 규모가 4B 수준에 불과한 특화형 의사결정 모델 Strands Decider를 도입한 것이다. 티켓당 단일 처리 지연 시간은 4,215ms에서 897ms로 단축되었으며, 백만 건 처리당 추론 비용은 22,200달러에서 500달러로 약 98% 급감했다.
이러한 파격적인 비용 절감의 핵심은 분류 작업의 본질을 다시 정의한 데서 출발했다. 일반적인 AI 에이전트 아키텍처에서는 수천 개 토큰에 달하는 규칙 프롬프트를 범용 LLM에 밀어 넣고 모델이 글자 단위로 토큰을 순차 생성하기를 기다리는 방식이 일반적이었다. 그러나 닫힌 선택지에서 정답을 고르는 단일 선택 작업에서는 각 레이블의 확률값만 필요할 뿐, 불필요한 텍스트 생성이 전혀 필요치 않다. 자기회귀 디코딩을 과감히 제거함으로써 프롬프트 전송에 따르는 오버헤드를 없애고, 출력 결과에 대한 문법 파싱 과정 역시 완전히 생략할 수 있었다.
티켓 분류 1회 호출에 6,000토큰을 소모하던 내부 시스템
아마존은 방대한 규모의 내부 운영 티켓 시스템을 운영한다. 매일 인입되는 티켓은 시스템 업그레이드, 용량 증설, 장애 알람, 감사 대응 등 다양하며, 최종적으로 20개의 정해진 범주로 분류된다. 기존에는 이 작업을 Amazon Bedrock 기반의 Claude Sonnet 4.6이 맡아 지능과 비용의 균형을 맞춘 표준 아키텍처로 운영해 왔다.
하지만 범용 LLM의 토큰 기반 과금 체계는 대규모 고빈도 파이프라인에 심각한 비용 부담을 안겼다. 모델이 정해진 규칙대로만 분류하도록 강제하기 위해, 호출할 때마다 20개 카테고리의 판정 기준을 상세히 나열한 시스템 프롬프트와 엄격한 JSON 출력 포맷 제약을 함께 주입해야 했기 때문이다. 운영 실측 데이터에 따르면 티켓 1건당 평균 6,554개의 입력 토큰과 170개의 출력 토큰이 소모되어 총 6,724개 토큰에 달했다. 컴퓨팅 자원의 대부분이 고정된 포맷 제약과 분류 기준을 반복 전송하는 데 낭비되고 있었던 셈이다.
수천 개 토큰을 순차적으로 생성하는 자기회귀 디코딩은 응답 속도를 크게 저하시켰고, Claude의 티켓당 평균 처리 시간은 4,215ms까지 치솟았다. 4초를 초과하는 지연 시간은 앞단 SQS 컨슈머 워커의 동시성 병목을 유발했다. Bedrock 정가 기준으로 티켓 1건당 순수 모델 비용은 0.0222달러였으며, 백만 건을 처리할 때마다 22,200달러의 청구서가 쌓였다. 가파르게 불어나는 운영 비용은 팀으로 하여금 근본적인 아키텍처 전환을 추진하게 만들었다.
텍스트 생성 파이프라인 제거: 확률 분포 직접 출력으로 지연 시간 78% 단축
닫힌 분류 문제에 직면한 엔지니어링 팀은 오픈소스 의사결정 모델인 Strands Decider로 눈을 돌렸다. 자기회귀 언어 모델과 달리, 이 모델은 인과적 언어 생성 헤드를 제거하고 후보 선택지의 점수를 계산하는 포인터 헤드(Pointer Head)를 탑재했다. 입력은 오직 현재 상태, 질문, 그리고 선택지 목록으로만 구성된다. 모델은 단 한 번의 순전파(Forward Pass) 연산을 수행하고 Softmax를 통해 각 선택지의 확률 분포와 신뢰도 점수를 즉시 출력한다.
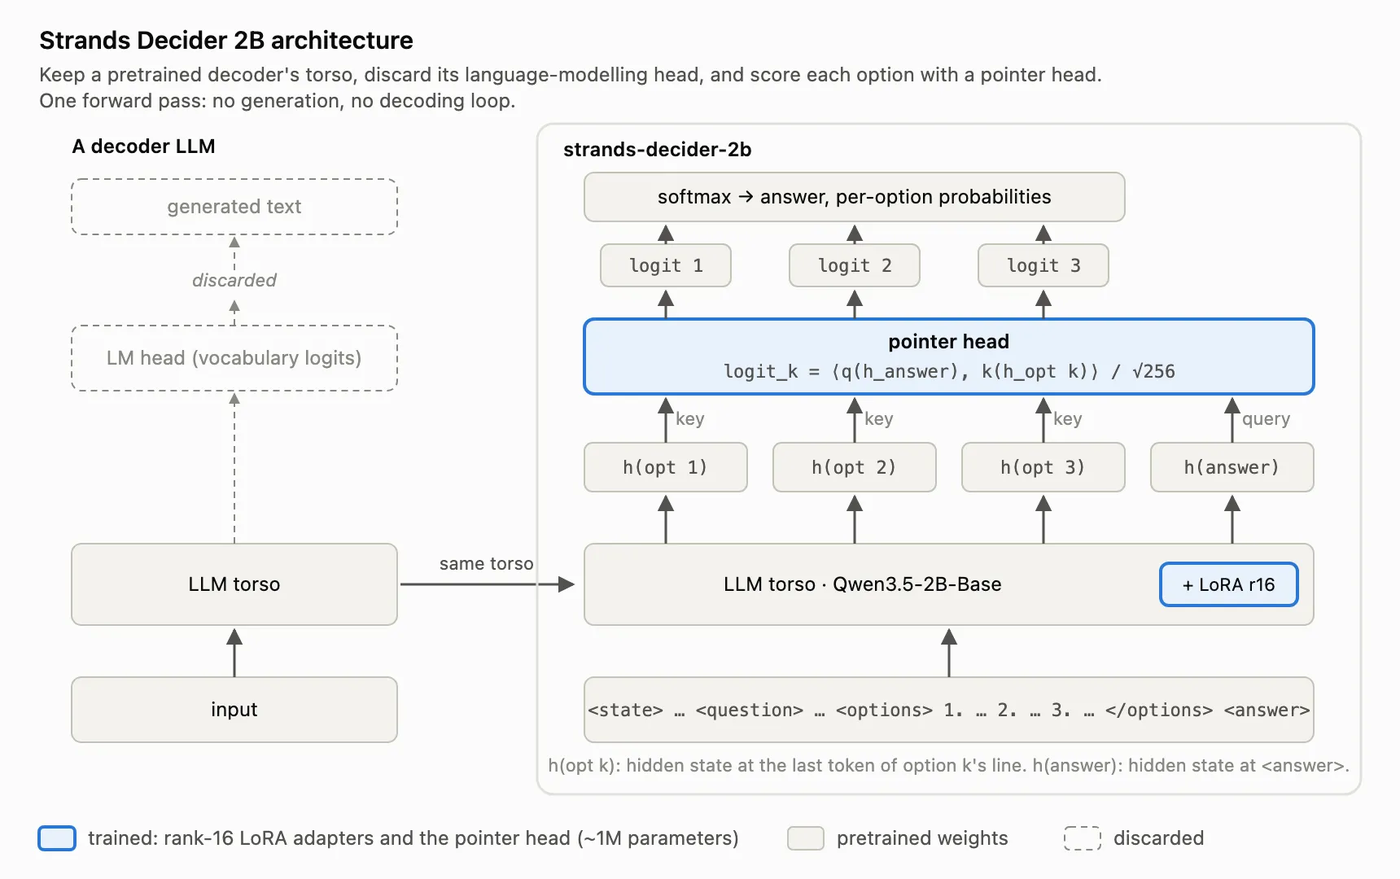 그림: Strands Decider는 자기회귀 언어 생성 헤드를 배제하고 Pointer Head를 통해 후보 선택지 점수를 계산한다. 출처: Strands Agents
이러한 구조적 변화는 텍스트 생성 시 발생하는 반복 샘플링 루프를 원천 차단했다. 추론 전체가 단일 순전파로 완료되므로 토큰을 하나씩 뱉어내는 디코딩 지연이 발생하지 않으며, 잘못된 JSON 포맷으로 인한 파싱 오류를 걱정할 필요도 없어졌다. 이후 진행된 벤치마크 평가에서 Gemma 4 기반의 E4B 모델은 운영 환경의 Claude Sonnet 4.6을 뛰어넘는 분류 정확도를 기록했다. 팀은 최종적으로 E4B 모델을 프로덕션 환경에 투입하기로 결정했다.
입출력의 대폭 축소는 즉각적인 성능 혁신으로 이어졌다. 동일한 티켓 테스트 세트에서 Strands Decider E4B의 평균 호출 시간은 4,215ms에서 897ms로 78% 감소했다. 티켓당 입력 토큰은 6,554개에서 2,009개로 줄었고, 출력 토큰은 170개에서 단일 선택지를 뜻하는 1개 토큰으로 압축되어 전체 토큰 소모량이 70% 감소했다. Sonnet 4.6 트래픽을 차단한 당일, 앞단 AWS Lambda의 평균 실행 시간은 74% 급감했다.
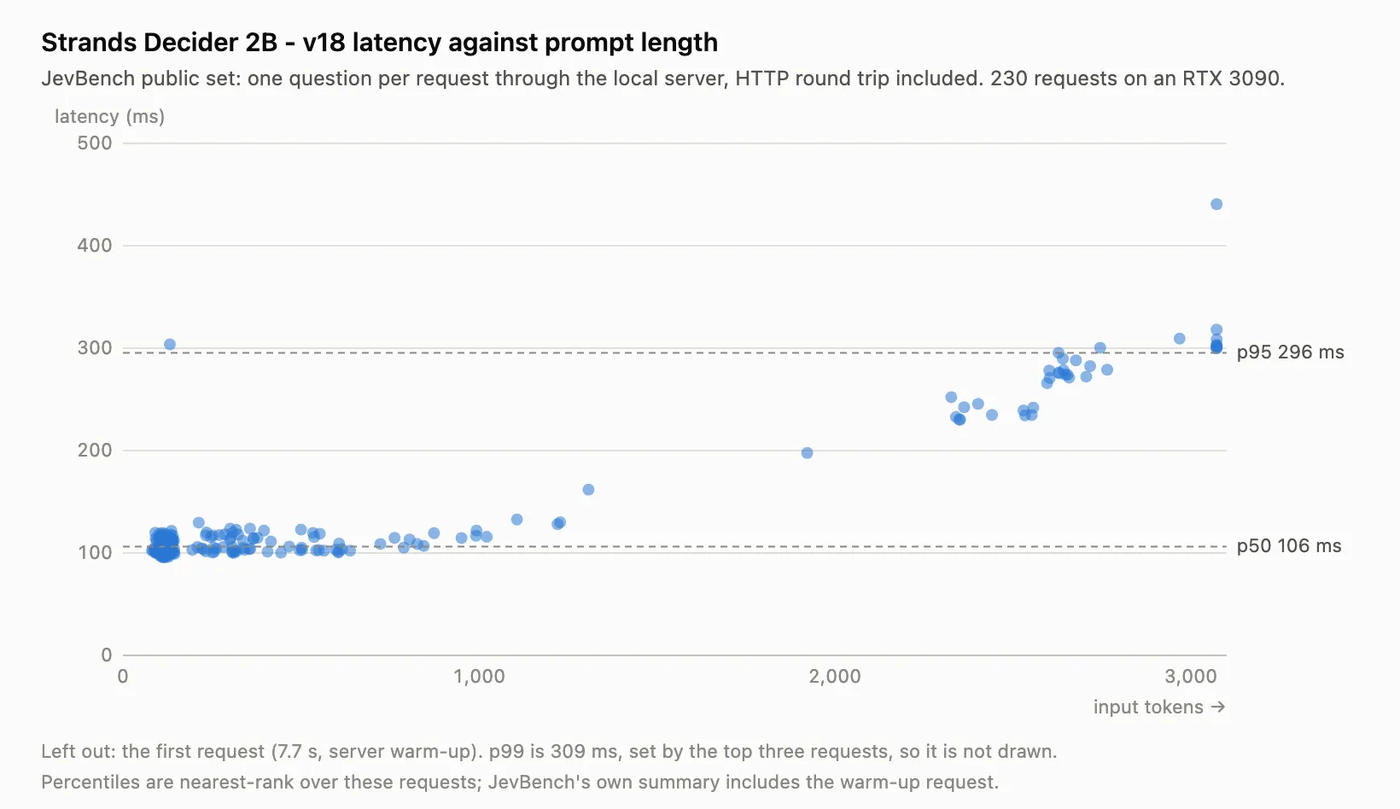 그림: 평가 데이터셋에서의 Strands Decider 추론 지연 시간 분포. 단일 요청의 네트워크 왕복 및 컴퓨팅 소요 시간이 매우 낮은 수준을 유지한다. 출처: Strands Agents
지연 시간의 감소는 서버리스 클러스터의 자원 효율성을 획기적으로 개선했다. Lambda와 같은 함수형 컴퓨팅의 과금은 실행 시간에 비례하므로, 단일 처리 시간을 4분의 1 가까이 줄였다는 것은 동일한 처리량을 유지하는 데 필요한 Lambda 동시성 할당량을 대폭 절감했음을 뜻한다. 큐의 적체 해소 주기도 1초 미만으로 단축되어, 긴급한 고우선순위 알람에 대한 시스템 반응 속도가 눈에 띄게 향상되었다.
4,096 토큰 윈도우의 제약과 엔지니어링: 규칙 압축과 키 순서 고정
소형 의사결정 모델 도입이 단순히 부품 교체처럼 순탄했던 것만은 아니다. 제한된 컨텍스트 윈도우가 첫 번째 장애물로 작용했다. Strands Decider의 컨텍스트 길이는 최대 4,096개 토큰으로 제한되어 있다. 프로덕션 환경에서 20개 카테고리의 상세 정의와 예시를 나열하는 것만으로도 4,000토큰을 초과했기 때문에, 기존 프롬프트를 그대로 가져오면 실제 티켓 본문을 담을 공간이 전혀 남지 않았다.
엔지니어들은 프롬프트 엔지니어링을 처음부터 다시 설계했다. 팀은 각 카테고리의 판정 기준을 1~2줄의 명확한 판단 휴리스틱으로 압축하고 객관식 선택지 형태로 재정리한 뒤, 마지막에 제외 옵션인 none을 추가했다. 본문이 긴 티켓의 경우 가장 오래된 과거 코멘트를 과감히 버림으로써, 최신 상태와 핵심 장애 정보가 온전히 보존되도록 제어했다.
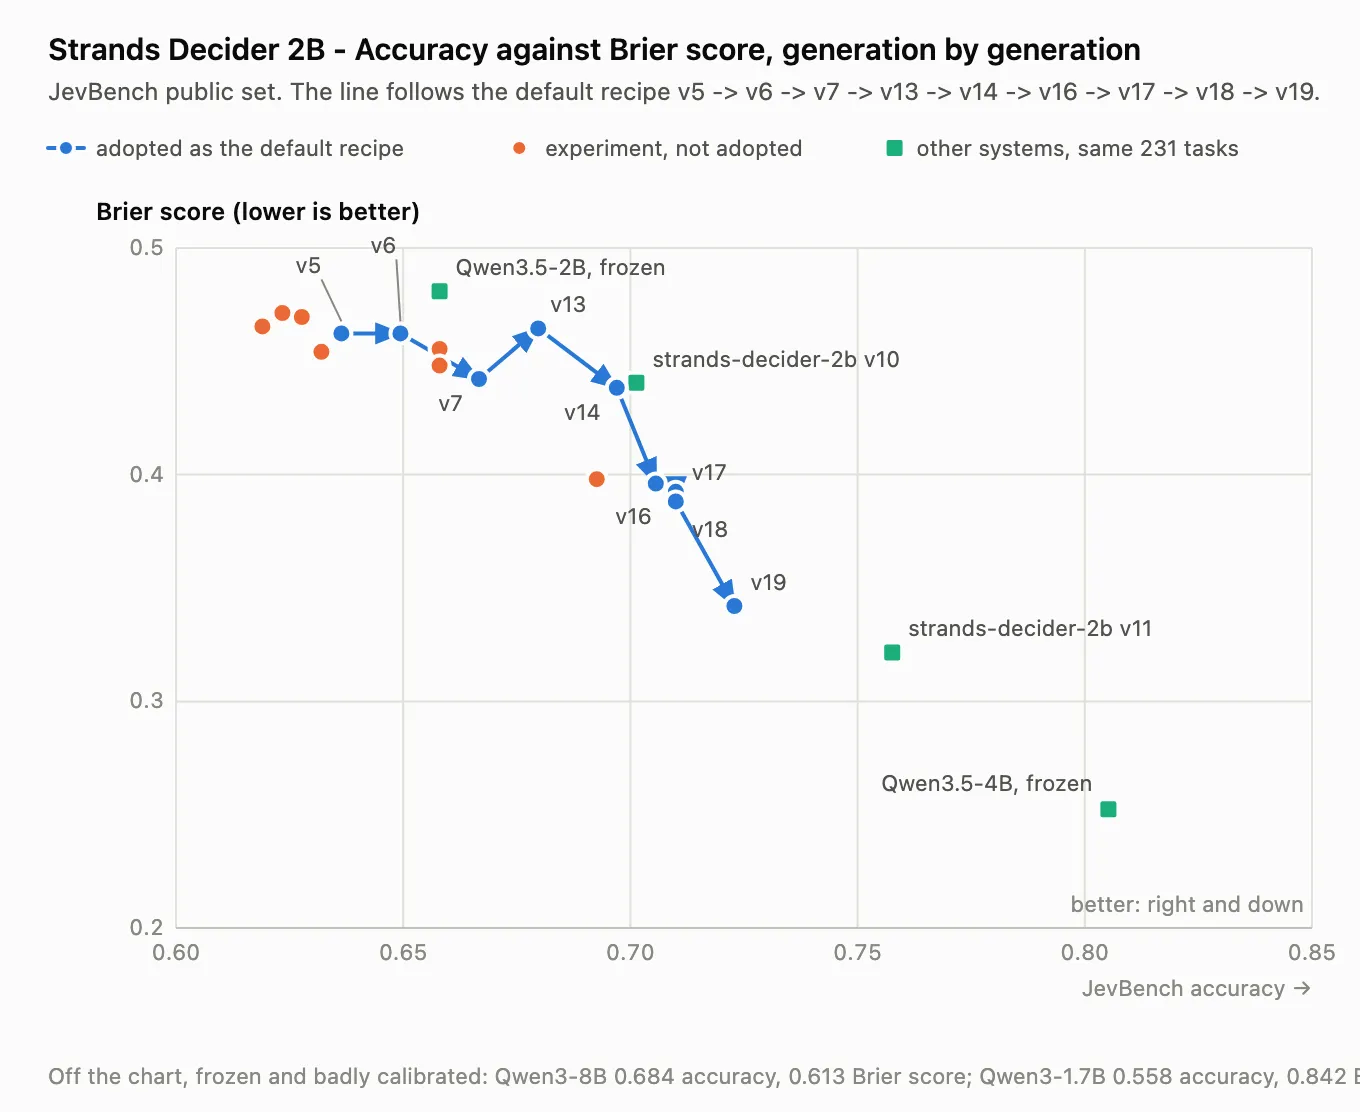 그림: 모델 반복 과정에서의 결정 보정치 및 정확도 변화 추이. 브리어 점수(Brier Score)가 낮을수록 확률 추정치의 신뢰도가 높음을 나타낸다. 출처: Strands Agents
라벨링의 신뢰성을 보장하기 위해 신뢰도 임계값 메커니즘도 도입했다. 팀은 확률 곡선을 지속적으로 보정하여 의사결정 경로에서의 브리어 점수를 낮췄다. 최상위 후보의 신뢰도가 임계값을 넘을 때만 자동 라벨링을 적용하고, 신뢰도가 미달하거나 none으로 판정될 경우에는 티켓을 엔지니어 수동 검토 큐로 안전하게 라우팅했다.
연동 테스트 단계에서 팀은 직관에 반하는 로우레벨 특성을 발견했다. JSON 키의 직렬화 순서에 따라 모델의 판정 결과가 달라진 것이다. 키와 값의 내용이 완전히 동일함에도 불구하고 키의 배치 순서를 바꾸는 것만으로 출력 확률값이 최대 0.19까지 요동쳤다. 경계선에 걸친 티켓의 경우 이 오차만으로 분류 결과가 뒤집힐 수 있었다. 팀은 모든 입력 JSON 키를 알파벳 오름차순으로 엄격하게 정렬하도록 강제하여, 페이로드 직렬화 순서로 인한 의사결정 변동성을 완전히 제거했다.
AppConfig 3단계 전환: 단일 인스턴스에서 시간당 5,600건 처리
새로운 아키텍처는 전적으로 AWS 표준 클라우드 서비스를 기반으로 구축되었다. 인입된 티켓은 먼저 Amazon SQS 큐에 적재된 후, Lambda 함수를 트리거하여 페이로드를 추출하고 Amazon SageMaker 모델 엔드포인트를 호출한다. 엔드포인트는 단일 24GB GPU(NVIDIA A10G)를 탑재한 ml.g5.xlarge 인스턴스를 활용한다. 모델의 VRAM 점유량은 약 19 GiB이며, 외부 인터넷 아웃바운드가 차단된 격리된 VPC 서브넷 환경에서 구동된다.
단일 A10G GPU는 뛰어난 처리 성능을 입증했다. 엔드포인트의 단일 요청 처리 시간은 약 640ms로, 1대의 컴퓨팅 인스턴스가 시간당 약 5,600건의 티켓을 처리할 수 있다. 클러스터는 SQS 큐 깊이에 따라 자동으로 스케일링되며, 로그와 메트릭은 CloudWatch로 수집된다. 전체 인프라는 AWS CDK를 통해 관리되며, Beta, Gamma, Prod의 3단계 릴리스 파이프라인으로 배포된다.
전면 전환에 따른 운영 리스크를 방지하기 위해 AWS AppConfig 기반의 동적 기능 플래그가 도입되었다. Lambda는 메시지를 처리할 때마다 이 설정을 실시간으로 참조한다. 플래그는 세 가지 모드를 지원했다. 전체 트래픽을 Sonnet 4.6으로 보내는 BEDROCK, 두 모델을 병렬 호출하여 결과 차이를 비교 검증하는 DUAL, 그리고 특화 모델로 전량 전환하는 DECIDER 모드다.
이러한 점진적 전환 제어는 안전한 마이그레이션을 가능하게 했다. DUAL 모드 운영 중에는 실제 티켓 처리가 여전히 Sonnet 결과에 따라 이루어지면서 백그라운드에서 양측의 판단 차이가 기록되고 정밀 분석되었다. 실제 프로덕션 트래픽 환경에서 모델의 일반화 성능을 충분히 검증할 수 있었던 것이다. 이상 징후가 발생하더라도 AppConfig 설정값 변경만으로 45초 이내에 기존 파이프라인으로 즉시 롤백할 수 있는 안전장치가 마련되었다.
백만 건당 2만 달러 절감, 닫힌 선택지가 그어준 적용의 경계
재무적 관점에서 구형 파이프라인과 신형 파이프라인의 비용 격차는 압도적이었다. 기존 Bedrock 기반 과금 체계에서는 티켓 1건당 0.0222달러, 백만 건당 약 22,200달러가 소요되었다. 반면 전용 SageMaker 인스턴스로 전환한 후에는 고정 컴퓨팅 시간 과금으로 바뀌었다. us-east-1 리전의 온디맨드 단가(시간당 1.408달러) 기준, 인스턴스를 100% 가동해 백만 건을 처리하는 데 드는 비용은 불과 250달러였다. 트래픽 급증에 대비해 2배의 여유 용량을 확보하더라도 백만 건당 비용은 약 500달러, 티켓당 단가는 약 0.0005달러 수준에 불과하다.
백만 건당 처리 비용이 22,000달러에서 500달러로 감소한 것은 98%의 절감이며, 약 44배의 비용 효율 개선을 의미한다. 이는 엔지니어링 팀이 공개한 자체 벤치마크와 공식 온디맨드 단가를 바탕으로 산출한 수치이며, Lambda 실행 시간 74% 단축에 따른 추가적인 서버리스 비용 절감분은 여기에 포함되지도 않았다. 연간 수억 건 이상의 티켓을 다루는 엔터프라이즈 플랫폼에서 이러한 개선은 막대한 운영 예산을 절약해 준다.
그러나 이번 아키텍처 혁신의 성공은 문제 자체가 지닌 전제 조건에 크게 좌우된다. 엔지니어들은 적용을 위한 명확한 선결 조건을 제시했다. 작업이 반드시 정해진 카탈로그 내에서 이루어지는 닫힌 선택 문제여야 하고, 인스턴스의 고정 가동 비용을 충분히 분산할 수 있을 만큼 대규모 처리량이 뒷받침되어야 하며, 기존 LLM의 높은 지연 시간이 하류 비즈니스 처리를 실질적으로 지연시키고 있어야 한다는 점이다. 이 세 가지 조건이 맞아떨어질 때 특화형 의사결정 모델은 비로소 강력한 효용을 발휘한다.
이러한 전제를 벗어난다면 이 방법론은 적합하지 않다. 하류 파이프라인에서 설명 텍스트 생성이 요구되거나, 분류 카탈로그가 매주 변경되거나, 유효 컨텍스트를 수천 토큰 내로 압축할 수 없는 환경이라면 범용 LLM의 유연성을 대체하기 어렵다. 거대언어모델의 높은 비용은 본질적으로 개방형 텍스트 생성을 위해 유지하는 방대한 자유도에서 비롯된다. 엔지니어링 과제가 명확한 닫힌 선택 문제로 좁혀진다면, 자기회귀 생성 파이프라인을 덜어내고 특화 모델이 선택지 확률을 직접 출력하도록 설계하는 것이야말로 AI 에이전트를 대규모로 운영하는 가장 실용적인 해법이다.
참고 링크:
- Strands Agents 공식 블로그: Amazon saves millions by replacing Sonnet 4.6 with Strands Decider
- Hacker News 커뮤니티 토론: Amazon engineers swap Claude for decision model