«Nadie vuelve a ver la grabación de una reunión de equipo de hace tres años para recordar las limitaciones de una funcionalidad. La gente escribe las cosas y utiliza esos registros».
En su artículo Agents Don’t Need Memory. They Need Documentation., el desarrollador Kevin Liao plantea que las soluciones de memoria en el ecosistema actual de agentes de IA sufren deficiencias estructurales de ingeniería. Mientras muchas herramientas se dedican a encadenar demonios en segundo plano, sistemas de reclasificación y algoritmos de resumen sobre bases de datos RAG, los proyectos reales continúan sufriendo los dolores de cabeza de gestionar memorias opacas de caja negra.
La lotería del RAG no puede resolver cinco trampas de ingeniería
La inmensa mayoría de los complementos de memoria para agentes siguen una fórmula idéntica: analizan las transcripciones de sesiones anteriores, generan fragmentos de memoria, los almacenan en una base de datos vectorial y recuperan los cinco más similares en cada prompt para inyectarlos en el contexto. Liao define este mecanismo como una auténtica lotería de fragmentos RAG. Al trocear los registros vectoriales, la motivación original del código y el estado del entorno en el que se concibió quedan irremediablemente sepultados.
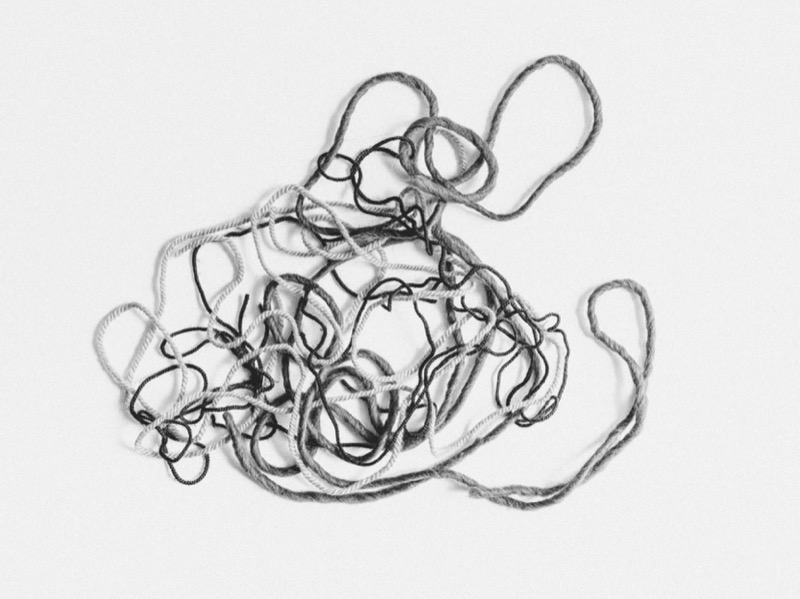 Figura: Fragmentos de memoria aislados y difíciles de rastrear. Fuente: liao.gg
La búsqueda por similitud vectorial se limita a calcular la proximidad entre dos fragmentos en un espacio de incrustaciones; no tiene forma de determinar qué regla sigue vigente en el sistema actual. Tratar los registros del pasado como verdades absolutas del presente representa un riesgo crítico en bases de código que evolucionan a diario. Si la lógica de autenticación cambia, fragmentos obsoletos en la base de datos continuarán transmitiendo directrices caducadas al agente. En una caja negra con 10.000 incrustaciones en SQLite, los desarrolladores no pueden distinguir qué fragmentos están desfasados o cuáles jamás han llegado a consultarse. Incluso si se proporciona una herramienta de búsqueda global al agente, este carece de la conciencia necesaria para discernir qué lagunas de conocimiento tiene o en qué momento exacto debe consultar.
Rediseñar el flujo de trabajo en cuatro fases bien definidas
Frente al colapso de gestión de las cajas negras, Liao propone la «memoria basada en documentos» (Document-based Memory). Este modelo elimina los procesos de fondo y las interfaces vectoriales, apostando por una arquitectura documental estructurada en Markdown plano. Un único archivo AGENTS.md resulta insuficiente para proyectos de envergadura; el repositorio requiere instrucciones de desarrollo, especificaciones funcionales, registros de decisiones de arquitectura e investigaciones técnicas.
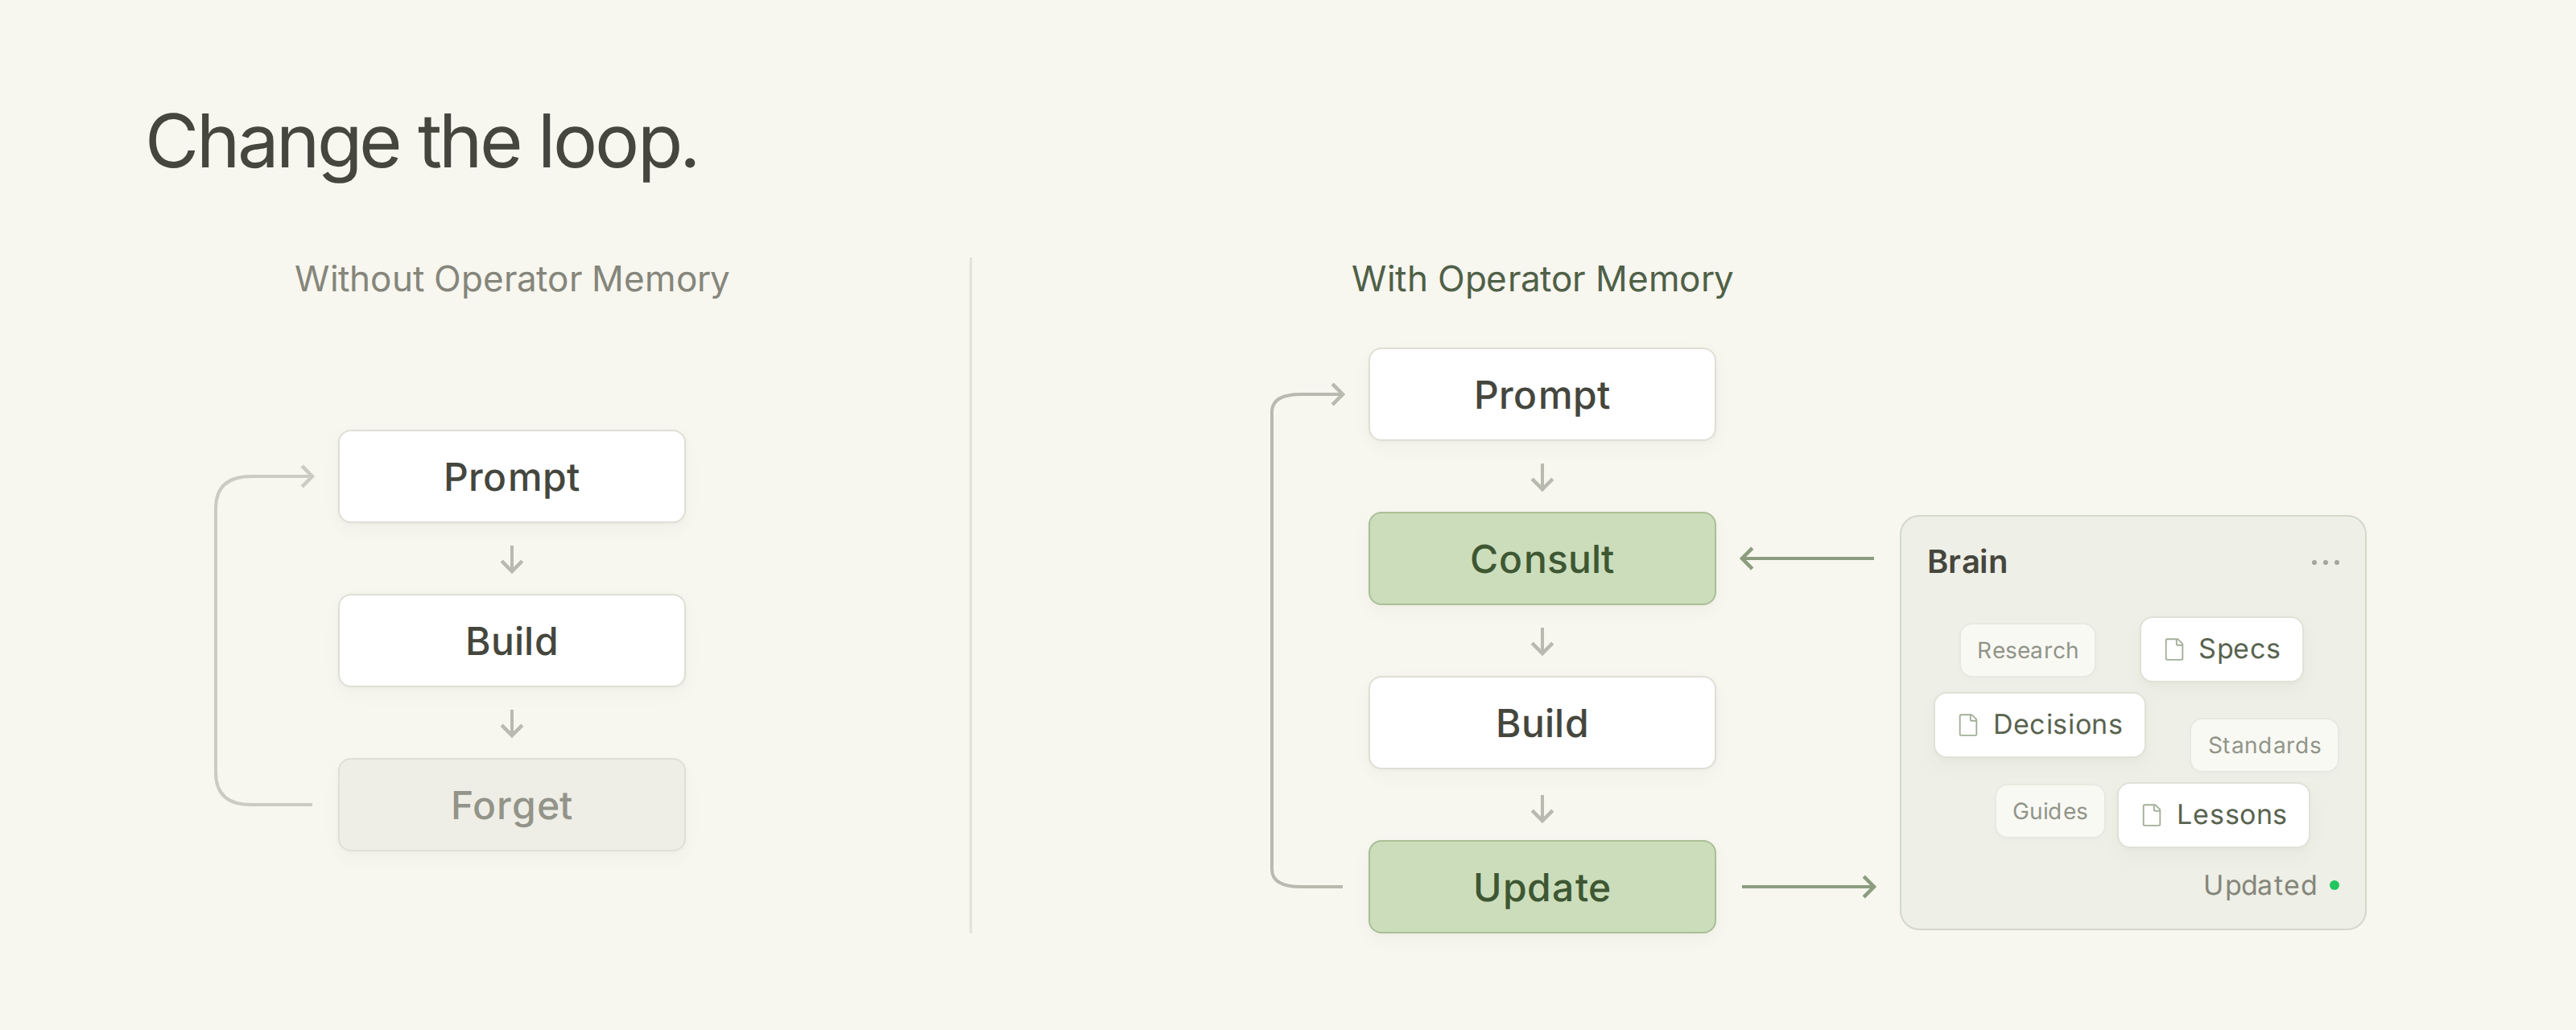 Figura: Comparación entre el ciclo «prompt → build → forget» y el nuevo «prompt → consult → build → update». Fuente: liao.gg
El flujo de desarrollo experimenta una transformación radical: deja atrás el modelo unidireccional prompt → build → forget para adoptar el ciclo prompt → consult → build → update. Al recibir una tarea, el agente consulta primero la documentación del módulo correspondiente; una vez completada la implementación, actualiza los documentos del proyecto con las nuevas restricciones y el estado resultante. La memoria deja de ser una base de datos de recuperación hermética y se convierte en un espacio de trabajo legible, editable y compartible por todo el equipo.
Reglas de tres niveles para organizar los directorios en producción
Al volver a adoptar documentos en texto plano como soporte de memoria, la comunidad ha articulado patrones de directorios bien estructurados. En lugar de acumular todas las conversaciones en una sola carpeta, los equipos establecen una jerarquía clara: .agents/plans/ para las hojas de ruta y pasos de ejecución, .agents/notes/ para las notas de investigación en curso, y .agents/knowledge/ para las conclusiones consolidadas y verificadas.
Bajo este esquema, las notas se consideran borradores temporales; solo el conocimiento contrastado y probado se promueve a la categoría de knowledge. Cuando los documentos de un área concreta crecen en volumen, se crean archivos INDEX.md locales para orientar la navegación. Al recuperar el texto plano como medio de almacenamiento, décadas de experiencia en taxonomía de directorios y gobierno de ingeniería se pueden trasladar de forma directa a la gestión de agentes de IA.
El debate en la comunidad: ¿pueden los acuerdos en texto contener las alucinaciones?
Diversos desarrolladores han cuestionado la fuerza vinculante de los protocolos en texto plano. En entornos reales de producción se observa que, aun cuando se indique taxativamente en las instrucciones «utiliza exclusivamente jq para procesar JSON y no generes scripts ad-hoc», los modelos siguen inclinándose por escribir y ejecutar scripts en Python ante estructuras JSON complejas.
Para modelos de lenguaje que operan bajo probabilidades estadísticas, los textos de instrucciones presentan límites evidentes. Por ello, muchos ingenieros recomiendan complementar los acuerdos en texto con bloqueos estrictos a nivel de compilador y linter. Al transformar las violaciones de linting en mensajes de error estructurados con indicaciones precisas de corrección, las herramientas imponen barreras deterministas que reconducen al agente hacia la ruta de ejecución esperada.
El sentido común del software devuelve las herramientas al texto plano
Tanto el mantenimiento de índices estáticos en Markdown como la aplicación de revisiones estrictas de linter confluyen en un mismo principio: las cadenas de herramientas modernas de desarrollo deben ser transparentes, deterministas y auditables. Buena parte de los plugins de memoria redujeron la gestión del contexto del proyecto a un simple problema de tasa de acierto (recall) en RAG, intentando enmascarar deficiencias de gestión de estado mediante capas y más capas de componentes adicionales.
El vehículo natural del conocimiento en ingeniería de software son los sistemas de texto plano que admiten revisión humana y control de versiones. Los agentes no necesitan un artificio opaco de memoria, sino un espacio documental vivo que puedan consultar antes de iniciar una tarea y actualizar al darla por concluida.
Enlaces de referencia:
- Agents Don’t Need Memory. They Need Documentation.
- Debate en Hacker News
- Repositorio de Operator Memory