「没有人会为了回忆某个功能的约束,去重看三年前的团队会议录像。人们是把东西写下来,然后用记录。」
开发者 Kevin Liao 在《Agents Don’t Need Memory. They Need Documentation.》中提出,当前 AI 工具生态的记忆方案存在工程问题。当许多方案在 RAG 系统中增加守护进程、排序器和自动摘要算法时,实际工程中的系统仍面临黑盒记忆带来的管理难题。
RAG 抽奖解决不了 5 类工程陷阱
现在市面的 agent memory 插件,几乎采用了相同的结构:遍历历史会话,生成记忆片段,存进 RAG 数据库,并在每次接到 prompt 时检索出前 5 条注入上下文。Liao 认为这套机制类似于一场 RAG 片段的抽奖。在切分的向量记录中,代码最初的编写动机、所处的环境状态可能出现丢失。
 图:一堆孤立且难以溯源的记忆片段。来源:liao.gg
相似度匹配主要计算两个片段在嵌入空间里的距离,难以确认哪个规则在当前的系统中是正确的。把过去的记录直接作为当前事实,在经常变动的代码库里存在风险。如果项目的鉴权逻辑发生变更,数据库中旧的鉴权片段可能会向 agent 输出过期指令。在这些 1 万条 embedding 数据构成的黑盒里,开发者难以区分哪些已经过期,哪些从未被调用。即便是提供全局搜索工具,agent 也难以判断自身缺乏哪些知识以及何时需要搜索。
用 4 个阶段重塑文档工作流
面对黑盒记忆的管理问题,Liao 提出了 Document-based Memory。这种思路移除了后台整理进程和向量接口,引入了基于纯 Markdown 的结构化文档方案。部分项目难以仅靠单个 AGENTS.md 文件支撑开发,系统需要涵盖指令、规格、决策记录和前沿调研。
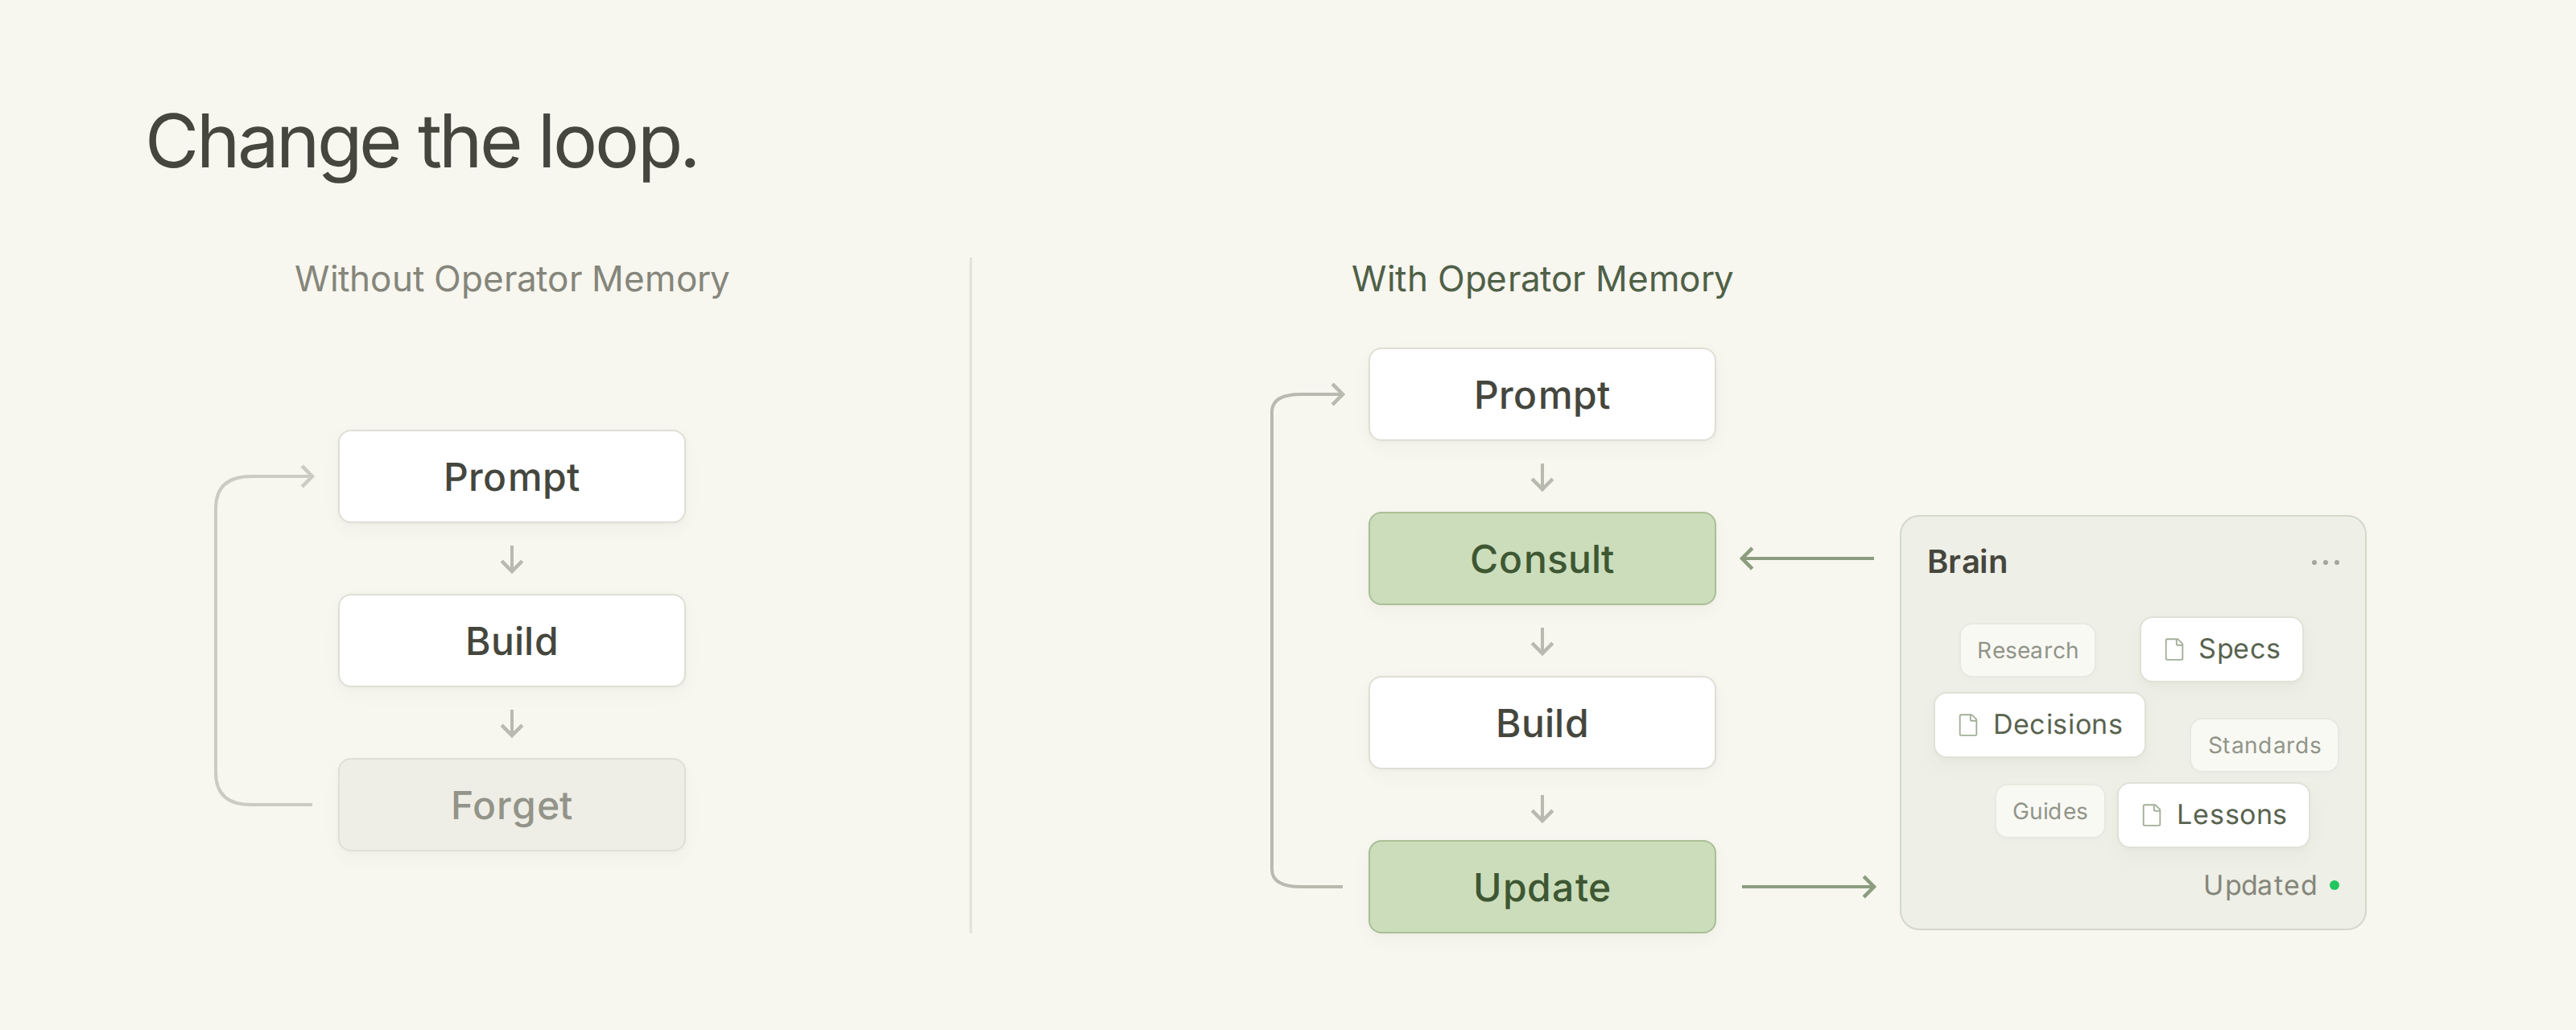 图:从 prompt → build → forget 到 prompt → consult → build → update 的循环对比。来源:liao.gg
开发模式发生了改变,从单向的 prompt → build → forget 转变为 prompt → consult → build → update。Agent 接到任务后需要先去查询对应模块的文档,完成代码构建后,再将新的约束和状态更新到项目文档中。记忆从独立的检索库,转变为可读、可修改、可分享的工作区。
落地实践跑出了 3 层目录法则
当记忆系统采用普通文档后,社区中出现了基于目录的实践方案。部分团队放弃了把所有对话放入单个目录的做法,建立了分层架构:.agents/plans/ 存放执行步骤,.agents/notes/ 存放研究笔记,.agents/knowledge/ 保存最终结论。
在这套设计中,笔记被定义为临时思考,经过验证沉淀下来的知识才能被归档进 knowledge。当某个业务板块的知识文件体积增加时,开发者会建立局部的 INDEX.md 进行导航。当存储介质回到明文后,现有的目录学和工程治理经验可以应用到 AI 团队的管理上。
社区争辩文本协议能否拦住代码幻觉
部分开发者对纯文本协议的约束力提出了疑问。他们在实际使用中发现,即使在文档里明确要求 agent「只准用 jq 解析,禁止写临时脚本」,模型在面对复杂 JSON 结构时,仍可能编写 Python 脚本执行。
对于依赖统计概率输出的 LLM 而言,文本协议的约束力有时存在局限。这些开发者建议使用编译器级别的硬拦截来辅助文本约束。他们将代码 lint 规则封装成带有修复说明的报错信息返回给模型,通过明确的反馈和规则拦截,引导 agent 返回预期的执行路径。
工程常识逼迫工具链回归明文协议
不管是维护静态的 Markdown 索引,还是部署严苛的 Lint 检查,这两套解法在诉求上保持一致:现代开发工具链需要保持透明、确定且可被审计。部分记忆插件将项目上下文的管理转化成了单一的检索召回率问题,试图通过增加功能模块来解决状态管理的问题。
软件工程知识的载体通常是可被审阅、支持版本控制的明文系统。Agent 需要一个能在开工前检索、完工后更新的静态库。
参考链接:
- Agents Don’t Need Memory. They Need Documentation.
- Hacker News 上的相关讨论
- Operator Memory 仓库