« Personne ne revisionne l’enregistrement d’une réunion d’équipe vieille de trois ans pour retrouver les contraintes d’une fonctionnalité. Les développeurs rédigent des documents et s’appuient sur ces traces écrites. »
Dans son essai intitulé Agents Don’t Need Memory. They Need Documentation., le développeur Kevin Liao soutient que les solutions de mémoire au sein de l’écosystème actuel des agents d’IA reposent sur de profondes erreurs d’ingénierie. Tandis que de nombreux projets multiplient les démons d’arrière-plan, les reclasseurs (rerankers) et les algorithmes de synthèse par-dessus des bases RAG, les équipes font face, sur le terrain, aux impasses de gestion générées par ces mémoires boîte noire.
La loterie du RAG échoue face à cinq pièges d’ingénierie
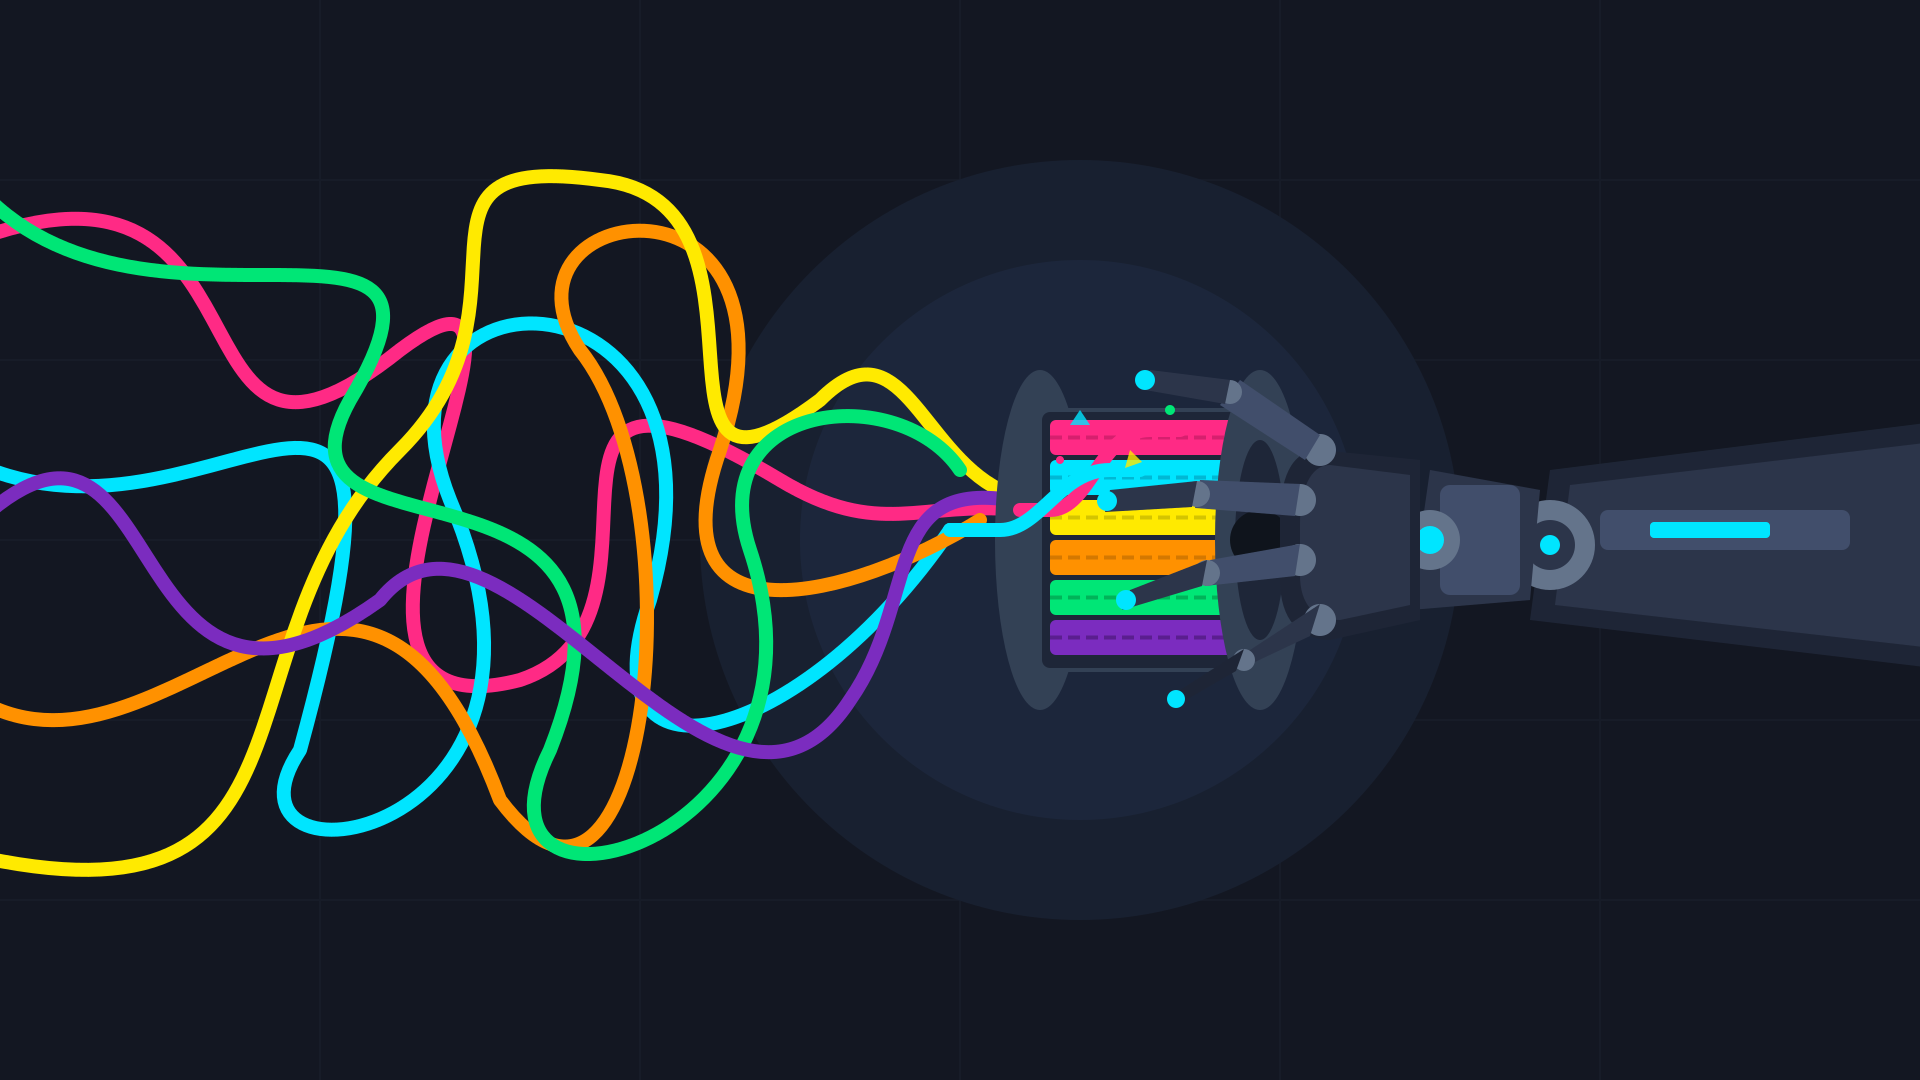
La majorité des extensions de mémoire pour agents partagent une architecture identique : parcourir l’historique des sessions, extraire des fragments de souvenirs, les consigner dans une base vectorielle, puis injecter les cinq résultats les plus proches à chaque nouveau prompt. Kevin Liao assimile ce dispositif à une véritable loterie de fragments RAG. Dans ces enregistrements vectoriels morcelés, l’intention originelle du code et l’état de l’environnement de développement s’effacent inexorablement.
 Figure : Des fragments de mémoire isolés et impossibles à contextualiser. Source : liao.gg
La recherche par similarité ne fait que mesurer la distance entre deux vecteurs dans un espace d’intégration ; elle est incapable de déterminer quelle règle fait autorité dans la base de code actuelle. Prendre les traces du passé pour des vérités présentes constitue un risque majeur au sein d’un dépôt en mutation constante. Si la logique d’authentification a évolué, de vieux fragments conservés en base injecteront des consignes obsolètes à l’agent. Au sein d’une boîte noire réunissant 10 000 plongements SQLite, les ingénieurs ne peuvent identifier les données périmées de celles qui n’ont jamais été sollicitées. Même lorsqu’on fournit à l’agent un outil de recherche global, celui-ci demeure incapable d’évaluer ses propres lacunes et de savoir à quel moment précis déclencher une requête.
Réorganiser le flux de travail en quatre temps
Face à cette faillite de gouvernance, Liao préconise la « mémoire documentaire » (Document-based Memory). Cette approche écarte démons permanents et interfaces vectorielles au profit d’un ensemble structuré de documents en Markdown brut. Un simple fichier AGENTS.md ne saurait porter à lui seul un projet d’envergure : le système doit intégrer des directives opératoires, des spécifications d’implémentation, des comptes rendus de décisions d’architecture et des études préalables.
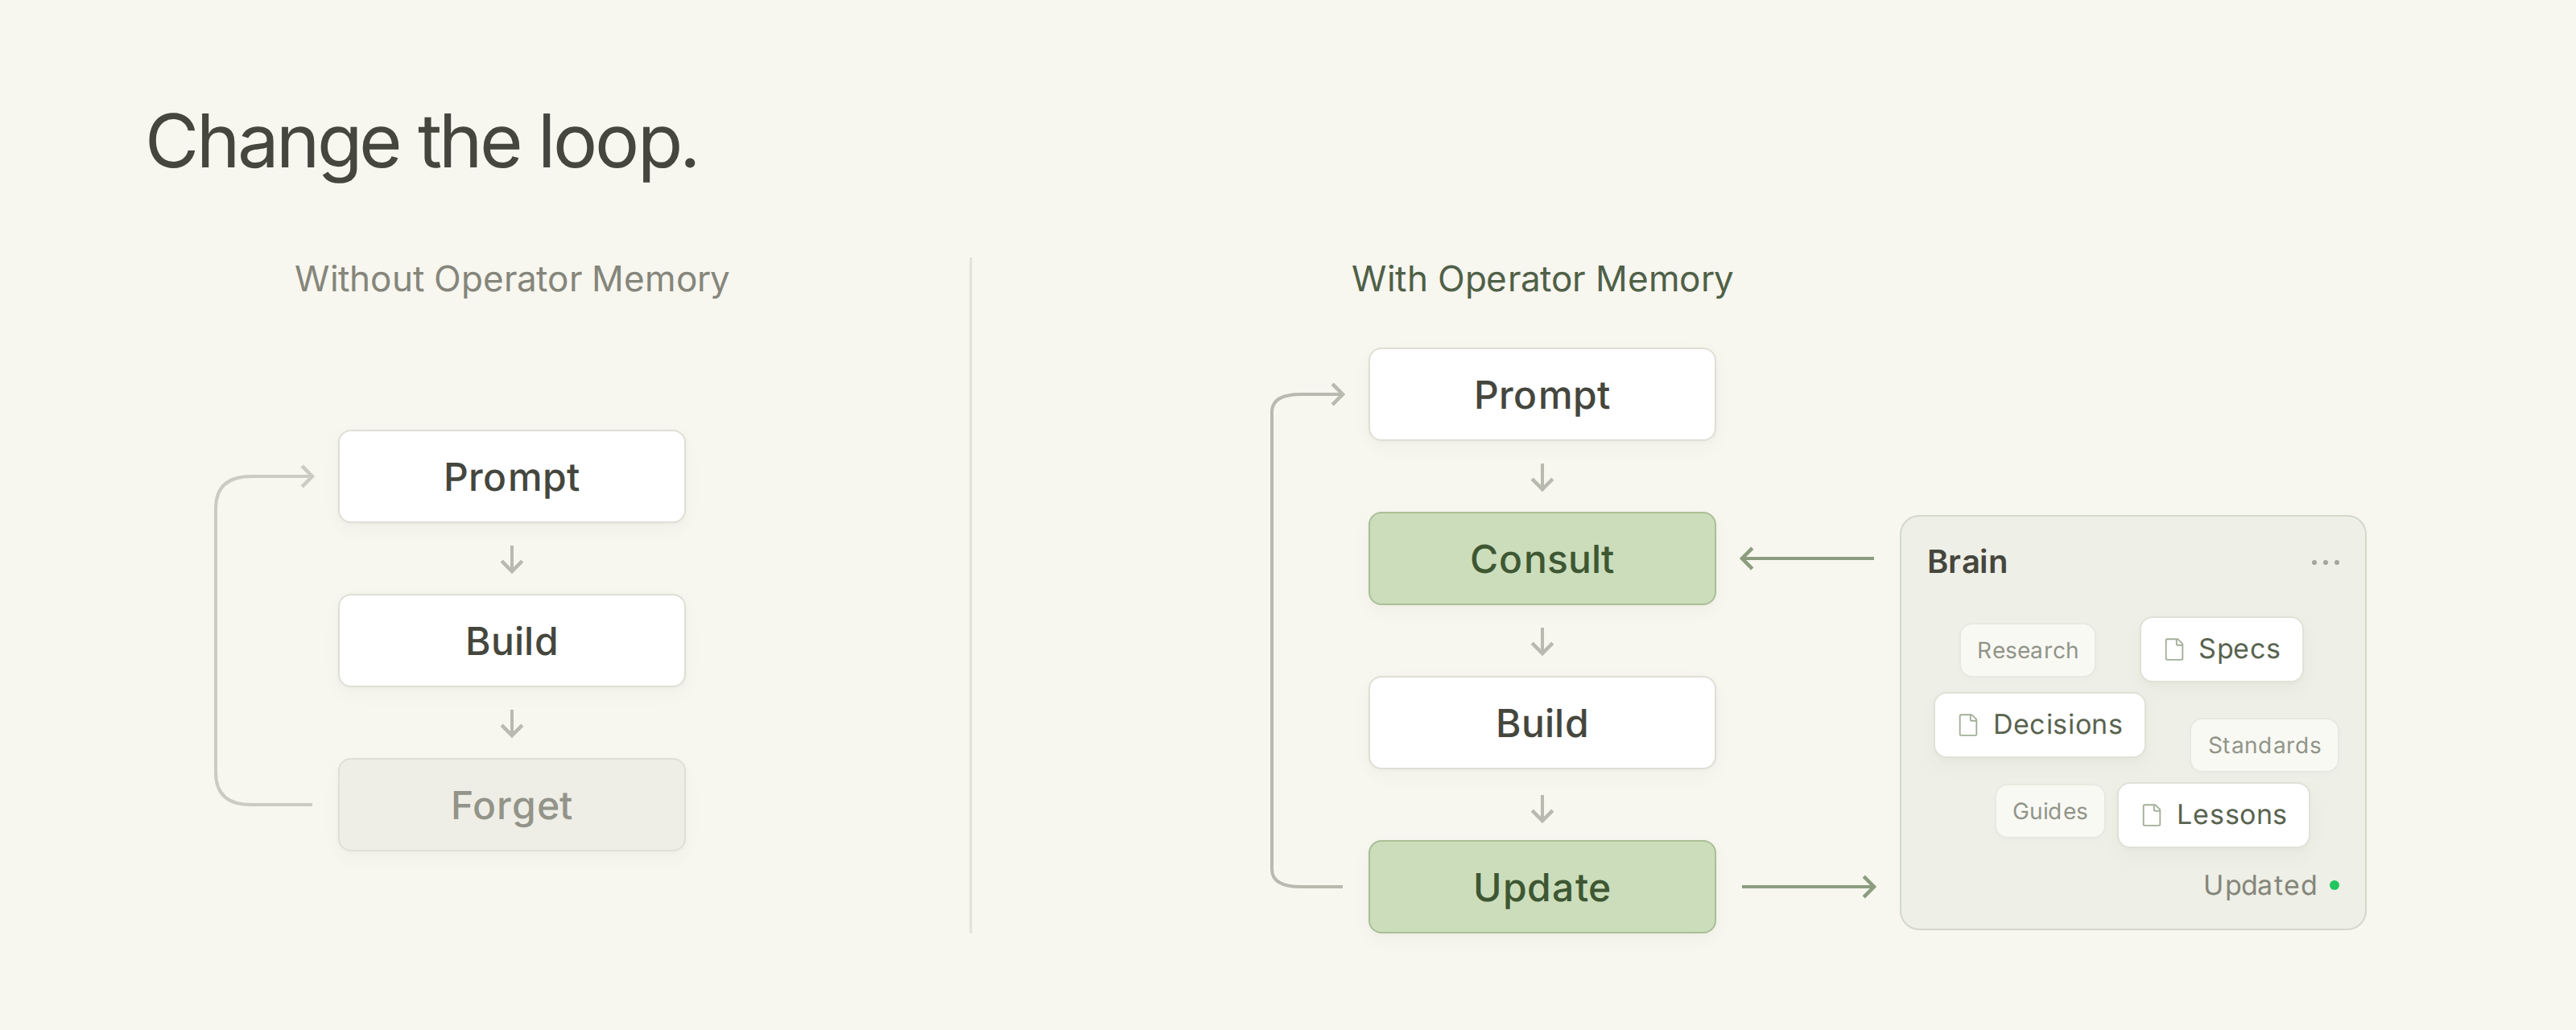 Figure : Comparaison entre « prompt → build → forget » et « prompt → consult → build → update ». Source : liao.gg
Le paradigme de développement se métamorphose alors : la boucle à sens unique prompt → build → forget cède la place au cycle vertueux prompt → consult → build → update. Lorsqu’il reçoit une tâche, l’agent commence par consulter la documentation du module visé ; une fois le développement achevé, il met à jour les contraintes et l’état du système directement dans les documents du projet. La mémoire cesse d’être une base de données opaque greffée de l’extérieur pour devenir un espace de travail lisible, modifiable et partageable avec l’ensemble de l’équipe.
Trois strates de dossiers nées de la pratique sur le terrain
Le retour au texte brut a vu émerger au sein de la communauté des schémas d’organisation clairs et pragmatiques. Plutôt que de consigner l’ensemble des échanges dans un dossier unique, les équipes mettent en place une architecture à trois niveaux : .agents/plans/ pour les feuilles de route et plans d’action, .agents/notes/ pour consigner les étapes d’investigation, et .agents/knowledge/ pour archiver les conclusions stabilisées et vérifiées.
Dans cette organisation, les notes demeurent des réflexions transitoires ; seules les connaissances confirmées par l’expérience sont promues vers le dossier knowledge. Dès qu’un domaine technique prend de l’ampleur, des fichiers INDEX.md locaux assurent le guidage. En revenant au format texte, les principes éprouvés d’arborescence et de gouvernance logicielle s’appliquent naturellement au pilotage des agents autonomes.
Débat communautaire : le texte suffit-il à endiguer les hallucinations de code ?
Certains développeurs s’interrogent toutefois sur le pouvoir contraignant des protocoles purement textuels. À l’usage, ils constatent que même si la documentation stipule expressément « n’utiliser que jq pour parser le JSON et ne générer aucun script temporaire », le modèle tend spontanément à concevoir et exécuter des scripts Python dès que la structure JSON se complexifie.
Pour un grand modèle de langage fondé sur des probabilités statistiques, les instructions textuelles atteignent leurs limites. Ces développeurs préconisent de doubler les conventions documentaires de barrières fermes au niveau du compilateur et des outils de linting. En réinjectant les violations de règles sous forme de retours d’erreurs enrichis de directives de correction, l’outillage impose des garde-fous stricts qui ramènent l’agent sur la trajectoire voulue.
Le bon sens de l’ingénierie ramène l’outillage vers le texte brut
Qu’il s’agisse de maintenir des index Markdown ou de déployer des linters intraitables, ces démarches partagent la même exigence : une chaîne de développement moderne doit demeurer transparente, déterministe et auditable. Une multitude de plugins de mémoire ont réduit la gestion de contexte à un problème étriqué de taux de rappel (recall) RAG, empilant les briques logicielles pour masquer l’incapacité de gérer un état pérenne.
Le socle naturel du savoir en génie logiciel reste le texte brut, auditable par des pairs et soumis au contrôle de version. L’agent n’a pas besoin d’un simulacre de mémoire artificielle, mais d’une documentation vivante qu’il consulte avant d’agir et enrichit une fois sa mission accomplie.
Liens de référence :
- Agents Don’t Need Memory. They Need Documentation.
- Discussions sur Hacker News
- Dépôt Operator Memory