„Niemand sieht sich die Aufzeichnung eines Team-Meetings von vor drei Jahren an, um sich an die Einschränkungen eines Features zu erinnern. Menschen schreiben Dinge auf und nutzen diese Aufzeichnungen.“
In seinem Aufsatz Agents Don’t Need Memory. They Need Documentation. legt der Entwickler Kevin Liao dar, dass aktuelle Speicherlösungen im Ökosystem der KI-Agenten an gravierenden ingenieurtechnischen Konstruktionsfehlern leiden. Während viele Anbieter ihre RAG-Systeme mit Hintergrund-Daemons, Rerankern und automatischen Zusammenfassungsalgorithmen überfrachten, kämpfen Entwickler in der Praxis weiterhin mit den Verwaltungsproblemen undurchsichtiger Blackbox-Speicher.
Die RAG-Lotterie scheitert an fünf elementaren Software-Fallen
Derzeitige Memory-Plugins für Agenten folgen fast ausnahmslos demselben Schema: Sie durchforsten historische Sitzungsprotokolle, extrahieren Textschnipsel, speichern diese in einer Vektordatenbank und schleusen bei jedem Prompt die fünf ähnlichsten Treffer in den Kontext ein. Liao bezeichnet dieses Verfahren treffend als Lotteriespiel über RAG-Fragmente. In zerlegten Vektoreinträgen gehen die ursprüngliche Motivation hinter dem Code und der jeweilige Systemzustand unweigerlich verloren.
 Abbildung: Isolierte Speicherfragmente, deren Kontext verloren geht. Quelle: liao.gg
Ähnlichkeitsabgleiche berechnen lediglich den Abstand zweier Fragmente im Einbettungsraum; sie können jedoch nicht feststellen, welche Regel im aktuellen System tatsächlich Gültigkeit besitzt. Historische Einträge ungeprüft als gegenwärtige Fakten zu behandeln, birgt in dynamischen Codebasen erhebliche Gefahren. Ändert sich beispielsweise die Authentifizierungslogik, speisen veraltete Fragmente aus der Datenbank weiterhin überholte Anweisungen in den Agenten ein. In einer Blackbox aus zehntausend SQLite-Embeddings lässt sich kaum nachvollziehen, welche Daten veraltet sind oder welche noch nie abgerufen wurden. Selbst wenn man dem Agenten ein globales Suchwerkzeug an die Hand gibt, fehlt ihm das Bewusstsein dafür, welches Wissen ihm fehlt und wann eine Suche erforderlich ist.
Ein Vier-Stufen-Modell für dokumentenbasierte Workflows
Um dem Kontrollverlust von Blackbox-Gedächtnissen zu entkommen, schlägt Liao das Konzept des „Document-based Memory“ vor. Dieser Ansatz verzichtet vollständig auf permanente Hintergrundprozesse und Vektorschnittstellen und setzt stattdessen auf strukturierte Dokumentation in reinem Markdown. Eine einzelne AGENTS.md-Datei reicht für komplexe Projekte selten aus; erforderlich ist ein Gefüge aus Arbeitsanweisungen, Spezifikationen, Architekturentscheidungen und technischer Recherche.
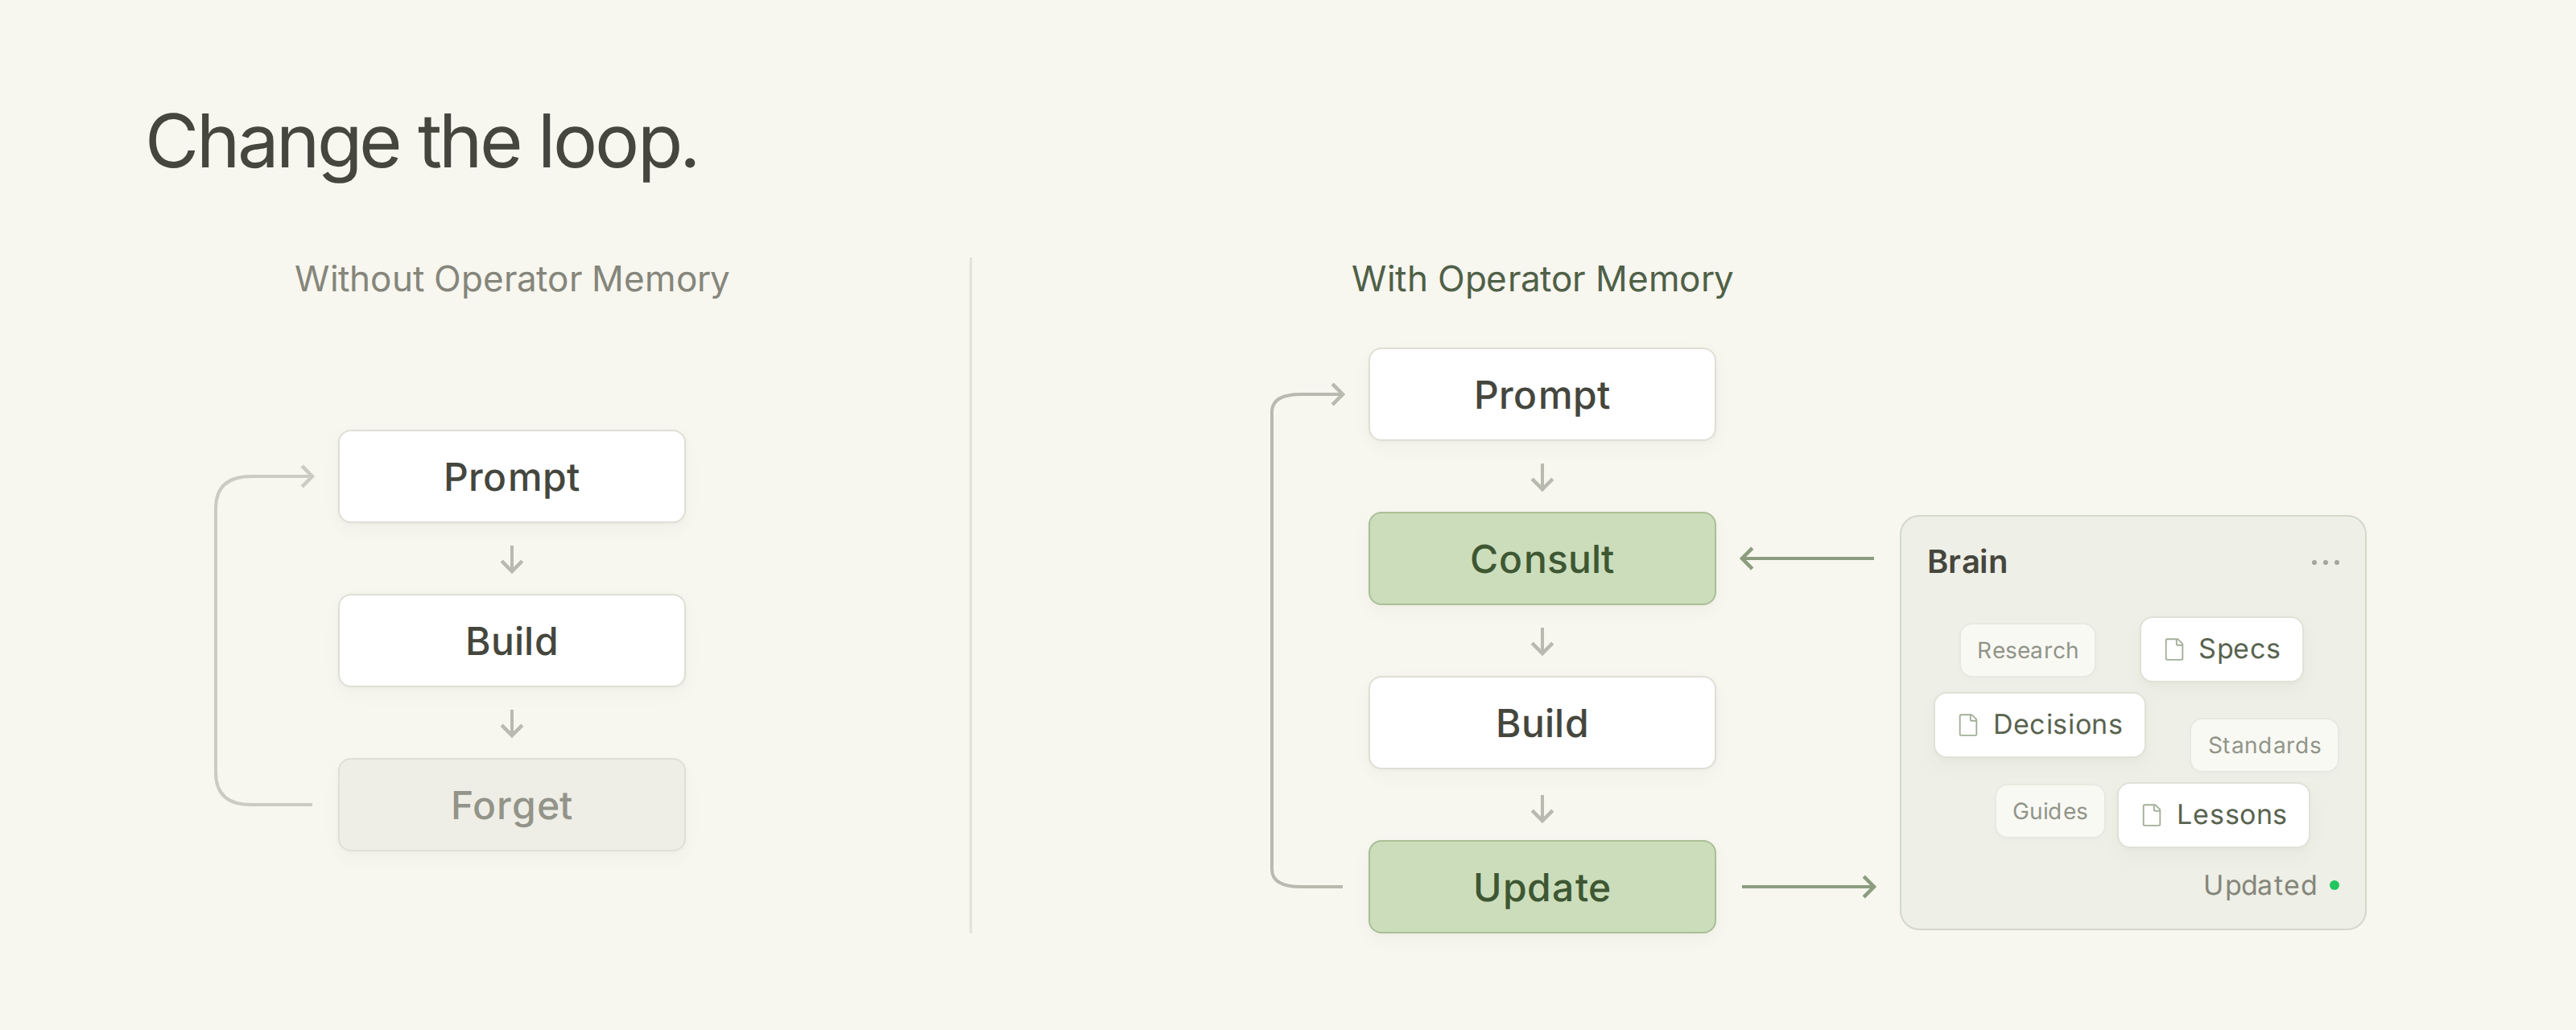 Abbildung: Gegenüberstellung von „prompt → build → forget“ und „prompt → consult → build → update“. Quelle: liao.gg
Das Entwicklungsparadigma wandelt sich grundlegend: Aus der linearen Schleife prompt → build → forget wird der Zyklus prompt → consult → build → update. Erhält der Agent eine Aufgabe, konsultiert er zunächst die Dokumentation des betreffenden Moduls. Nach Abschluss der Implementierung aktualisiert er die Projektdokumente mit den neuen Rahmenbedingungen und Zuständen. Das Gedächtnis wandelt sich von einer undurchsichtigen externen Abfragedatenbank in einen offenen Arbeitsbereich, der von Menschen und Maschinen gleichermaßen gelesen, angepasst und versioniert werden kann.
Drei Verzeichnisebenen für die praktische Umsetzung
Mit der Rückkehr zu gewöhnlichen Textdokumenten haben sich in der Community praxiserprobte Verzeichnisstrukturen etabliert. Statt alle Dialogspuren in einem einzigen Ordner zu sammeln, setzen Entwickler auf eine dreistufige Architektur: .agents/plans/ für Ablaufpläne, .agents/notes/ für Untersuchungsprotokolle und .agents/knowledge/ für validierte, dauerhafte Erkenntnisse.
In diesem Aufbau fungieren Notizen als flüchtige Denkräume; erst verifizierte Erkenntnisse werden in den Wissensbereich überführt. Wächst der Dokumentenumfang in einem Teilbereich stark an, schaffen lokale INDEX.md-Dateien die nötige Übersicht. Indem Klartext als Speichermedium wiederbelebt wird, lassen sich bewährte Praktiken der Verzeichnisorganisation und des Software-Engineerings nahtlos auf die Steuerung von KI-Teams übertragen.
Community-Debatte: Genügen Textprotokolle gegen Halluzinationen?
Einige Entwickler äußern jedoch Skepsis bezüglich der Verbindlichkeit reiner Textvorgaben. In der täglichen Praxis zeigt sich wiederholt: Selbst wenn in den Anweisungen ausdrücklich gefordert wird, JSON ausschließlich mittels jq zu parsen und keine Ad-hoc-Skripte anzulegen, verfällt das Modell bei komplexen JSON-Strukturen oft eigenmächtig darauf, temporäre Python-Skripte zu schreiben und auszuführen.
Bei Modellen, die auf statistischen Wahrscheinlichkeiten beruhen, stößt rein textuelle Steuerung an natürliche Grenzen. Entwickler plädieren daher dafür, Textvereinbarungen durch harte Compiler- und Linter-Prüfungen abzusichern. Indem Verstöße gegen Linter-Regeln in strukturierte Fehlermeldungen mit konkreten Reparaturanweisungen übersetzt und an das Modell zurückgemeldet werden, lässt sich der Agent über deterministisches Feedback zuverlässig auf den vorgesehenen Pfad zurückführen.
Technische Vernunft zwingt Toolchains zurück zu Klartext
Ob strukturierte Markdown-Indizes oder strikte Linter-Schranken: Beide Ansätze verfolgen denselben Grundsatz. Moderne Entwicklerwerkzeuge müssen transparent, deterministisch und auditierbar bleiben. Viele bisherige Gedächtnis-Plugins haben das Problem des Projektkontexts auf eine bloße Frage der RAG-Trefferquote reduziert und versucht, fundamentale Schwächen des Zustandsmanagements durch das Anhäufen weiterer Komponenten zu kaschieren.
Das natürliche Trägermedium für Software-Engineering-Wissen ist und bleibt ein einsehbares, versioniertes Klartextsystem. Ein Agent benötigt keinen spekulativen Gedächtnisapparat, sondern eine lebendige Dokumentationsbasis, die er vor Arbeitsbeginn konsultiert und nach getaner Arbeit eigenständig aktualisiert.
Weiterführende Links:
- Agents Don’t Need Memory. They Need Documentation.
- Diskussion auf Hacker News
- Operator-Memory-Repository