“특정 기능의 제약 사항을 기억해 내기 위해 3년 전 팀 회의 녹화 영상을 다시 돌려보는 사람은 없다. 사람들은 글을 기록으로 남기고, 그 기록을 참조한다.”
개발자 케빈 리아오(Kevin Liao)는 자신의 글 《에이전트는 기억이 아니라 문서가 필요하다(Agents Don’t Need Memory. They Need Documentation.)》를 통해 현재 AI 에이전트 생태계의 메모리 솔루션들이 근본적인 엔지니어링 결함을 안고 있다고 지적했다. 수많은 툴이 RAG 아키텍처 위에 백그라운드 데몬, 리랭커, 자동 요약 알고리즘을 덧대고 있지만, 실제 현장의 시스템은 블랙박스 메모리가 초래한 관리 난맥상에 시달리고 있다.
RAG 뽑기 방식이 해결하지 못하는 5가지 엔지니어링 함정
시중에 나온 에이전트 메모리 플러그인들은 대체로 동일한 구조를 답습한다. 과거 대화 로그를 훑어 기억 조각을 생성하고, 이를 벡터 데이터베이스에 넣은 뒤, 프롬프트가 들어올 때마다 유사도 상위 5개를 검색해 컨텍스트에 밀어 넣는다. 리아오는 이 방식을 일종의 ‘RAG 조각 뽑기’라고 비판한다. 잘게 쪼개진 벡터 레코드 속에서 코드를 작성하게 된 본래의 의도나 실행 환경의 상태가 소실되기 십상이다.
 그림: 고립되어 출처와 맥락을 추적하기 힘든 기억 조각들. 출처: liao.gg
유사도 매칭은 임베딩 공간에서 두 조각 사이의 거리만을 계산할 뿐, 현재 시스템에서 어떤 규칙이 유효한지 판별하지 못한다. 빠르게 변하는 코드베이스에서 과거 기록을 현재의 진실로 취급하는 것은 위험하다. 만약 인증 로직이 변경되었다면 데이터베이스에 남아 있던 낡은 인증 정보 조각이 에이전트에 잘못된 지침을 전달할 수 있다. 1만 개의 임베딩 데이터가 얽힌 블랙박스 속에서 개발자는 어느 정보가 유효 기간이 지났는지, 어느 정보가 한 번도 호출되지 않았는지 파악하기 어렵다. 에이전트에 전체 검색 도구를 제공하더라도 에이전트 스스로 자신이 무엇을 모르는지, 언제 검색을 실행해야 하는지 판단하지 못한다.
4단계로 재정립하는 문서 기반 워크플로
블랙박스 메모리의 관리 실패에 맞서 리아오는 ‘문서 기반 메모리(Document-based Memory)‘를 제안한다. 이 접근법은 백그라운드 정리 데몬과 벡터 인터페이스를 걷어내고 순수 마크다운(Markdown) 기반의 구조화된 문서 체계를 도입한다. 단순한 AGENTS.md 단일 파일만으로는 대규모 개발을 지탱하기 어려우며, 지침서, 상세 규격서, 의사결정 기록, 사전 조사 문서 등을 포괄해야 한다.
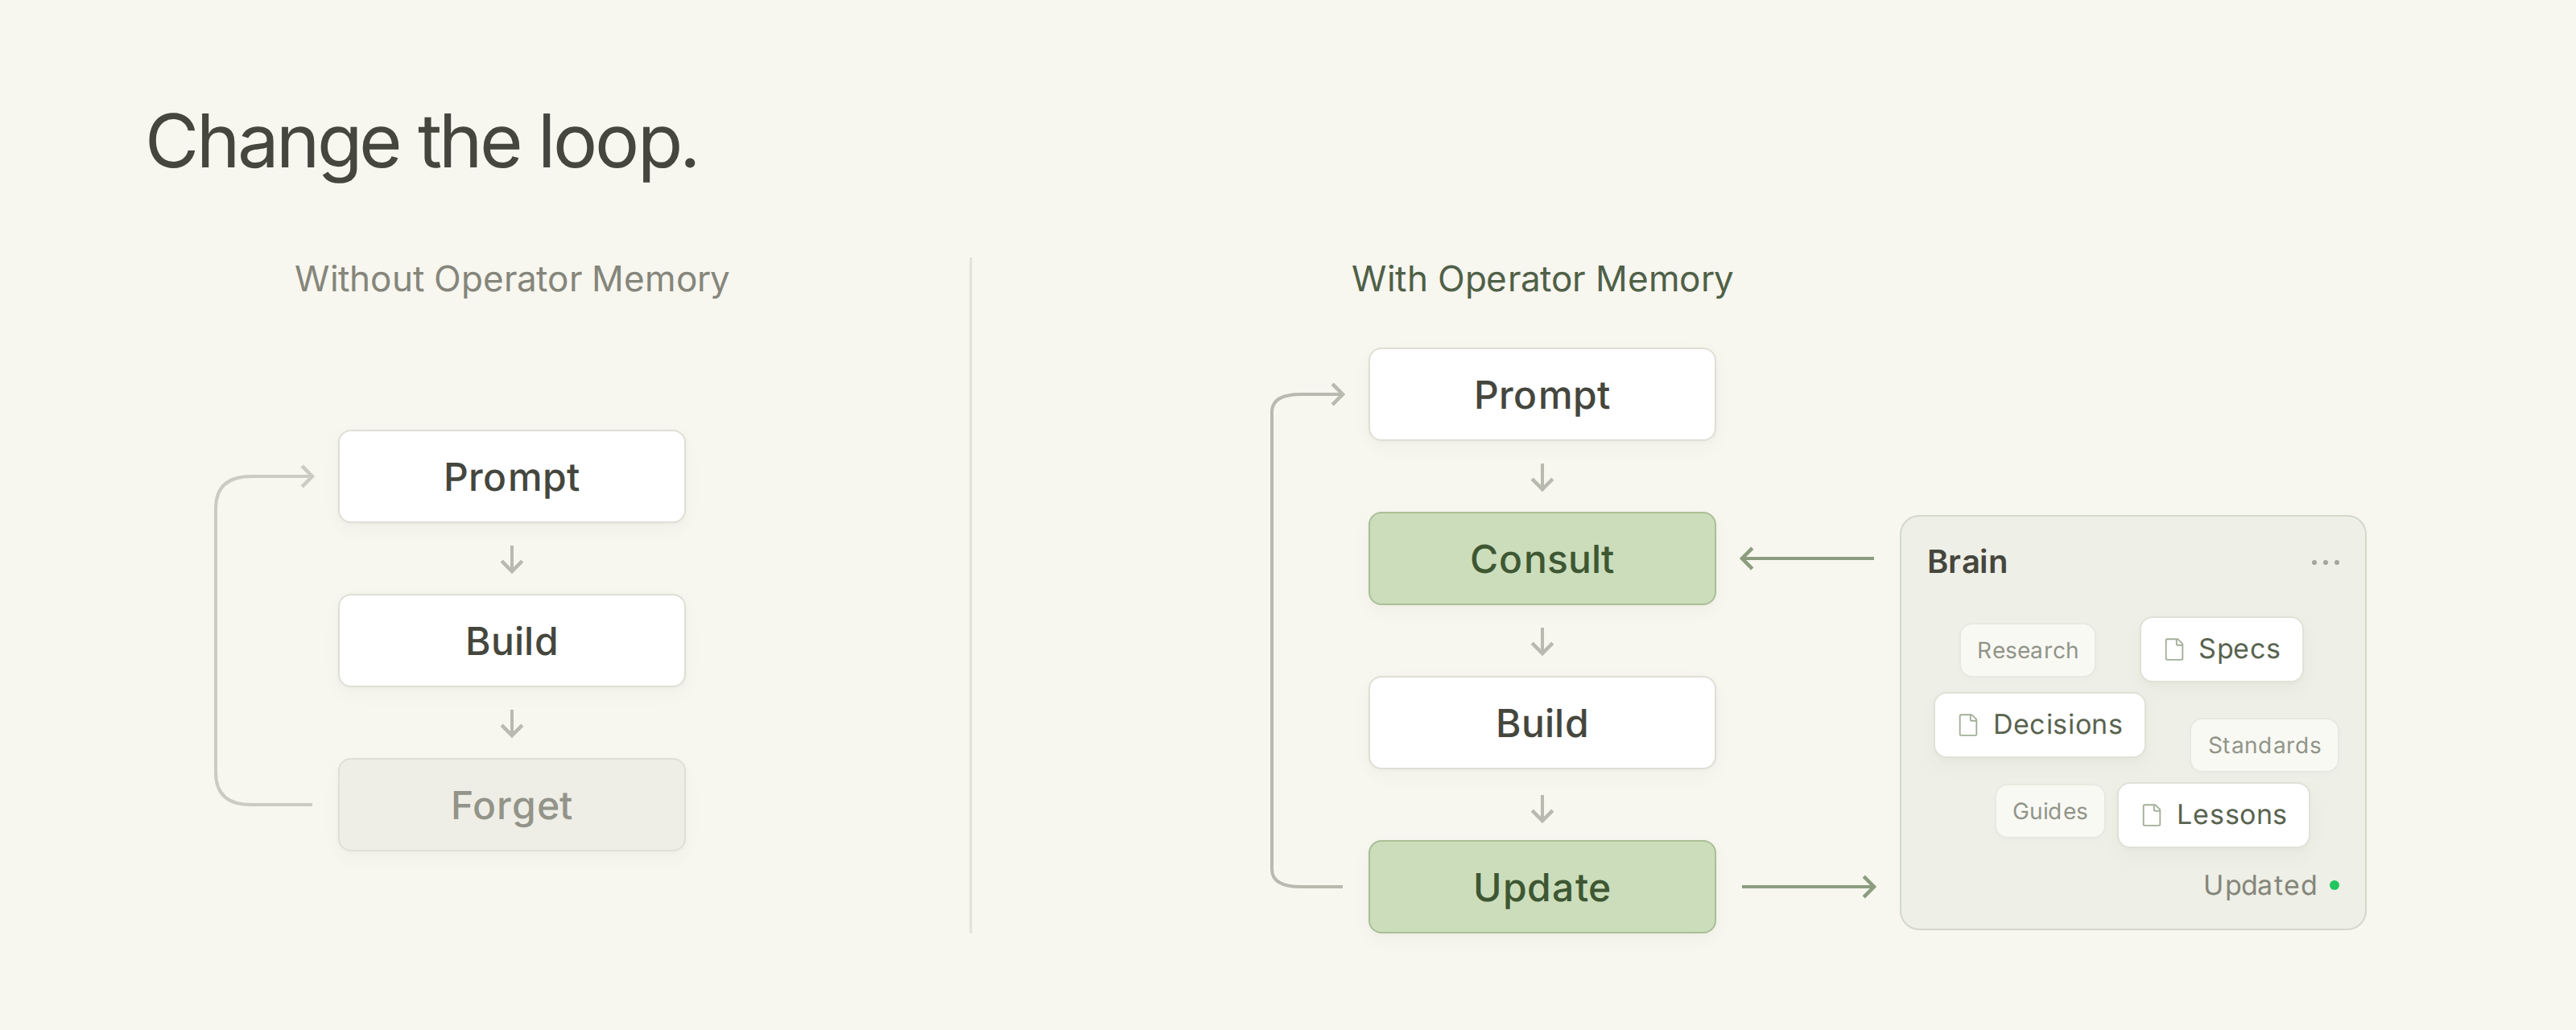 그림: prompt → build → forget 방식과 prompt → consult → build → update 순환 구조의 비교. 출처: liao.gg
개발 패러다임은 일방통행식 prompt → build → forget에서 prompt → consult → build → update로 전환된다. 에이전트는 작업을 시작하기 전 해당 모듈의 문서를 먼저 조회(consult)하고, 코드 구축을 마친 후 새로운 제약과 변경 사항을 프로젝트 문서에 갱신(update)한다. 메모리는 외부에 부착된 불투명한 검색용 DB가 아니라 팀원 모두가 읽고 고치며 공유할 수 있는 열린 작업 공간으로 탈바꿈한다.
실무에서 검증된 3단계 디렉터리 구성 법칙
메모리 저장소가 일반 텍스트 문서로 회귀하면서 커뮤니티에서는 체계적인 디렉터리 설계가 정립되고 있다. 모든 대화 기록을 단일 폴더에 몰아넣는 대신 계층 구조를 도입했다. .agents/plans/에는 실행 절차와 계획을 두고, .agents/notes/에는 조사 과정의 메모를 기록하며, .agents/knowledge/에는 최종 검증된 결론을 보관한다.
이 구조에서 메모(notes)는 임시적인 사고 기록으로 취급되며, 실증을 거쳐 가치가 입증된 지식만이 knowledge로 승격된다. 특정 업무 영역의 지식 파일이 비대해지면 하위 탐색을 돕는 로컬 INDEX.md를 둔다. 저장 매체가 평문 텍스트로 돌아오면서 인류가 수십 년간 축적해 온 디렉터리 분류 체계와 엔지니어링 관리 역량을 AI 협업 환경에 그대로 적용할 수 있게 되었다.
커뮤니티의 쟁점: 텍스트 프로토콜이 코드 환각을 막을 수 있는가
일부 개발자들은 텍스트 기반 지침의 구속력에 대해 현실적인 의문을 던진다. 실전에서 에이전트 문서에 “JSON 파싱 시 임시 파이썬 스크립트를 작성하지 말고 오직 jq만 사용하라”고 명시하더라도, 모델이 복잡한 JSON 구조를 맞닥뜨리면 임의로 파이썬 스크립트를 작성해 실행해 버리는 일이 빈번하게 발생하기 때문이다.
확률 통계에 기대는 대형 언어 모델의 특성상 텍스트 지침만으로는 통제력에 한계가 있다. 이에 따라 개발자들은 컴파일러 수준의 엄격한 차단 장치를 텍스트 프로토콜과 결합할 것을 권장한다. 코드 린트(lint) 규칙 위반 시 수정 가이드가 포함된 에러 메시지를 모델에 반환함으로써 명확한 피드백과 규칙 차단을 통해 에이전트가 정상 궤도로 복귀하도록 유도하는 방식이다.
엔지니어링 상식이 도구 생태계를 평문 프로토콜로 이끈다
정적 마크다운 색인을 유지하든 엄격한 린트 검사를 적용하든 두 해법이 지향하는 가치는 동일하다. 현대 소프트웨어 개발 도구 체계는 투명하고 결정론적이며 감사 가능해야 한다. 기존의 여러 메모리 플러그인은 프로젝트 맥락 관리라는 본질적인 문제를 검색 정확도(recall) 경쟁으로 축소하고, 부가 모듈을 덕지덕지 붙여 상태 관리의 실패를 감추려 했다.
소프트웨어 엔지니어링 지식의 참된 터전은 동료 검토가 가능하고 버전이 추적되는 평문 시스템이다. 에이전트에게 진정으로 필요한 것은 불투명한 메모리 상자가 아니라, 작업 전 참조하고 작업 후 스스로 갱신할 수 있는 살아 숨 쉬는 문서다.
참고 링크:
- Agents Don’t Need Memory. They Need Documentation.
- Hacker News 관련 토론
- Operator Memory 저장소